Den ersten Platz im Bereich der quelloffenen KI-Bildgenerierung belegen, Qwen-Image-2.1 hebt die gesamte Bildgenerierungsdomäne auf ein völlig neues Niveau.
Die Fähigkeit von KI, Code zu schreiben, ermöglicht es Entwicklern oft, die Hände von der Tastatur zu nehmen, aber für Designer sind die von KI generierten Bilder immer noch mehrere Schritte von der endgültigen Abgabe entfernt.
Im Arbeitsablauf des Bilddesigns müssen Personen ausgeschnitten werden, Texte in Materialien geändert werden, und die Platzierung verschiedener Waren muss von Zeit zu Zeit angepasst werden, während die Texte auf der Verpackung und die Form der Flasche nicht mitverändert werden dürfen. Wenn die Anforderungen ständig angepasst werden, müssen weiterhin lokale Teile modifiziert werden, damit das gesamte Bild harmonisch bleibt.
Diese Details bestimmen, ob die KI-Bildgenerierung in den echten kreativen Prozess einbezogen werden kann. Für Designer, E-Commerce-Betreiber und Inhaltsersteller liegt der Engpass aktueller Bildmodelle darin, ob jede vorgegebene Änderungsanweisung genau umgesetzt werden kann.
Diesen Sonntag hat Alibaba Qwen das Bildgenerierungsmodell Qwen-Image-2.1 offiziell quelloffen veröffentlicht, das mit dem Umfang eines kleinen Modells die meisten Produktivitätsprobleme löst: Es integriert Text-zu-Bild-Generierung und Bildbearbeitung in einem System, unterstützt nativ die Generierung transparenter Bilder, kann maximal 10 Referenzbilder verarbeiten und hat die lokale Bearbeitung sowie die Treue von Porträts und Waren weiter verbessert.
Es ist derzeit das ausgewogenste und kostengünstigste quelloffene Bildgenerierungsmodell in der Qwen-Bildreihe. Öffentliche Bewertungsergebnisse zeigen, dass Qwen-Image-2.1 den ersten Platz unter den quelloffenen Modellen belegt und sogar einen höheren Punktwert als Nano Banana 2.0 erreicht. Man muss wissen, dass der Parameterumfang des visuellen Generierungsteils dieses Modells nur 7B beträgt.
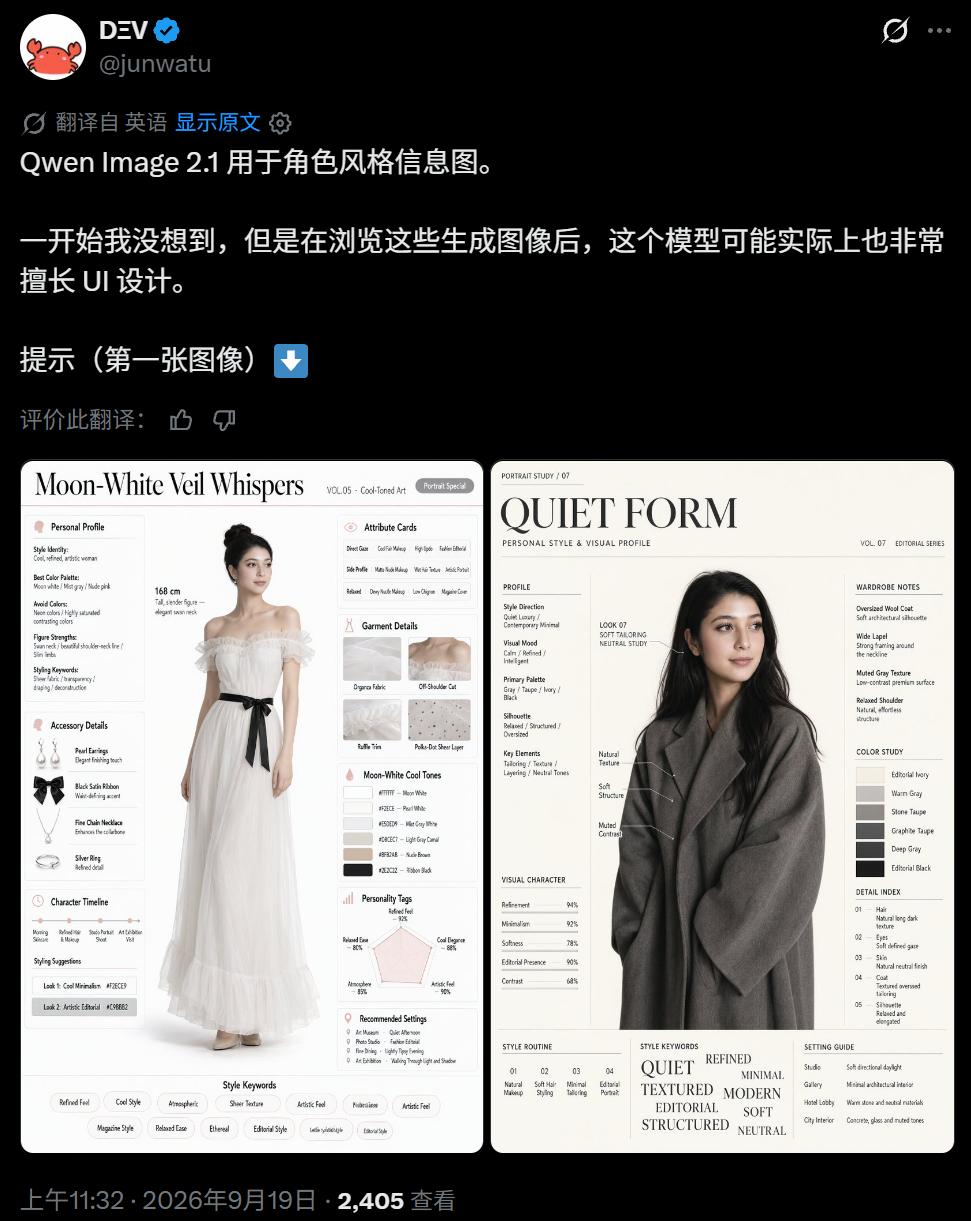
Auf Plattformen wie X haben Benutzer, die vorab Zugang zu der Testversion erhalten haben, bereits die Generierungsergebnisse veröffentlicht, die überall positiv bewertet werden. Es gibt Ergebnisbilder mit großen Mengen an Textinhalten:
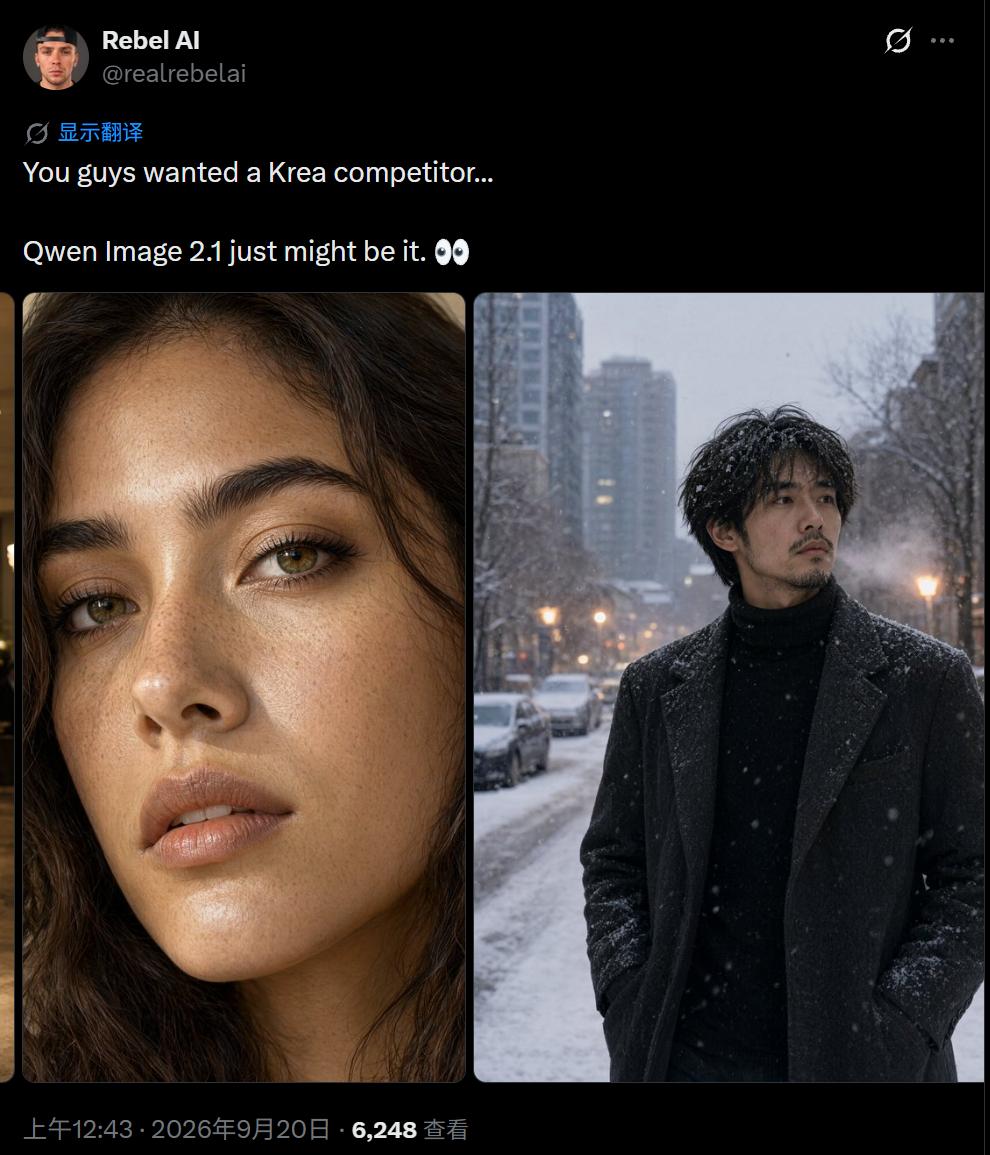
Ergebnisse, die Bilder mit der Textur echter Fotos erzeugen:
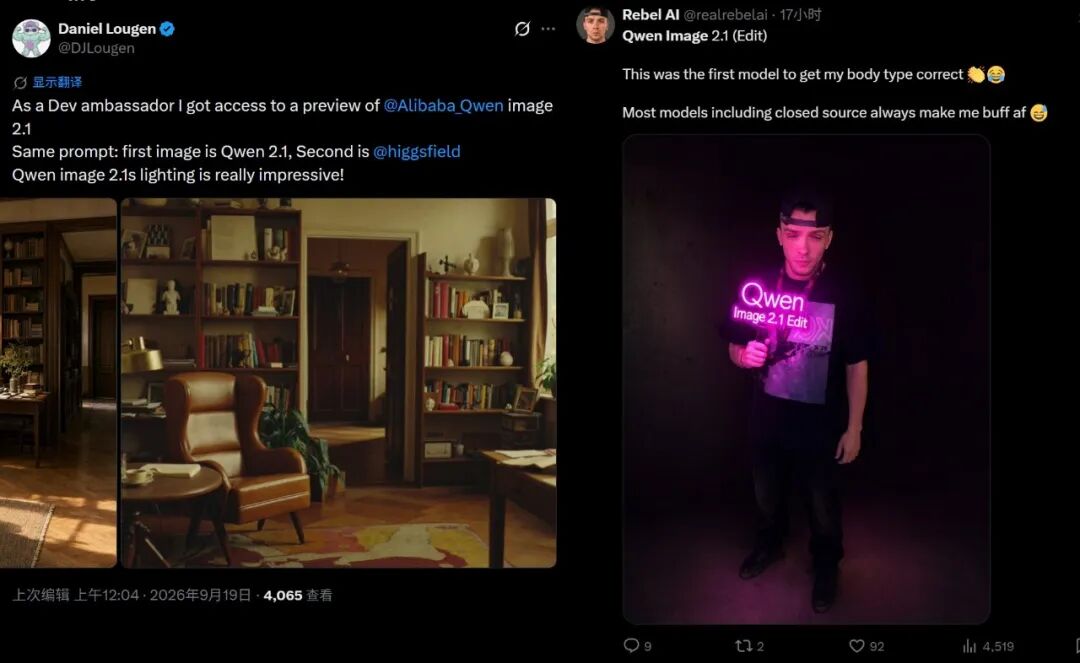
Auch Ergebnisse mit verschiedenen Filtern und Beleuchtungsstilen wurden ausprobiert:
Die Nutzer halten Qwen-Image-2.1 für beeindruckend in Bezug auf Anweisungsbefolgung, Erfolgsrate der Generierung und praktische Ergebnisse. Auf Basis der Fähigkeiten des neuen Modells können wir bereits den Arbeitsablauf von Materialgenerierung, Kombination und Modifikation verbinden und mit KI viele komplexe Bildbearbeitungsprobleme lösen.
Fähigkeit und Effizienz
Nach Angaben der Entwickler verwendet der visuelle Generierungsteil von Qwen-Image-2.1 ein 20-schichtiges Single-Stream-DiT mit 7B Parametern und unterstützt nativ 2K-Auflösung. Dieses Modell erreicht in den Bewertungsbenchmarks ein Niveau, das über seinem Umfang liegt: Die Gesamtpunktzahl von Qwen-Image-2.1 beträgt 60,28. Zum Vergleich: Nano Banana 2.0 erreicht 59,82 und GPT Image 1.5 erreicht 59,65. Es kann bereits mit vielen geschlossenen Bildmodellen konkurrieren.
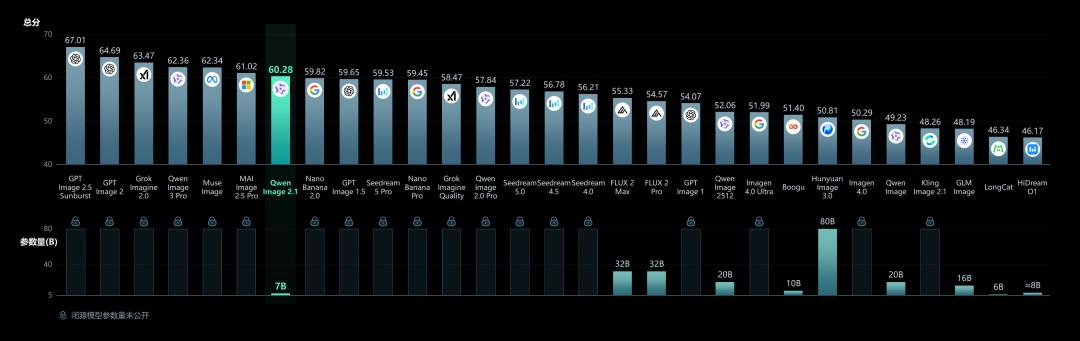
Bewertungsdiagramm von Qwen-Image-Bench.
Dass der visuelle Generierungsteil nur über 7B Parameter verfügt, macht dieses Fähigkeitsniveau noch bemerkenswerter: Es integriert in einem kleinen Generierungsmodul gleichzeitig die Fähigkeiten zur Bildgenerierung, Generierung transparenter Materialien und Mehrbildbearbeitung (einheitliche Pipeline für Generierung und Bearbeitung) und bietet Entwicklern einen leichteren Ausgangspunkt für die Bereitstellung und Anpassung von Bildwerkzeugen.
Neben der guten Leistung hat Qwen-Image-2.1 auch den Inferenzprozess des Modells optimiert, dessen Kernidee darin besteht, unnötige wiederholte Berechnungen zu reduzieren.
Bei einer einzelnen Bildbearbeitung ändern sich das eingegebene Referenzbild und die Bearbeitungsanweisung nicht mit jedem Generierungsschritt. Daher verwendet das neue Modell eine Aufmerksamkeitsstruktur mit gemischter Granularität: Der Textteil (Systempräfix, Bearbeitungsanweisung) folgt der herkömmlichen Token-Level-Kausalmaske und führt strenge sequenzielle Berechnungen Wort für Wort durch, um die Kohärenz des semantischen logischen Verständnisses zu gewährleisten. Der Bildgenerierungsteil verwendet eine Chunk-Level-Maske und speichert diese statischen Kontexte nach dem ersten Berechnungsschritt über den KV-Cache-Mechanismus zwischen, um sie für nachfolgende Generierungsschritte wiederzuverwenden.
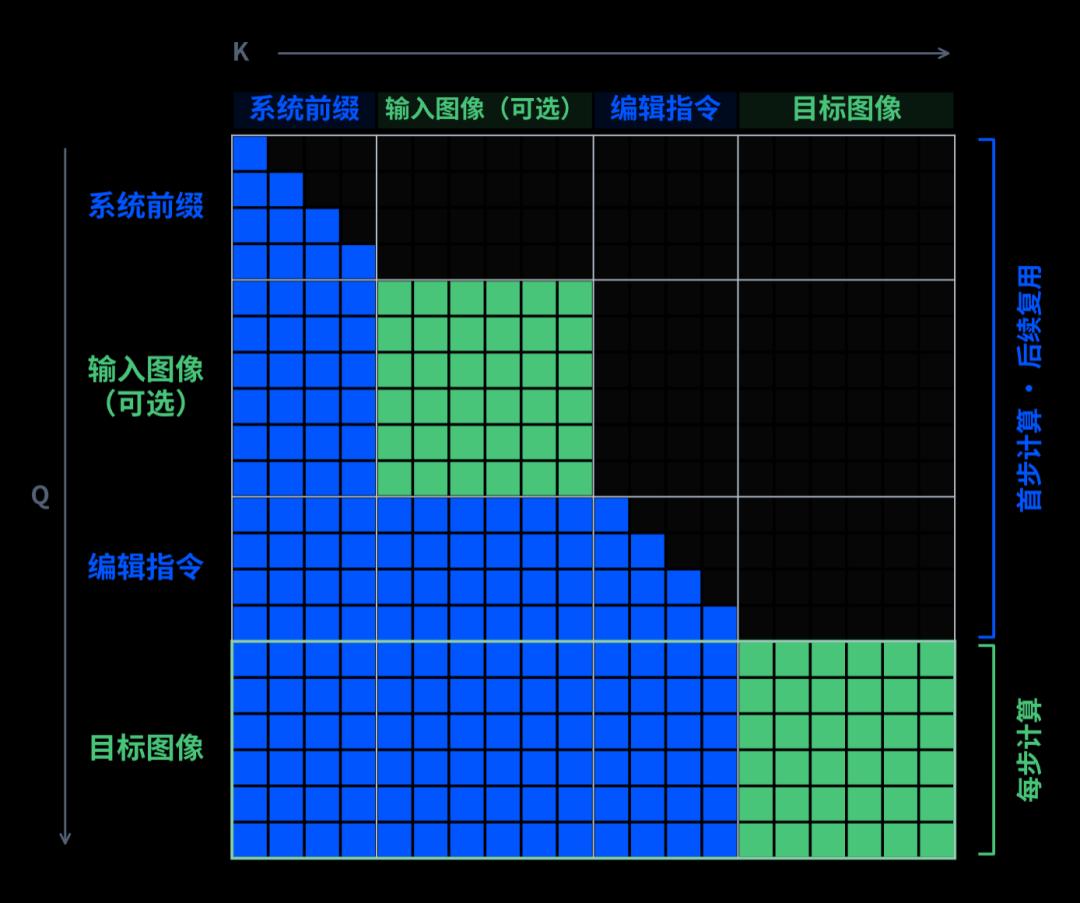
Das bedeutet, dass die KI jetzt zuerst die Referenzmaterialien verarbeitet und die vorhandenen Ergebnisse bei der schrittweisen Generierung des Zielbildes wiederverwendet. Diese Optimierung wirkt sich besonders deutlich bei Mehrbildeingaben aus und hilft, die Inferenzeffizienz zu verbessern und den Grafikspeicherbedarf zu senken.
Da Qwen-Image-2.1 jetzt maximal 10 Referenzbilder unterstützt, ist diese Optimierung von entscheidender Bedeutung. Je reicher die Eingabeinhalte sind, desto mehr Aufmerksamkeit verdient die Verarbeitung von Referenzinformationen und die Steuerung wiederholter Berechnungen. Wie viel Zeit und Grafikspeicher konkret eingespart werden kann, muss je nach Hardware, Genauigkeit, Auflösung und Anzahl der Eingaben beurteilt werden.
Direkte Generierung nutzbarer transparenter Materialien
Die Fähigkeit der neuen Qwen-Image-Version, die den Designanforderungen am nächsten kommt, ist die Generierung transparenter Bilder.
Herkömmliche Bildmaterialien haben normalerweise einen vollständigen Hintergrund. Um das Hauptmotiv davon in ein Poster, eine Produktbeschreibungsseite oder ein anderes Bild einzufügen, muss man normalerweise zuerst das Motiv ausschneiden und Konturen, Lücken und Ränder bearbeiten. Transparente Bilder enthalten zusätzliche Transparenzinformationen, die den Hintergrund um das Hauptmotiv oder in Teilbereichen hindurchscheinen lassen, was das nachfolgende Überlagern und Kombinieren erleichtert.
Qwen-Image-2.1 unterstützt nativ die Generierung transparenter Bilder und kann anhand von Prompten automatisch entscheiden, ob ein normales Bild oder ein transparentes Bild generiert wird. Benutzer können beim Beschreiben des Materials die Anforderung an einen transparenten Hintergrund stellen. Die derzeit gezeigten Beispiele umfassen Festillustrationen, Personenmaterialien, Dekorationselemente und komplexe Kombinationen aus mehreren Objekten, die alle gängigen Materialanforderungen im Designarbeitsablauf entsprechen. Wir haben es auch ausprobiert:
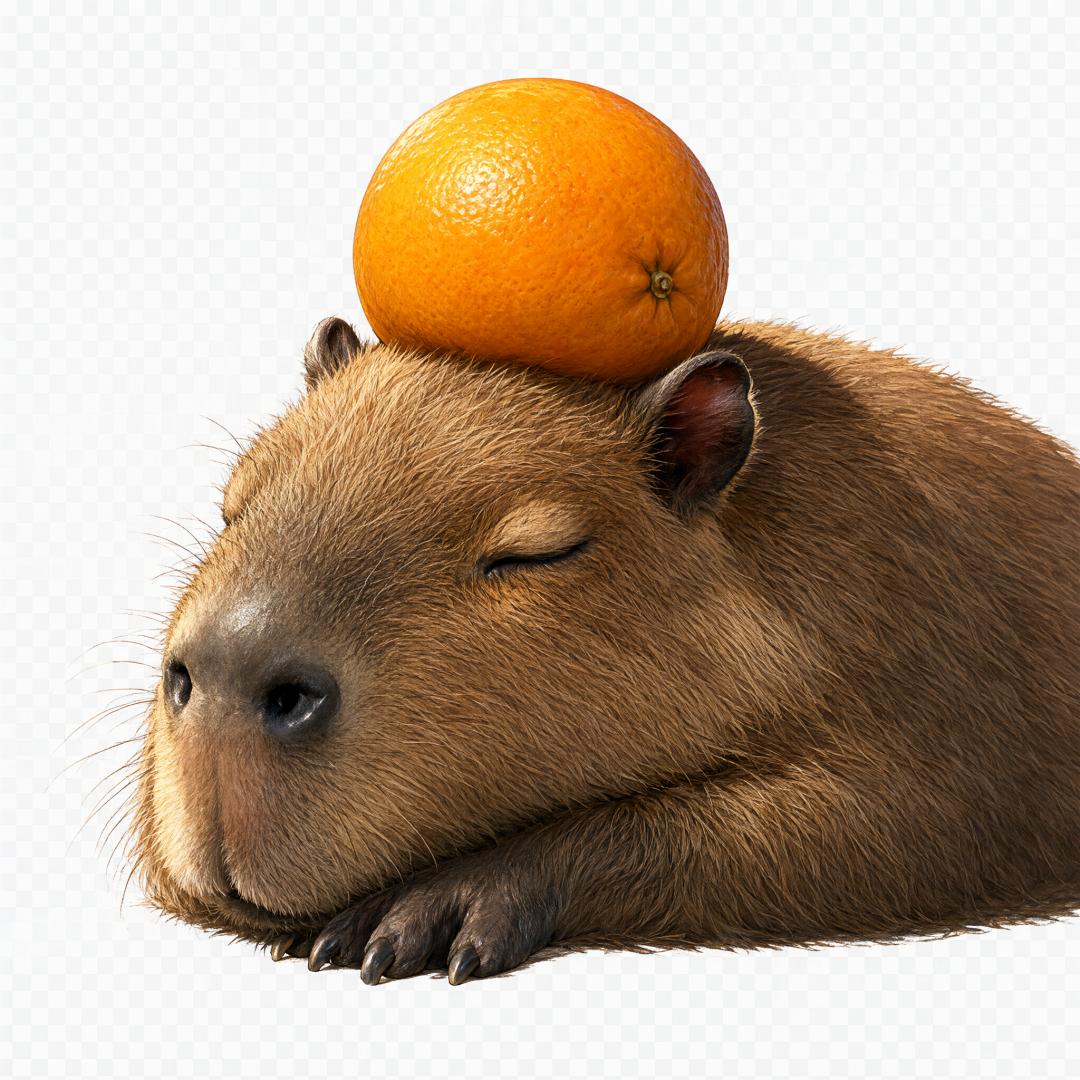
Das ist eine gute Nachricht für Kreative: Jetzt können wir direkt nutzbare Materialien erhalten, was mehrere Arbeitsschritte einspart.
Natürlich können diese generierten transparenten Materialien auch weiter modifiziert werden. Zum Beispiel kann der Ausdruck einer illustrierten Figur angepasst werden, und der Text im Bild kann inhaltlich geändert werden. Die bearbeiteten Objekte können sowohl visuelle Details von Personen als auch Texte in den Materialien sein.
Das entspricht sehr den echten Änderungsanforderungen beim Design: Wenn der Veranstaltungsname geändert wird, muss das Muster weiterhin erhalten bleiben; wenn der Ausdruck lockerer gestaltet werden soll, muss die Person immer noch als dieselbe Figur erkennbar sein. Nachdem Generierung und Bearbeitung in ein einziges Modell integriert wurden, gibt es einen einheitlichen Verarbeitungseinstieg für diese nachfolgenden Anforderungen.
Natürlich unterstützt Qwen-Image-2.1 auch die Verarbeitung vorhandener Fotos.
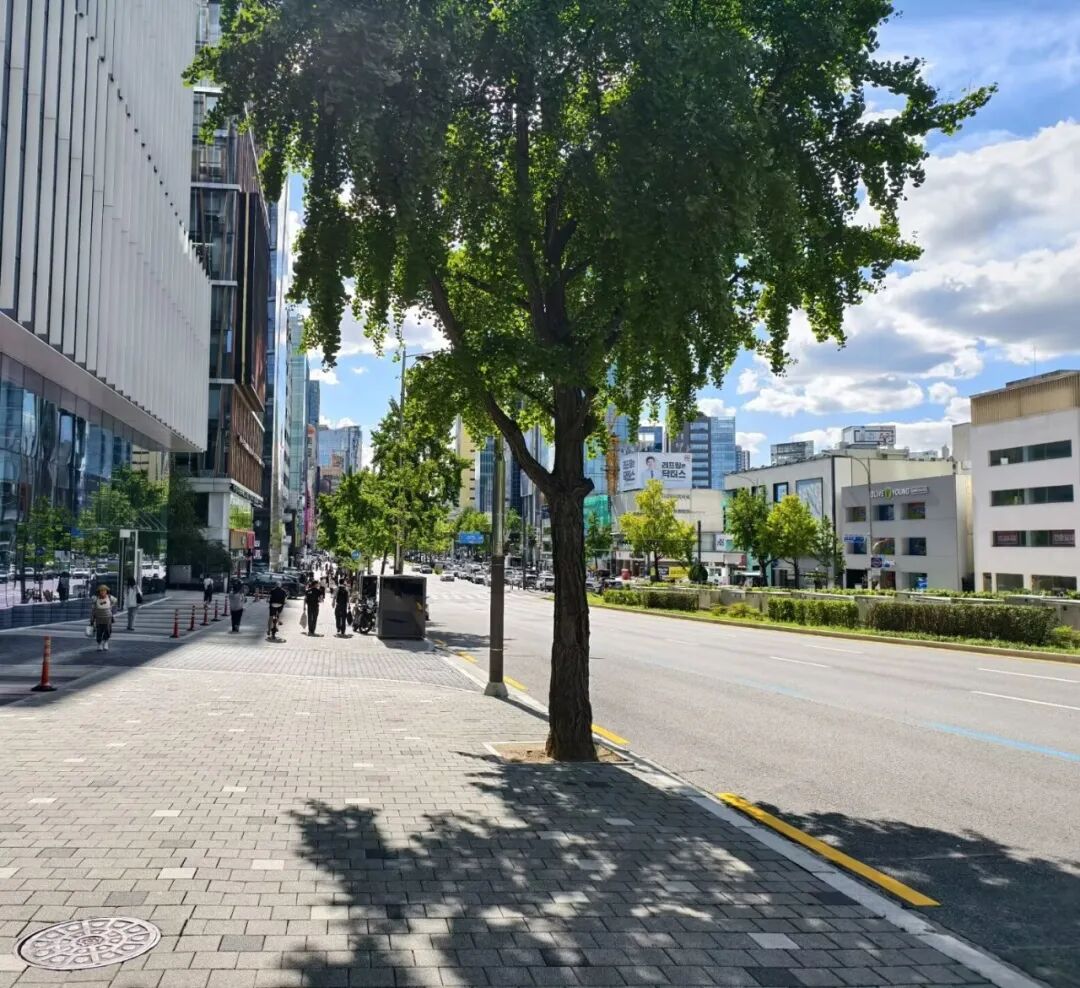
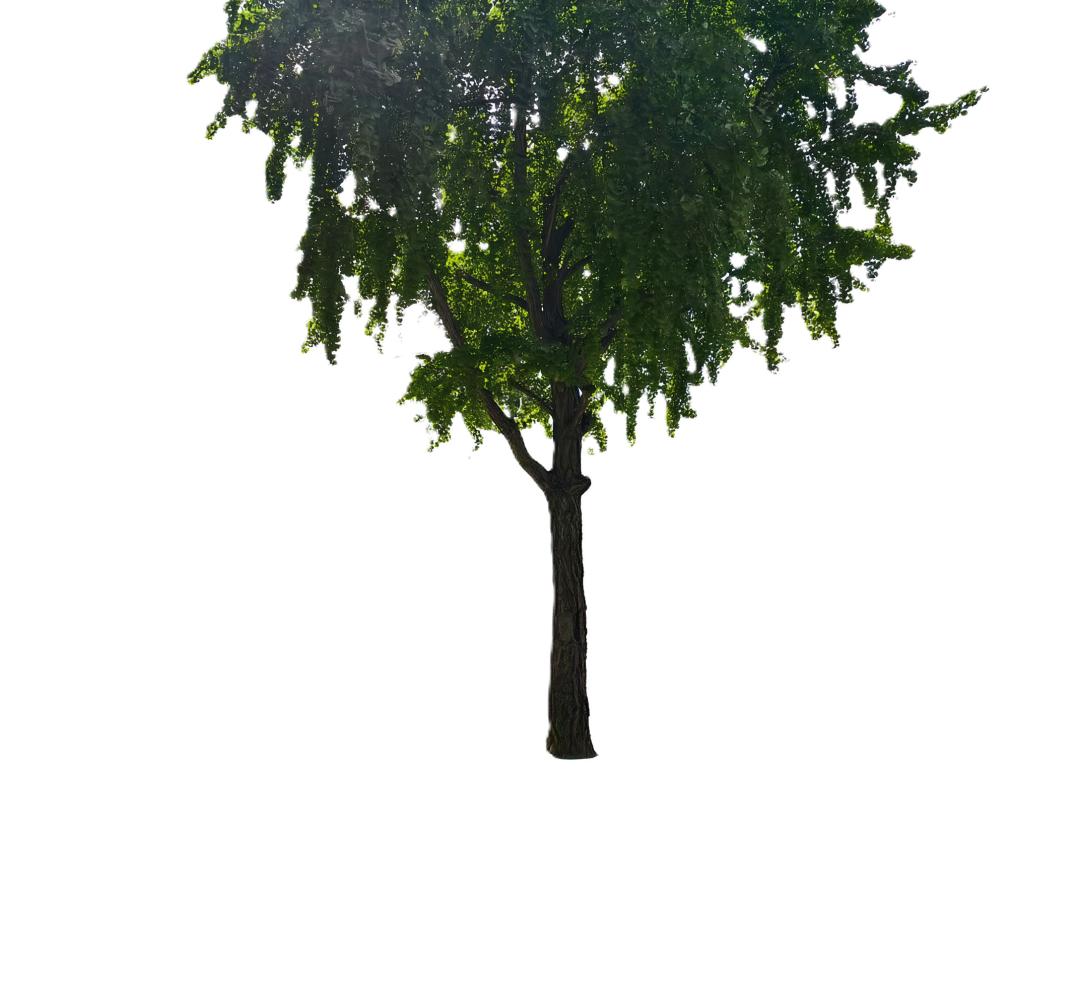
Die offizielle Seite zeigt Beispiele für die Extraktion benötigter Inhalte aus echten Fotos, um RGBA-transparente Bilder zu erhalten. Das A steht hier für den Transparenzkanal, der den Transparenzgrad an jeder Stelle des Bildes beschreibt.
Man sieht, dass diese Fähigkeit sowohl die Generierung von Grund auf als auch die Wiederverwendung vorhandener Bilder unterstützt. Kreative können zuerst ein Foto bereitstellen und dann das Modell auffordern, das benötigte Hauptmotiv daraus zu extrahieren, das als Material für nachfolgende Designarbeiten dient.
Die Qwen-Image-Reihe hat zuvor das unabhängige Qwen-Image-Layered herausgebracht, um Fähigkeiten im Zusammenhang mit transparenten Bildern zu erforschen. Bei Qwen-Image-2.1 wurde die native Generierung und Bearbeitung transparenter Bilder in das allgemeine Bildmodell integriert, was die Benutzerfreundlichkeit weiter verbessert.
Die für die Mehrbildbearbeitung erforderliche Genauigkeit ist jetzt auch in quelloffenen KI-Modellen verfügbar
Wenn die Anforderungen an ein Bild aus mehreren Objekten bestehen, wird die Bearbeitungsaufgabe noch komplexer.
Wenn man zum Beispiel bestimmte Kleidung, Schuhe, Taschen und Hüte demselben Modell anziehen möchte, hat jedes Referenzbild eine andere Funktion. Das Modell muss Personen und Waren unterscheiden, sie an vernünftige Positionen platzieren und ihre jeweiligen Merkmale so weit wie möglich beibehalten.
Qwen-Image-2.1 unterstützt die Eingabe von maximal 10 Referenzbildern. Wir haben es ausprobiert und Ultraman und Dario dazu gebracht, sich hinzusetzen und zu unterhalten. Wir haben 7 Bilder verwendet: ein Foto der beiden, die sich gegenüberstehen (mit angepasstem Ausdruck), ein Hintergrundzimmer, ein Einzelsessel, eine Kaffeetasse (mit eingeschenktem Kaffee), eine Stehlampe, ein Elektrokamin und ein niedriger Tisch, um schließlich ein vollständiges Ergebnisbild zu generieren.
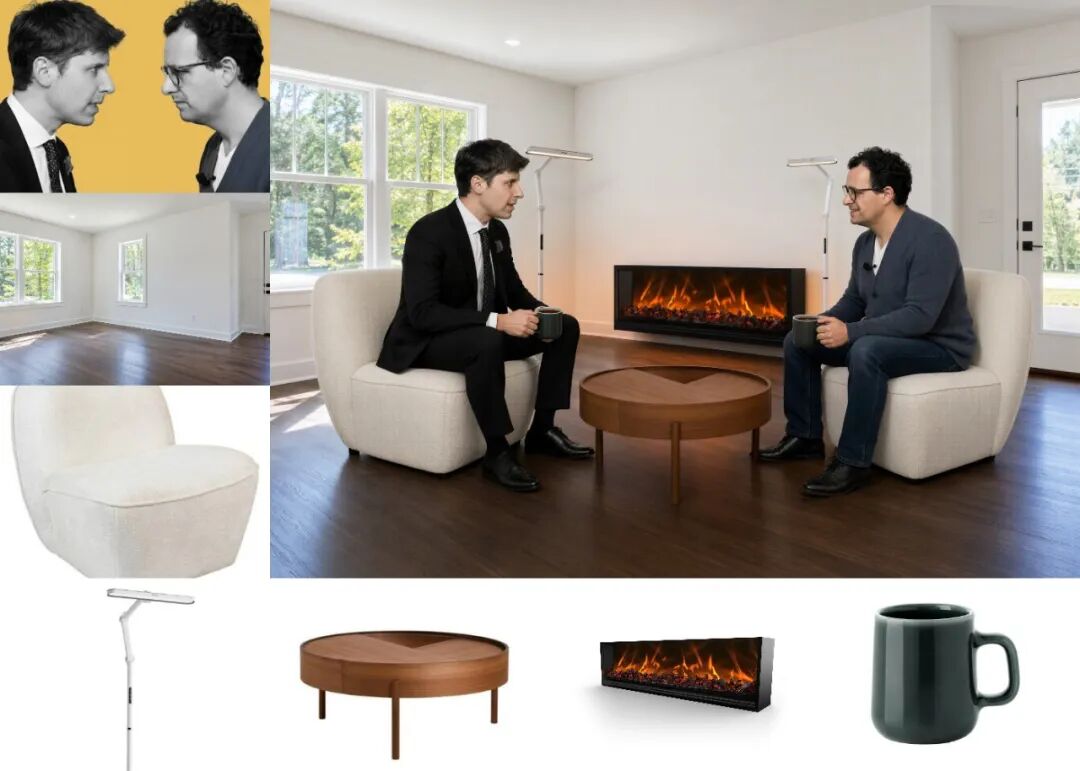
Verschiedene Kleidungsstile können jetzt schnell an einer Person ausprobiert werden, und man kann auch verschiedene Einzelfotos zu einem Gruppenfoto kombinieren.
Technisch gesehen prüft das nicht nur, wie viele Bilder das KI-Modell verarbeiten kann, sondern auch, ob die Referenzobjekte im endgültigen Bild an der richtigen Stelle platziert werden und ob Proportionen, Positionen und der Gesamtstil harmonisch sind.
Nachdem das Gesamtbild zusammengestellt wurde, folgen normalerweise noch lokale Anpassungen.
Qwen-Image-2.1 bietet Methoden wie Auswahl, Malen und unabhängige Masken, mit denen Benutzer die zu bearbeitende Position klarer angeben können. Zum Beispiel kann man verschiedene Bereiche mit verschiedenen Farben markieren und eine gleichzeitige Änderung verlangen, bei der Teile der Kleidung der Person im Foto entfernt und die Haarfarbe geändert werden.
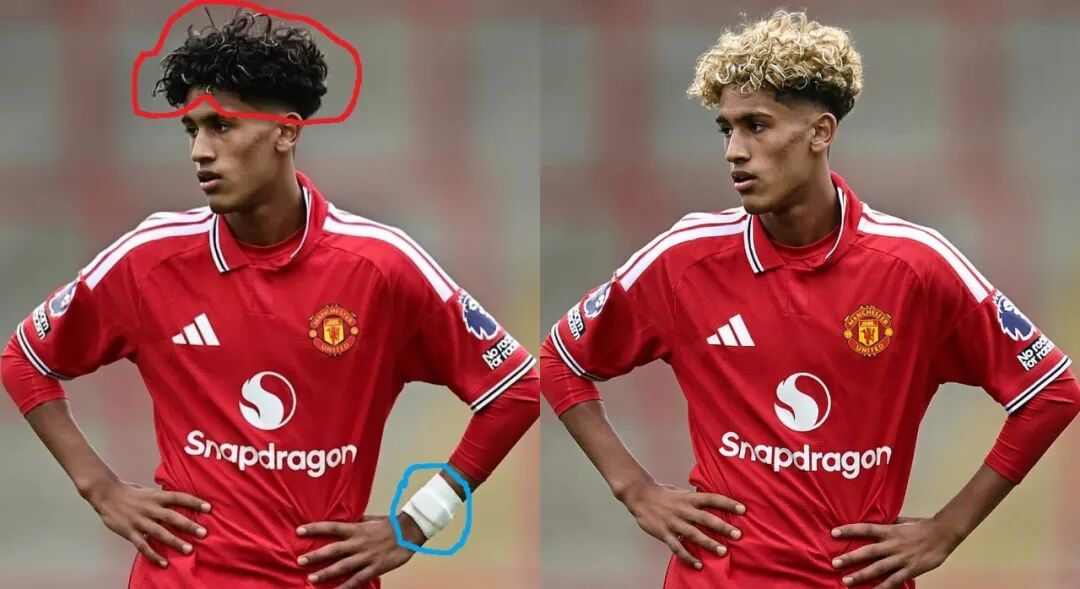
Diese Interaktion stellt eine Zuordnung zwischen räumlichen Positionen und Textanforderungen her. Bei Bearbeitungen, die mehrere Bereiche betreffen, können Benutzer jeweils angeben, wo etwas gelöscht werden soll, wo etwas ersetzt werden soll und was genau geändert werden soll.
Die