Großmodelle beginnen, kollektiv kleiner zu werden
Text von Li Zhaofeng und Wang Xinyi
Redaktionell bearbeitet von Zhang Yuxin
In Shenzhen beschäftigt das KI-Startup-Unternehmen, bei dem Lin Zhou arbeitet, nur zehn Mitarbeiter. Der Großteil der Arbeiten wird von KI erledigt – täglich laufen Hunderte von Agenten gleichzeitig, die getrennt voneinander Code schreiben und Forschungen durchführen.
Die Modelle, die diese Agenten antreiben, waren seit jeher die GPT-Modellreihe von OpenAI.
Doch als das Team den Agenten immer mehr Aufgaben zuwies, stellte Lin Zhou fest, dass GPT nicht mehr Schritt halten konnte: Das damals verwendete GPT 5.6 konnte nur zwei bis drei Aufgaben gleichzeitig verarbeiten. „Die Anzahl der gleichzeitigen Aufgaben, die GPT bewältigen kann, ist begrenzt, was unseren Arbeitsfortschritt behindert“, sagte Lin Zhou. Das Team begann, nach Modellen zu suchen, die mehr Aufgaben gleichzeitig ausführen können und zudem zu niedrigeren Kosten aufgerufen werden können.
DeepSeek V4.1 Flash wurde zur neuen Wahl. Seit September hat das Team Claude und mehrere inländische Modelle getestet und sich schließlich für V4.1 Flash entschieden: Es kann die anstehenden Entwicklungsaufgaben bewältigen, liefert schnellere Rückmeldungen und verursacht niedrigere Aufrufkosten. Laut Lin Zhou ist dies derzeit die Option mit dem besten Preis-Leistungs-Verhältnis.
Früher in diesem Jahr sagte Google-CEO Sundar Pichai auf der Google I/O, dass seinem Kenntnisstand nach einige Unternehmen bis zum Mai bereits fast ihr gesamtes jährliches Token-Budget aufgebraucht hätten. Nehmen wir Google selbst als Beispiel: Der tägliche Token-Verbrauch seiner internen KI-Programmierwerkzeuge stieg von 500 Milliarden im März auf über 3 Billionen im Mai.
Auf genau dieser Konferenz stellte Google dann das schnellere und kostengünstigere Gemini 3.5 Flash vor, das auf alltäglichere Entwicklungs- und Arbeitsszenarien abzielt. Seit diesem Jahr hat der „Hummer“-Hype, der von OpenClaw ausgelöst wurde, auch normale Nutzer dazu veranlasst, Agenten zur Bearbeitung verschiedener Arbeitsaufgaben einzusetzen – dies ist eine alltäglichere, niedrigschwelligere und häufigere Nachfrage als die Programmierung.
Gleichzeitig tauchen immer mehr Modelle mit kleinen Parametern auf. Da die Aufgaben immer zahlreicher werden und die Modelle häufiger aufgerufen werden, entstehen für Nutzer sehr hohe Kosten, wenn sie Flaggschiffmodelle mit mehreren hundert Milliarden oder sogar zwei bis drei Billionen Parametern verwenden. Außerdem sind Modelle mit großen Parametern nicht besonders schnell, was die Wartezeit der Nutzer erheblich verlängert.
Modellanbieter, insbesondere chinesische Modellanbieter, bringen nacheinander Flash-Versionen von Modellen mit kleinen Parametern auf den Markt und konkurrieren genau um diese alltäglichen Anforderungen, die früher ebenfalls von Flaggschiffmodellen erfüllt wurden. „Flash“ bedeutet „Blitz“. Modellanbieter verwenden diese Bezeichnung in der Regel, um schnellere und günstigere Modellversionen zu kennzeichnen: Sie rufen bei jedem Lauf weniger Parameter auf und eignen sich für die wiederholte Bearbeitung alltäglicher Aufgaben. Komplexe Probleme können hingegen weiterhin an Flaggschiffmodelle wie Pro übergeben werden.
Am 31. Juli veröffentlichte DeepSeek die offizielle Version von V4 Flash. Am 26. August traten Qwen3.8-Flash-Next vom Qwen-Team von Alibaba und GLM-5.3-Flash von Zhipu am selben Tag auf. Im September brachte DeepSeek zudem V4.1 Flash auf den Markt. Diese Modelle weisen unterschiedliche Parametergrößen auf, liegen alle im Bereich von hundert Milliarden (im Parameterbereich von 100B bis 500B) und sind weitaus kleiner als die aktuellen Flaggschiffmodelle mit Parametern im Billionenbereich.
Vor zwei Monaten, nach der offiziellen Veröffentlichung von DeepSeek V4 Flash, zeichnete ein Entwickler seine Bewertungsergebnisse und die Kosten für die Aufgabenerfüllung in einem Diagramm auf und stellte die sogenannte „Abschneidelinie“ vor: Modelle, deren Leistung hinter der von V4 Flash zurückbleibt und für dieselbe Aufgabe teurer sind, werden auf diese Weise „abgeschnitten“.
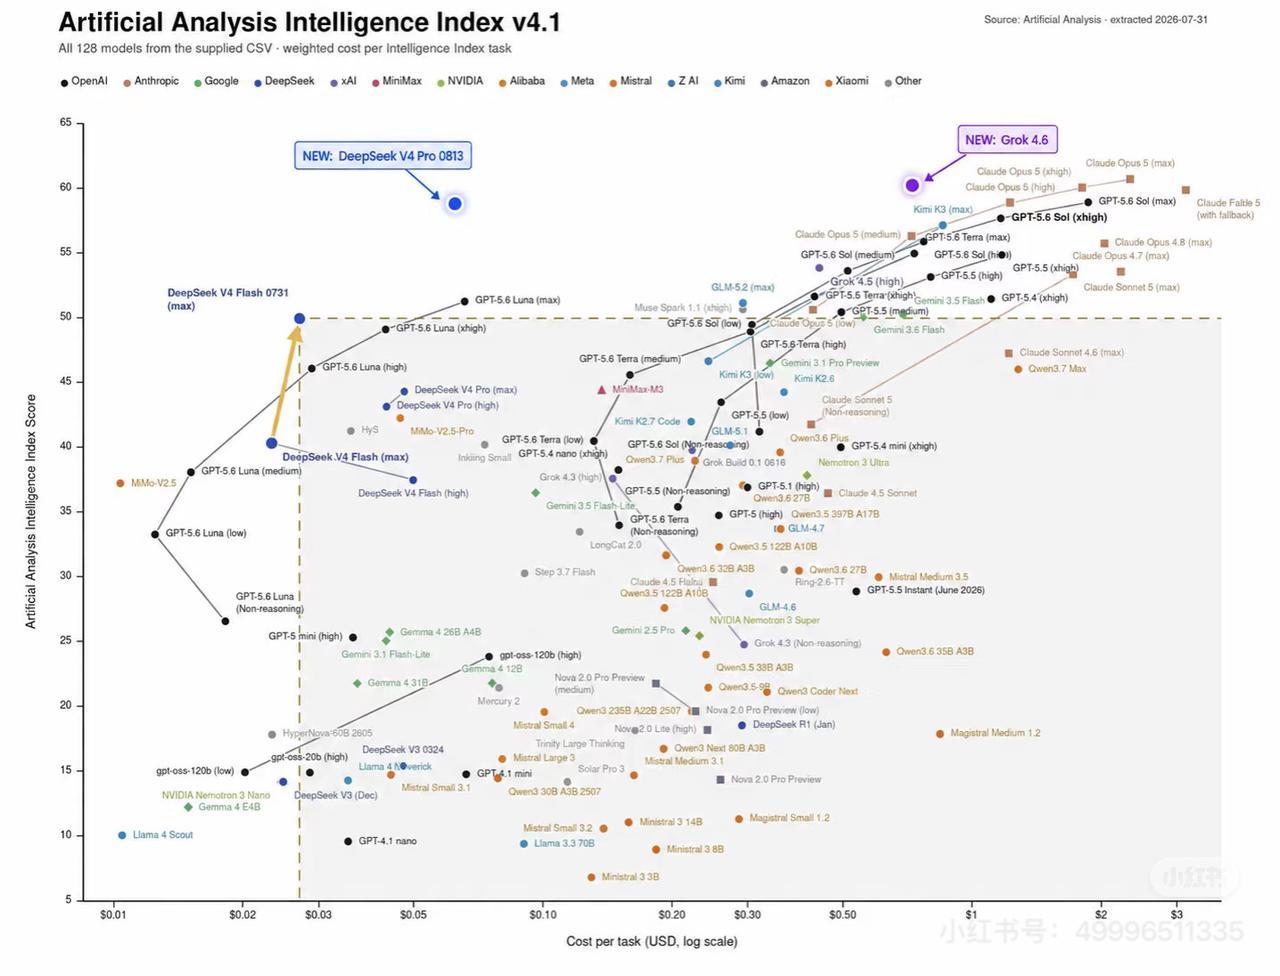
Modelle im grauen Bereich werden von DeepSeek V4 Flash „abgeschnitten“, Quelle: Artificial Analysis
Ende August begann die amerikanische Programmier-Agenten-Plattform Cline, ein nicht näher benanntes Modell kostenlos anzubieten. Laut Cline übernahm dieses Modell innerhalb weniger Wochen mehr als 11 % der Inferenzleistung der Plattform. Anschließend bestätigte Zhipu die Urheberschaft dieses Modells, das genau das später veröffentlichte GLM-5.3-Flash ist. Zuvor sprach Tang Jie, Gründer von Zhipu, auf einer Leistungssitzung über das nächste Modell und sagte, das Unternehmen werde „kein großes und nutzloses Modell entwickeln“.
Tatsächlich wächst das Lager der „kleinen Modelle“ stetig weiter. Intelligent Emergence hat erfahren, dass sowohl Moonlight AI als auch Tencent Hunyuan die Entwicklung von Flash-Modellversionen vorantreiben.
Auf der anderen Seite hat der Kapitalmarkt in diesem Jahr bereits hohe Wetten auf chinesische Modellunternehmen platziert. Vor diesem Hintergrund wird die Kommerzialisierung zu einer noch realeren Herausforderung.
Öffentlichen Daten zufolge belief sich das jährliche annualisierte Umsatzvolumen (ARR) von Zhipu bis August dieses Jahres auf etwa 1,6 Milliarden US-Dollar, wobei das Umsatzmultiplum bis zu 46-fach beträgt. Das noch nicht börsennotierte DeepSeek weist eine Bewertung auf, die sogar 163-fach über seinem geschätzten annualisierten Umsatz liegt. Auf der anderen Seite des Pazifiks beträgt das Umsatzmultiplum von Anthropic etwa das 20-fache. Chinesische Modellunternehmen haben auf dem Weg zur Kommerzialisierung noch einen weiten Weg vor sich.
Daher hat der Wettbewerb zwischen Modellen aus China und den USA eine weitere Hauptlinie hervorgebracht: Wer kann Modelle mit besserem Preis-Leistungs-Verhältnis dazu bringen, mehr echte Aufgaben zu erledigen und mehr Nutzer zu bedienen, während man weiterhin nach AGI strebt und die Obergrenze der Modellfähigkeiten anstrebt? Wer kann mit kostengünstigen Modellen einen größeren Markt erschließen und mehr Einnahmen erzielen?
01 Eine Revolution der Effizienz von Modellen
Nach dem Wechsel des Modells war eine der spürbaren Verbesserungen für Lin Zhou, dass die Antwortgeschwindigkeit des Modells deutlich gestiegen ist.
Das Team muss oft Dutzende von Agenten gleichzeitig Code schreiben lassen, wobei er den Fortschritt verfolgt und Anweisungen anpasst. Wenn er merkt, dass die Richtung nicht stimmt, lässt er das Modell sofort Änderungen vornehmen. Bei der früheren Verwendung von Codex musste er oft warten, bis das Modell einen langen Text ausgegeben hat, um korrigierend eingreifen zu können. „Egal ob Sie das CLI-Format oder die native App verwenden, die Antwort dauert sehr lange.“ Bei langen Projekten muss das Modell zudem den vorherigen Gesprächsverlauf zusammenfassen, was bei der Verwendung von GPT-5.6 weitere Wartezeit verursacht. „Aber nach dem Wechsel zu V4.1 Flash reagiert es sofort auf alles, was man ihm sagt.“
In diesem Jahr ist das Scaling Law nach wie vor die Hauptlinie bei der Entwicklung großer Modelle. Das in diesem Jahr veröffentlichte Qwen3.8-Max verfügt über insgesamt 2,4 Billionen Parameter, Kimi K3 über 2,8 Billionen. Nach den von Elon Musk im April dieses Jahres offengelegten Vergleichsdaten zu schätzen, verfügte das damalige Claude Opus über etwa 5 Billionen Parameter, obwohl Anthropic diese Zahl nicht bestätigt hat.
Diese Supermodelle haben zwar höhere Intelligenzniveaus erreicht, aber größere Grundmodelle erfordern mehr Ressourcen für Training und Bereitstellung. Wenn Modelle im Agenten-Szenario wiederholt aufgerufen werden, steigen die Kosten für die Nutzung der Modelle exponentiell an.
Nach dem Wechsel zu V4.1 Flash war eine weitere deutliche Beobachtung von Lin Zhou, dass die Aufrufkosten stark gesunken sind. Er führte das Beispiel der Entwicklung kleiner Anwendungen durch das Team an: Ein Mitarbeiter hat die Entwicklung allein abgeschlossen, und „für etwa drei bis vier US-Dollar ist eine kleine App fertiggestellt“.
Die wöchentliche Rangliste der Modell-Serviceplattform Requesty vom August zeigt, dass DeepSeek V4 Flash etwa ein Drittel des tatsächlichen Token-Verbrauchs auf der Plattform ausmacht und an der Spitze aller Modelle steht. In früheren unabhängigen Bewertungen lag sein Gesamtergebnis nahe dem der hohen Inferenzversion des amerikanischen GPT-5.6 Luna, während die Kosten für die Erledigung derselben Aufgabengruppe um etwa 60 % niedriger sind.
„Modellunternehmen beginnen nun, sich stärker auf die tatsächliche Marktnachfrage zu konzentrieren und den Stimmen der Entwickler mehr Gehör zu schenken“, sagte ein Forscher für Basismodelle gegenüber Intelligent Emergence. Ein Durchgang des Trainings kleiner Modelle erfordert weniger Zeit und Ressourcen, sodass Nutzer schneller sehen können, ob die Ergebnisse, die sie mit dem Modell erzielen, machbar sind und angepasst werden müssen. „Mit kleinen Modellen kann man Entwicklungen schneller iterieren und schneller Erkenntnisse gewinnen.“
In der täglichen Arbeit wählt dieser Forscher selbst auch Modelle entsprechend den Aufgabenanforderungen aus. Als Beispiel nennt er einfache aber arbeitsintensive Aufgaben wie das Ändern von Experimentalskripten: Die Bearbeitung durch GPT dauert möglicherweise 20 Minuten, während DeepSeek V4 Flash nur 2 Minuten benötigt. „Da die Aufgabe nicht besonders schwierig ist, möchte ich nur, dass das Modell die Arbeit schnellstmöglich erledigt.“
Angetrieben durch solche Nutzerszenarien liegen die meisten der kürzlich veröffentlichten Flash-Modelle unter 400B (B steht für Milliarden Parameter): DeepSeek V4 Flash verfügt über insgesamt 284B Parameter, GLM-5.3-Flash über insgesamt 320B Parameter und das Hauptmodell von Qwen3.8-Flash-Next über 125B Parameter.
„Aus Sicht des Trainings unterscheiden sich die Fähigkeiten von Modellen mit 300B und etwas größeren Modellen möglicherweise kaum“, sagte dieser Forscher. Er hat selbst Trainingsexperimente mit verschiedenen Modellgrößen durchgeführt. Mit den von ihm verwendeten Datensätzen und Trainingsschemata kann ein Modell mit etwa 300B Parametern bereits die langen Inferenzketten lernen, die von größeren Modellen ausgegeben werden.
Eine im Jahr 2025 in „Nature Machine Intelligence“ veröffentlichte Studie hat 51 Open-Source-Modelle analysiert und festgestellt, dass die Anzahl der erforderlichen Parameter immer geringer wird, um ähnliche Ergebnisse in fünf Tests wie Wissen, Schlussfolgerung, Mathematik und Code zu erzielen. Die Forscher nennen dies die Erhöhung der „Fähigkeitsdichte“: Ein Modell gleicher Größe kann mehr Aufgaben erledigen.
Qwen3.8-27B ist ein aktuelles Beispiel. In der von Qwen veröffentlichten Testreihe erzielte es im Programmiertest SWE-bench Pro 61,7 Punkte, während das gleich große Modell der vorherigen Generation 53,5 Punkte erreichte. Im Langzeit-Büroarbeitstest CoWorkBench erzielte es 70,7 Punkte, die vorherige Generation 61,0 Punkte.
Die Probleme, die Modelle lösen sollen, ändern sich ebenfalls mit den Nutzern. Dieser Forscher erläutert das Beispiel: Programmierprodukte beantworten häufig Fragen von Programmierern, wie sie Code schreiben und Projekte verwalten. Im Büroarbeitsbereich lauten die Fragen hingegen „Was mache ich, wenn ich die Excel-Formel vergessen habe?“ oder „Wie schreibe ich diese wissenschaftliche Arbeit?“.
Die grundlegende Arbeit kann nach wie vor darin bestehen, Code zu schreiben, aber die Komplexität der tatsächlich zu erledigenden Arbeit kann abnehmen. Von Code zu Work findet eine Revolution der Effizienz und Kosten von Modellen statt.
02 Von der „Programmierung“ zur „täglichen Büroarbeit“
„Ich denke, es werden zwei Wege geben“, so bewertet ein Gründer eines Code-Agenten-Startups die derzeitige Aufteilung von Agenten in die beiden Produktkategorien „Programmierung“ und „Büroarbeit“. Sowohl Programmier- als auch Büroarbeitsprodukte erfordern, dass Modelle Anweisungen verstehen, Code schreiben und Werkzeuge aufrufen, richten sich aber an unterschiedliche Nutzergruppen. Seiner Meinung nach müssen Büroarbeitsprodukte für normale Nutzer „absolut kostensparend und ein Höchstmaß an Preis-Leistungs-Verhältnis bieten“.
Im Januar dieses Jahres sprach Yao Shunyu, Leiter von Tencent Hunyuan, auf dem AGI-Next-Gipfel über die Unterschiede in den Nutzeranforderungen: Unternehmen sind bei produktiven Aufgaben nach wie vor bereit, die leistungsstärksten Modelle zu verwenden, während normale Nutzer dies in den meisten Fällen nicht benötigen.
Die Art und Weise, wie die beiden Nutzergruppen Modelle auswählen, ist ebenfalls unterschiedlich. „Programmierer können selbst unterscheiden, für welche Aufgaben sie teurere Modelle und für welche sie günstigere Modelle verwenden.“ Normale Nutzer wissen möglicherweise nicht, welche Leistung ein Modell für die Verarbeitung von Tabellen oder das Erstellen von Berichten benötigt. Der genannte Gründer sagte: „Dies ist ein Problem, das die Produktmanager von Büro-Agenten lösen müssen.“
Im Januar dieses Jahres brachte Anthropic Claude Cowork auf den Markt, sodass Agenten, die ursprünglich hauptsächlich beim Schreiben von Code unterstützten, auch Desktop-Büroaufgaben bearbeiten können. Anschließend veröffentlichte OpenAI ChatGPT Work, mit dem Nutzer direkt eine Arbeitsaufgabe zuweisen können, ohne schrittweise im Dialogfeld Fragen stellen zu müssen.
Gleichzeitig haben sich auch inländische Produkte von der Programmierung zur Büroarbeit weiterentwickelt. Im März brachte das CodeBuddy-Team von Tencent Cloud WorkBuddy auf den Markt. Im August integrierte Alibaba QoderWork, Wukong und MuleRun zu Qianwen Office. Zur gleichen Zeit integrierte ByteDance die Büroarbeitsfähigkeiten von Produkten wie Feishu und TRAE Work in Doubao und veröffentlichte „Doubao Work“.
Ein Bericht von QuestMobile zeigt, dass Tencent WorkBuddy im Juli 2026 6,582 Millionen monatlich aktive Nutzer hatte. Die Nutzer des PC-Clients nutzten das Produkt im Durchschnitt 19 Mal in diesem Monat.
Angesichts von Millionen Nutzern, die ständig alltägliche Aufgaben zuweisen, können Büro-Agenten Modelle nicht nur nach den Standards komplexer Programmierung auswählen. In einigen Nutzer-Communitys von WorkBuddy bewerten Nutzer DeepSeek V4 Flash und GLM-5.3-Flash wie folgt: „Mit diesen beiden Flash-Modellen reicht die Leistung für die meisten Arbeiten grundsätzlich aus.“ Auf Unternehmensebene gab eine mit Zhipu vertraute Person an, dass viele Unternehmenskunden nach der Veröffentlichung von GLM-5.3-Flash großes Interesse an diesem Modell mit 320 Milliarden Parametern zeigten.
In den tatsächlichen Nutzungsszenarien von Büro-Agenten können die Modelle, die Aufgaben ausführen, sogar noch kleiner sein, bis hin zum Bereich von zehn Milliarden Parametern.
YuanKong Intelligence, ein Startup, das sich auf Büro-Agenten spezialisiert hat, hat bereits Modelle mit mehreren zehn Milliarden Parametern in YuanKong AI Work eingesetzt. Das Team führt nachträgliches Training auf Basis von Open-Source-Modellen durch, sodass diese spezialisiertere Aufgaben bearbe