Mit bloßem Auge nicht sichtbare Halluzinationen? Die Tsinghua-Universität schlägt eine visuelle Quellhalluzination vor und erreicht SOTA mit nur 0,9 % der Daten.
Die Objekthalluzination multimodaler großer Modelle wurde lange Zeit auf den Sprachprior zurückgeführt.
Sehen Sie sich zunächst die folgenden zwei Dialoggruppen an.
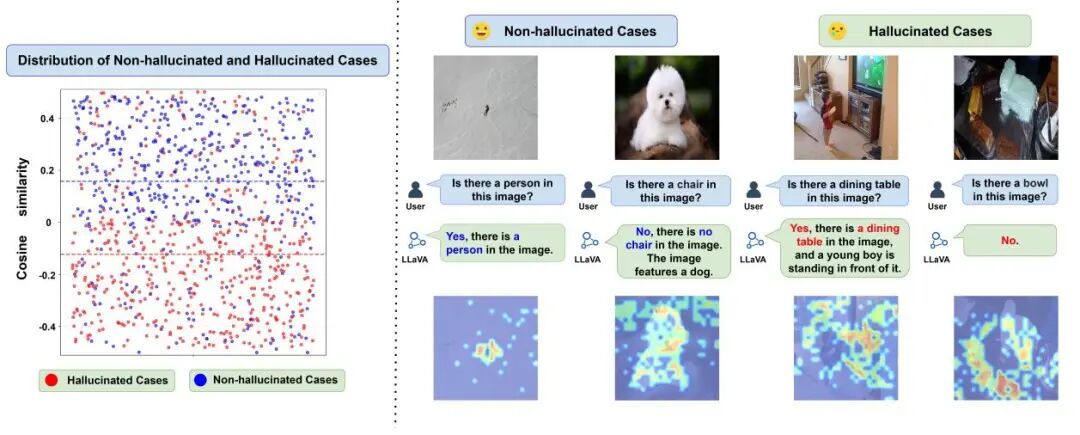
Bei der ersten Gruppe: Auf einem Foto, das nur einen kleinen Hund zeigt, wird das Modell gefragt „Ist ein Stuhl im Bild?“, und es antwortet „Nein, im Bild ist ein Hund“, was völlig korrekt ist;
Bei der zweiten Gruppe: Auf einem anderen Foto wird gefragt „Ist ein Esstisch im Bild?“, und das Modell antwortet überzeugt „Es gibt einen Esstisch, und ein Junge steht davor“, obwohl im Bild überhaupt kein Esstisch zu sehen ist.
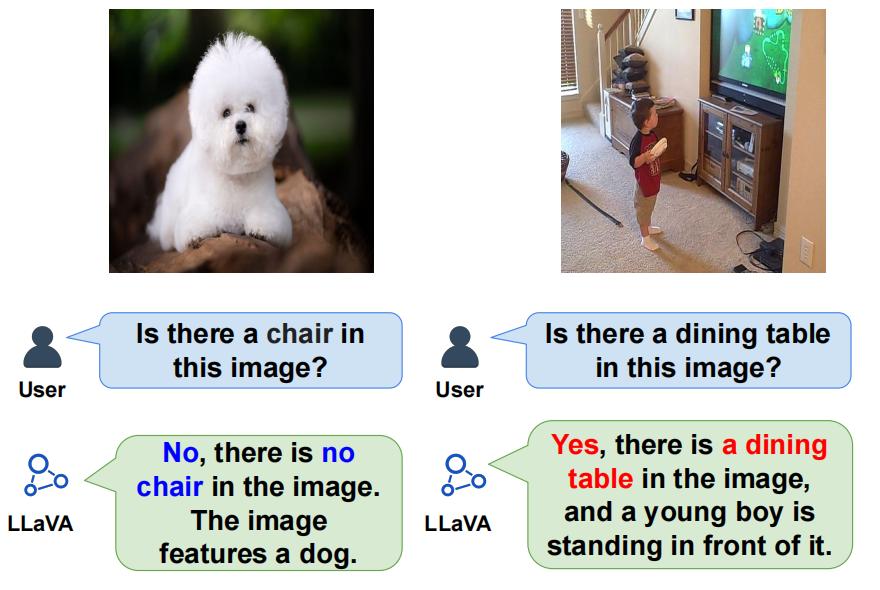
Dies ist die Objekthalluzination, die die praktische Anwendung multimodaler großer Modelle (MLLM) behindert: Das Modell „sieht“ Objekte, die nicht existieren, oder übersieht Objekte, die eindeutig vorhanden sind. In hochriskanten Szenarien wie automatisiertem Fahren oder medizinischer Unterstützung können die Kosten solcher Fehler sehr hoch sein.
Die vorherrschende Erklärung in der Vergangenheit lautet: Das liegt alles am Sprachprior.
Das Modell hat in den Trainingskorpora häufig gesehen, dass „Esstisch“ und „Junge“ gemeinsam auftreten, also gibt es die Antwort entsprechend den sprachlichen statistischen Regeln aus, auch wenn sie nicht im Bild zu sehen sind.
Aber das Forschungsteam der Tsinghua-Universität ist der Ansicht, dass diese Erklärung nicht vollständig ist.
Kürzlich hat das Team der Tsinghua-Universität in einem Papier auf der ACM MM 2026 (der 34. Internationalen ACM-Konferenz für Multimedia) vorgeschlagen: Wenn die Ausgabe des Modells sehr kurz ist, z. B. nur mit Ja/Nein antwortet, hängt die Inferenz stärker von der visuellen Modalität ab. Zu diesem Zeitpunkt tritt ein anderer Halluzinationsmechanismus auf, der in der Extraktion visueller Merkmale selbst verwurzelt ist.
Die Forscher nannten dies Halluzination mit visueller Herkunft (visual-origin hallucination) und schlugen die entsprechende Lösung ACFT vor.
Link zum Papier: http://arxiv.org/abs/2609.00231
Link zum Code: https://github.com/zxp555/ACFT_MM26
Experimente zeigen, dass ACFT nur 0,9 % der Datenmenge des COCO-Datensatzes verwendet und keinen zusätzlichen Inferenzaufwand erzeugt, und erzielte hervorragende Ergebnisse auf den drei Modellen LLaVA, MiniGPT-4 und Qwen2.5-VL bei POPE, MME und vier beschreibenden Halluzinations-Benchmarks.
Forschungshintergrund
Objekthalluzination war schon immer das zentrale Hindernis für die Zuverlässigkeit von MLLM. Die meisten vorhandenen Arbeiten verfolgen die Linie des „Sprachpriors“: Einige führen sie auf die übermäßige Abhängigkeit von der Statistik des gemeinsamen Auftretens von Text zurück, einige lokalisieren sie in „Halluzinations-Aufmerksamkeitsköpfen“, die speziell auf Text-Token achten, einige weisen auf das Phänomen der Aufmerksamkeitskonvergenz von Zusammenfassungs-Token hin, und andere sind der Ansicht, dass die Überwachung der feingranularen Inferenz unzureichend ist.
Dementsprechend werden die Linderungsmethoden nach dem Interventionsort in mehrere Kategorien unterteilt: VCD, OPERA und andere führen Eingriffsmaßnahmen auf Eingabeebene in der Dekodierungsphase durch; Woodpecker nutzt ein externes Grounding-Modul für die Nachverarbeitung der Ausgabe; sowie Post-Training-Ausrichtungsmethoden wie RLHF und DPO.
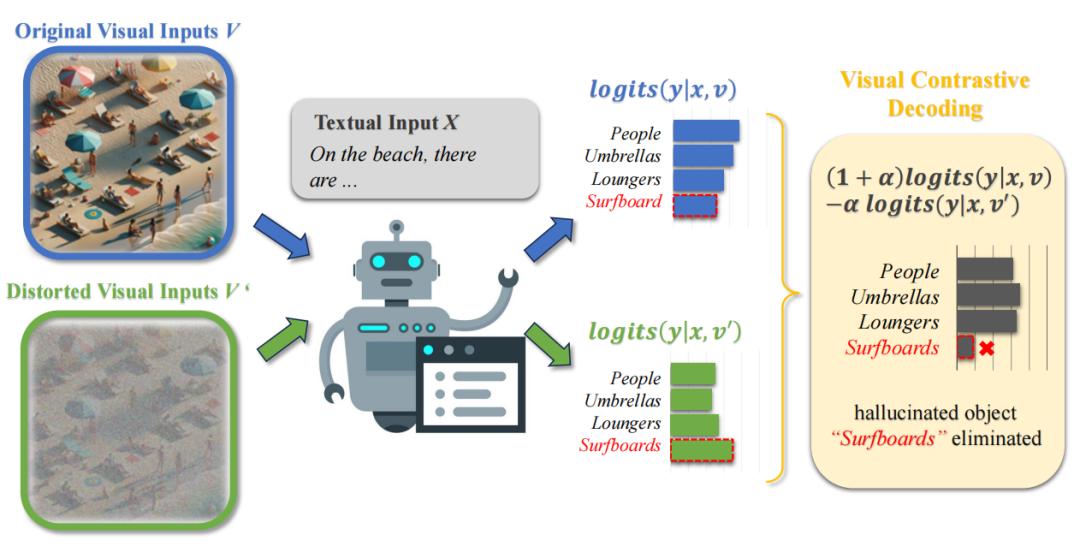
Aber diese Methoden haben eine gemeinsame Voraussetzung: Halluzinationen stammen hauptsächlich von der Verzerrung auf der Textseite. Diese Annahme trifft in Szenarien mit langen Textausgaben (z. B. „Beschreibe dieses Bild detailliert“) tatsächlich zu, da der umfangreiche Kontext die sprachlichen Verzerrungen verstärkt.
Das Problem besteht darin, dass wenn die Ausgabe zu einer kurzen Antwort „Ja/Nein“ wird, die Wirkung des Sprachpriors stark abnimmt und die Wirkung dieser Methoden ebenfalls abnimmt. Woher stammen dann die Halluzinationen zu diesem Zeitpunkt?
Forschungsmethoden
Schritt 1: Diagnose – Gibt es Halluzinationen mit visueller Herkunft?
Die Forscher führten zwei komplementäre Analysen auf LLaVA v1.5 durch und lieferten quantitative Beweise.
Erkenntnis 1: Fehlausrichtung von Bild- und Texteinbettungen.
Die Kosinusähnlichkeit der Bild-Text-Einbettungen von Halluzinationsproben ist signifikant niedriger als die von korrekten Proben. Der Durchschnittswert korrekter Proben beträgt 0,158, der von Halluzinationsproben beträgt −0,122, was zeigt, dass die crossmodale Ausrichtung systematisch zusammenbricht.
Erkenntnis 2: Umkehrung des Aufmerksamkeitsmusters.
Die Forscher visualisierten die Aufmerksamkeit des Modells mit Smooth Grad-CAM und definierten einen Verteilungsstandard für „semantische Plausibilität“: Wenn das Zielobjekt vorhanden ist, sollte die Aufmerksamkeit auf den Zielbereich konzentriert werden; wenn das Zielobjekt nicht vorhanden ist, sollte die Aufmerksamkeit verteilt werden.
Nach der Quantifizierung mit normalisierter Shannon-Entropie an 500 Halluzinationsproben und 500 Nicht-Halluzinationsproben wurde festgestellt, dass das halluzinierende Modell dieses Muster systematisch verletzt: Wenn das Objekt vorhanden ist, ist der Entropiewert um 5,1 % höher, was zeigt, dass die Aufmerksamkeit übermäßig verteilt ist und das Ziel verpasst wird; wenn das Objekt nicht vorhanden ist, ist der Entropiewert um 6,2 % niedriger, was zeigt, dass das Modell sich fälschlicherweise auf irrelevante Bereiche konzentriert und dadurch Halluzinationen auslöst.
Kausale Überprüfung. Um zu bestätigen, dass dies nicht nur eine Korrelation ist, griffen die Forscher direkt in den visuellen Encoder ein: Durch Hinzufügen von Gaußschem Rauschen, Herunterabtastung oder Verwendung eines schwächeren Encoders sank die durchschnittliche Genauigkeit von POPE von 0,842 auf 0,739 bis 0,822; umgekehrt stieg die Genauigkeit bei Verwendung des stärkeren SigLIP-SO400M-Encoders auf 0,864. Dies liefert eine kausale Unterstützung dafür, dass die Qualität visueller Merkmale die Halluzination bezüglich der Existenz von Objekten antreibt.
Schritt 2: AHAF – Umkehren der Halluzinationseigenschaften durch antagonistische Störungen
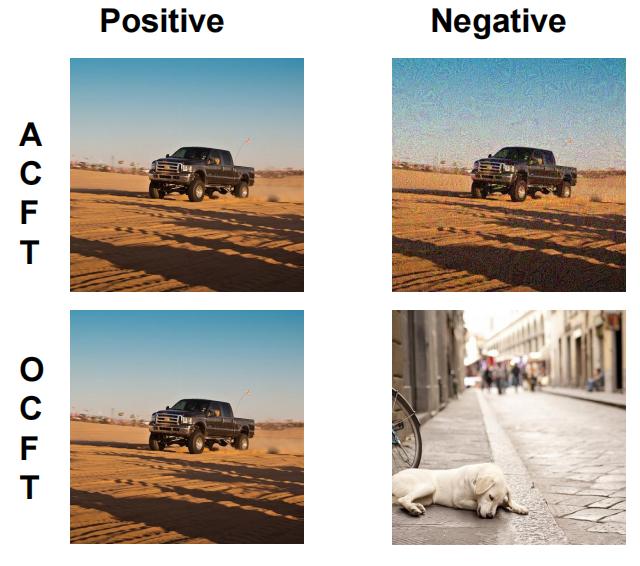
Die Diagnose weist auf eine visuelle Fehlausrichtung hin, sodass kontrastives Lernen der direkteste Korrekturansatz ist. Die Forscher stellten jedoch fest, dass gewöhnliches kontrastives Feinschweifen (OCFT), d. h. das Verwenden des passenden Bildes als positive Probe und das zufällige Auswählen eines irrelevanten Bildes als negative Probe, keine zufriedenstellenden Ergebnisse liefert.
Der Grund dafür ist: Die Merkmalsunterschiede zwischen positiven und negativen Proben sind nicht kontrollierbar und konzentrieren sich nicht auf das Zielobjekt, sodass das Modell kaum lernen kann, welche visuellen Merkmale genau die Halluzination auslösen.
Aus diesem Grund schlugen die Forscher AHAF (Adversarial Hallucination Attribute Flipping, Umkehren von Eigenschaften antagonistische Halluzinationen) vor: Mit PGD werden gerichtete antagonistische Störungen auf das Originalbild innerhalb eines sehr kleinen ℓ∞-Balls ausgeübt, um ein Bild, das keine Halluzination auslöst, in ein Bild umzuwandeln, das eine Halluzination auslöst. Die so erzeugten Paare von positiven und negativen Proben sind vollständig ausgerichtet, und der einzige Unterschied ist die kontrollierte Störung.
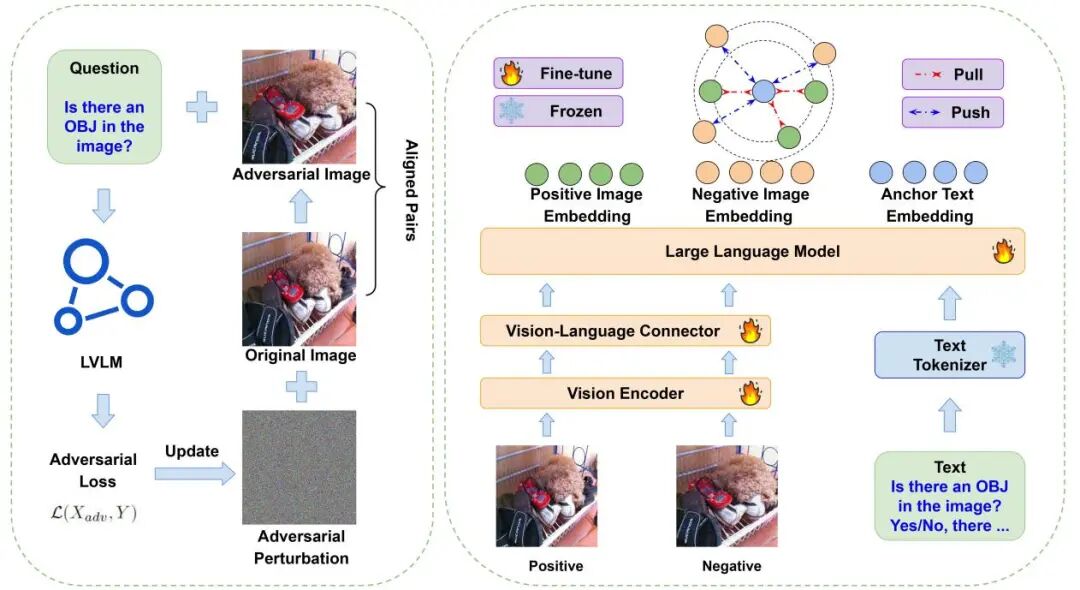
AHAF hat einen zusätzlichen Nutzen als Nebenprodukt: Es dient gleichzeitig als Diagnosesonde. Eine sehr kleine pixelweise Störung reicht aus, um die Antwort des Modells umzukehren, was zeigt, dass die visuelle Repräsentation von MLLM selbst bei sauberen Bildern bereits gefährlich nah an der Entscheidungsgrenze für Halluzinationen liegt – dieses Phänomen bestätigt wiederum die Diagnose der „Halluzination mit visueller Herkunft“.
Schritt 3: ACFT – Antagonistisches kontrastives Feinschweifen
Auf der Grundlage der aus AHAF erzeugten ausgerichteten Probenpaare entwarfen die Forscher ACFT (Adversarial Contrastive Fine-Tuning): Im Einbettungsraum wird die Ähnlichkeit zwischen dem Textanker und dem Bild der positiven Probe maximiert, während gleichzeitig die Ähnlichkeit zwischen ihm und dem Bild der negativen Probe minimiert wird.
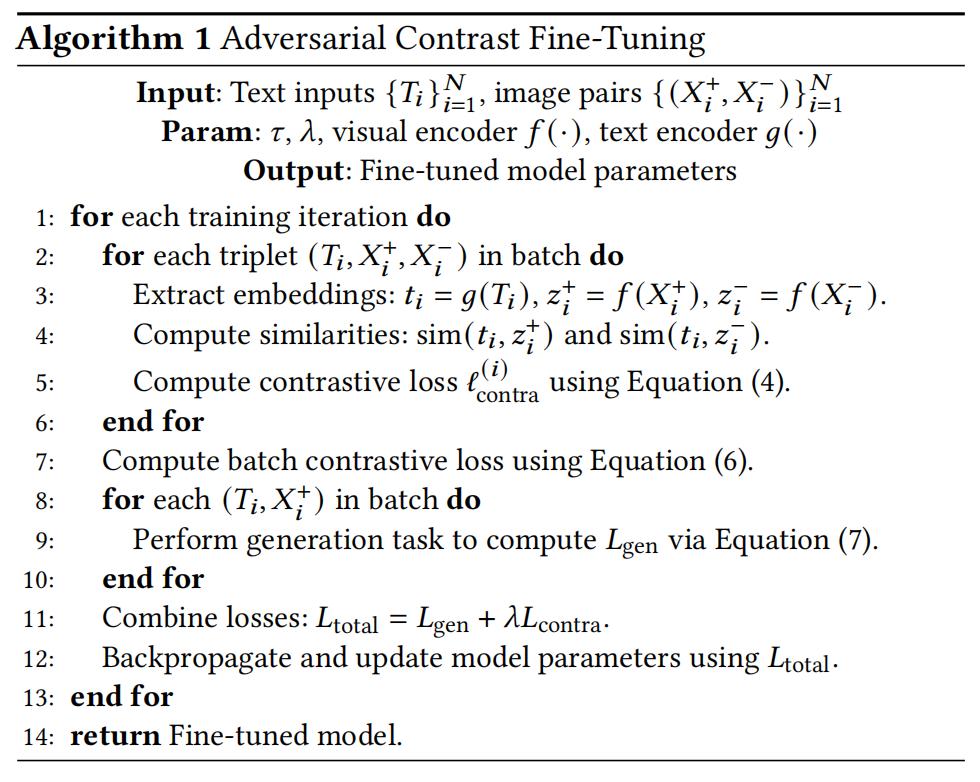
Die gesamte Methode hat drei technische Vorteile: Sie ist nicht von einer bestimmten Backbone-Architektur abhängig, erfordert nur eine kleine Datenmenge und wird vollständig in der Trainingsphase abgeschlossen, sodass keine zusätzliche Belastung während der Inferenz entsteht.
Experimentelle Ergebnisse
Die Forscher führten eine systematische Bewertung auf den drei Modellen LLaVA v1.5-7B, MiniGPT-4 13B und Qwen2.5-VL-7B durch. Die Benchmarks umfassen POPE und MME. Der Grund für die Auswahl dieser beiden Benchmarks ist, dass alle Fragen nur mit Ja/Nein beantwortet werden, was genau dem Szenario kurzer Ausgaben entspricht, auf das sich diese Arbeit konzentriert.
Hauptexperiment: POPE
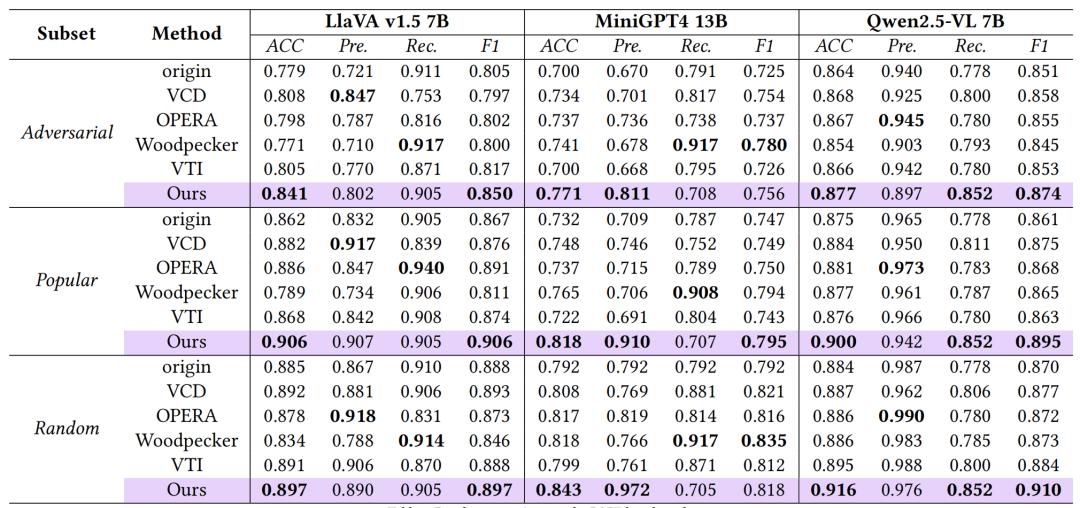
Auf LLaVA erzielte ACFT Genauigkeiten von 0,841, 0,906 und 0,897 in den drei Teilmengen, was um 3,3 %, 2,0 % und 0,5 % höher ist als der zweitbeste Baseline-Wert; auf MiniGPT-4 lag es um 3,0 %, 5,3 % und 2,5 % vor dem zweitbesten Baseline-Wert; auf Qwen2.5-VL, dessen eigene Baseline bereits sehr stark ist, stiegen die Genauigkeiten von 0,864, 0,875 und 0,884 auf 0,877, 0,900 und 0,916 an.
Wichtige Ablationsstudie: Wie wichtig sind ausgerichtete Probenpaare wirklich?
Dies ist die aussagekräftigste Vergleichsgruppe in dem Papier. Die Forscher verwendeten dieselben 3000 COCO-Bilder, um OCFT und ACFT jeweils zu trainieren.
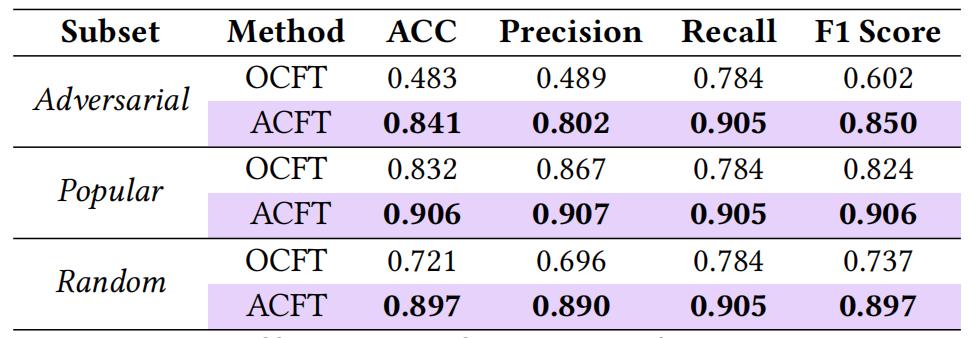
Das Ergebnis lautet: Die Genauigkeit von ACFT in den drei Teilmengen ist um 35,8 %, 7,4 % und 17,6 % höher als die von OCFT.
Besonders in der Adversarial-Teilmenge erreicht OCFT nur eine Genauigkeit von 0,483, was sogar weit unter dem Wert des ursprünglichen, nicht feingeschweiften LLaVA-Modells liegt. Dies zeigt, dass nicht ausgerichtete negative Proben nicht nur nicht nützlich sind, sondern sogar schädlich.