Es geht gerade viral: Warum greifen alle eifrig zu Jev, das von einem ehemaligen OpenAI-Forscher entwickelt wurde?
Redaktion von Synced
Vor kurzem tauchte in der KI-Szene ein neuer Name auf: Jev.
https://typesafe.ai/blog/introducing-system-one-models-and-jev
In den letzten Tagen wurde Jev auf X, GitHub und in den Entwicklergemeinschaften für Agenten schnell viral. Einige Nutzer nutzten es, um 724 Echtzeit-Werbeanzeigen in 40 Sekunden zu analysieren, andere schlossen es an Claude Code an, um den Kontext zu bereinigen, wieder andere verwendeten es für die Aufgabenprüfung von KI-Agenten, und weitere Entwickler integrierten Jev in Browser-Agenten, um damit zu entscheiden, welche Schaltfläche als Nächstes angeklickt und welche Seite aufgerufen werden soll.
Auch LangChain zog schnell nach und veröffentlichte am 20. September ein Experiment zu Jev-as-a-Judge, um seine Leistung als Agenten-Bewerter zu testen.
Sogar Tibo, der unter dem Spitznamen „Gott des Zurücksetzens“ bei OpenAI bekannt ist, hat für Jev geworben.
Was ist Jev eigentlich?
Einfach ausgedrückt handelt es sich um eine KI, die speziell für „Entscheidungsfragen“ entwickelt wurde.
Am 15. September veröffentlichte TypeSafe AI Jev offiziell und bezeichnete diese Modellkategorie als „System One Models“. Nach der Definition von TypeSafe erhält diese Art von Modell einen Programmstatus oder Textinformationen und gibt schnell ein strukturiertes Entscheidungsergebnis sowie die entsprechende Wahrscheinlichkeit zurück.
Wir haben bereits über Jev berichtet, als es gerade veröffentlicht wurde. Einige Tage später ist seine Popularität noch einmal gestiegen, und die zugehörigen Tweets wurden bereits von 37 Millionen Menschen angesehen.
Nehmen wir ein Beispiel: Angenommen, ein Kundenservice-System erhält eine E-Mail, können Entwickler Jev gleichzeitig folgende Fragen beantworten lassen: „Ist das ein Verkaufslead?“, „Ist die Stimmung des Nutzers aufgebracht?“, „Ist menschliches Eingreifen erforderlich?“, „Handelt es sich um ein Rechnungs-, Technik- oder Verkaufsproblem?“
Jev gibt möglicherweise eine Reihe von Wahrscheinlichkeiten zurück: Verkaufslead: 0,91; menschliches Eingreifen erforderlich: 0,12; Technikproblem: 0,83. Die Anwendung kann sofort auf Basis dieser Zahlen mit dem nächsten Arbeitsschritt fortfahren.
Matija Sosic, Mitbegründer und CEO von Wasp, hat ebenfalls ein 45-sekündiges Erklärvideo zu Jev auf X veröffentlicht.
Derzeit bietet Jev drei zentrale Entscheidungsformen an: Noul, Choice und Score. Noul ist für Ja/Nein-Entscheidungen zuständig, Choice wählt die Antwort aus vorgegebenen Optionen aus, und Score bewertet nach vordefinierten Kriterien. Jedes Ergebnis wird mit einer Wahrscheinlichkeit oder einem Konfidenzwert geliefert, und mehrere Fragen können gleichzeitig auf Basis derselben Eingabe ausgewertet werden.
Durch dieses Design hat Jev schnell ein Anwendungsszenario mit explosivem Wachstum gefunden: als „Schiedsrichter“ für Agenten.
Heutige KI-Agenten müssen oft Dutzende oder sogar Hunderte von Schritten nacheinander ausführen. Nach dem Schreiben von Code, dem Aufrufen von Tools, der Suche im Internet und dem Ändern von Dateien muss das System zudem beurteilen, ob die Aufgabe abgeschlossen ist. Diese Art von Problemen passt genau zur Arbeitsweise von Jev.
Entwickler können das Ausführungsprotokoll des Agenten an Jev übergeben und dann fragen: „Ist das Ziel erreicht?“, „Entspricht das Ergebnis den Anforderungen?“, „Gibt es etwas, das übersehen wurde?“, „Zu welcher Kategorie gehört die Qualität des aktuellen Ergebnisses?“
Das neu vorgestellte Experiment von LangChain folgt einem ähnlichen Ansatz. Sie ließen Jev, GPT-5.6 Luna, GPT-5.6 Terra und Claude Sonnet 4.6 die festgelegten Ausgaben des Agenten wiederholt bewerten. In dieser kleinen Versuchsreihe dauerte ein durchschnittlicher Aufruf von Jev etwa 0,44 Sekunden, die Kosten lagen bei etwa 0,00035 US-Dollar, und es zeigte eine herausragende Konsistenz bei fortlaufenden Bewertungen. LangChain betont zudem, dass es sich hierbei noch um frühe Kleinsttests handelt, die in weiteren Agenten und echten Produktionsaufgaben noch validiert werden müssen.
Eine Reihe von Daten zur Werbeanzeigenanalyse hat Jev zudem über die Kreise der KI-Entwickler hinaus bekannt gemacht.
In einem von dem Entwickler Matthew Berman geteilten Experiment nutzte das System Jev, um 724 Echtzeit-Werbeanzeigen von 37 Marken zu analysieren. Es klassifizierte die Hook-Struktur, das Format, das Angebot, die CTA, die Phase der Nutzerwahrnehmung und die Übereinstimmung zwischen Anzeige und Zielseite, wobei insgesamt 8724 Entscheidungen getroffen wurden.
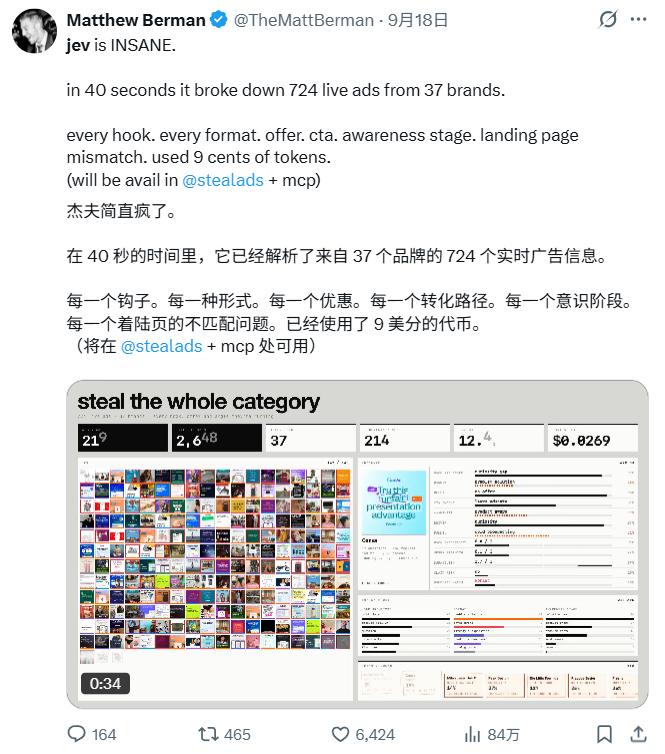
Nach den von den Entwicklern veröffentlichten Daten wurden diese Aufgaben in etwa 40 Sekunden erledigt, die Token-Kosten beliefen sich auf etwa 9 US-Cent, und die mittlere Verarbeitungszeit pro Werbeanzeige lag bei etwa 216 Millisekunden. Die zugehörigen Fälle wurden bereits in die Fallbibliothek der Jev-Gemeinschaft aufgenommen.
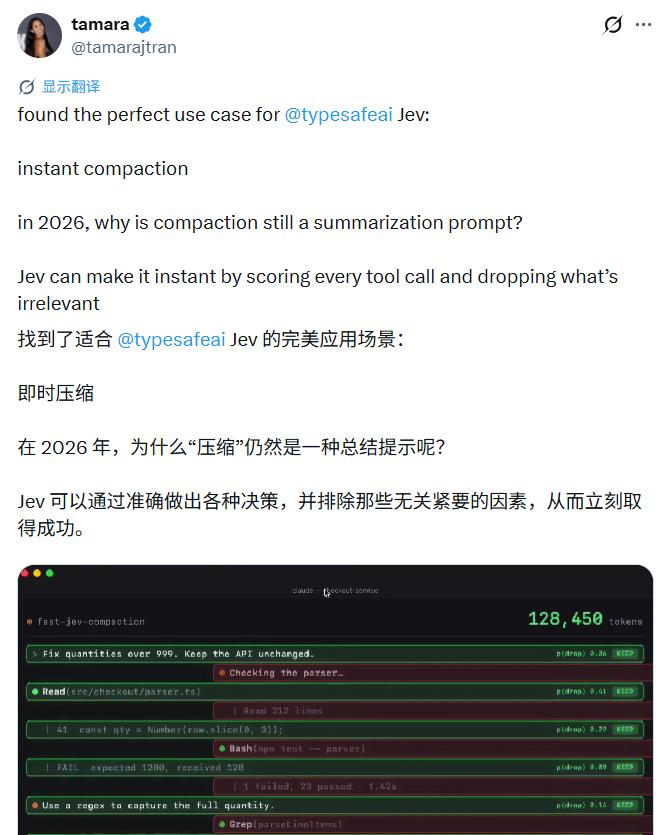
Ein weiteres Projekt, das sich schnell in Entwicklerkreisen verbreitet hat, heißt fast-jev-compaction.
Dieses Claude-Code-Plugin übergibt eine große Anzahl von Tool-Aufrufen und Terminalausgaben an Jev zur Bewertung. Jev beurteilt, welche Inhalte noch mit der aktuellen Aufgabe zusammenhängen, und komprimiert auf Basis der Ergebnisse den Kontext, der an das Modell übermittelt wird. Nach der Veröffentlichung erregte das Projekt schnell große Aufmerksamkeit, und es entstanden mehrere portierte Versionen.
https://github.com/tamaratran/fast-jev-compaction
Auch Browser-Agenten sind zu einem beliebten Experimentierfeld für Jev geworden.
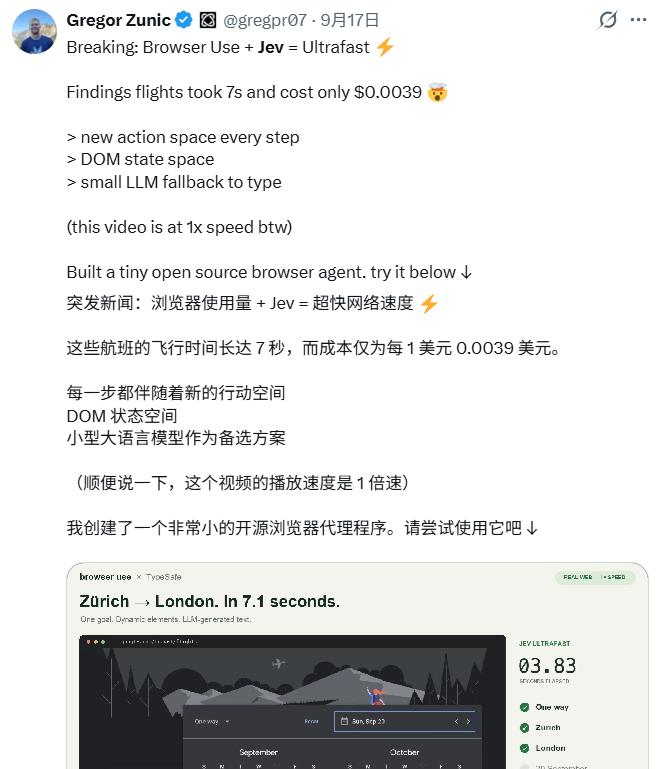
Derzeit gibt es mehrere Open-Source-Projekte, die den Zyklus „Browser liest Seite – generiert Aktionskandidaten – Jev wählt Aktion aus – Browser führt aus“ verwenden. In einem öffentlichen Demo zur Flugsuche gaben Entwickler an, dass der gesamte Suchvorgang etwa 7 Sekunden dauert und die Kosten bei etwa 0,004 US-Dollar liegen.
Diese Art von Anwendungen erklärt gut, warum Jev plötzlich die Aufmerksamkeit von Entwicklern für Agenten auf sich zieht.
Viele Schritte von Agenten sind im Wesentlichen hochfrequente Entscheidungen: Welche Schaltfläche angeklickt werden soll, welches Tool aufgerufen werden soll, ob eine Information relevant ist, ob die aktuelle Aufgabe abgeschlossen ist und ob ein bestimmtes Ergebnis die Prüfung besteht. Wenn diese Entscheidungen täglich Hunderttausende oder sogar Millionen Mal auftreten, werden Latenz und Kosten schnell zu einem integralen Bestandteil des Systemdesigns.
In seinem eigenen Workflow-Benchmark behauptet TypeSafe, dass Jev bei einigen Aufgaben eine Geschwindigkeitssteigerung von bis zu etwa 193,6-fach und einen Kostenvorteil von 444,6-fach erreicht. TypeSafe weist zudem darauf hin, dass diese Ergebnisse im oberen Bereich der von ihnen erwarteten praktischen Gewinne liegen und die Testsätze vom internen Team für Modellfähigkeiten erstellt wurden, sodass diese Zahlen eher als frühe Referenz für die technische Ausrichtung dienen.
Die Benennung von Jev verrät auch die Ambition von TypeSafe.
„System One“ stammt aus dem Konzept von System 1, das Daniel Kahneman in seinem Werk „Schnelles Denken, Langsames Denken“ vorgestellt hat – also das schnelle, intuitive Entscheidungssystem. „Jev“ geht auf den Ökonomen William Stanley Jevons zurück. TypeSafe verweist auf die Bedeutung des „Jevons-Paradoxons“: Wenn die Effizienz der Nutzung einer Ressource stark steigt, kann die gesamte genutzte Menge dieser Ressource schnell anwachsen.
Im Kontext der KI ist diese Bedeutung sehr offensichtlich. Wenn der Preis einer intelligenten Entscheidung um mehrere Größenordnungen sinkt, werden Entwickler beginnen, KI auch an Orten einzusetzen, an denen sie es sich früher nie leisten konnten, ein Modell aufzurufen.
Ob ein Protokoll wichtig ist, zu welcher Kategorie eine E-Mail gehört, ob ein Agent seine Aufgabe abgeschlossen hat, in welcher Phase der Nutzerwahrnehmung sich eine Werbeanzeige befindet, welche Schaltfläche für eine Aktion auf einer Webseite ausgewählt werden soll – diese kleinen Entscheidungen summieren sich zu einem sehr großen Aufrufvolumen in den KI-Agentensystemen der nächsten Generation.
Jev befindet sich derzeit noch in der Phase des frühen Zugriffs, und die Experimente der Gemeinschaft mit Browsern, Code-Agenten, Werbeanzeigenanalysen, Bewertern und Kontextverwaltung haben gerade erst begonnen.
Aber es wirft bereits eine sehr interessante Frage auf: In zukünftigen KI-Anwendungen könnten die Tausenden von kleinen Entscheidungen, die in Softwareabläufen verborgen sind, am meisten intelligentere Rechenleistung verbrauchen.
Und Jev soll genau die Infrastruktur hinter diesen „intelligenten if-Anweisungen“ werden.
Haben Sie Jev schon ausprobiert? Wie finden Sie es?
Referenzlinks:
https://x.com/CompleteSkeptic/status/2099925682726002904
https://x.com/TheMattBerman/status/2100654891756589230
https://x.com/tamarajtran/status/2100694549362553153
https://x.com/LangChain/status/2101454284927959080
https://x.com/MatijaSosic/status/2101333105193693652
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Synced“ (ID: almosthuman2014) mit dem Autorenteam von Synced, das sich auf KI konzentriert. 36Kr veröffentlicht den Inhalt mit Genehmigung.