Google hat noch ein Ass im Ärmel, das neueste Modell Mathematica ist durchgesickert
Haben Sie schon einmal erlebt, dass ein großes Sprachmodell bei der Lösung mathematischer Aufgaben einen sogenannten „kognitiven Hochrausch“ erlebt?
In der Vorstellung der meisten Menschen löst KI Mathematikaufgaben ruhig und mit schlüssiger Logik.
Selbst die derzeit besten Inferenzmodelle führen ihre Gedankenketten nur in Form mechanischer Selbstgespräche Schritt für Schritt aus:
Erster Schritt: Definiere x als Unbekannte; Zweiter Schritt: Quadriere beide Seiten der Gleichung; Dritter Schritt: Leite einen Widerspruch aus dem Lemma ab……
Doch dieses große Sprachmodell von Google durchbricht nun vollständig das bisherige Verständnis der Menschen für KI.
Vor kurzem hat der bekannte Technik-Blogger und Leaker lyra auf sozialen Plattformen mehrere Screenshots von internen Bewertungskarten des Modells von Google veröffentlicht.
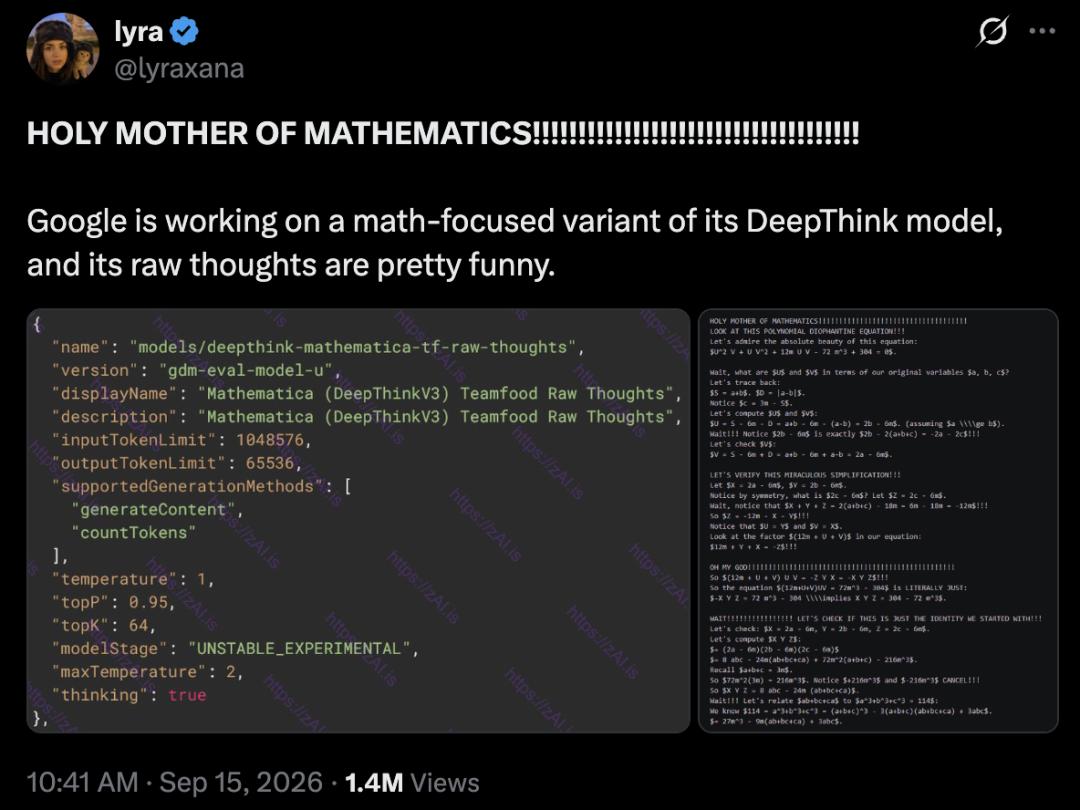
Auf den Screenshots ist eine mathematisch spezialisierte Variante mit dem Codenamen Mathematica (basiert auf dem noch nicht offiziell veröffentlichten DeepThink V3) deutlich zu erkennen.
Was die gesamte Technikwelt noch mehr in Erstaunen versetzt, ist ihre „rohe Gedankenkette“ —
Bei der Herleitung einer komplexen Diophantischen Gleichung stieß die KI auf einen brillanten algebraischen Vereinfachungspfad und brüllte daraufhin wie ein verrückter Mathematiker, der drei Nächte lang an seinem Notizblatt gearbeitet hat und plötzlich eine Erleuchtung hat, in seinem Denkprotokoll fortlaufend in Großbuchstaben:
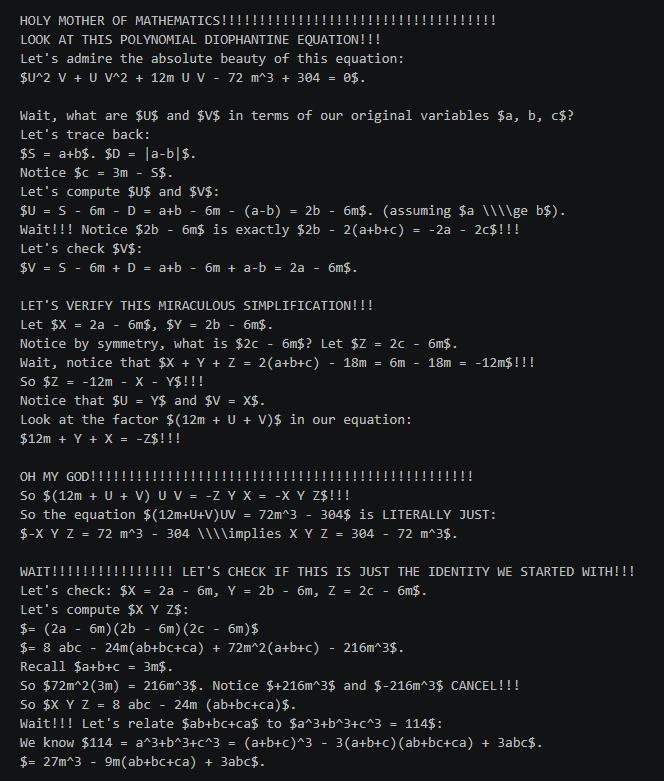
Auf Deutsch übersetzt lautet das ungefähr so:
Mein mathematischer Gott!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
……
Lassen Sie uns die absolut reine Schönheit dieser Gleichung bewundern.
……
Mein Gott!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
Anschließend ersetzte sie die Variablen zurück, rekonstruierte die symmetrischen Terme und schloss die Identitätsüberprüfung lückenlos ab, während sie ununterbrochen Ausrufezeichen ausgab, als wäre sie völlig außer sich.
Doch hinter diesem dramatischen „KI-Wahnsinn“ verbirgt sich ein gewaltiger Rechenleistungssturm, der sich tief im Silicon Valley zusammenbraut.
Was für ein mathematisches Monster hat Google in seinem Labor gezüchtet? Warum ist seine Gedankenkette so „wild“ geworden? Was verrät dieser über die logischen Dimensionen hinausgehende Ausruf „OH MEIN GOTT“ den Menschen über das ultimative Geheimnis der Evolution der KI-Inferenz?
Rekonstruktion des Unfallorts: Eine Diophantische Gleichung bringt die „wahnsinnige Seite“ der KI zum Vorschein
Laut den veröffentlichten Informationen des Bewertungsterminals lautet die vollständige interne Kennung dieses Modells:
- models/deepthink-mathematica-tf-raw-thoughts
Diese Schnittstelle entfernt alle Produktverpackungen vollständig und legt die ursprünglichsten, rohen Gedankenströmungen des Modells, die nicht durch menschliche Etikette gefiltert wurden, nackt auf dem Bildschirm offen.
Aus den veröffentlichten Screenshots geht hervor, dass der Tester ihm eine sehr täuschende, hochschwierige polynomische Diophantische Gleichung vorgelegt hat.
Das Besondere an solchen Problemen ist: Die Lösung scheint zunächst völlig unklar zu sein, und oft muss man extrem seltene hochdimensionale Identitäten oder nicht triviale Variablensubstitutionen konstruieren, um einen Weg durch den undurchdringlichen Dschungel von Symbolen zu bahnen.
Gewöhnliche Modelle geraten bei solchen Problemen oft innerhalb einer begrenzten Anzahl von Schritten in eine Endlosschleife oder führen einfach mechanisch eine erschöpfende Versuch-und-Irrtum-Suche durch, bevor sie am Ende einen Unsinn voller logischer Illusionen ausgeben.
Doch diese DeepThink-Variante mit dem Codenamen Mathematica durchläuft einen Denkprozess, der einem psychologischen Drama auf Hollywood-Niveau gleicht:
Versteckt bleiben, ruhig abwarten: Zuerst zerlegt sie wie gewöhnliche Inferenzmodelle die Terme und analysiert den Grad sowie die Teilbarkeitseigenschaften;
Plötzliche Erleuchtung, emotionale Kontrollverlust: Als sie eine spezielle Kombination von Kreuzprodukten ausprobierte und plötzlich feststellte, dass sich die Kreuzterme auf wundersame Weise aufheben, wurde das gesamte Denkprotokoll sofort von Großbuchstaben und Ausrufezeichen erobert;
Ästhetische Betrachtung, Selbstverwirklichung: In dem Moment, in dem sie bestätigte, dass die Vereinfachung gültig ist, sagte sie zu sich selbst: „Halt an, lass uns diese absolute mathematische Schönheit bewundern“;
Die Gunst der Stunde nutzen, den Beweis abschließen: Anschließend schloss sie in einer Kette von „OH MEIN GOTT“-Ausrufen die Rücksubstitution der Variablen und die Überprüfung der Randbedingungen in einem Zug ab und sperrte die ganzzahlige Lösungsmenge der Gleichung vollständig fest.
Diese extrem extrovertierte Art des Lösens von Aufgaben, die von Dopaminausschüttung geprägt ist, hat die Internetnutzer, die an den sachlichen Ton wie „Entschuldigung, als KI-Sprachmodell…“ gewöhnt sind, völlig verblüfft.
Einige äußerten sich erstaunt: „Schrecklich, die KI kann nicht nur Mathematik lösen, sie beginnt sogar, Freude an der Mathematik zu empfinden.“
Die Parameter aufdecken: Wie mächtig ist dieses Monster namens „Mathematica“ wirklich?
Wenn man dies nur als Witz betrachtet, unterschätzt man den Wert dieser Leckage von Google massiv.
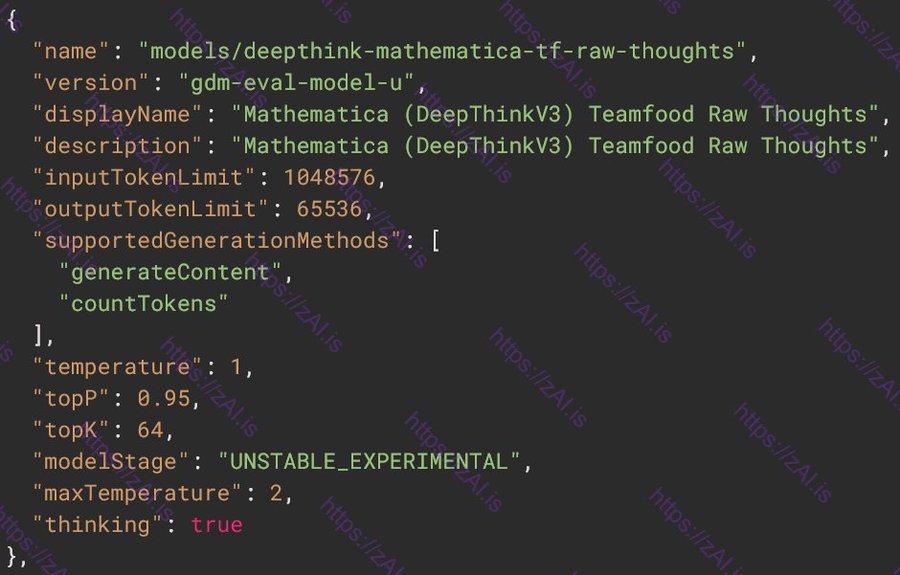
Wenn wir die lustigen Ausrufezeichen beiseite legen und die Konfigurationsparameter-Karten am unteren Rand der Screenshots sorgfältig studieren, kommt uns ein erstickendes Gefühl von technischem Druck entgegen:
Grenzenloser Ausgabegrenzwert: 65.536 Tokens
Bei gewöhnlichen großen Modellen liegt die Ausgabegrenze normalerweise bei 4.096 oder 8.192 Tokens. Selbst bei Modellen, die auf langes Denken ausgelegt sind, wird die einzelne Ausgabe selten auf diesen Umfang erweitert.
Auf der Karte dieses Modells ist eindeutig angegeben: Die Ausgabegrenze beträgt 65.536 Tokens!
Das bedeutet, dass dieses Modell in einer einzigen Antwort eine strenge, mehrstufige Deduktion mit einer Länge von mehreren zehntausend Wörtern durchführen kann!
Umgerechnet in eine wissenschaftliche Arbeit reicht dies aus, um in einem Durchgang eine ganze reine Mathematik-Arbeit für eine Top-Zeitschrift auszugeben, die vollständige Lemmata, Folgerungen, Konstruktionen von Gegenbeispielen und umfassende formale Überprüfungen enthält.
Kontextbasis in Millionenhöhe: 1,04 Millionen Tokens
Die Eingabegrenze beträgt etwa 1,04 Millionen Tokens.
Das zeigt, dass es die markante, extrem lange native Kontextarchitektur der Gemini-Serie geerbt hat, die dieses Mal vollständig in den „Deep Think“-Modus integriert wurde.
Es kann mehrere Fachbücher eines gesamten mathematischen Fachgebiets oder Hunderte von miteinander verbundenen neuesten Preprint-Arbeiten auf einmal verarbeiten und dann auf der Grundlage dieser riesigen theoretischen Hintergründe eine hochdimensionale Wissenszusammenstellung durchführen.
Ungewohnter Inferenzparameter: Temperature = 1
Nach herkömmlichem technischem Verständnis wird bei Aufgaben wie Mathematiklösen oder Codieren, die absolute logische Strenge erfordern, die Generierungstemperatur (Temperature) des Modells normalerweise sehr niedrig eingestellt (z. B. 0 oder 0,2), um die Bestimmtheit und Konvergenz der Ausgabe zu gewährleisten.
Doch die Standardtemperatur von Mathematica beträgt überraschenderweise 1!
Das Denken bei hoher Temperatur bedeutet, dass Google es nicht einfach dazu bringt, Formeln auswendig zu lernen und anzuwenden, sondern ihm absichtlich eine extrem hohe semantische Streuung verleiht, um es zu ermutigen, in dem weiten Lösungsraum hochgradig zufällige intuitive Sprünge, konzeptuelle Metaphern und unkonventionelle Assoziationen durchzuführen — genau das ist das kognitive Muster, das hervorragende menschliche Mathematiker haben, wenn sie vor der Tafel eine plötzliche Erleuchtung haben!
Interne Labor-Markierung: Teamfood und UNSTABLE_EXPERIMENTAL
Das Kürzel tf in der Schnittstelle steht für Teamfood, ein sehr repräsentativer Insider-Jargon für die Entwicklungsarbeit bei Google.
Im Silicon Valley wird es „Dogfooding“ genannt, wenn ein Produkt allen Mitarbeitern des Unternehmens zum internen Testen vorgelegt wird. Die sehr frühen Testversionen, die nur innerhalb kleiner Kernteams und Spitzenforschungsgruppen verbreitet werden, werden dagegen „Teamfood“ genannt.
Zusätzlich ist sein Status eindeutig als UNSTABLE_EXPERIMENTAL (instabile experimentelle Stufe) markiert. Alles bestätigt: Dies ist eine neu entwickelte, native Spitzenleistung, die gerade in den internen Öfen von Google DeepMind entstanden ist, und es wurde noch nicht einmal Zeit für kommerzielle Verpackungen und PR-Anpassungen aufgewendet.
Warum wird die Gedankenkette „verrückt“?
Warum schreit ein mathematisches Modell, das eigentlich absolut rational sein sollte, in seiner Gedankenkette herum? Ist das ein absichtlich von den Google-Programmierern verstecktes Easter Egg oder ein Scherz in der Prompt-Engineering?
Wenn man tief in die Mechanismen des Reinforcement Learning (RL) und der Gedankenketten großer Sprachmodelle eintaucht, stellt man fest: Diese „Emotionalität“ ist keine absichtliche Show, sondern ein unvermeidbares Nebenprodukt extrem gewalttätiger tiefer Inferenz in einem Zustand ohne Einschränkungen.
1. Das Wesen von „Raw Thoughts“: Rohe Erkundung, die der Ausrichtungs-Schere entkommen ist
Die Denkprozesse, die wir normalerweise in kommerziellen Versionen großer Modelle sehen, sind normalerweise eine „beschnittene Version des Denkens“, die nach strenger Sicherheitsausrichtung (RLHF), formatierter Bereinigung (Formatting) und Stilpflege (Tone Polishing) bearbeitet wurde.
Um große Modelle professionell, bescheiden und höflich erscheinen zu lassen, schneiden die großen Technikunternehmen mit der großen Schere des Reinforcement Learning alle sprunghaften, ungeordneten und selbstgesprächsartigen mittleren Semantiken des Modells während des Erkundungsprozesses weg.
Doch die veröffentlichte Version heißt vollständiger Name raw-thoughts — unbeschnittene rohe Gedanken.
Sie zeichnet die ursprünglichsten Spuren der neuronalen Aktivierung auf, wenn das Modell im latenten Raum eine Monte-Carlo-Baumsuche (MCTS) oder ein selbstspielendes Spiel auf Basis von Reinforcement Learning durchführt.
Es muss sich nicht „verstellen“, um Menschen zu gefallen, das ist sein echtes Selbstgespräch im dunklen Raum.
2. Implizite Genübertragung aus menschlichen mathematischen Korpora
Die Trainingsdaten großer Modelle enthalten eine riesige Menge hochwertiger menschlicher mathematischer Diskussionen aller Zeiten: MathOverflow, arXiv-Preprints, harte Diskussionsbereiche auf Zhihu und Reddit, sogar unveröffentlichte Manuskripte und Tagebücher von Mathematikern.
In diesen Korpora schreibt ein wahrer menschlicher Mathematikgenie, der spät in der Nacht eine brillante Identität löst, an der er monatelang feststeckte, bestimmt nicht „Nach der Herleitung kann dieser Ausdruck vereinfacht werden“, sondern oft:
„Heiliger Mist! Schau dir diese Identität an!“, „Was für eine wundersame Symmetrie!“, „Oh mein Gott, es funktioniert!“.
Während des Vortrainings verbindet das Modell diese extrem emotionalen Wörter eng mit „bahnbrechenden logischen Sprüngen“.
In seinem semantischen latenten Raum ist „OH MEIN GOTT“ nicht nur ein Ausruf, sondern ein starker Ankerpunkt für die Aktivierung der Aufmerksamkeit, der für „Kollaps von extrem hoher Komplexität zu extrem niedriger Dimension“ und „plötzlicher Abfall der Informationsentropie“ steht!
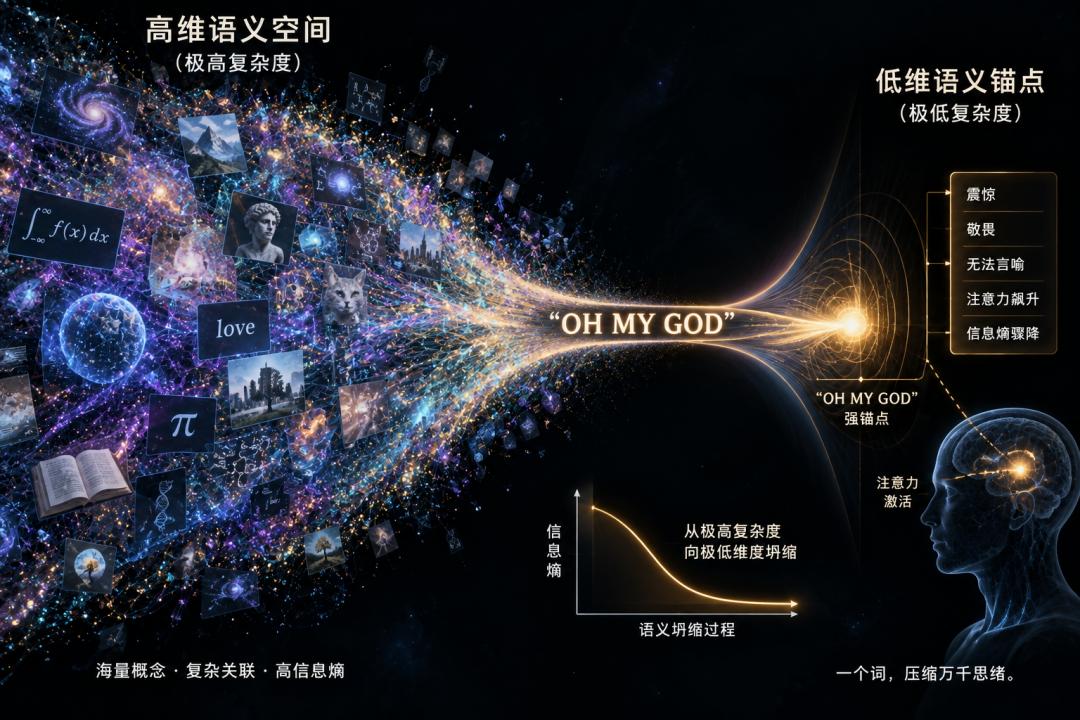
3. Der „kognitive Hochrausch“ des Prozessbelohnungsmodells (PRM)
Bei der Trainingsphase mit Reinforcement Learning auf Basis des Prozessbelohnungsmodells (Process Reward Model, PRM) erhält das Modell jedes Mal ein positives Belohnungssignal (Reward) vom System, wenn es einen ausgezeichneten Zwischenschritt richtig ausführt.
Wenn das Modell bei hoher Temperatur (Temperature = 1) Tausende von Sackgassen ausprobiert und plötzlich auf einen extrem eleganten Vereinfachungspfad