OpenAI übernimmt den Schlüsselentwickler hinter dem Porträtmodus des iPhone, um der KI ein neues Paar Augen zu verleihen.
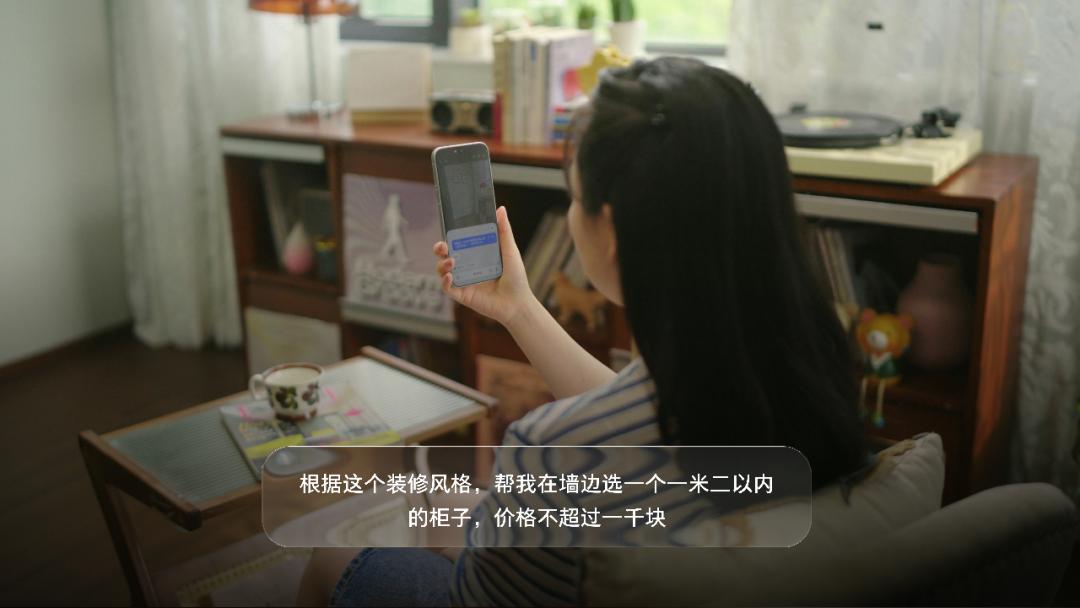
Innerhalb der letzten Woche haben zwei neue Smartphone-Produkte die öffentlichen Aufmerksamkeit stark auf sich gezogen: Eines ist das neu erschienene iPhone 18 von Apple, das andere ist die Veröffentlichung der Consumer-Version des Doubao Mobile Assistant – das erste damit ausgestattete Modell Nubia NaviX Ultra ist heute in den Verkauf gegangen, KI wird in das Betriebssystem des Smartphones integriert, und wir haben bereits eine detaillierte Bewertung dazu erstellt.
KI beginnt, den Bildschirm zu sehen, und beginnt auch, ihn zu berühren. Gleichzeitig enthüllte das Wall Street Journal, dass OpenAI das Kameratechnikunternehmen Glass Imaging für mehr als 300 Millionen US-Dollar übernommen hat.
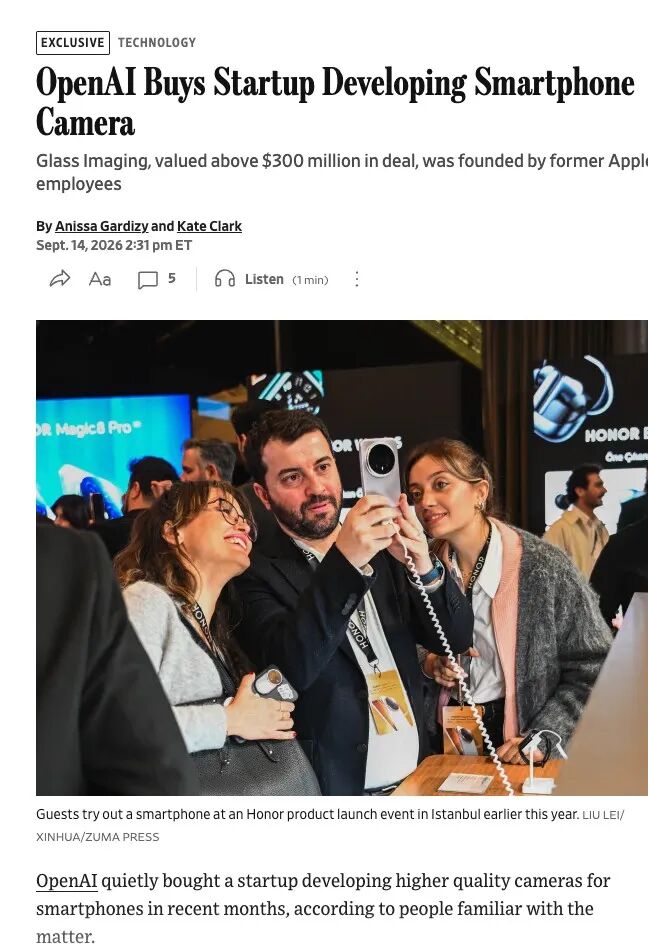
Die Transaktion wurde von OpenAI noch nicht öffentlich bestätigt, aber die Position, an der dieses neue Puzzleteil auftaucht, ist sehr delikat: Nachdem OpenAI im vergangenen Jahr das von Jony Ive gegründete Hardwareunternehmen io für 6,5 Milliarden US-Dollar übernommen hat, hat es noch keine großen Erfolge erzielt, aber Industrie-Designer und Kamera-Ingenieure sind bereits nacheinander eingetreten.
Es ist KI, aber keine KI für Bildbearbeitung
Glass Imaging wurde von Ziv Attar und Tom Bishop gegründet, die beide zuvor bei Apple im Bereich der rechnergestützten Fotografie gearbeitet und an der Entwicklung des Porträtmodus des iPhone mitgewirkt haben.
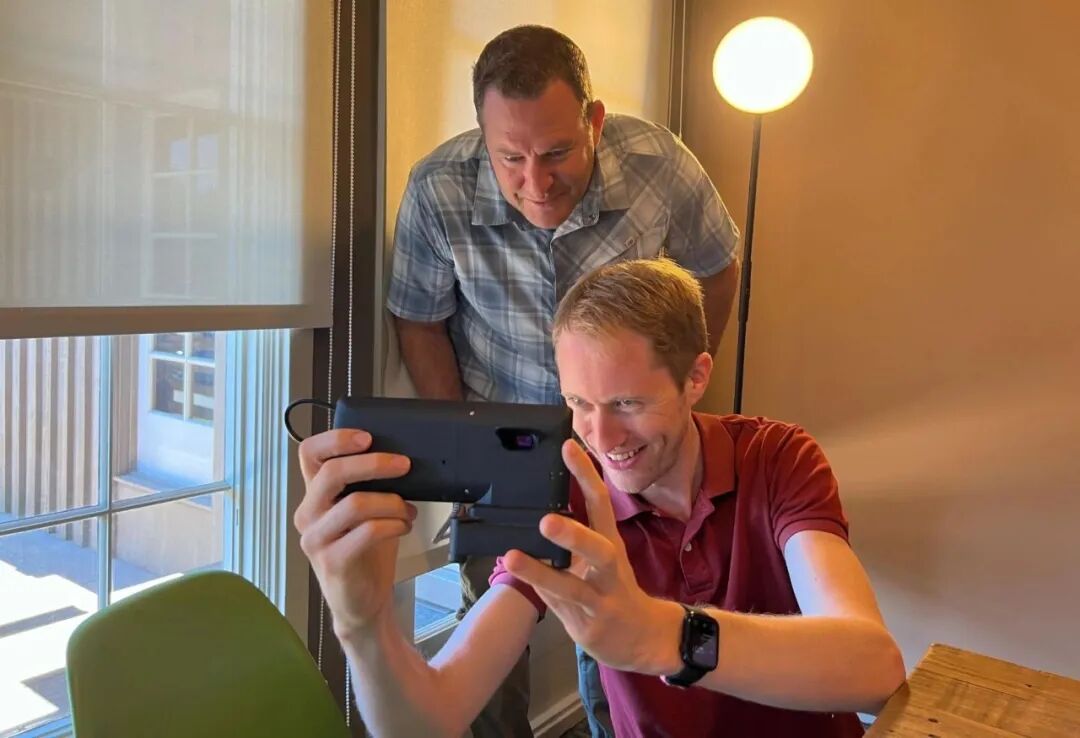
Allerdings erforscht Glass Imaging nicht die heute am weitesten verbreitete KI-Bildbearbeitung, sondern die Verwendung von KI, um die Designlogik der Kamerahardware umgekehrt zu beeinflussen.
Nach dem Drücken des Auslösers am Smartphone erhält der Sensor zuerst kein direkt betrachtbares Foto, sondern eine Menge roher Lichtsignale. Ein herkömmlicher Bildsignalprozessor muss Verfahren wie Rauschunterdrückung, Farbkorrektur und Schärfung durchführen, bevor das endgültige Bild auf dem Bildschirm erzeugt wird.
Glass Imaging versucht, diese Pipeline mit einem neuronalen Netzwerk zu übernehmen, das für bestimmte Objektive und Sensoren trainiert wurde. Die technische Grundlage ist nach wie vor Neural ISP: Ein herkömmlicher ISP gibt die RAW-Daten nacheinander an Module wie Demosaicing, Rauschunterdrückung, Mehrbildfusion und Schärfung weiter, wobei jeder Schritt von einem unabhängigen Algorithmus verarbeitet wird und ein Teil der Informationen im Prozess verloren geht.
GlassAI geht dagegen von den RAW-Serienaufnahmedaten des Sensors aus, integriert Demosaicing, Rauschunterdrückung, Entschärfung und Mehrbildfusion in ein gemeinsam trainiertes Netzwerk und fügt gleichzeitig die Entfaltung von Objektivaberrationen und die Korrektur von Sensorübersprechungen hinzu, bei denen herkömmliche ISPs schlecht abschneiden, bevor es direkt das fertige RGB-Bild ausgibt.
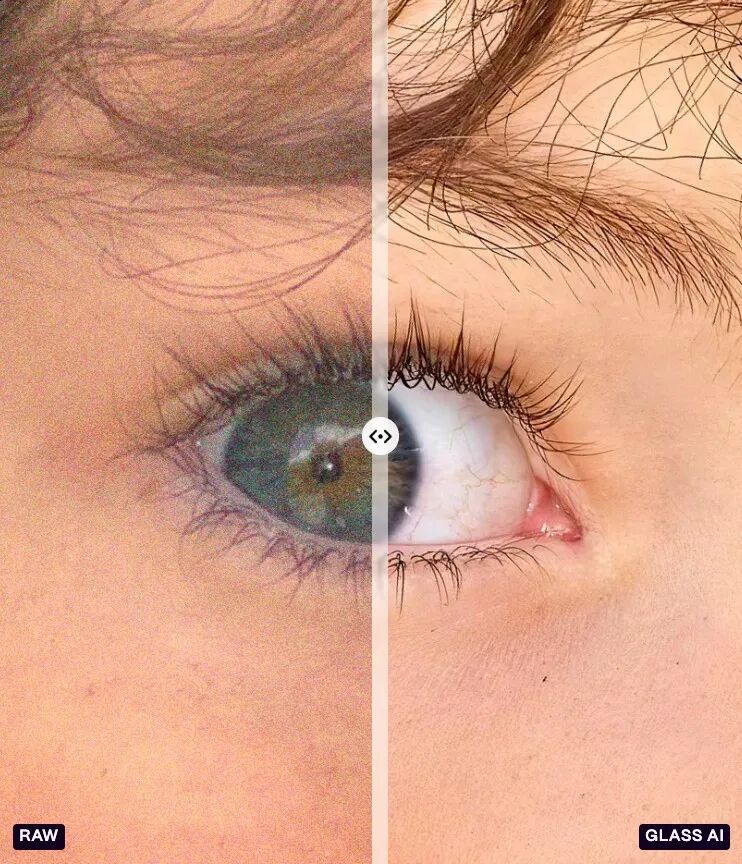
Auf der Grundlage von Neural ISP hat Glass Imaging zahlreiche Kernverfahren des herkömmlichen ISPs übernommen und neu geschrieben. Es muss lernen, wie eine Kamera Fehler erzeugt, und diese Fehler dann bei der Bildentstehung rückgängig machen. Der Ansatz von Glass Imaging lautet: Solange das Objektiv genügend Informationen an den Sensor übermittelt, können verbleibende Unschärfen, Farbfehler und Verzerrungen von einem speziell trainierten Netzwerk repariert werden.
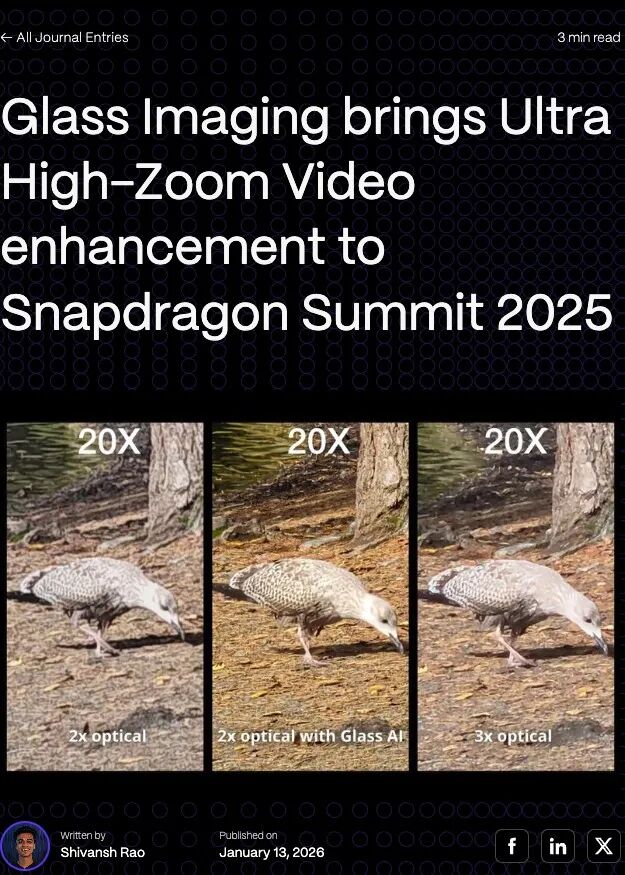
Aber das hier genannte „Reparieren“ meint nicht die „Bearbeitung“ im Sinne der KI-Bildbearbeitung: Generative Bildbearbeitung kann zwar unscharfe Texte, Monde und Gesichter in der Ferne „erraten“ und klarer darstellen, aber Klarheit bedeutet nicht Echtheit. Nach Angaben von Glass Imaging zielt sein auf spezifische optische Systeme und RAW-Daten trainiertes Netzwerk darauf ab, die tatsächlich vom Sensor erfassten Informationen wiederherzustellen, anstatt neue Texturen aus Allgemeinwissen und Schlussfolgerungen zu erzeugen.
Das unterscheidet sich stark von der derzeitigen Hauptanwendung von KI in der Bildverarbeitung, und der Grund dafür lautet: Wenn die Kamera nur dazu dient, Fotos für soziale Netzwerke aufzunehmen, reicht es aus, wenn die Fotos gut aussehen. Aber wenn Bilder von einem Agenten zur Beurteilung der Realität und zum Ergreifen von Maßnahmen verwendet werden, können ergänzte Objekte und Texte zu Fehlbedienungen führen – das erklärt, warum OpenAI daran interessiert ist.
Die zwei Arten von „Sichtrecht“ für KI-Geräte
Für Smartphone-Hersteller ermöglicht die Neural ISP-Technologie, dass kleinere Objektive klarere Fotos aufnehmen. Aber für ein Unternehmen, das KI-Hardware herstellt, hat sie noch eine weitere Bedeutung: Die Welt, die das Modell sieht, hängt zuerst davon ab, was die Kamera ihm übermittelt.
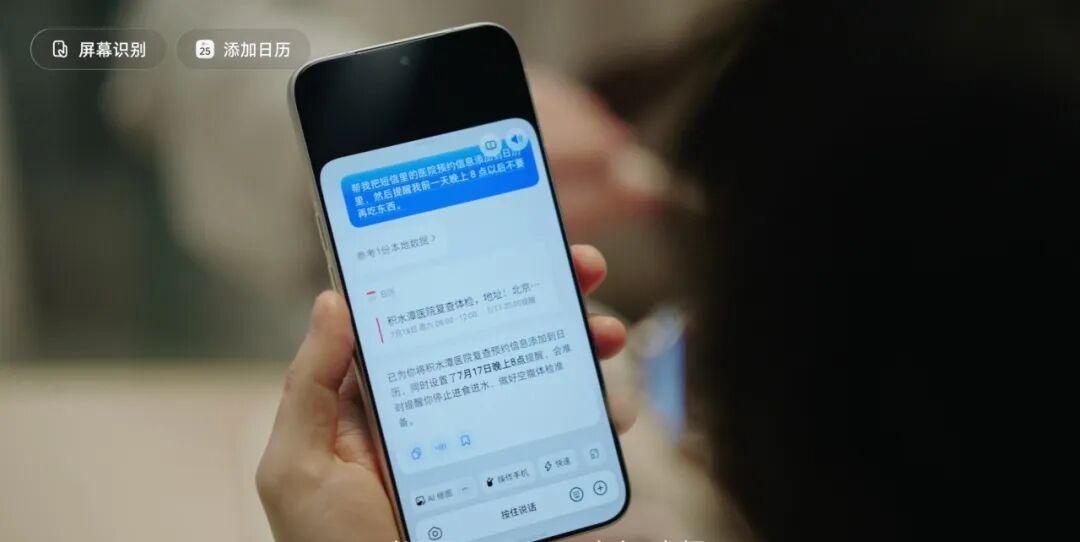
KI-Geräte brauchen zwei Arten von „Sichtfähigkeiten“. Die erste findet innerhalb des Bildschirms statt: Die KI muss verstehen, was der Nutzer gerade durchsucht, welche lokalen Informationen er liest, und die Berechtigung erhalten, auf verschiedene Apps zuzugreifen. Auf dieser Grundlage kann sie den Kontext im gesamten Betriebssystem verstehen.
Die zweite findet außerhalb des Bildschirms statt: Texte auf Menüs, Gegenstände auf dem Tisch, Straßen vor den Augen und Geräte im Raum können der KI nicht nur durch Chat-Protokolle „bekannt“ gemacht werden – man muss zuerst ein Foto aufnehmen und es dann an die KI übermitteln.
Das Foto ist das Ende der Betrachtung für Menschen, aber es könnte nur der Anfang der Arbeit für einen Agenten sein. Wenn zukünftige KI-Geräte rechtzeitig handeln wollen, müssen sie die gesamte Kette „Mensch sieht, fotografiert, lädt hoch, fragt“ verkürzen.
Die Identität der Kamera hat sich dadurch ebenfalls verändert: Früher bewahrte sie für Menschen Bilder auf, die es wert sind, erneut betrachtet zu werden, in Zukunft wird sie der Maschine die Grundlage liefern, um die nächste Handlung zu beurteilen.
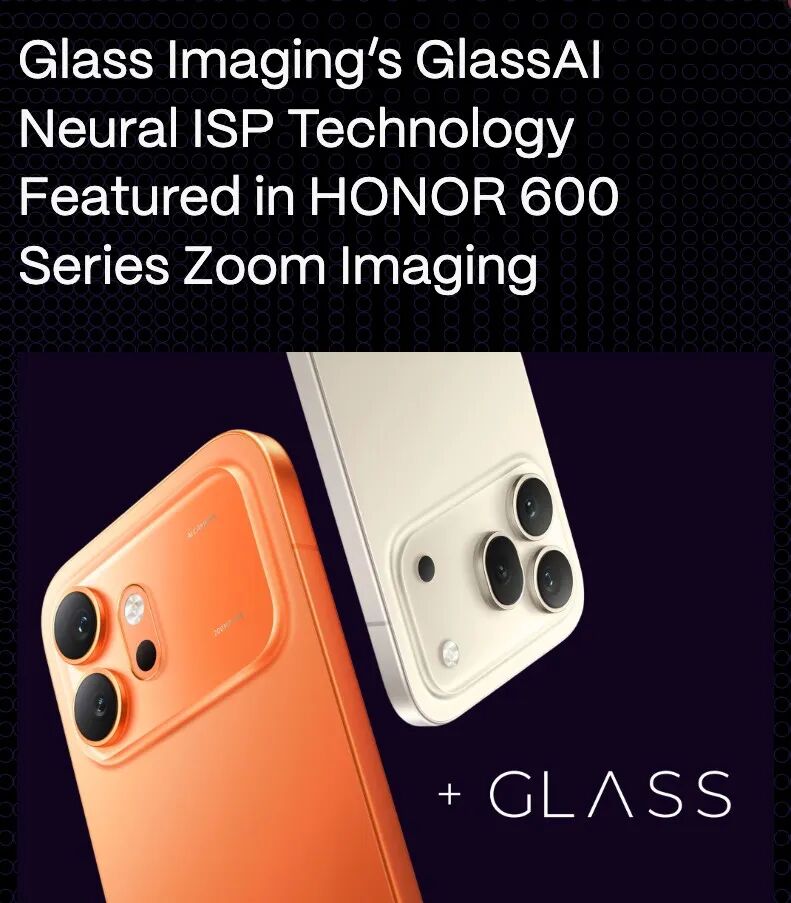
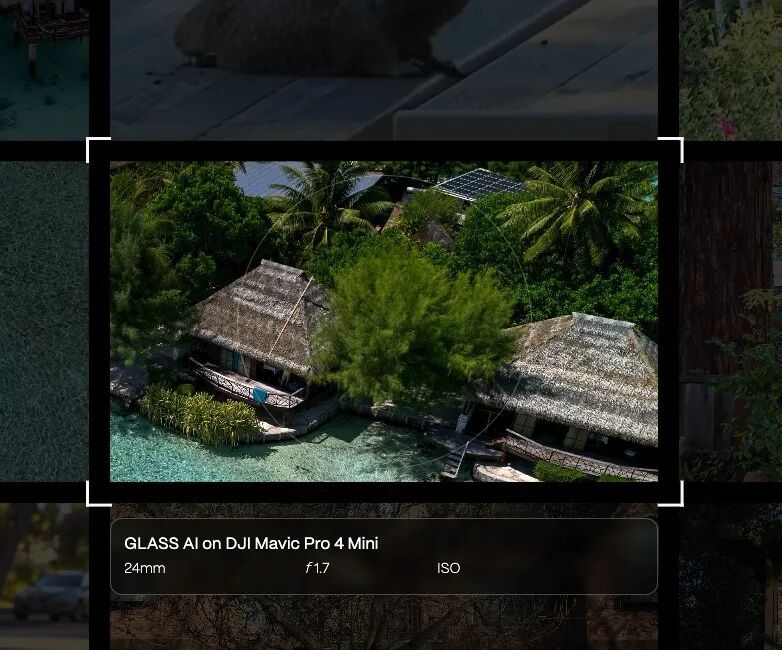
Die Zoom-Technologie von GlassAI ist bereits in der Honor 600-Serie integriert, was zeigt, dass sie mindestens die Anpassung von Modell, Smartphone-Chip bis zu Seriengeräten abgeschlossen hat. Das Unternehmen hat außerdem auf dem Referenzgerät Snapdragon 8 Elite Gen 5 die Echtzeit-4K-Videoverarbeitung und eine Zoom-Verbesserung von über dem 20-fachen vorgeführt.
Diese Fähigkeiten werden derzeit verwendet, um entfernte Objekte klarer aufzunehmen. In Zukunft, wenn die Kamera nicht mit einem Fotoalbum, sondern mit einem handlungsbereiten Agenten verbunden ist, ändern sich die Bewertungsmaßstäbe für die Bildgebung.
Fotos müssen nicht nur gut aussehen, sondern auch Texte, Objekte und räumliche Beziehungen so echt, stabil und zeitnah wie möglich darstellen, da das Modell anschließend möglicherweise Waren erkennt, Geräte bedient oder sogar Handlungen plant.
Das bedeutet nicht, dass GlassAI Kameras automatisch zu intelligenten Agenten macht, aber es ergänzt das unterste Glied, bevor intelligente Agenten in die reale Welt eintreten: Die tatsächlich vom Sensor erfassten Informationen so genau wie möglich an das Modell zu übermitteln.
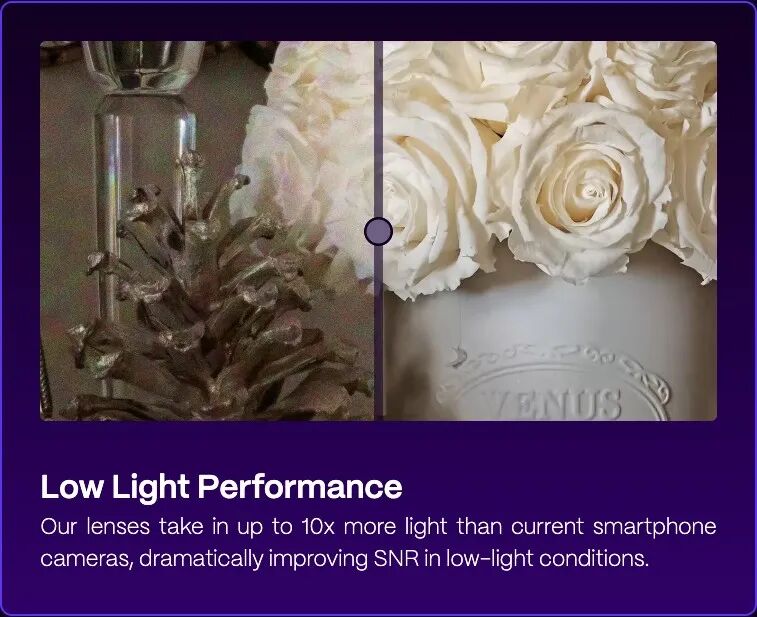
Die erste von Glass Imaging aufgedeckte Veränderung ist die Neudefinition der Arbeitsteilung zwischen Hardware und Software. Früher haben Kamerahersteller versucht, Objektivaberrationen, Unschärfen und Rauschen zuerst mit Objektiven und Sensoren zu beseitigen, bevor der ISP das endgültige Bild bearbeitet. GlassAI erlaubt es der Hardware dagegen, einige Mängel zu behalten, die durch Berechnung rückgängig gemacht werden können: Solange der Sensor genügend Informationen erfasst, kann ein speziell trainiertes Netzwerk sie während der Bildgebung wiederherstellen. Objektive können dadurch kleiner werden, Pixel können weiter verkleinert werden, und ein Teil der Probleme, die früher durch das Hinzufügen von Linsen, Dicke und Kosten gelöst werden mussten, wird auf neuronale Netze übertragen.
Es ist also möglich, dass die Hardware zukünftiger KI-Geräte nicht vollständig entworfen werden muss, bevor man „ein Modell hineinsteckt“. Objektive, Sensoren, NPU, Arbeitsspeicher und Modell werden von Anfang an gemeinsam entworfen, welche Rohsignale der Sensor behalten soll, welche Fehler das neuronale Netzwerk reparieren kann, wie viel lokale Rechenleistung das Gerät braucht und ob es die Umgebung im Niedrigleistungsmodus kontinuierlich verstehen kann … all diese Probleme werden wiederum die Form der Hardware beeinflussen.
Zum Beispiel: Wenn Ingenieure im Voraus wissen, dass bestimmte optische Mängel von neuronalen Netzen stabil repariert werden können, können sie bei der Auswahl der Anzahl von Objektiven, der Pixelgröße, des Sensors und der Gerätedicke bei der nächsten Kamerageneration Mängel tolerieren, die früher nicht akzeptabel waren. Das kann bedeuten, dass man nicht mehr durch das Stapeln von mehr Linsen alle Aberrationen vollständig beseitigt, sondern sicherstellt, dass der Sensor noch genügend Rohinformationen behält, bevor sie von der KI wiederhergestellt werden.
Dasselbe Prinzip kann sich auch auf Mikrofone, räumliche Sensoren und andere Wahrnehmungskomponenten ausweiten. Früher war die Hardware dafür verantwortlich, die Welt so vollständig wie möglich aufzuzeichnen, und die Software verarbeitete sie erst nachträglich. In Zukunft muss die Hardware nur die Informationen erfassen, die das Modell verstehen und wiederherstellen kann, und das Modell beeinflusst von Anfang an, wie die Hardware die Welt betrachten soll.
Das Modell ist nicht dafür verantwortlich, zu bestimmen, was die Kamera sieht, aber es ändert, wie viel Hardware die Kamera braucht, um ein Bild zu erhalten, das ausreichend wiederhergestellt und verstanden werden kann.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „APPSO“, Autor: Entdecker von Produkten für morgen, veröffentlicht mit Genehmigung von 36Kr.