Wie groß ist der Druck auf Luo Fuli? Er hat sogar das Training des Xiaomi-Modells zum Livestream gemacht.
Das ist so spannend. Jeder weiß, dass das Training von Modellen sehr kostspielig ist, aber wenn man mit eigenen Augen sieht, wie der Betrag in Xiaomis „Live-Übertragung“ nach oben springt, tut es einem ein bisschen weh für das Unternehmen.
Am Abend des 15. September nach Pekinger Ortszeit starteten zwei neue Modelle von Xiaomi nacheinander diese Trainingsrunde. Bis zum Nachmittag des 17. Septembers, weniger als zwei Tage später, lagen die kumulierten Kosten auf der Seite bereits über 1,3 Millionen US-Dollar und steigen weiter. Glücklicherweise müssen die Zuschauer dieses Geld nicht bezahlen, sonst würde man wahrscheinlich wirklich die Webseite schließen müssen, um sich zu erholen, während man zuschaut.
Die Person, die die Adresse zum Zuschauen veröffentlicht hat, ist Luo Fuli, Leiterin des großen Modells von Xiaomi und ehemalige Forscherin bei DeepSeek.
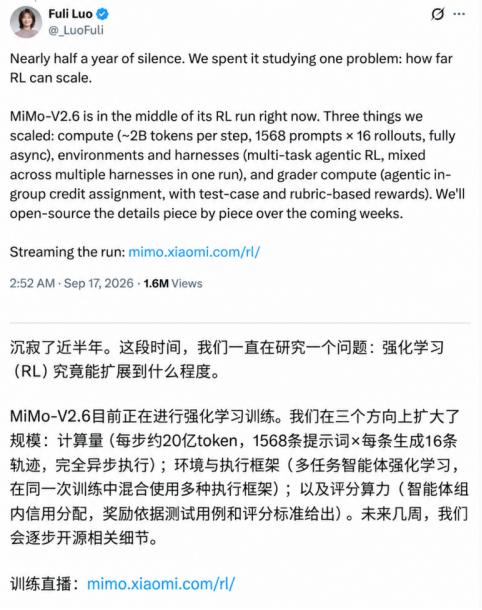
Am frühen Morgen desselben Tages schrieb sie auf X: „Es war fast ein halbes Jahr lang still.“ Danach erklärte sie, dass sie und ihr Team in dieser Zeit ständig erforscht haben, in welchem Ausmaß sich das verstärkende Lernen ausweiten lässt.
Das neue Modell MiMo-V2.6 war noch nicht fertig trainiert, als Luo Fuli bereits die „Live-Übertragung“ für alle startete – das muss man sagen, das ist sehr mutig.
Allerdings sind die schnell steigenden Kosten sicherlich nicht die einzige Information, die diese „Live-Übertragung“ preisgibt. Viel entscheidender ist, womit Luo Fuli in den letzten Monaten beschäftigt war und wie weit Xiaomi durch diese Trainingsrunde aufholen kann.
Das Modell ist noch nicht fertig trainiert – die Live-Übertragung läuft bereits
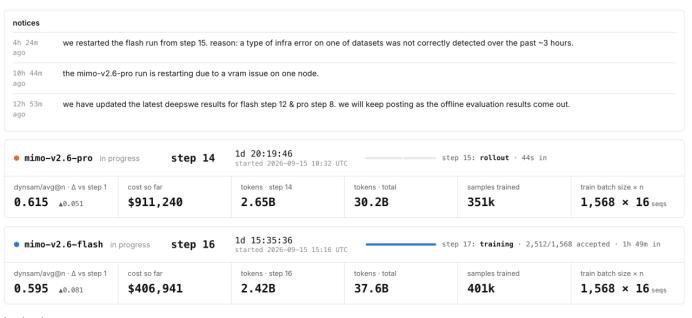
Die Seite der „Live-Übertragung“ ist leicht verständlich: Die beiden Modelle Pro und Flash von MiMo-V2.6 belegen jeweils eine Spalte.
Um 15:47 Uhr nach Pekinger Ortszeit am 17. September hat Pro in dieser Trainingsrunde über 45 Stunden gelaufen, mit kumulierten Kosten von etwa 930.000 US-Dollar. Flash, das einige Stunden später mit dem Training begonnen hat, läuft seit etwa 40,5 Stunden und kostet etwa 416.000 US-Dollar. Die Kosten von Pro sind bereits mehr als doppelt so hoch wie die von Flash.
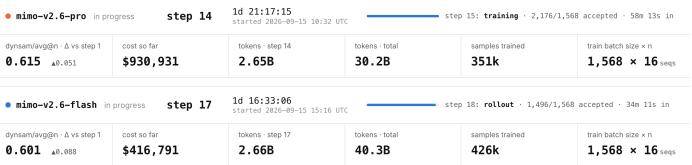
Was den Fortschritt betrifft: Pro hat den 14. Schritt abgeschlossen und befindet sich gerade im 15. Schritt. Flash hat den 17. Schritt abgeschlossen und läuft im 18. Schritt. Flash scheint schneller voranzukommen, aber nur anhand der Anzahl der Schritte lässt sich nicht beurteilen, welches Modell besser trainiert ist – man muss sich die Testergebnisse unten ansehen.
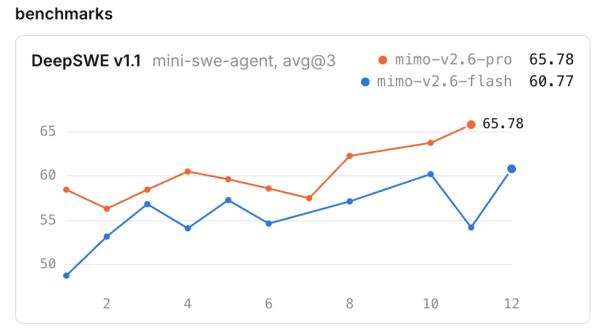
Auf der Seite wird eine Softwareentwicklungstest namens DeepSWE v1.1 veröffentlicht. Bei diesem Test muss das Modell Funktionen in echten Open-Source-Projekten hinzufügen und Probleme beheben, bevor überprüft wird, ob der eingereichte Code den Anforderungen entspricht. Selbst wenn die neue Funktion erstellt wurde, zählt es nicht als bestanden, wenn die ursprünglichen Funktionen dadurch beschädigt werden.
Die derzeit auf der Seite veröffentlichte Bestehensquote beträgt 65,78 % für Pro und 60,77 % für Flash. Das heißt, bei diesem Test können beide Modelle mehr als 60 % der Aufgaben erledigen, wobei Pro um etwa 5 Prozentpunkte vorne liegt. Diese Ergebnisse werden aktualisiert, sobald die phasenweisen Tests abgeschlossen sind. Das Modell befindet sich noch im Training, sodass die aktuell sichtbaren Ergebnisse nur die Ergebnisse der Zwischenprüfung sind.
Noch interessanter ist, dass die Webseite gleichzeitig als Störungsmeldetafel dient: Xiaomi schreibt sogar auf der Seite, welche Probleme während des Trainings aufgetreten sind.
Die Ankündigung oben auf der Seite besagt, dass Pro aufgrund eines Problems mit dem Grafikspeicher eines Rechenknotens neu gestartet werden muss. Flash ist bei einem Datensatz auf eine Art von Infrastrukturfehler gestoßen, der etwa 3 Stunden lang nicht korrekt erkannt wurde, sodass es schließlich ab Schritt 15 neu gestartet wurde.
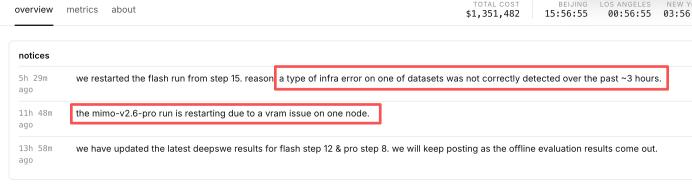
Wenn man normalerweise die Veröffentlichung von Modellen verfolgt, bekommt man nur eine bereits aufbereitete Ergebnisliste zu sehen. Meistens hat man keine Möglichkeit, zu erfahren, welche Probleme während des Trainings aufgetreten sind und wie oft neu angefangen wurde. Diesmal hat Xiaomi sogar die Störungsmeldungen veröffentlicht – die Außenwelt kann direkt sehen, dass das Team gleichzeitig damit beschäftigt ist, Probleme zu beheben und das Training neu zu starten, während die Punktzahlen des Modells steigen. Das ist fast eine Art Performance-Kunst.
Diese Art von „Live-Übertragung“ hat schnell die Aufmerksamkeit von Kollegen aus der Branche auf sich gezogen.
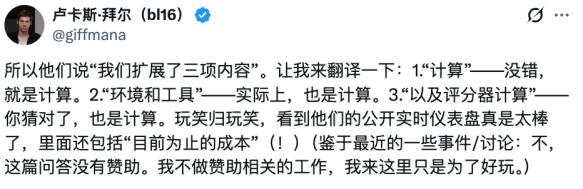
Lukas Beyer, Forscher bei Meta und ehemaliger Forscher bei OpenAI, sah Luo Fulis Vorstellung von drei Richtungen zur Erweiterung des Trainingsumfangs und konnte nicht widerstehen, sie für sie noch einmal neu zu „übersetzen“: Rechenleistung, Rechenleistung und nochmals Rechenleistung. Nach dem Scherz lobte er ausdrücklich, dass Xiaomi sogar veröffentlicht hat, „wie viel Geld bisher ausgegeben wurde“.
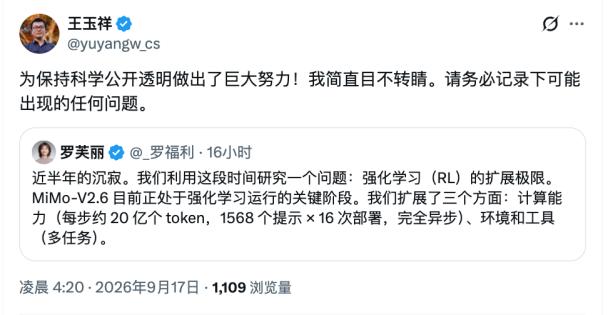
Yu-Xiang Wang, außerordentlicher Professor an der University of California, San Diego und Forscher für verstärkendes Lernen, sagte auch, dass er „nicht mehr wegschauen kann“ – und er stellte eine ausdrückliche Anforderung: Er hofft, dass das Team alle Probleme aufzeichnet, auf die es während des Trainingsprozesses stößt. Die Neustart-Ankündigungen weiter oben sind genau die Inhalte, die er wissen wollte.
Sasha Rush, ehemaliger Professor an der Cornell University, der an der Entwicklung des Cursor-Modells mitgewirkt hat, verfolgte die Live-Übertragung ebenfalls mit seinem Handy. Er spottete, dass er beim Beobachten der Antwortlänge einer Programmieraufgabe das Gefühl eines Spielers bekommen hat, der sich zu sehr hineinsteigert – und dann zweifelte er an den Änderungen der Zahlen: „Der Sprung von 80k auf 120k fühlt sich zu groß an.“
Mit dieser Offenheit können Außenstehende bereits anhand der konkreten Details über die Trainingsmethoden diskutieren.
Übrigens hat Xiaomi im März dieses Jahres sein neues Modell bereits einmal ein Spiel „Rate mal, wer ich bin“ spielen lassen. Damals tauchte ein anonymes Modell namens Hunter Alpha auf der Modell-Serviceplattform OpenRouter auf. Eine Woche später gab Xiaomi am 18. März die Identität bekannt: Es handelte sich um eine frühe Testversion von MiMo-V2-Pro.
Diesmal hat Luo Fuli den Trainingsprozess kurzerhand im Voraus veröffentlicht und angekündigt, dass die entsprechenden Details in den kommenden Wochen schrittweise Open-Source gemacht werden. Was das Training lösen soll, sagte sie in ihrem Tweet, dass das Team in den letzten fast sechs Monaten ständig erforscht hat, in welchem Ausmaß sich das verstärkende Lernen ausweiten lässt.
Ein halbes Jahr der Stille – womit war Luo Fuli eigentlich beschäftigt?
Im April dieses Jahres wurde die MiMo-V2.5-Serie veröffentlicht und Open-Source gemacht. In der im selben Monat gestarteten Sendung „Zhang Xiaojun Jùn | Geschäftsinterviews“ sprach Luo Fuli darüber, dass inländische Teams die Nachbearbeitung von Agenten beschleunigt erforschen – einer der Schwerpunkte liegt dabei auf der Erweiterung des Umfangs des verstärkenden Lernens. Als der Moderator nach ersten Ergebnissen fragte, sagte sie damals nur: „Im Moment ist es noch nicht sehr praktisch, dies zu teilen.“
Einige Monate später stellte Xiaomi den Trainingsprozess online. Das Modell gibt täglich so viel Geld aus – was lernt es eigentlich?
Nehmen wir als Beispiel die Reparatur einer Webseite: Der Nutzer stellt fest, dass er sich plötzlich nicht mehr auf der Webseite anmelden kann und bittet die KI darum, das Problem zu beheben. Die KI muss dann die relevanten Dateien finden, prüfen, wo das Problem liegt, den Code ändern und Tests ausführen. Manchmal treten nach der Änderung immer noch Fehler auf, sodass man weiter nach dem Problem suchen muss. Der Nutzer möchte, dass er sich anmelden kann – eine einfache Nachricht wie „Ich habe das Problem für Sie behoben“ reicht offensichtlich nicht aus.
Diese Art von KI, die Tools verwenden und Aufgaben nacheinander bearbeiten kann, ist der sogenannte Agent, von dem wir oft hören. Während des Trainings versucht das Modell wiederholt, die Aufgabe zu erledigen. Das System bewertet seine Leistung und passt dann die Modellparameter anhand dieser Rückmeldungen an, sodass erfolgreiche Vorgehensweisen in Zukunft häufiger auftreten. Das ist eine Anwendung des verstärkenden Lernens im Training von Agenten.
Nach der von Luo Fuli veröffentlichten Konfiguration plant Xiaomi für jeden Trainingsschritt 1568 Prompts vor, von denen jeder 16 Versuchen entspricht – insgesamt 25088 Trajektorien.
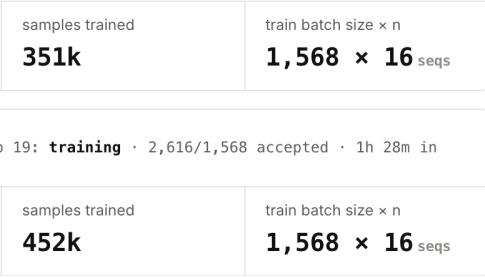
Eine Trajektorie hier ist der vollständige Prozess des Modells von dem Moment, in dem es die Aufgabe erhält, bis zu seinem Abschluss. Wenn man eine Webseite repariert, gehört es auch dann noch zu demselben Versuch, wenn man zwischendurch mehrmals den Code ändert und mehrmals Tests ausführt. Wenn sich eine große Anzahl solcher Prozesse ansammelt, umfasst ein einziger Trainingsschritt etwa 2 Milliarden Token. Alle Inhalte, die das Modell liest und schreibt, wie Texte und Codes, werden in dieser Einheit gemessen.
Daher kann hinter einem unscheinbaren „step“ auf der Seite bereits sehr viel Arbeit stecken.
Für diese Übungen gibt es noch eine Vorbereitungsarbeit: Das Modell braucht einen Ort, an dem es arbeiten kann.
Beispielsweise muss das Trainingssystem bei der Reparatur einer Webseite die Projektdateien und Tools zum Ausführen des Codes bereitstellen. Nachdem das Modell den Code geändert hat, muss das Ergebnis auch an es zurückgegeben werden, um zu prüfen, ob das Programm normal läuft. Wenn es nur die Anweisung „Beheben Sie bitte den Anmeldefehler“ gibt, aber keine Dateien zum Nachschlagen und keine Programme zum Ausführen vorhanden sind, kann es nichts unternehmen.
Luo Fuli erwähnte in dem Interview, dass das Team zuerst mehr Mitarbeiter im Unternehmen dazu bringt, das Modell zu verwenden, um praktische Anforderungen zu entdecken – danach werden Trainingsdaten rund um diese Szenarien erstellt. Das Schwierige ist, die Umgebungen bei der Nutzung so genau wie möglich nachzubilden, sodass das Modell darin nacheinander arbeiten kann, und entsprechende Bewertungsstandards festzulegen.
Die erweiterte Trainingsumgebung und das Ausführungsframework von MiMo-V2.6 bei diesem Projekt umfassen genau diese Arbeiten. In derselben Trainingsrunde können mehrere Arten von Aufgaben gemischt werden, sodass sich die Tools, Arbeitsprozesse und Abschlussanforderungen für das Modell unterscheiden.
Zudem braucht es auch Rechenleistung, um zu beurteilen, wie gut das Modell gearbeitet hat. Wenn die Aufgaben komplexer werden, wird auch die Überprüfung der Ergebnisse aufwendiger.
Ob ein Programm die Tests besteht, kann vom System automatisch überprüft werden. Wenn man dagegen die KI die Geschäftslage eines Unternehmens analysieren lassen möchte, müssen Daten und Schlussfolgerungen miteinander abgeglichen werden. Wenn sie beispielsweise den Umsatz des letzten Jahres als den des laufenden Jahres ausgibt, ist die gesamte Analyse unhaltbar, egal wie plausibel die weiteren Schlussfolgerungen sind. Das Bewertungssystem muss in der Lage sein, diese Probleme zu erkennen – sonst gibt es falsche Belohnungen, und das Modell könnte weiterhin die falschen Vorgehensweisen lernen.
Das ist auch der Grund, warum Luo Fuli die „Bewertungs-Rechenleistung“ separat aufführt. Das Modell braucht Rechenleistung, um Aufgaben zu erledigen – und die Beurteilung der Qualität dieser Versuche erfordert ebenfalls Rechenressourcen.
Derzeit macht die Programmierung einen großen Teil dieses Trainings aus. Um 17:49 Uhr nach Pekinger Ortszeit am 17. September machten die codebezogenen Prompts im 14. Schritt von Pro 67,7 % aus, also mehr als zwei Drittel – daneben sind auch Aufgaben wie visuelle Verarbeitung und Chat gemischt.