Der Mann, der ChatGPT das Sprechen beigebracht hat, hat ein „stummes“ Modell entwickelt.
Im KI-Kreis ist die Person, die am besten versteht, wie man Modelle zum „Sprechen“ bringt, jetzt entschlossen, die Sprachfähigkeiten großer Modelle zu entziehen.
Dieser ehemalige OpenAI-Forscher und Mit-Erfinder von ChatGPT, Diogo Almeida, kehrt nach zwei Jahren im Verborgenen mit seinem neuen Unternehmen TypeSafe AI und einer Finanzierung von 40 Millionen US-Dollar auf die Bühne zurück. Das von ihnen veröffentlichte neue Modell Jev kann weder die Wochenberichte von Angestellten schreiben noch Nutzer bis spät in die Nacht begleiten. Es kann nicht einmal ein einziges Satzzeichen ausgeben.
Gründer von TypeSafe Diogo Almeida|Bildquelle: X
Dies ist ein Moment, der dem gesunden Menschenverstand widerspricht. In den letzten drei Jahren hat die gesamte Branche große Modelle gelehrt, wie man wie Menschen „langsam denkt“. Verschiedene Labore haben sich bemüht, die Schlussfolgerungsketten zu verlängern, sodass Modelle Tausende von Wörtern im Stillen mit sich selbst sprechen, bevor sie eine Antwort geben.
Aber Jev geht einen völlig entgegengesetzten Weg: Es generiert keinen Text, sondern gibt nur deterministische strukturierte Entscheidungen aus.
Dies ist nicht nur die Veröffentlichung eines neuen Produkts, sondern auch eine offene Herausforderung an das aktuelle technische Paradigma großer Modelle.
KI mit „Reflexnerven“ ausstatten
Um zu verstehen, was Jev eigentlich ist, muss man zuerst verstehen, wie schmerzhaft die aktuelle Situation von KI-Entwicklern ist.
Heutzutage tun die meisten Ingenieure oft sehr absurde Dinge, wenn sie große Modelle in Geschäftssysteme einbinden. Sie brauchen eigentlich nur die Antwort, ob diese E-Mail eine Spam-E-Mail ist oder eine von fünf API-Schnittstellen auszuwählen, aber sie müssen ein riesiges Modell mit Hunderten von Milliarden von Parametern dazu bringen, über mehrere Sekunden lang Zeichen für Zeichen eine JSON-Zeichenfolge auszugeben.
Um sicherzustellen, dass diese Zeichenfolge den Codespezifikationen entspricht, müssen Entwickler ganze zwei Seiten an Prompts schreiben und das Modell bitten, „keinen überflüssigen Text auszugeben, sondern nur reines JSON-Format“. Trotzdem fügt das Modell manchmal einen Satz wie „OK, das ist das von Ihnen gewünschte Format“ am Anfang oder Ende hinzu, was die gesamte nachgeschaltete Pipeline sofort zum Absturz bringt.
Die Lösung von Jev ist extrem direkt. Es ist überhaupt kein autoregressives Textmodell.
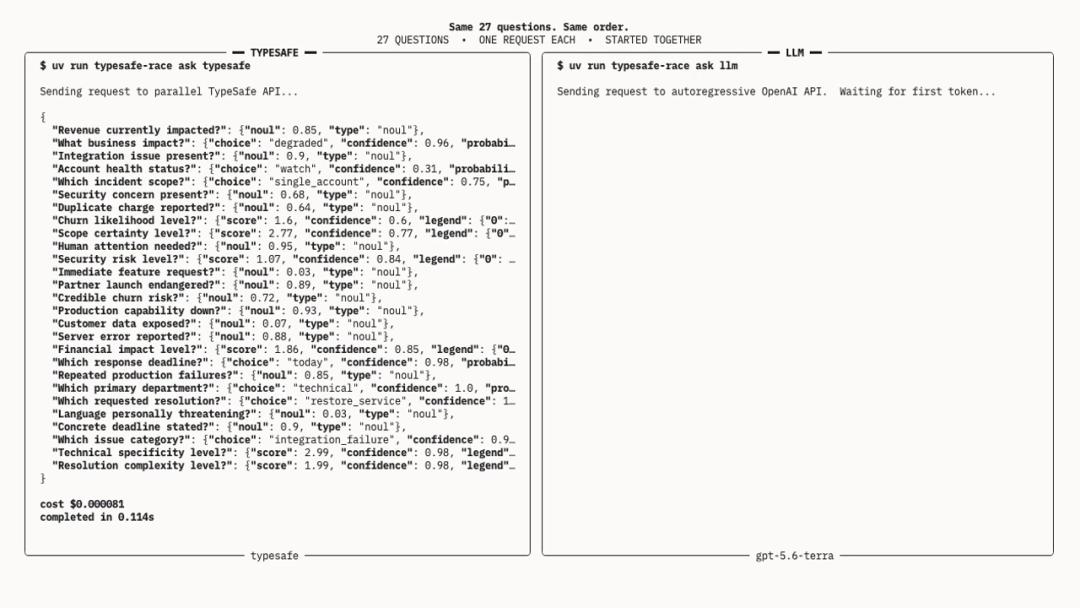
Geschwindigkeitsvergleich: Nach 3 Sekunden hat Jev bereits massenhaft Tokens ausgegeben (links)|Bildquelle: TypeSafe
In Kahnemans berühmtem Werk „Schnelles Denken, Langsames Denken“ wird das menschliche Denken in zwei Systeme unterteilt. System 1 ist unbewusstes, extrem schnelles instinktives Intuitionsvermögen; System 2 ist langsames, energieaufwändiges logisches Schlussfolgern. Die aktuellen großen Mainstream-Modelle bemühen sich alle, System 2 zu perfektionieren, während Jev sich selbst als das erste reine „System-1-Modell“ der Welt definiert.
Es generiert Inhalte nicht Wort für Wort, sondern alle Entscheidungen werden gleichzeitig in einer einzigen unidirektionalen parallelen Berechnung erzeugt. Das bedeutet, dass es keine generierten überflüssigen Texte gibt und die Ausgabe immer streng auf das von Entwicklern vordefinierte Schema beschränkt ist.
Auf mathematischer Ebene beseitigt Jev vollständig die Format-Halluzination bei strukturierten Ausgaben.
Da es nicht Schritt für Schritt ableiten muss, was der nächste Token ist, wird seine End-to-End-Latenz direkt auf 70 bis 500 Millisekunden komprimiert, was 40 bis 200 Mal schneller ist als die aktuellen fortschrittlichen großen Modelle auf dem Markt.
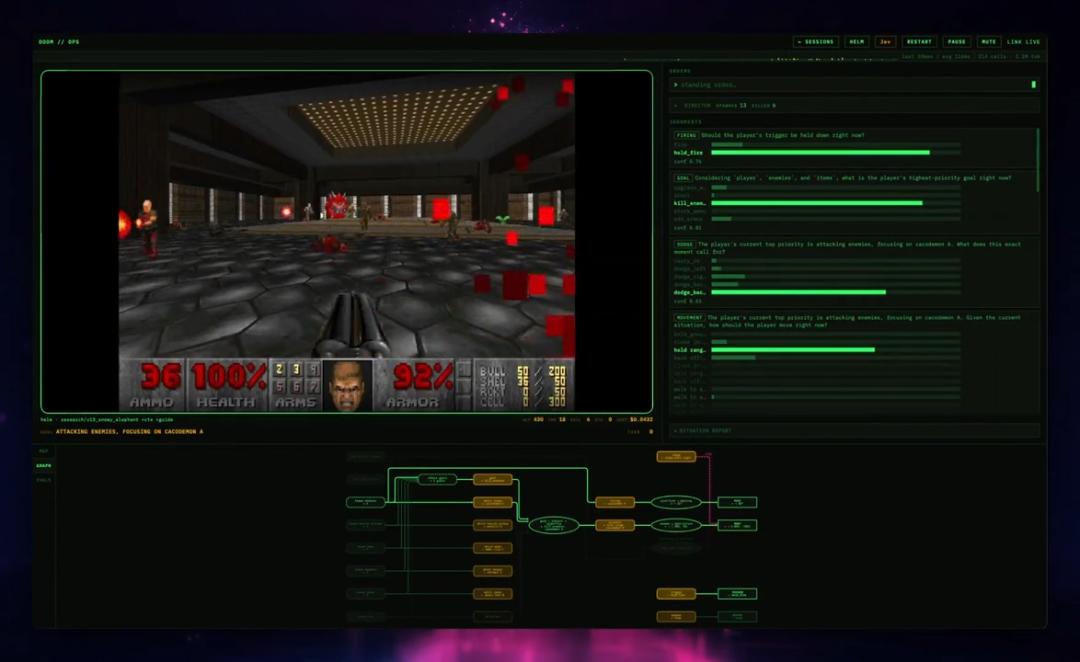
Jev beim Test des Doom-Spiels|Bildquelle: TypeSafe
TypeSafe hat Jev sogar dazu verwendet, das Shootergame Doom zu spielen. In Szenarien, in denen keine komplexen langfristigen Planungen erforderlich sind, sondern nur etwa 10 sofortige Handlungsentscheidungen pro Sekunde getroffen werden müssen, verhält sich Jev wie ein menschlicher Spieler mit extrem schnellen Reflexen, während die gesamten Schlussfolgerungskosten nur etwa 7 US-Dollar pro Stunde betragen.
Noch überraschender ist der Preis. Die Eingabekosten von Jev betragen nur 0,042 US-Dollar pro 1 Million Token, und die Ausgabe ist völlig kostenlos. Im Durchschnitt liegen die Kosten für eine einzelne strukturierte Entscheidung bei etwa 0,0004 US-Dollar. Zum Vergleich: Die Kosten für einen Aufruf von GPT-5.6 Terra sind etwa 76 Mal so hoch, und die von Claude Opus 5 sogar hunderte Male so hoch.
Eingegebene unstrukturierte Daten geben sofort klassifizierte Auswahlmöglichkeiten mit kalibrierten Wahrscheinlichkeiten, numerische Bewertungen oder boolesche Urteile aus und geben dann sofort die Kontrolle zurück. Das ist die gesamte Arbeit von Jev.
Der Engpass von Agenten ist nicht ein zu langsames Gehirn
Warum hat sich TypeSafe entschieden, zu diesem Zeitpunkt ein Modell zu entwickeln, das überhaupt keine Wörter ausgibt?
Die Antwort liegt in den KI-Agenten, die derzeit umfassend eingeführt werden.
Ob es sich um Cursor, GitHub Copilot oder verschiedene unternehmensweite automatisierte Workflows im Silicon Valley handelt, die Ingenieure stellen schnell eine grausame Realität fest: Die heutigen Agenten sind langsam und teuer, oft nicht weil die Kernlogik nicht intelligent genug ist, sondern weil die „Ausführungsreibung“ dazwischen zu groß ist.
Eine vollständige Agentenaufgabe umfasst normalerweise Dutzende kleiner Entscheidungen. Zum Beispiel beurteilen, ob der aktuelle Schritt erfolgreich ist, entscheiden, ob Werkzeug A oder Werkzeug B aufgerufen wird, Schlüsselfelder aus der vorherigen Ausgabe extrahieren und beurteilen, ob der Prozess beendet werden soll.
Wenn jede kleine Aktion einen Aufruf eines riesigen Modells mit Milliarden von Parametern erfordert, summiert sich die Latenz nicht nur auf Dutzende von Sekunden oder sogar Minuten, sondern die Kosten geraten auch schnell außer Kontrolle. Noch schlimmer: Wenn die JSON-Format-Parsing in einem einzigen Schritt fehlschlägt, bleibt der gesamte Agent direkt auf halbem Weg stecken.
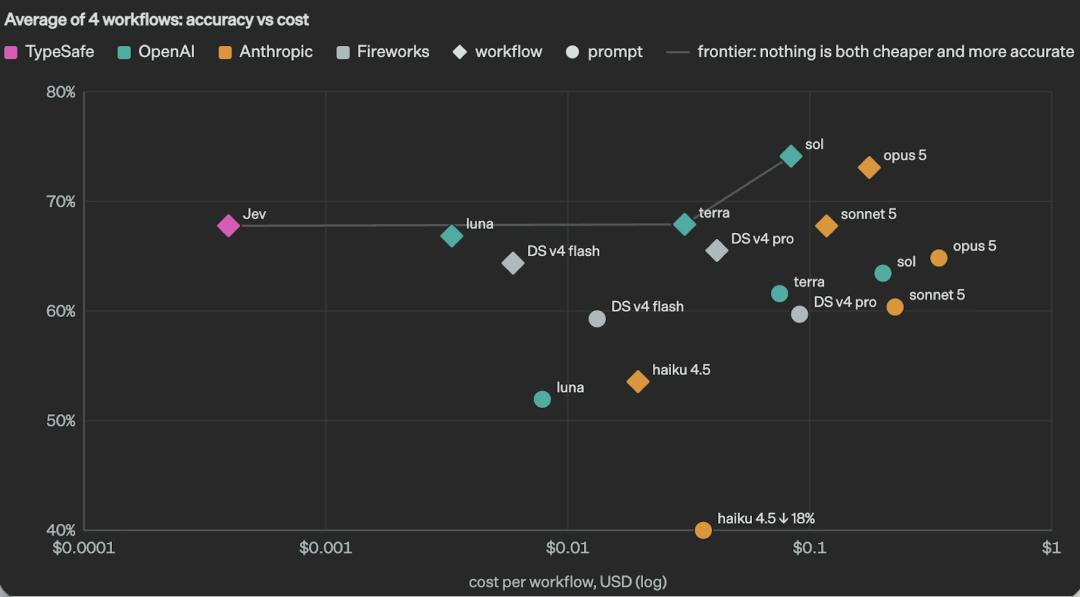
Vergleich der durchschnittlichen Genauigkeit und Kosten von Workflows|Bildquelle: TypeSafe
Die Branche ist zu lange von autoregressiven Textmodellen gefangen gewesen, sodass fast alle selbstverständlich davon ausgehen, dass alle KI-Aufgaben über natürliche Sprache vermittelt werden.
Aber in den Produktionssystemen der realen Welt sind die meisten Knoten im Wesentlichen nur traditionelle Codesteuerungsströme. Code braucht keinen emotionalen Wert, Code braucht keine Parallelismen, Code braucht nur ein extrem billiges, extrem schnelles und absolut typkonformes Entscheidungssignal.
Das Erscheinen von Jev bedeutet tatsächlich, dass eine Schicht von „vorderem Reflexbogen“ in die Systemarchitektur großer Modelle eingefügt wird.
In einer idealen kooperativen Architektur sollten die teuren fortschrittlichen großen Modelle in den Hintergrund treten und als System 2 fungieren, das die Gesamtsituation steuert und für makroskopische Planung und schwieriges Denken verantwortlich ist. Die an vorderster Front anfallenden lästigen Arbeiten wie Ticketklassifizierung, erste Prüfung der Inhaltskonformität, Massendatenmarkierung und sogar die genaue Auswahl eines von Dutzenden von APIs können vollständig von einem System-1-Modell wie Jev in Millisekunden erledigt werden.
Eigene Testdaten von TypeSafe zeigen, dass Jev in vier typischen unternehmensweiten Workflows eine Genauigkeit von 67,8 % erreicht, was fast der Genauigkeit von 67,9 % von GPT-5.6 Terra entspricht. Wenn man nur die Genauigkeit der Urteile betrachtet, hat es nicht gegen die großen Modelle verloren, die um ein Vielfaches teurer sind, während die Ausführungsgeschwindigkeit um ein Vielfaches höher liegt.
Die Trennung des langsamen Denkens der Großhirnrinde von den bedingten Reflexen des Rückenmarks könnte der richtige Weg sein, damit KI-Agenten wirklich in die großtechnische industrielle Anwendung gelangen.
Die Black Box hinter 0 Fehler
Es ist jedoch zu früh, Jev als perfektes Wundermittel zu betrachten. Hinter diesem beeindruckenden technischen Ergebnis gibt es mindestens zwei große Schattenseiten, die bewusst vermieden werden.
Zuerst der vollständige Verlust der Erklärbarkeit.
Obwohl traditionelle Chain-of-Thought-Modelle umständlich und fehleranfällig sind, schreiben sie zumindest den Prozess, „warum sie so gewählt haben“, auf ein Blatt Papier. Wenn ein Kreditprüfungs-Agent den Antrag eines Kunden ablehnt oder ein Sicherheitssystem eine Transaktion blockiert, kann die Compliance-Abteilung die Entscheidungslogik des Modells über den Schlussfolgerungsprozess nachverfolgen.
Die Ausgabe von Jev besteht jedoch nur aus trockenen Optionen und Wahrscheinlichkeiten, es hat überhaupt keine Fähigkeit, die Gründe in natürlicher Sprache zu erläutern. Wenn das Modell eine kritische Fehlentscheidung trifft, kann niemand den Grund aus seinen Black-Box-artigen Gewichten herausfinden. In stark regulierten Bereichen wie Finanzen, Medizin und Recht stößt diese Art von Entscheidungsmechanismus ohne Prüfmöglichkeit oft direkt an die Wand der Compliance.
Zweitens die Abgeschlossenheit der technischen Details und Bewertungsmaßstäbe.
TypeSafe behauptet, dass sie eine neue Trainingsmethode namens RLCD (Reinforcement Learning with Calibrated Decisions) erfunden haben, die das traditionelle RLHF ersetzt. Aus den derzeit veröffentlichten Informationen geht jedoch hervor, dass die genaue Gestaltung der Belohnungsfunktion, die genaue Netzwerkarchitektur und die mathematische Methodik der kalibrierten Wahrscheinlichkeiten von der offiziellen Seite nicht offengelegt werden.
Noch subtiler sind die beeindruckenden Punktzahlen. Alle aktuellen Benchmark-Tests stammen aus internen Bewertungen von TypeSafe, keine unabhängige Drittorganisation hat sie bisher reproduziert. Die Referenzantworten, die sie als Wahrheitsstandard verwenden, werden sogar aus den Ergebnissen von GPT-6 Astra und Claude Fable 5.1 gemittelt. Die Verwendung des nächsten Modells des Konkurrenten als Schiedsrichter und dann zu erklären, dass man im Preis-Leistungs-Verhältnis einen großen Sieg errungen hat, hat an sich einen starken PR-Charakter.
Ganz zu schweigen von der Nachhaltigkeit des Geschäftsmodells. Nur 4 Cent pro 1 Million Token zu verlangen und die Ausgabe völlig kostenlos zu machen, ist so niedrig, dass man vermutet, dass die 40 Millionen US-Dollar Finanzierung für Preiskämpfe verbrannt werden.
Derzeit befindet sich Jev noch in einer kleinen, auf Einladung begrenzten Betaphase. Wenn eine große Anzahl hochparalleler echter unternehmensweiter Datenströme hereinkommt, bleibt abzuwarten, ob dieses System die extrem niedrige Latenz beibehalten und gleichzeitig die Kostendeckung erreichen kann.
Modelle kleiner, schneller und determinierter zu machen, trifft tatsächlich die aktuellen Schmerzpunkte der Branche. Aber es ist noch zu früh, zu behaupten, dass es das Paradigma umgestoßen hat, bevor es nicht wirklich extremen Situationen in echten Geschäftsumgebungen ausgesetzt wurde.
In den letzten Jahren waren alle erstaunt darüber, dass KI immer schöner sprechen kann. Und jetzt hat endlich jemand erkannt, dass in der stillen Welt der Maschinen Handlungen oft wichtiger sind als Worte.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „GeekPark“ (ID: geekpark), Autor: Hualin Wuwang, Redakteur: Jingyu, veröffentlicht mit Genehmigung von 36Kr.