Der härteste Kampf um AGI findet überraschenderweise im Krankenhaus statt. Chinesische KI wurde in Science veröffentlicht, Ärzte fürchten keine Arbeitslosigkeit und drängen sogar auf deren rasche Inbetriebnahme.
KI erobert alle Bereiche, doch es gibt eine harte Nuss, die sich bisher nicht knacken lässt und unzählige Hoffnungen zunichte macht.
Im Jahr 2016 prophezeite der alte Meister Hinton: „Die Menschen sollten jetzt aufhören, Radiologen auszubilden.“ Er war sogar der Ansicht, dass KI innerhalb von fünf Jahren die Radiologen bei der Erkennung von medizinischen Bildern übertreffen würde.
Der alte Meister war sein Leben lang vorsichtig, aber die Geschichte hat ihm einen Streich gespielt. Zehn Jahre sind vergangen, die Menschen nähern sich dem AGI immer mehr, aber im medizinischen Umfeld ist selbst eine KI-Aufgabe wie die Bilderkennung, die eigentlich ein Anfängerspiel sein sollte, nach wie vor ein harter Modus.
Zählt man von IBMs Watson an, gibt es unzählige KI-Experten, die in der Medizin eine Niederlage erlitten haben.
Warum ist die Medizin zur Achillesferse der KI geworden?
– Die extrem hohen Anforderungen an die Modellgenauigkeit: In anderen Bereichen kann man über Modellhalluzinationen lachen, aber hier geht es um Menschenleben.
Dies führt auch dazu, dass die KI für medizinische Bilder seit langem in spezialisierten Modellen gefangen ist.
Bis heute hat der „König“ der wissenschaftlichen Zeitschriften, Science, eine gewichtige Studie aus China offiziell veröffentlicht:
DAMO RADAR, das laut Angaben das weltweit erste expertenfähige allgemeine KI-Modell für die medizinische Bildgebung ist.
Dieses Modell kann 146 Krankheiten in 18 anatomischen Strukturen des Abdomens erkennen und ist genauer als viele Radiologen.
Darüber hinaus sind das Modell, der Code und das Framework vollständig quelloffen.
Ein Modell erkennt 146 Krankheiten
DAMO RADAR, der vollständige Name lautet Rapid Abdominal Diagnosis with AI and Radiology, ist ein KI-Modell für die schnelle Diagnose im Bauchraum.
Das Entwicklerteam dieses KI-„Radars“ ist das Alibaba Damo Academy. In den vergangenen Jahren hat es mit KI die im CT kaum sichtbaren frühen Krebsherde erkannt, wichtige Durchbrüche bei spezifischen Krankheiten wie Bauchspeicheldrüsenkrebs, Magenkrebs und Darmkrebs erzielt und 5 Arbeiten in *Nature Medicine* veröffentlicht.
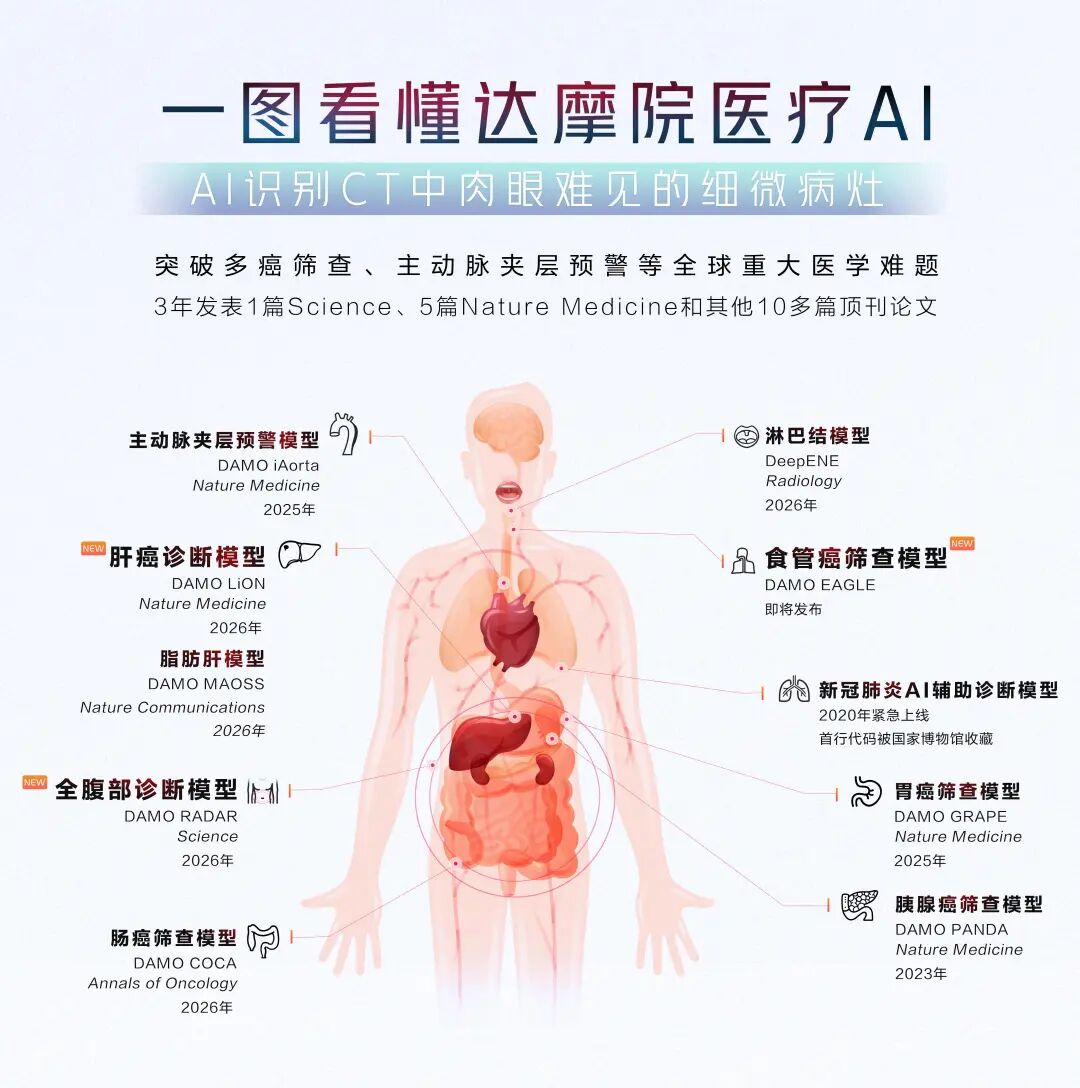
Aber im Laufe der Arbeit merkten einige Mitglieder des Damo Academy, dass etwas nicht stimmte. Zhang Jianpeng, leitender Algorithmusexperte bei Damo Academy, sagte: Die Bewältigung einer einzigen Krankheitsart dauert mindestens zwei bis drei Jahre. Es gibt Tausende von menschlichen Krankheiten, also könnten wir unser ganzes Leben lang damit verbringen, ohne jemals fertig zu werden …
Schwieriger ist noch, dass Patienten in der realen Welt nicht nur mit einer einzigen Krankheit ins Krankenhaus kommen, um das spezialisierte Modell zu fragen, ob sie diese Krankheit haben. Tatsächlich können in einem CT-Bild gleichzeitig mehrere Organe und mehrere Läsionen vorhanden sein.
Das Damo Academy hat sich gemeinsam mit dem ersten Krankenhaus der Zhejiang-Universität und zahlreichen weiteren Krankenhäusern weltweit der Herausforderung der Abdomen-CT gestellt, in der Hoffnung, dass KI alle Arten von Bauchkrankheiten auf einmal erkennen kann.
Die Wahl fiel auf den Bauchraum, weil dies das klinisch anerkannte schwierigste Szenario für die Bildgebung ist.
Xiao Wenbo, Direktor der Radiologieabteilung des ersten Krankenhauses der Zhejiang-Universität, erläuterte: Junge Ärzte fürchten sich normalerweise am meisten davor, der Arbeitsgruppe für den Bauchraum zugeteilt zu werden.
Denn der Bauchraum umfasst das Verdauungssystem, das Harnsystem und das Fortpflanzungssystem. Leber, Galle, Bauchspeicheldrüse, Milz und Darm liegen dicht beieinander, der Darm windet sich durch die gesamte Bauchhöhle. Fast alle Organe sind Weichteile mit ähnlicher Dichte, und die Läsionen lassen sich nur durch die Empfindlichkeit des menschlichen Auges für Dichteunterschiede erkennen.
Bisher gibt es bereits KI-Hilfswerkzeuge für Lungenknoten und Ähnliches, aber der Bauchraum ist zu komplex und galt lange als Tabubereich, den niemand zu betreten wagte.
Was RADAR erreichen soll, ist die Abdeckung des gesamten Bauchraums mit einem einzigen Modell.
Schließlich deckt es 18 anatomische Strukturen und 146 Krankheiten ab, darunter wichtige Organe wie Leber, Bauchspeicheldrüse, Galle, Niere, Milz und Darm, und deckt im Wesentlichen alle klinisch häufigen Läsionen ab.
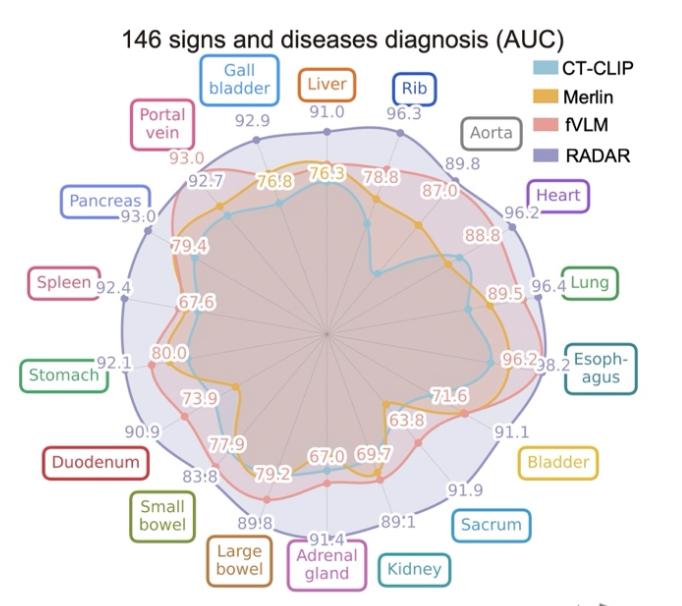
Für die Prüfung seiner Wirksamkeit hat das Team eine sehr strenge mehrstufige Validierung durchgeführt.
In einer internen fortlaufenden Kohorte von fast 39.000 echten Fällen aus der realen Welt erreichte die durchschnittliche AUC von RADAR 0,913.
AUC ist ein Maß für die Fähigkeit eines Diagnosemodells, Patienten von gesunden Personen zu unterscheiden. Der Wert 1 bedeutet perfekte Unterscheidung, 0,5 entspricht zufälligem Raten, und ein Wert über 0,9 gilt als hervorragend.
Anschließend hat das Team RADAR an mehr als 24.000 CT-Bildern aus 8 externen Krankenhäusern validiert. Diese Fälle stammen aus verschiedenen Regionen und wurden mit unterschiedlichen Scan-Geräten erfasst, und die AUC von RADAR erreichte immer noch 0,895.
Darüber hinaus lässt sich RADAR auch auf das Notfallszenario verallgemeinern.
Der Unterschied zwischen dem Notfallszenario und dem regulären Ambulanzszenario besteht darin, dass aufgrund des Zeitdrucks keine Zeit bleibt, damit das Kontrastmittel seine volle Wirkung entfaltet, und die Patienten nicht immer in der Lage sind, mitzuwirken, sodass die Qualität der CT-Bildgebung schlechter ausfällt.
Das Trainingziel von RADAR umfasste keine Notfallszenarien, aber bei Tests mit 27.000 Notfalldaten erreichte die AUC immer noch einen Wert von 0,904.
Darüber hinaus hat das Damo Academy die Anforderungen an RADAR bei der Diagnose von vier Krebsarten – Leberkrebs, Bauchspeicheldrüsenkrebs, Magenkrebs und Darmkrebs – noch weiter angehoben.
Bei diesen vier Krebsarten diente der „pathologische Goldstandard“ als Grundlage für die Bewertung von RADAR, das heißt, das Ergebnis der pathologischen Biopsie wurde als Ground Truth verwendet, um zu bestätigen, ob die Bildauswertung korrekt ist.
In diesem erweiterten Test erreichte die AUC von RADAR immer noch Werte zwischen 0,891 und 0,984.
Das Damo Academy hat auch einen Vergleich zwischen Mensch und Maschine durchgeführt.
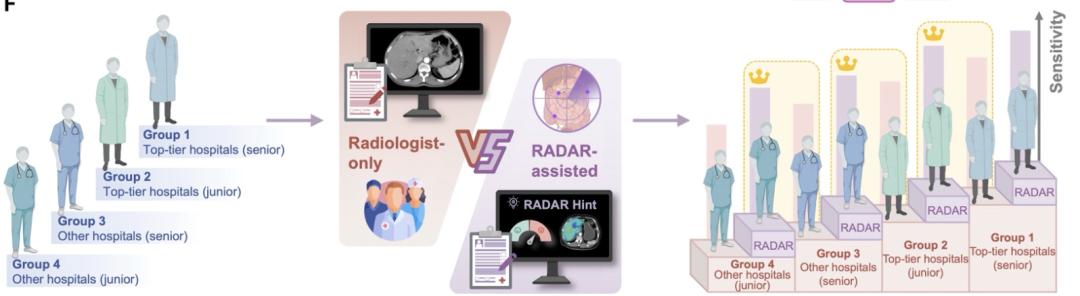
An diesem Vergleich nahmen 26 Radiologen aus 14 Krankenhäusern teil. RADAR und die Ärzte haben unabhängig voneinander dieselben Fälle diagnostiziert, und das Ergebnis zeigte, dass die Genauigkeit von RADAR 23 der Ärzte übertrifft und nur etwas geringer ist als die von 3 erfahrenen Ärzten.
Gleichzeitig hat das Damo Academy auch das Szenario der Zusammenarbeit zwischen Mensch und Maschine getestet und festgestellt, dass die Gesamtsensitivität der Ärzte bei der Auswertung von Bildern mit KI-Unterstützung um etwa 10 % gestiegen ist und die durchschnittliche Auswertungszeit um mehr als 30 % gesunken ist.
Die Konfiguration „Junger Arzt + KI“ erreicht eine Sensitivität, die sogar die von erfahrenen Ärzten bei der alleinigen Auswertung von Bildern übertrifft.
Wie hat RADAR das eigentlich geschafft?
Bisherige KI-Systeme für medizinische Bilder verwenden überwachtes Lernen, das einfach gesagt bedeutet, dass Ärzte CT-Bilder einzeln annotieren und die KI dann anhand dieser Annotationen lernt.
Diese Methode ist mit enormen Annotierungskosten verbunden, und das Modell kann nur die wenigen Krankheiten erkennen, die annotiert wurden – andere Krankheiten erkennt es nicht.
RADAR geht einen anderen Weg, der als visuell-sprachliches kontrastives Lernen bezeichnet wird.
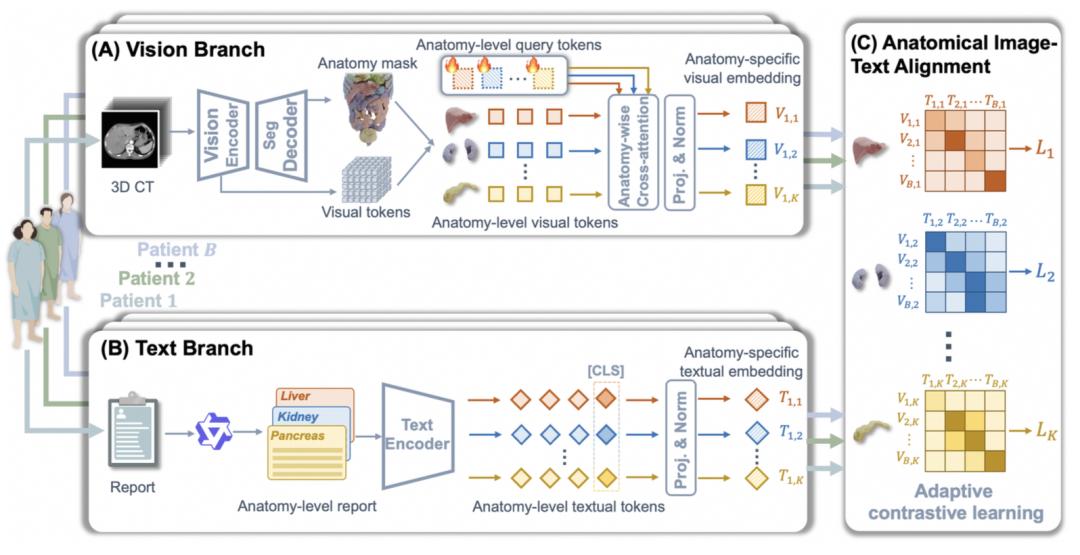
In Krankenhäusern gibt es natürlicherweise eine große Menge an CT-Bildern und den dazugehörigen Diagnoseberichten. RADAR lernt direkt aus der Zuordnung zwischen Bildern und Berichtstexten, ohne dass Ärzte zusätzliche Bilder einzeln annotieren müssen.
Das funktioniert ähnlich wie bei Medizinstudenten, die mit dem Chefarzt bei der Visite gehen: Wenn der Chefarzt beim Betrachten von Bildern sagt „In der Leber befindet sich eine lichte Herdstelle, die als Hämangiom einzustufen ist“, lernen die Studenten nach mehrmaligem Hören ganz natürlich, welche Bildmerkmale welcher Diagnose entsprechen.
Aber die direkte Zuordnung des gesamten CT-Bildes zum gesamten Bericht führt zu schlechten Ergebnissen.
Das Team hat diesen Weg zuerst ausprobiert und festgestellt, dass das Modell nur grobe statistische Merkmale lernen kann und keine Verbindung zwischen „welchem Organ welche Beschreibung zugeordnet ist“ herstellen kann.
Denn ein Satz von Bauch-CT besteht aus Hunderten von Slices, die viele Organe umfassen. Die eigentliche Problemstelle ist möglicherweise nur eine sehr kleine Läsion in einem bestimmten Organ. Wenn das Modell das gesamte Bild zur Auswertung verwendet, wird das wichtige Signal von einer großen Menge an normalem Gewebe überdeckt.
Dies führt zum zentralen Durchbruch von RADAR – der „feingranularen Ausrichtung auf Organebene“.
Zuerst lokalisiert es alle Organe wie Leber, Bauchspeicheldrüse, Galle und Niere im CT, teilt den gesamten CT-Satz in einzelne Organeinheiten auf und richtet dann jede Organeinheit exakt der entsprechenden Beschreibung im Bericht zu.
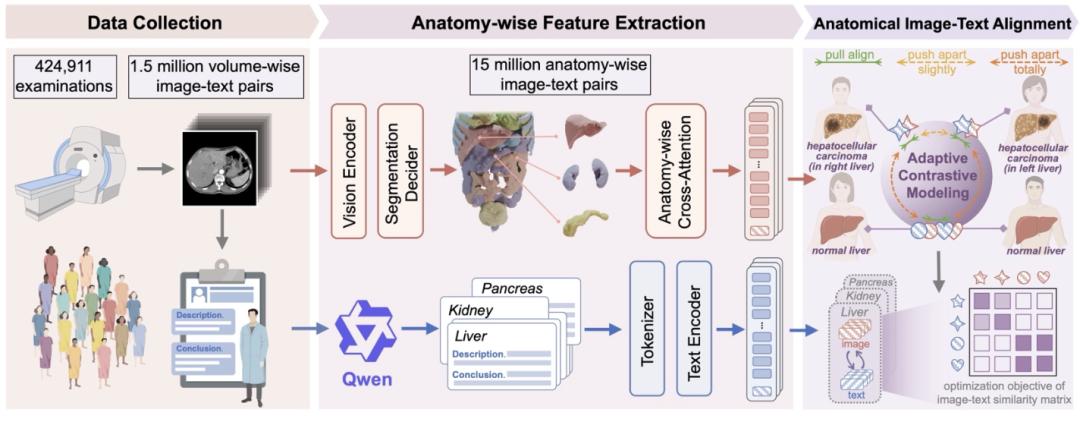
Die Inspiration für dieses Design stammt aus der tatsächlichen Arbeitsweise von Radiologen.
Wenn Ärzte ein Bauch-CT betrachten, scannen sie nicht den gesamten Bauch auf einen Blick, sondern betrachten nacheinander Leber, Bauchspeicheldrüse, Gallengänge, Niere und Darm, gehen jedes Organ einzeln durch. RADAR lässt die KI auf diese Weise lernen.
Eine weitere Innovation ist das adaptive kontrastive Modellieren.
Beim standardmäßigen kontrastiven Lernen wird standardmäßig davon ausgegangen, dass die Merkmale verschiedener Patienten streng voneinander getrennt sind. Aber im medizinischen Umfeld sollten zwei Patienten mit gesunder Leber nicht getrennt voneinander behandelt werden.
Ebenso sollten die Bildmerkmale von zwei Patienten mit derselben Krankheit gemeinsam erlernt werden.
RADAR passt den Abstand zwischen den Proben dynamisch anhand dieser medizinischen Kenntnisse an.
Darüber hinaus zeigt die im Papier dargestellte Scaling-Law-Kurve, dass die Leistung des Modells mit zunehmender Datenmenge weiter steigt, ohne Anzeichen einer Sättigung.
Ärzten dabei helfen, „eine Läsion weniger zu übersehen“
Die Scaling-Law-Kurve steigt weiter an, aber die Fähigkeiten, die RADAR bereits jetzt erreicht hat, verändern bereits den Arbeitsrhythmus der Ärzte an der Frontlinie.
„Als ich die Validierungsdaten von RADAR zum ersten Mal sah, konnte ich es kaum glauben“, sagte Xiao Wenbo, Direktor der Radiologieabteilung des ersten Krankenhauses der Zhejiang-Universität. Dass KI in so vielen ähnlichen Strukturen des Bauchraums auf einmal 146 Krankheiten erkennen kann und die AUC einen Wert um 0,9 erreicht, übertrifft die Vorstellungen der Ärzte völlig.
In der Abteilung herrschte Aufregung, viele Ärzte sagten: Setzt es sofort ein! Viele Ärzte von externen Krankenhäusern kamen ebenfalls vorbei, weil sie von der Technologie gehört hatten, in der Hoffnung, dass KI ihnen bei dem lästigen Problem der Bauch-CT-Auswertung helfen kann.
Xiao Wenbo arbeitet seit mehr als 30 Jahren in der Bildgebung, leitet eine Abteilung mit über 300 Mitarbeitern, die täglich Tausende von Bildern verarbeitet.
Die Erstellung eines Berichts für ein Bauch-CT dauert selbst bei mittelalten und erfahrenen Ärzten mindestens 20 Minuten, da ein CT aus Hunderten von Bildern besteht, die alle nacheinander ausgewertet werden müssen.
Sie weiß nur zu gut, wie schwierig diese Aufgabe ist.
Erst als sie feststellte, dass RADAR nach wiederholten Validierungen immer noch eine nahezu gleichbleibende Genauigkeit aufweist, war sie wirklich überzeugt.
In der Bildgebungsabteilung gibt es den Spruch „Dieselbe Krankheit zeigt unterschiedliche Bilder, unterschied