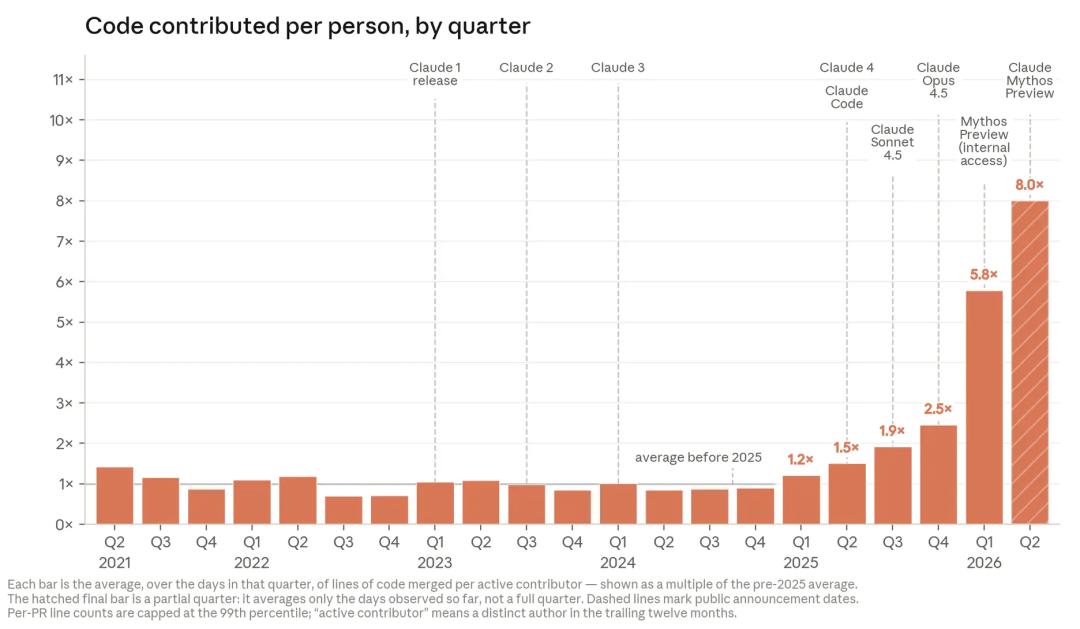
Gerade ist das von Claude entwickelte Claude innerhalb eines halben Jahres um das 26-fache stark angestiegen, und 30.000 Agents sind gleichzeitig im Einsatz.
Gerade eben hat Anthropic zum ersten Mal detailliert die internen Fortschritte offengelegt, die Claude bei der Entwicklung der nächsten Generation von KI macht.
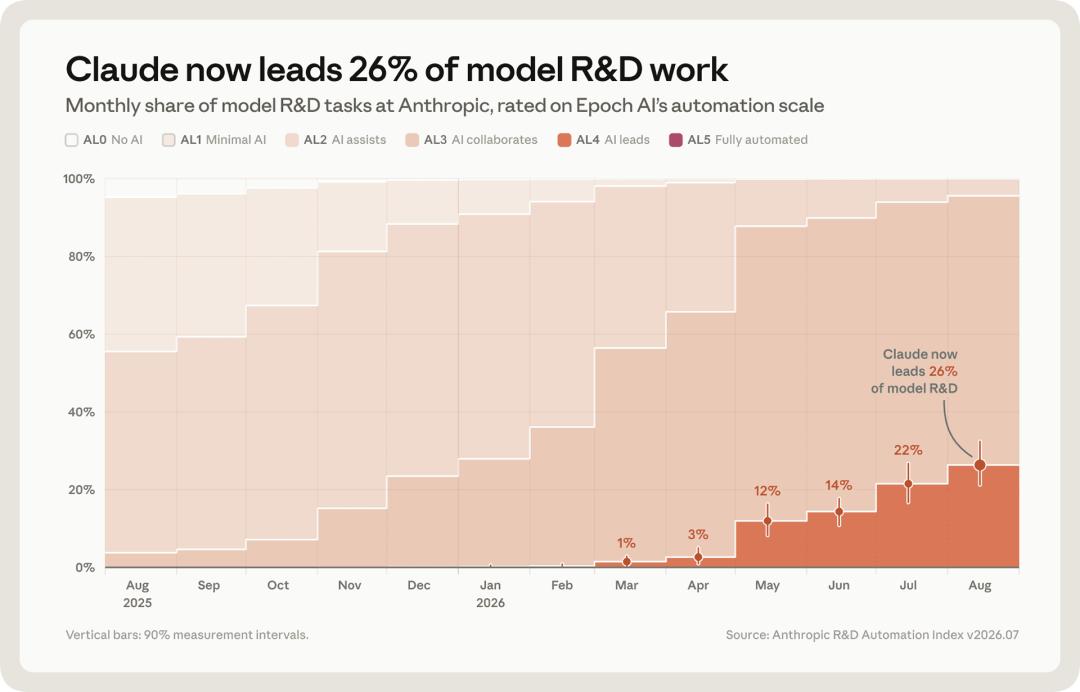
Bis zum August dieses Jahres war Claude bereits in der Lage, etwa 26 % der KI-Entwicklungsarbeiten bei Anthropic zu „leiten“, und über 90 % der Aufgaben erreichten mindestens das Niveau der „KI-Kooperation“. Im Vergleich dazu betrug der Anteil der Arbeiten, die Claude im Februar dieses Jahres leiten konnte, weniger als 1 %.
Gleichzeitig arbeiten etwa 30.000 KI-Agenten auf der am häufigsten genutzten internen Plattform von Anthropic an Forschungs- und Ingenieurarbeiten.
Allein im August dieses Jahres haben sie mehr als 1 Milliarde Entscheidungen getroffen, von denen etwa 0,002 % vom Echtzeit-Überwachungssystem blockiert wurden, was einem Auslösemechanismus zur Verhinderung von Problemen alle 47.000 Aktionen entspricht.
Darüber hinaus gab Anthropic bekannt, dass etwa 6 % der für die KI-Entwicklung verwendeten Rechenleistung in die Sicherheitsforschung fließen, während dieser Anteil bei der KI-gesteuerten KI-Entwicklung 12 % beträgt.
Nun stellt sich die Frage: Wenn KI an der Herstellung der nächsten Generation von KI beteiligt ist, können Menschen ihr Tempo noch klar erfassen und ihre Maßnahmen rechtzeitig eingreifen?
KI baut KI – dies ist bereits Teil des Entwicklungsprozesses bei Anthropic
Um das Ausmaß der Beteiligung von Claude an den internen Entwicklungsarbeiten zu messen, hat Anthropic ein Prototypsystem namens „Anthropic Automatisierungsindex für die Entwicklung“ aufgebaut.
Dieser Index verwendet die von Epoch AI vorgeschlagenen Automatisierungsstufen und unterteilt das Ausmaß der KI-Beteiligung an der Entwicklung in sechs Stufen von AL0 bis AL5.
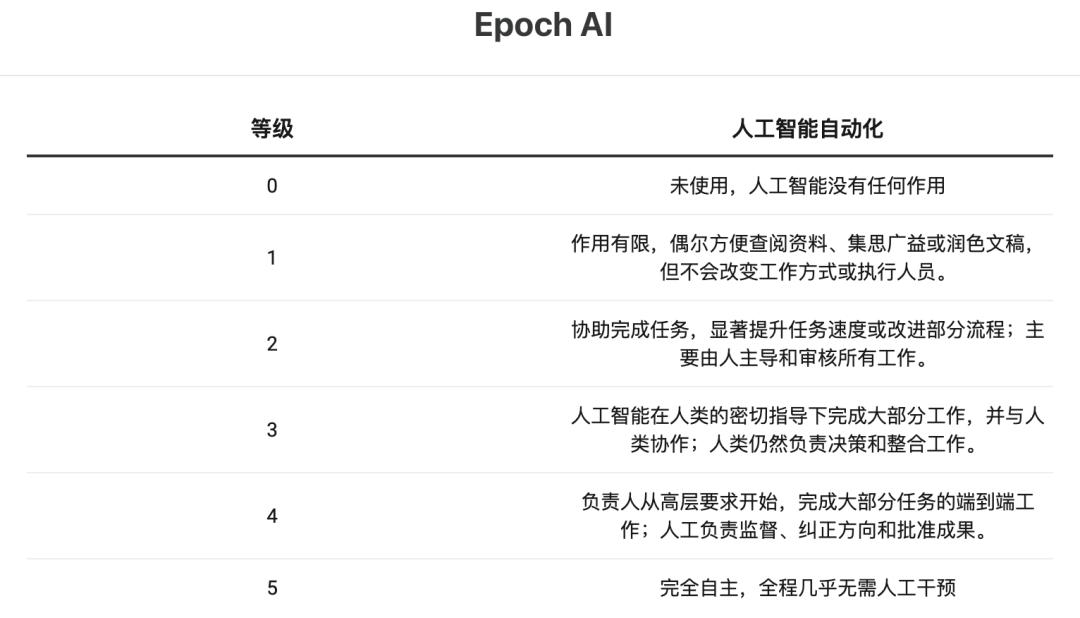
AL0 steht für keine KI-Beteiligung, AL3 bedeutet, dass KI unter enger Anleitung von Ingenieuren eine große Menge an Arbeiten übernehmen kann, AL4 bedeutet, dass KI nach Erhalt eines hochrangigen Ziels die meisten Aufgaben erledigen kann und nur an wichtigen Punkten menschliche Aufsicht erhält. AL5 bedeutet, dass KI Probleme erkennen, Aufgaben planen, Änderungen durchführen, Tests abschließen und direkt bereitstellen kann – der gesamte Prozess läuft ohne menschliches Eingreifen ab.
Was Anthropic als „Claude leitet 26 % der KI-Entwicklungsarbeiten“ bezeichnet, entspricht der Stufe AL4.
Nehmen wir als Beispiel einen Ausfall einer nächtlichen Datenpipeline: Auf der Stufe AL3 müssen Ingenieure die Protokolle einsehen, erste Beurteilungen abgeben und Claude weiterhin Anleitung geben, wenn es auf neue Probleme stößt. Nach dem Übergang zu AL4 müssen Ingenieure Claude nur die Ausfallwarnung übergeben. Claude kann dann selbstständig die Protokolle analysieren, die fehlerhafte Stelle finden, Reparaturpläne erstellen und testen, unerwartete Situationen im Prozess bewältigen und die Pipeline erneut mit Testdaten ausführen.
Nach Abschluss der oben genannten Arbeiten fasst Claude die Ursache des Problems und die vorgenommenen Änderungen zusammen, danach entscheiden die Ingenieure, ob die Lösung bereitgestellt wird. Die Menschen behalten weiterhin das endgültige Recht zur Veröffentlichung, müssen aber nicht mehr den gesamten Prozess kontinuierlich begleiten.
Bis zum August dieses Jahres hat Anthropic jedoch noch keine einzige Art von KI-Entwicklungsarbeit gefunden, die die Stufe AL5 erreicht hat.
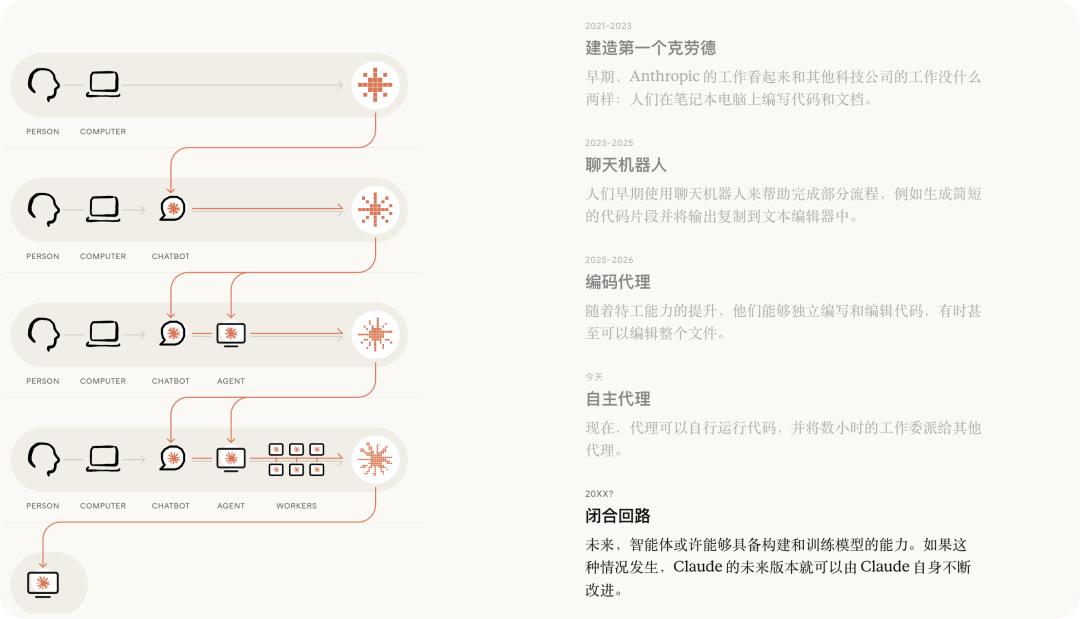
Claude kann noch nicht alle Ausfälle selbstständig überwachen und keine Änderungen ohne menschliche Genehmigung in der Produktivumgebung bereitstellen. Claude hat keine rekursive Selbstverbesserung erreicht, aber der technische Zyklus, in dem KI an der Entwicklung der nächsten Generation von KI beteiligt ist, ist von einer Forschungsidee zu einem statistisch erfassbaren und nachverfolgbaren internen Produktionsprozess geworden.
Um diesen Index aufzubauen, hat Anthropic im Juli dieses Jahres wöchentlich zufällig etwa 20 % der Mitarbeiter der relevanten Abteilungen ausgewählt, Claude die Arbeitsaufzeichnungen untersuchen lassen, die diese Mitarbeiter in Slack und internen Dokumenten hinterlassen haben, und schließlich etwa 15.000 spezifische Entwicklungsaufgaben zusammengestellt.
Anschließend organisierte Claude diese Aufgaben in einem hierarchischen Baum mit 542 Knoten, darunter 378 spezifische Aufgabentypen, die Bereiche wie Vortraining, Verstärkungslernen, Ausfälle von Bewertungsplattformen, Sandbox-Netzwerkrichtlinien und Nachbesprechungen zu Vorfällen bei Inferenzdiensten abdecken. Anthropic weist dann Gewichte entsprechend der Arbeitszeit zu, die die Mitarbeiter investieren, um die Bedeutung verschiedener Aufgaben im gesamten Entwicklungsprozess zu beurteilen.
Aus den Datenänderungen geht hervor, dass der Anteil der von Claude geleiteten Entwicklungsarbeiten von weniger als 1 % im Februar dieses Jahres auf 26 % im August gestiegen ist. Innerhalb von nur einem halben Jahr hat sich die Rolle von KI bei Anthropic von einem Entwicklungstool zu einem Entwicklungsteilnehmer gewandelt, der vollständige Aufgaben übernehmen kann.
Wenn 30.000 Agenten beginnen, Entscheidungen für Menschen zu treffen
Nachdem der Grad der Automatisierung der Entwicklung gestiegen ist, taucht ein weiteres Problem bei Anthropic auf: Wenn Zehntausende von Agenten gleichzeitig ausgeführt werden und Aufgaben über lange Zeit erledigen sowie Arbeit untereinander verteilen können, reicht die herkömmliche Verwaltungsmethode, bei der Menschen jede Aktion einzeln prüfen, nicht mehr aus, um alle Verhaltensweisen zu erfassen.
Bis zum August 2026 arbeiten auf der am häufigsten genutzten internen Plattform von Anthropic etwa 30.000 Agenten gleichzeitig an Forschungs- und Ingenieurarbeiten. Um sie zu überwachen, hat Anthropic zwei Systeme bereitgestellt: ein Echtzeit-Überwachungssystem und ein Nachlauf-Überwachungssystem.
Das Echtzeit-Überwachungssystem prüft die relevanten Aktionen der Agenten, bevor diese ausgeführt werden, und blockiert vor allem Operationen, die schnell schwerwiegende Folgen haben könnten, beispielsweise das Kopieren von Modellgewichten in externe Systeme. Anthropic gibt an, dass alle Aktionen der Agenten auf dieser Plattform der Echtzeit-Überwachung unterliegen. Die Prüfung dauert in der Regel nur wenige Sekunden, und die blockierten Aktionen werden innerhalb einer Woche von Menschen nachgeprüft.
Im August dieses Jahres haben die Forschungs- und Ingenieuragenten von Anthropic insgesamt mehr als 1 Milliarde Entscheidungen getroffen, von denen etwa 0,002 % vom Echtzeit-Überwachungssystem blockiert wurden – das entspricht etwa einer Blockierung pro 47.000 Aktionen.
Das Nachlauf-Überwachungssystem liest die bereits abgeschlossenen Aktivitäten der Agenten aus, um Risiken zu erkennen, die sich langsam entwickeln und noch rückgängig gemacht werden können, beispielsweise Verhaltensweisen, die mit Abweichungen des Modells zusammenhängen könnten. Das System markiert wöchentlich etwa 100.000 Gesprächsaufzeichnungen, mehrere Klassifikatoren beseitigen Fehlalarme und führen eine erste Auswahl durch, und schließlich werden etwa 50 Aufzeichnungen mit höchster Priorität zur menschlichen Prüfung vorgelegt.
Gemäß den von Anthropic veröffentlichten Daten markiert das Nachlauf-Überwachungssystem ein bis zwei Aufzeichnungen pro 1000 Einträgen. Die Wahrscheinlichkeit für anomales Verhalten eines einzelnen Agenten ist nicht hoch, aber wenn die Anzahl der ausgeführten Agenten von Zehntausenden auf Millionen oder sogar Milliarden ansteigt, können auch Ereignisse mit geringer Wahrscheinlichkeit häufig auftreten.
Anthropic hat den internen Agenten zudem eine eindeutige Identität zugewiesen. Alle von einem Agenten erzeugten Daten, gesendeten Nachrichten und ausgeführten Aktionen sind an diese Identität gebunden. Selbst wenn das zugrunde liegende Modell aktualisiert wird, bleiben die historischen Aufzeichnungen des Agenten erhalten. Verschiedene Agenten kommunizieren über ein gemeinsames Nachrichtensystem. Andere Agenten können die von ihnen veröffentlichten Informationen prüfen, die ursprünglichen Quellen einsehen und Fehler korrigieren, falls sie diese entdecken.
Diese Konstruktion ermöglicht es Anthropic, jede einzelne Aktion anhand der Identität und der Kommunikationsaufzeichnungen nachzuverfolgen. Das Unternehmen räumt jedoch ein, dass das aktuelle Überwachungssystem erst seit wenigen Monaten in Betrieb ist und noch nicht bestätigt werden kann, ob es alle potenziellen Verhaltensmuster abdeckt.
Sicherheitsforschung erhält nur 6 % der Entwicklungsrechenleistung
Neben der Automatisierung der Entwicklung und der Überwachung von Agenten hat Anthropic zum ersten Mal die Verteilung der internen Rechenleistung offengelegt.
Das Unternehmen hat alle Aufzeichnungen zur Nutzung der Rechenleistung vom 13. Juli 2026 bis zum 20. Juli 2026 ausgewertet und die relevanten Arbeiten in KI-Entwicklung, Sicherheitsforschung und weitere Kategorien unterteilt. Die Ergebnisse zeigen, dass von der für die KI-Entwicklung zugewiesenen Rechenleistung etwa 6 % für Sicherheitsarbeiten verwendet werden; bei der KI-gesteuerten KI-Entwicklung beträgt dieser Anteil etwa 12 %.
Anthropic definiert Sicherheitsarbeiten als Forschung, deren Hauptziel die Verbesserung der Sicherheit, der Nachvollziehbarkeit und der Systemsicherheit von Modellen ist. Dazu gehören die Prüfung der Denkprozesse von Modellen, die Untersuchung von abweichendem Verhalten und die Bewertung, ob Modelle sicher bereitgestellt werden können. Arbeiten wie das Training von Produktionsmodellen, Produktentwicklung, Fähigkeitsforschung und Entwicklertools werden unter anderen KI-Entwicklungsarbeiten erfasst.
Wenn eine Arbeit sowohl die Fähigkeiten als auch die Sicherheit des Modells verbessert, ordnet Anthropic sie der Fähigkeitsentwicklung zu. Daher ist das Unternehmen der Ansicht, dass 6 % und 12 % relativ konservative Schätzungen sind. Die für Sicherheitsklassifikatoren verwendete Rechenleistung ist darin nicht enthalten – ihr Umfang soll den veröffentlichten Zahlen ungefähr entsprechen.
Während des Auswertungsprozesses hat der Claude-Klassifikator die Metadaten der Trainingsaufgaben und den zugehörigen Code gelesen und beurteilt, ob jede Aufgabe zur Sicherheitsforschung oder zu anderen Entwicklungsarbeiten gehört. Bei fast 10.000 Forschungs-, Trainings- und Bewertungsaufgaben hat Anthropic etwa 14 % stichprobenartig geprüft und gleichzeitig die Stichprobengewichte von Aufgaben mit hohem Rechenleistungsbedarf erhöht, damit die Daten dem tatsächlichen Fluss der Rechenleistung näherkommen.
Wer überwacht die KI, die KI herstellt?
Der Hintergrund für die Veröffentlichung dieser Daten durch Anthropic ist, dass das Entwicklungstempo der hochmodernen KI immer mehr Kontroversen auslöst. Der CEO des Unternehmens, Dario Amodei, hat zuvor öffentlich dazu aufgerufen, das Tempo der Weiterentwicklung der hochmodernen KI zu verlangsamen, und hofft, dass die Branche klarere Transparenzmechanismen und Sicherheitsanforderungen einführt.
Gemäß den Plänen von Anthropic wird das Unternehmen unabhängige Bewerter aus mehreren Einrichtungen Zugang zu seinen internen Systemen gewähren und ihnen Zugriff auf die Prozesse, Systeme und Daten gewähren, der dem des Risikobewertungsteams nahekommt. Diese Dritten werden die Sicherheitsmaßnahmen prüfen, relevante Vorfälle melden und kontinuierlich Indikatoren wie den Automatisierungsgrad der Entwicklung, die Überwachung von Agenten und die Verteilung der Rechenleistung verfolgen.
Anthropic räumt auch ein, dass die aktuellen Daten noch deutliche Einschränkungen aufweisen. Der Automatisierungsindex für die Entwicklung wird von Claude erfasst und beurteilt – das bedeutet, dass das Modell des Unternehmens die Arbeiten bewertet, an denen es selbst beteiligt ist. Verschiedene Labore verwenden derzeit keine einheitliche Methode, sodass diese Zahlen vorerst nicht direkt für einen horizontalen Vergleich verwendet werden können.
Bei internen Validierungen betrug die vollständige Übereinstimmungsrate zwischen Claude und menschlichen Bewertern bei der Beurteilung der Automatisierungsstufen 59 %. Die vollständige Übereinstimmungsrate zwischen zwei menschlichen Bewertern lag nur bei 35 %. Wenn eine Abweichung von einer Stufe erlaubt ist, erreicht die Übereinstimmungsrate zwischen den Beurteilungen von Claude und Menschen 97 %, aber zwischen „KI-Kooperation“ und „KI leitet“ gibt es noch einen großen Interpretationsspielraum