Eine „schweigende“ KI geht viral – ist Jev wirklich ein neues Paradigma?
Um den 15. September herum tauchte ein neues Modell namens Jev plötzlich in der KI-Entwicklercommunity im Silicon Valley auf und verbreitete sich viral.
Es stellt die bisherige Vorstellung von großen Modellen in Frage: Es kann weder Code schreiben, Texte verfassen noch chatten. Es verzichtet bewusst auf die wichtigste Fähigkeit großer Modelle der letzten Jahre – die Generierung von Texten – und behält nur die „Urteilsfähigkeit“ bei. TypeSafe definiert es wie folgt: „Decisions, not strings“ – Entscheidungen statt Texte.
Wenn man ihm eine Information und mehrere vordefinierte Fragen gibt, kann es direkt Auswahlmöglichkeiten, Bewertungen und entsprechende Wahrscheinlichkeiten zurückgeben. Beispielsweise kann Jev bei Erhalt einer Kundenservice-E-Mail gleichzeitig beurteilen, welche Abteilung sie zugewiesen werden soll, wie hoch der Dringlichkeitsgrad ist, welches Rückerstattungsrisiko besteht und ob ein menschlicher Eingriff erforderlich ist.
Dieses Modell, das eher wie ein „fortgeschrittener Klassifikator“ aussieht, erregte schnell große Aufmerksamkeit. Latent Space berichtete in den AI News vom 16. September, dass TypeSafe am Veröffentlichungstag lange Zeit auf den vorderen Plätzen von Hacker News stand, und der Veröffentlichungsbeitrag des Gründers Diogo Almeida hatte damals rund 4,2 Millionen Aufrufe und fast 20.000 Likes.
Die von TypeSafe veröffentlichten Leistungswerte sind ebenfalls beeindruckend: Bei bestimmten Workflow-Bewertungen ist Jev bis zu 193,6-fach schneller und 444,6-fach günstiger als das Vergleichs-Großmodell, mit einer End-to-End-Latenz von 70 bis 500 Millisekunden. Der Eingabepreis beträgt 0,042 US-Dollar pro Million Token, und die Ausgabe wird nicht nach Token berechnet.
Das Team hinter Jev hat ebenfalls eine hohe Sichtbarkeit. Es stammt aus dem kürzlich aus dem Stealth-Modus hervorgegangenen San-Francisco-Startup TypeSafe AI, das von Diogo Almeida, Erik Gafni und Sasha Sheng gemeinsam gegründet wurde. Es hat kürzlich eine Seed-Finanzierung in Höhe von 40 Millionen US-Dollar unter der Leitung von DCVC abgeschlossen, und laut Angaben von mit der Angelegenheit vertrauten Personen gegenüber Forbes beträgt die Bewertung rund 200 Millionen US-Dollar.
Almeida war früher Forscher bei OpenAI und einer der Hauptautoren des InstructGPT-Papiers von 2022. Er war am Aufbau des später weitverbreiteten RLHF-Trainingsablaufs beteiligt. OpenAI hat ihn in der Beitragsliste von GPT-4 unter dem Punkt „Foundational RLHF and InstructGPT work“ aufgeführt.
Nach seinem Weggang von OpenAI sagte Almeida, er habe zwei Jahre lang über eine Frage nachgedacht: Wenn große Modelle bereits so intelligent sind, warum sind die meisten Arbeiten auf der Welt noch nicht automatisiert?
Jev kann als seine erste Antwort darauf betrachtet werden.
Müssen Agenten bei jedem Schritt wirklich „sprechen“?
Heutige große Sprachmodelle sind im Wesentlichen immer noch extrem leistungsfähige Token-Generierungsmaschinen. Nehmen wir als Beispiel einen E-Commerce-Agenten: Nachdem er eine Webseite geöffnet hat, muss er beurteilen, welche Schaltfläche als Nächstes angeklickt werden soll. Die gängige Praxis besteht darin, den Zustand der Webseite an GPT, Claude oder Gemini zu übergeben. Nachdem das Modell die Seite verstanden hat, generiert es die Antwort autoregressiv Token für Token, beispielsweise: „Auf der Grundlage der aktuellen Seite sollte ich die Schaltfläche ‚Checkout‘ in der rechten unteren Ecke anklicken.“ Die Software extrahiert anschließend „Checkout“ aus diesem Text und ruft das Browser-Tool auf, um den Klick auszuführen.
Aus der Sicht eines Softwaresystems ist die wirklich benötigte Information aber möglicherweise nur „die dritte Schaltfläche“.
Ähnliche Fälle treten in großer Zahl innerhalb von Agenten auf: Soll dieses Arbeitsticket an den Vertrieb oder den After-Sales-Service übergeben werden, ist das Risiko dieser Transaktion hoch, welches der zehn Suchergebnisse ist am relevantesten. All diese Aufgaben erfordern, dass das Modell über semantisches Verständnis und Urteilsfähigkeit verfügt, aber es besteht kaum Notwendigkeit zur Generierung offener Texte.
Das Ziel von Jev ist genau dieser Arbeitsbereich. TypeSafe definiert es als „System One Model“, der Name stammt aus System 1 in Daniel Kahnemans Werk „Schnelles Denken, Langsames Denken“ – schnelle, intuitive Urteile.
Der Name Jev geht auf den Ökonomen William Stanley Jevons und das „Jevons-Paradoxon“ zurück: Wenn die Effizienz bei der Nutzung einer Ressource steigt und ihre Kosten sinken, kann die endgültige Nachfrage sogar steigen. TypeSafe hofft, dass sich das Gleiche auch bei der KI ereignet, sodass „intelligente Urteile“ nach ausreichender Kostensenkung in großem Umfang in Software eingebettet werden.
Die derzeit öffentlich zugänglichen grundlegenden Ausgaben von Jev umfassen hauptsächlich Choice, Score und Noul.
Choice ist für die Auswahl unter vordefinierten Optionen zuständig, Score gibt Klassen oder fortlaufende Bewertungen ab, Noul verarbeitet Ja/Nein-Urteile und gibt gleichzeitig die entsprechende Wahrscheinlichkeit aus. Beispielsweise kann ein Risikokontrollsystem Jev dazu bringen, zu beurteilen, ob das Rückerstattungsrisiko eines bestimmten Nutzers niedrig, mittel oder hoch ist, und das Modell gibt schließlich „Hohes Risiko 75 %“ zurück. Nachdem die Software dieses Ergebnis erhalten hat, kann sie über normalen Code direkt entscheiden, ob eine menschliche Prüfung eingeleitet werden soll.
Aus dieser Perspektive ist Jev wie ein „intelligentes If-Statement“ mit allgemeiner semantischer Verständnisfähigkeit. Das ist auch der wichtigste Unterschied zu herkömmlichen Klassifikatoren.
Herkömmliche Klassifikatoren können natürlich auch Spam-Mails, Betrugsrisiken oder Bildkategorien beurteilen, aber bei jeder neuen Aufgabe müssen oft die Daten neu definiert und das Modell neu trainiert oder feinabgestimmt werden. Jev möchte das allgemeine Wissen und die Zero-Shot-Generalisierungsfähigkeit bewahren, die große Modelle bereits erworben haben, und gleichzeitig die Ausgaben auf die Auswahlmöglichkeiten und Wahrscheinlichkeiten komprimieren, die die Software wirklich benötigt.
Diese Anforderung hat sich im Zeitalter der Agenten deutlich verstärkt. In einer komplexen Agentenaufgabe können Dutzende oder sogar Hunderte von Modellaufrufen stattfinden, von denen viele zu Routing, Klassifizierung, Überprüfung und Zustandsbeurteilung gehören. Wenn alle diese Schritte an ein vollständiges generatives Großmodell übergeben werden, muss das Modell nicht nur die Aufgabe verstehen, sondern auch Zeit darauf verwenden, einen Text zu generieren, der am Ende von niemandem gelesen wird. Dieser zusätzliche Aufwand erscheint wirklich unnötig.
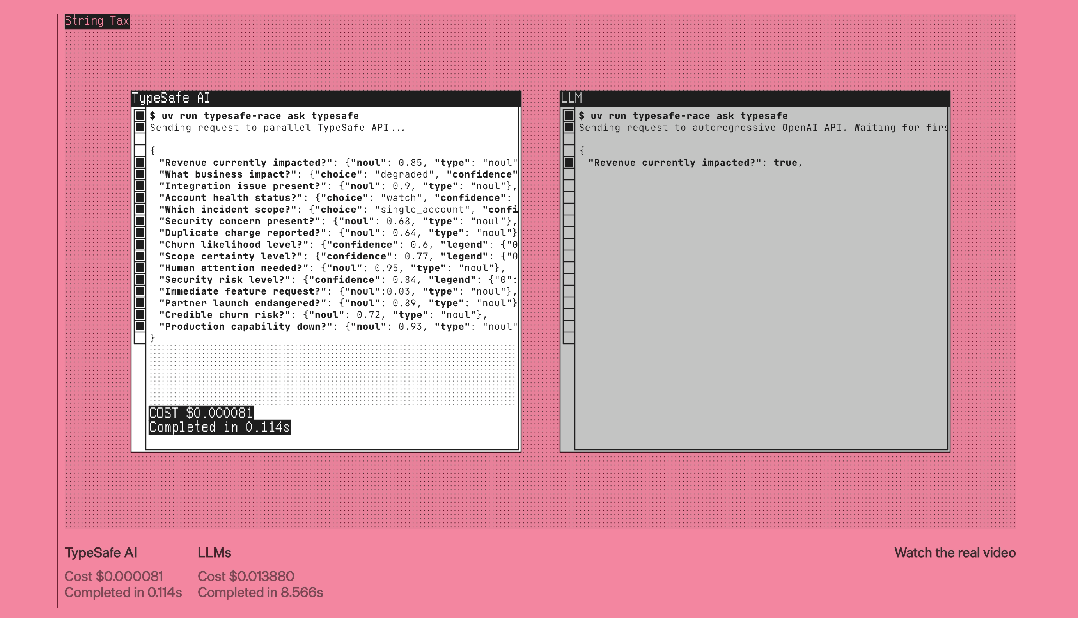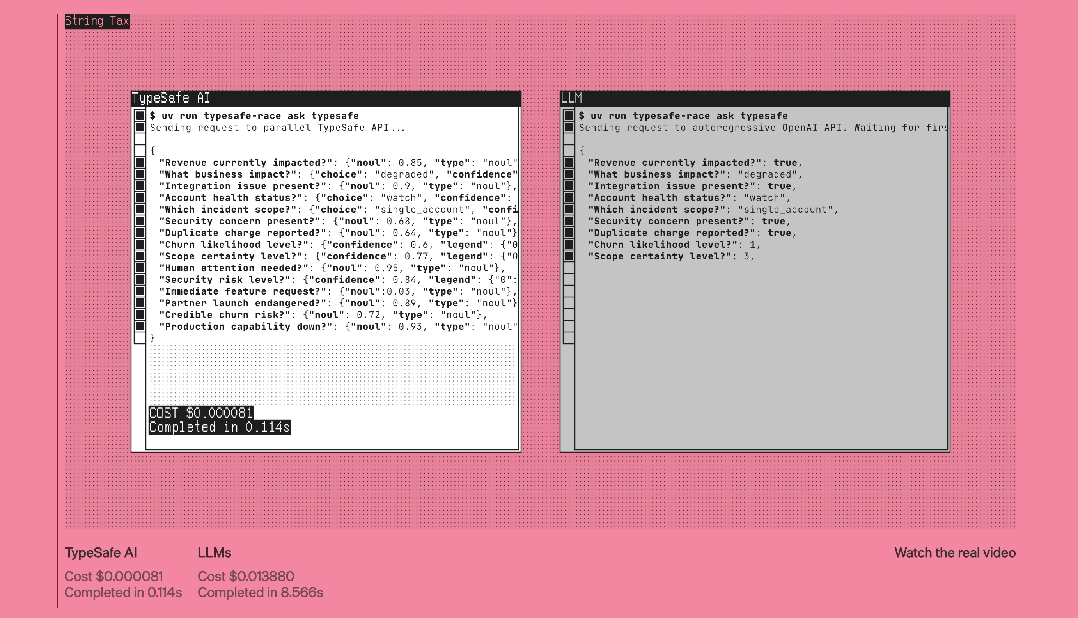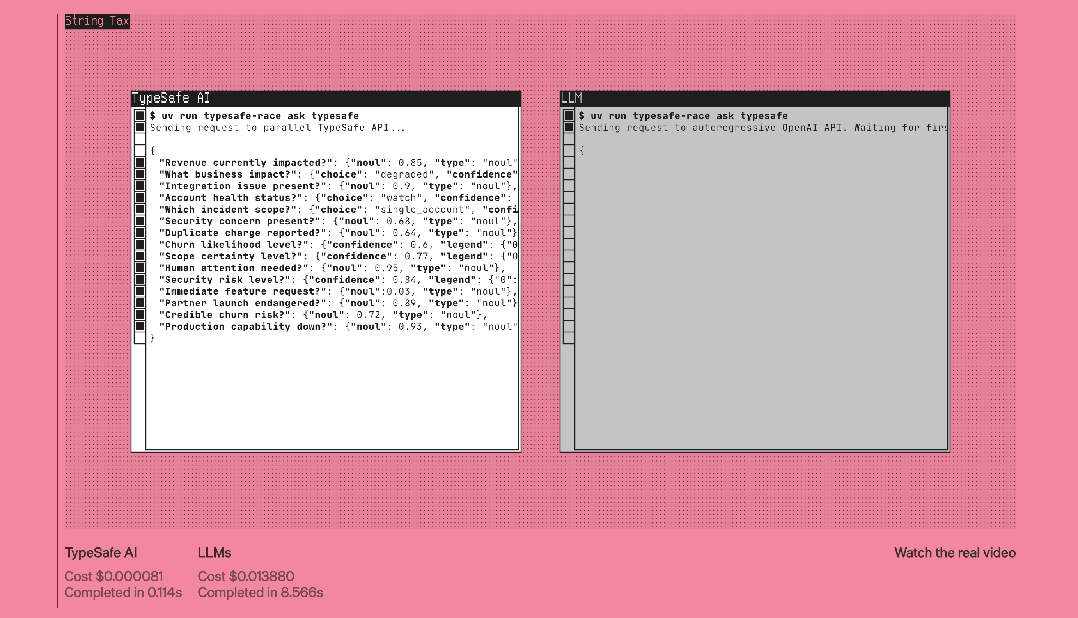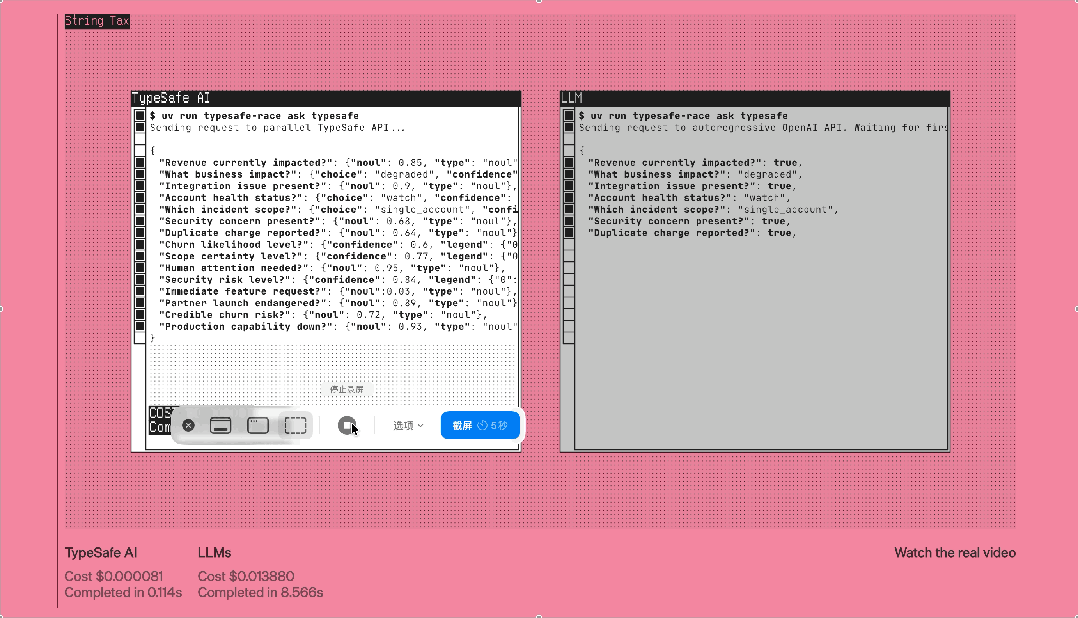
Abbildung: Die Demonstration von TypeSafe zeigt, dass Jev direkt mehrere strukturierte Urteile zurückgibt, während das herkömmliche LLM noch schrittweise Text generiert. Im offiziellen Beispiel dauert die erstere Variante 0,114 Sekunden, die letztere 8,566 Sekunden.
Ein neuer Klassifikator?
Das ist auch die entscheidende Frage zur Beurteilung des technischen Gehalts von Jev.
Große Sprachmodelle wie GPT, Claude und Gemini verwenden autoregressive Generierung. Das Modell verarbeitet zunächst die Eingabe und prognostiziert dann das nächste Token auf der Grundlage aller vorherigen Token, sodass ein Satz nacheinander decodiert werden muss. Dieser Mechanismus verleiht dem Modell eine große Freiheit bei der Ausgabe: Es kann Texte schreiben, Code generieren, Gründe erklären und komplexe Schlussfolgerungen ziehen. Aber der Preis dafür ist der sequenzielle Ablauf des Generierungsprozesses: Je länger die Ausgabe ist, desto mehr Decodierungsschritte sind normalerweise erforderlich.
Jev schränkt den Ausgaberaum bewusst ein. Entwickler legen die möglichen Antworten im Voraus fest, beispielsweise refund_risk={low, medium, high}, und das Modell muss nur die Wahrscheinlichkeiten der drei Ergebnisse beurteilen, ohne dass es natürliche Sprache wie „Ich denke, dass dieser Nutzer ein hohes Rückerstattungsrisiko aufweist“ generieren muss. TypeSafe gibt zudem an, dass Jev einen neuen parallelen Sampler verwendet, der mehrere unabhängige Fragen in einer einzigen Abfrage gleichzeitig beantworten kann. Beispielsweise kann bei der Verarbeitung einer Rechnung gleichzeitig die Rechnungsart, das Anomalierisiko, die Genehmigungsstufe und die Notwendigkeit einer menschlichen Überprüfung beurteilt werden.
Das ist der Schlüssel zum Verständnis der Leistungswerte von Jev.
Es gibt daher einen deutlichen Unterschied zur in letzter Zeit immer stärker beachteten Flash-Linie. Modelle wie Google Gemini Flash oder DeepSeek V4.1 Flash gehören nach wie vor zu den generativen LLMs, die den Berechnungsaufwand pro Token durch Architekturverbesserungen, aktivierte Parameter, KV-Cache und Inferenzsysteme senken und das Problem lösen, „wie man Token schneller generiert“.
Jev reduziert die Token direkt. Wenn ein Agent für die Erledigung einer Aufgabe 100 Modellaufrufe benötigt, von denen 10 komplexe Planung und Generierung natürlicher Sprache erfordern und die restlichen 90 nur die Auswahl von Tools, die Sortierung von Ergebnissen, Risikobeurteilungen und die Überprüfung des Aufgabenstatus betreffen, gibt es offensichtlich Optimierungspotenzial, wenn alle Aufrufe an dasselbe große generative Modell gerichtet werden.
Zukünftige realistischere Agentsysteme könnten eine mehrschichtige Modellstruktur verwenden: Komplexe Aufgaben werden an das Frontier Model übergeben, gewöhnliche Schlussfolgerungen an Flash, häufige Urteile wie Routing, Klassifizierung und Überprüfung an das Decision Model, und deterministische Teile werden weiterhin durch herkömmlichen Code verarbeitet, während Harness für die Planung zwischen diesen Fähigkeiten zuständig ist.
Das ist auch die bemerkenswerteste industrielle Bedeutung von Jev: Nicht überall, wo Intelligenz benötigt wird, muss auf ein generatives LLM zurückgegriffen werden.
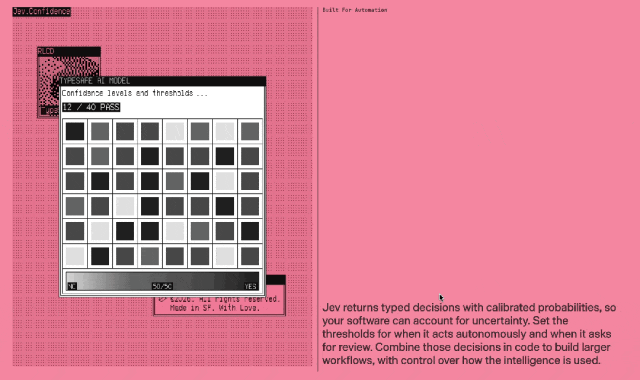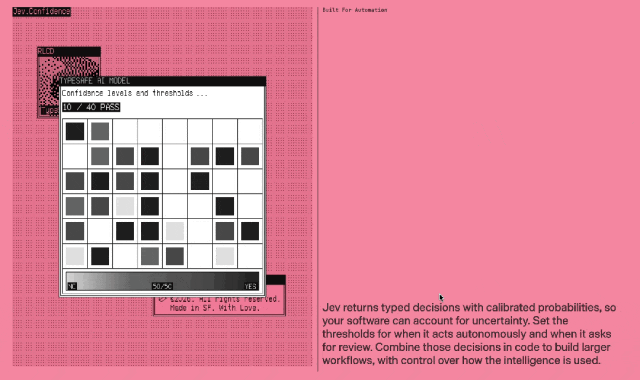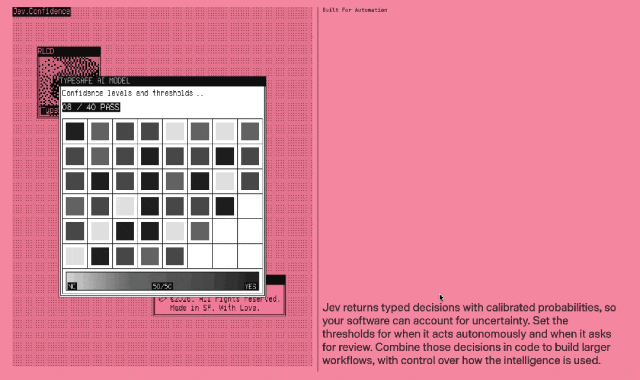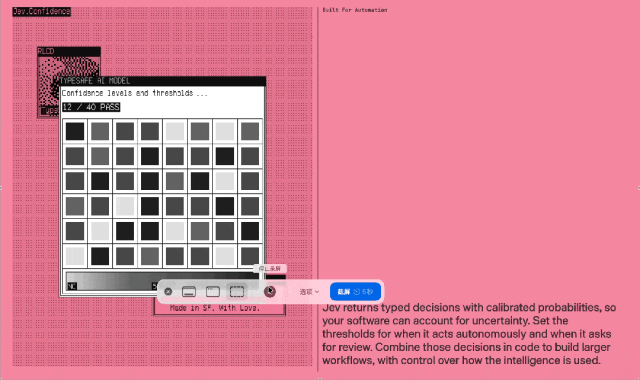
Abbildung: Nach Angaben von TypeSafe gibt Jev für jedes Urteil eine kalibrierte Wahrscheinlichkeit zurück, sodass die Software darauf basierend Schwellenwerte für die automatische Ausführung festlegen kann: Aufgaben mit hohem Konfidenzgrad werden direkt bearbeitet, Aufgaben mit niedrigem Konfidenzgrad an die menschliche Überprüfung weitergeleitet.
Keine Halluzinationen?
Eines der auffälligsten Werbeversprechen von TypeSafe auf der Jev-Website lautet „Zero Hallucinations“. Diese Aussage könnte leicht zu der Annahme verleiten, dass Jev das seit langem bestehende Halluzinationsproblem großer Modelle gelöst hat, aber es stellt nur sicher, dass die Ausgabe nicht die vordefinierten Typen überschreitet.
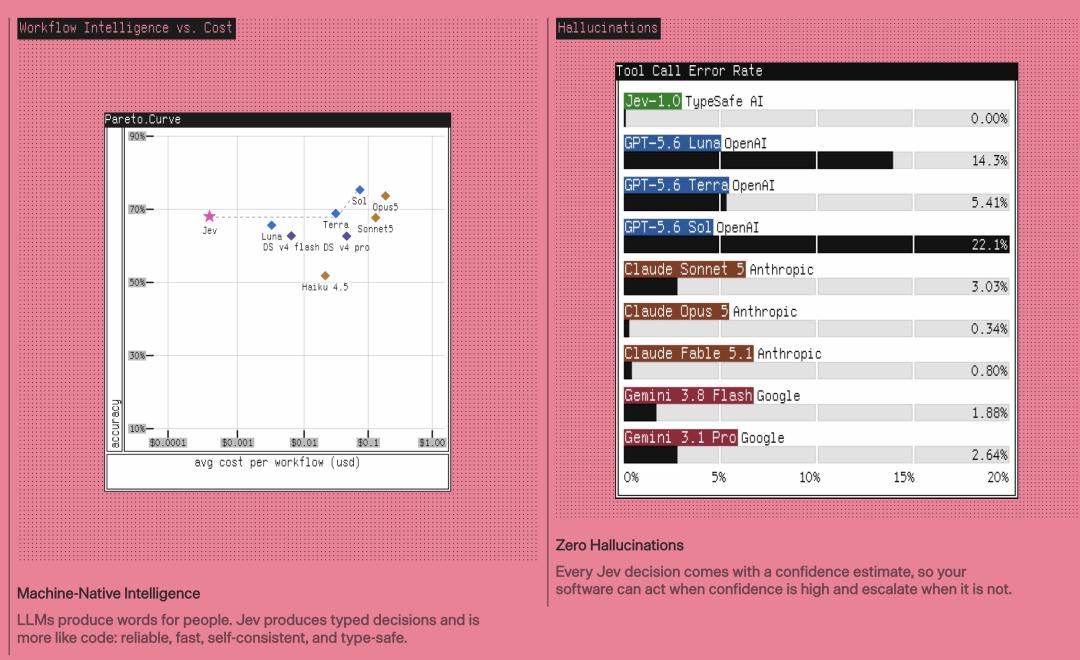
Abbildung: Die von TypeSafe veröffentlichte offizielle Bewertung zeigt, dass Jev bei seinen Workflow-Tests mit niedrigeren Kosten eine Genauigkeit erreicht, die nahe an der von Spitzenmodellen liegt; die rechte Abbildung zeigt, dass der Typfehler bei Tool-Aufrufen von Jev 0 % beträgt.
Beispielsweise wenn Entwickler festlegen, dass das Modell nur zwischen den drei Optionen „Katze, Hund, Vogel“ wählen darf, gibt Jev weder „Elefant“ zurück noch generiert es einen Text, der von der Software nicht analysiert werden kann.
Aus diesem Grund betont TypeSafe, dass sein Typfehler auf 0 % gesenkt werden kann. Das ist für Produktionssysteme wirklich wichtig, insbesondere wenn Agenten automatisch APIs aufrufen, Datenbanken ändern und Workflows ausführen: Je stabiler die strukturierte Ausgabe ist, desto leichter kann das System nachfolgende Operationen einbinden.
Aber ein korrekter Typ bedeutet nicht zwangsläufig ein korrektes Urteil. Wenn die Eingabe eindeutig eine Katze ist, das Modell aber „Hund: 97 %“ zurückgibt, liegt zwar kein Typfehler vor, aber das Geschäftsergebnis ist völlig falsch. Daher ist „Zero Hallucinations“ genauer gesagt eine Einschränkung des Ausgabeformats und -typs. Derzeit gibt es keine Belege dafür, dass Jev Fehler auf Fakten- und Urteilsebene beseitigt hat.
Der bemerkenswertere Teil von Jev ist eigentlich das von TypeSafe vorgeschlagene RLCD – Reinforcement Learning for Calibrated Decisions, also verstärkendes Lernen für kalibrierte Entscheidungen. Nach der Erklärung des Teams optimiert RLHF hauptsächlich menschliche Präferenzen, RLVR verbessert die Fähigkeiten bei Aufgaben wie Mathematik und Code durch überprüfbare Belohnungen, und RLCD konzentriert sich darauf, das Problem zu lösen: „Wie sicher ist sich das Modell seiner Sache, und ist diese Wahrscheinlichkeit verlässlich?“
Das ist besonders entscheidend für den Einsatz von Agenten in Produktionsumgebungen. Angenommen, die tatsächliche Urteilsgenauigkeit eines Modells beträgt nur 80 %, aber es gibt häufig einen Konfidenzgrad von 99 % an, dann kann dieser Wert kaum für automatisierte Entscheidungen verwendet werden. Im Idealfall sollten etwa 90 % der Aufgaben, bei denen das Modell einen Konfidenzgrad von 90 % angibt, korrekt beurteilt werden. Nur so können Unternehmen einen stabilen Verteilungsmechanismus aufbauen: Aufgaben mit hohem Konfidenzgrad werden direkt ausgeführt, Aufgaben mit mittlerem Konfidenzgrad zur Überprüfung an ein leistungsstärkeres Modell übergeben und Aufgaben mit niedrigem Konfidenzgrad an Menschen weitergeleitet.
Wenn RLCD schließlich unabhängig verifiziert werden kann, ist seine praktische Bedeutung sehr groß. Ein gut kalibriertes Decision Model kann selbst als Router im Agentsystem fungieren.
Allerdings hat TypeSafe bisher weder das vollständige Papier veröffentlicht noch Angaben zu Parameterumfang, Netzwerkstruktur, Trainingsdaten und ausreichenden Ablationsexperimenten gemacht. Die Außenwelt kann daher noch nicht beurteilen, ob RLCD ein deutlich anderes Trainingsparadigma darstellt oder nur eine ingenieurstechnische Kombination bestehender Methoden wie verstärkendes Lernen und Wahrscheinlichkeitskalibrierung ist. Ebenso fehlen derzeit ausreichende Details zu dem von TypeSafe behaupteten parallelen Sampler und dem System One Model, sodass es schwer ist zu bestätigen, dass Jev bereits grundlegende Architekturdurchbrüche auf dem Niveau von Transformer, Attention oder MoE erzielt hat.