Es wurde enthüllt, dass OpenAI Hunderte von Beweisen zurückhält. Die Antwort auf das Problem, an dem du drei Jahre lang verbissen gearbeitet hast, befindet sich möglicherweise schon längst auf dem Server.
„Wenn ich Mathematiker werden will, scheint es, dass mir nur noch etwa zwei Wochen bleiben.“
Derjenige, der diesen Witz machte, ist ein 13-jähriges Mädchen.
Ihr Vater Scott Aaronson ist Professor für Theoretische Informatik an der University of Texas at Austin und war früher als Gastforscher im Ausrichtungsteam von OpenAI tätig.
Am 15. September schrieb Aaronson diesen Satz seiner Tochter in einen langen Blogbeitrag.
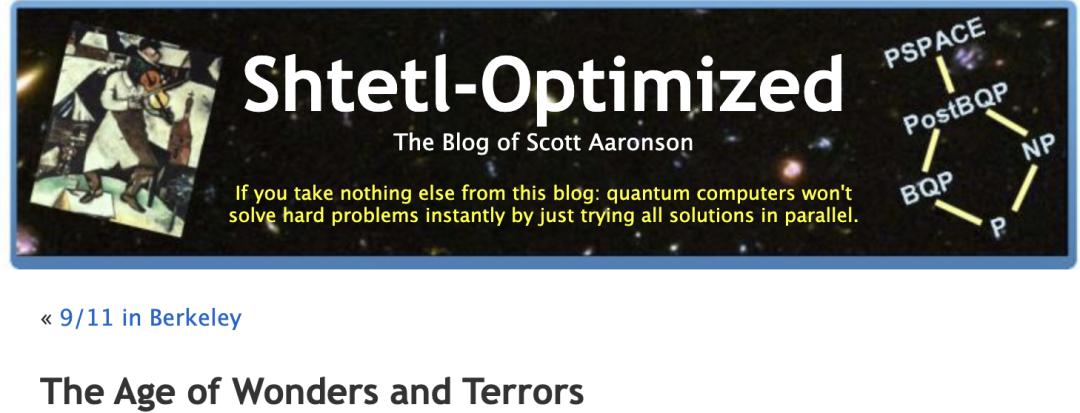
In demselben Blogbeitrag listete er zudem eine Liste langjähriger offener Probleme auf, die im vergangenen Monat von KI bewiesen oder bei deren Beweis die KI mitgewirkt hat:
Gegenbeispiele zur Jacobi-Vermutung, der durch Lean verifizierte Fermatsche Satz, seit Jahren schwebende Probleme in der Theorie der Quantenkomplexität – alles ist darin enthalten.
Was den mathematischen Kreis wirklich in Aufregung versetzte, war ein Gerücht am Ende der Liste.
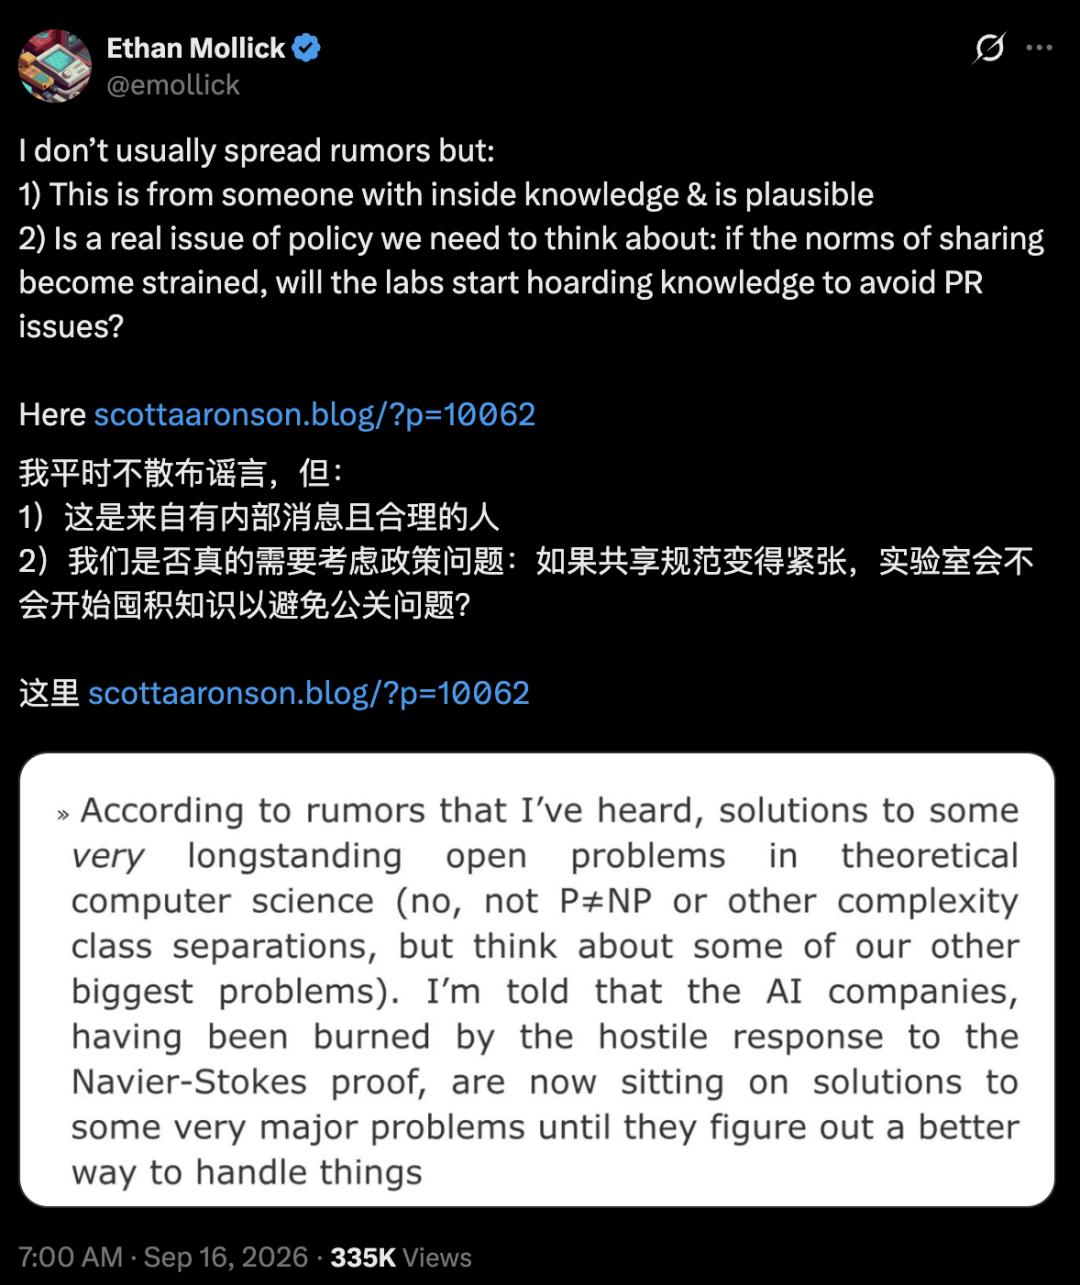
Nach seinen Angaben erlebten KI-Unternehmen nach einer feindseligen öffentlichen Reaktion auf den Beweis der Navier-Stokes-Gleichung nun die Lösung einiger „sehr wichtiger Probleme“ in ihren Händen, um zu warten, bis sie einen besseren Umgang damit gefunden haben.
Als der außerordentliche Professor der Wharton School Ethan Mollick den Beitrag weiterleitete, erklärte er ausdrücklich, dass er normalerweise keine Gerüchte verbreite, aber er beurteilt, dass diese Nachricht von einer Person mit internen Informationen stammt und nicht wenig glaubwürdig ist.
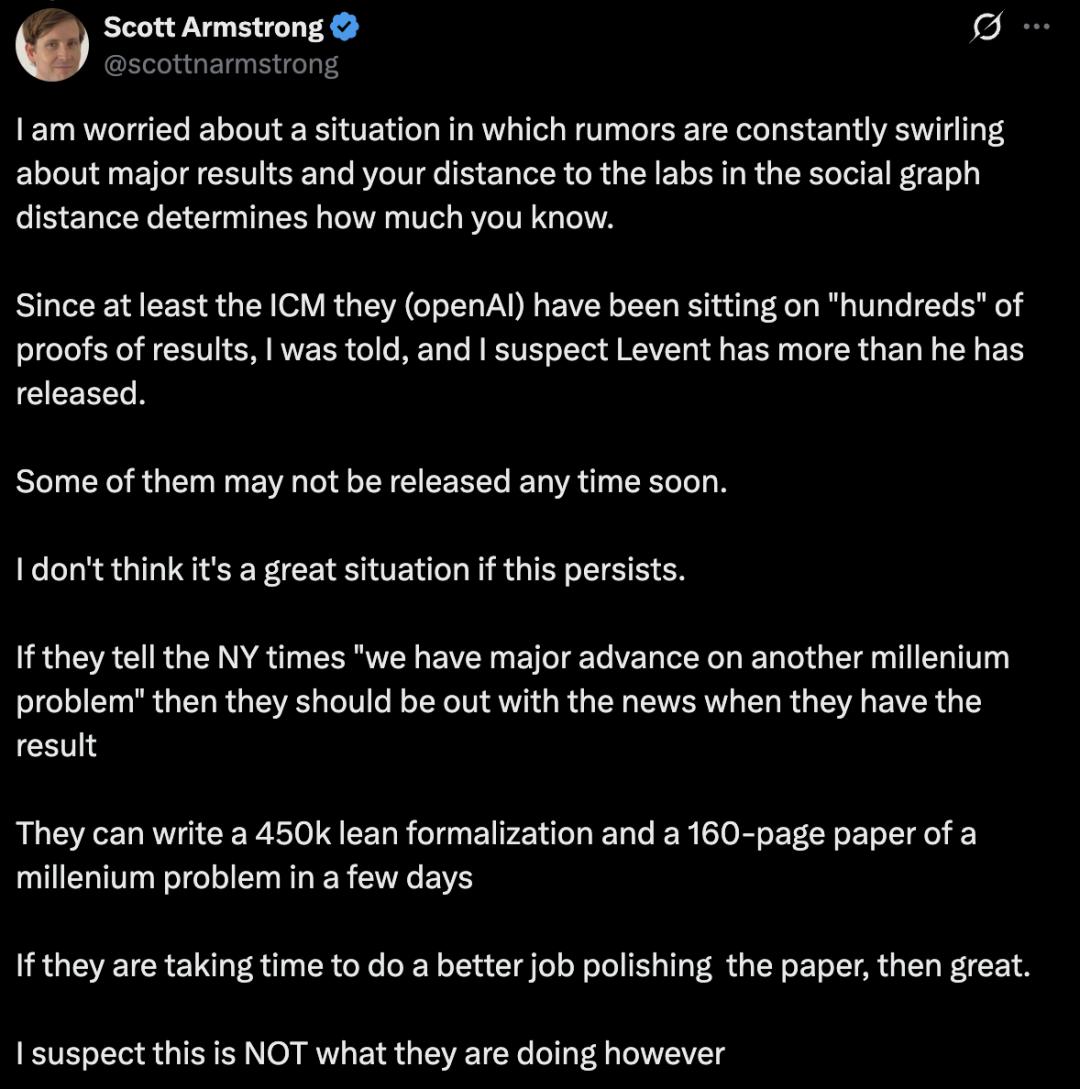
Anschließend veröffentlichte der Mathematikprofessor der New York University Scott Armstrong eine noch erstaunlichere Zahl:
Ihm wurde mitgeteilt, dass OpenAI seit mindestens dem Internationalen Mathematikerkongress (ICM) im Juli „Hunderte“ mathematischer Beweise zurückhält und nicht veröffentlicht.
Ein seit Jahrzehnten schwebendes schwieriges Problem ist gelöst – soll man die Welt sofort davon erzählen?
In den letzten Jahrhunderten war dies in der Mathematik fast kein Problem.
Die Menschen fürchteten nur, dass das Problem zu schwer ist, um es zu lösen.
Jetzt breitet sich eine neue Unruhe in der Mathematik aus: Die Antwort wurde vielleicht schon lange von Maschinen berechnet, aber sie ist im Labor eingeschlossen und geheim gehalten.
KI löst Probleme im Fließbandmodus
„Hunderte“ unveröffentlichte Beweise klingen wie ein Märchen, aber in den heutigen Spitzen-KI-Laboren ist dies völlig logisch.
Vor 20 Jahren scherzten selbst die konservativsten Gelehrten: Weckt mich auf, wenn die KI die Millennium-Preis-Probleme gelöst hat.
Heutzutage braucht die KI nur Dutzende von Stunden, um ein außergewöhnlich schwieriges Problem zu lösen, und die Menschen haben sich sogar schon daran gewöhnt.
Diesmal ist es nicht die Lösung eines weiteren Problems, das die Mathematik in Aufregung versetzt, sondern die Ungewissheit, welche Probleme die KI heimlich gelöst hat.
Am 1. August veröffentlichte OpenAI in einem Zug zehn Ergebnisse in Mathematik und Theoretischer Informatik und behauptete, dass jedes davon langjährige offene Probleme gelöst oder wesentlich vorangebracht hat.
Am 1. September erhielt OpenAI die Nachricht: Zwei der Millennium-Probleme wurden bereits gelöst.
Das Vorgehen von OpenAI war einfach und grob:
Da man nicht wusste, welche zwei es sind, fütterte man kurzerhand alle ungelösten Millennium-Probleme zusammen mit einer Reihe von hochwirksamen Problemen in ein internes Modell, das leistungsfähiger als GPT-6 Astra ist.
Eine Gruppe von fast 100 Agenten löste das Problem der Euler-Gleichungen ohne äußere Kräfte in nur etwa 50 Stunden.
Anschließend wurden die Ressourcen konzentriert auf die Navier-Stokes-Gleichung verlagert.
In der Gruppe, die dieses Problem löste, arbeiteten etwa 10.000 Agenten gleichzeitig. Etwa 88 Stunden nach dem Start der ersten Agenten war die Lösung fertig, und die anschließende formale Verifikation mit Lean dauerte weitere 17 Stunden.
Allein für dieses Problem wurden etwa 130 Milliarden Ausgabe-Token verbraucht.
Aaronson schätzt, dass dieser 166-seitige Beweis mindestens etwa 15 Millionen US-Dollar an Rechenleistung verbraucht hat, und bisher hat wahrscheinlich kein einziger Mensch ihn wirklich verstanden.
Die Navier-Stokes-Gleichung ist nur die Spitze des Eisbergs.
Armstrong enthüllte, dass Labore heute innerhalb weniger Tage eine 160-seitige Arbeit zusammen mit einer formalen Lean-Verifikation im Umfang von Hunderttausenden Zeilen erstellen können.
Wenn man von einem kleinen Hinweis erfährt, kann man sofort zehntausend Agenten aktivieren, die 88 Stunden lang laufen. Diese überlegene Gewalt der Rechenleistung ist für keine der Spitzenuniversitäten der Vergangenheit vorstellbar gewesen.
Beweiserstellung dauert Tage, Verständnis dauert Jahre
Der Rhythmus der menschlichen Forschung und der der KI befinden sich in völlig parallelen Welten.
Gemäß den Regeln des Clay Mathematics Institute erfordert die Anerkennung eines Millennium-Problems die offizielle Veröffentlichung, eine Wartezeit von zwei Jahren und die strenge Prüfung durch externe Experten.
Bis heute listet Clay die Navier-Stokes-Gleichung immer noch als ungelöstes Problem auf und erklärt, dass das gesamte Ereignis detailliert geprüft wird.
Maschinen liefern Ergebnisse in Tagen, Menschen brauchen Jahre, um die Ergebnisse zu verstehen.
Peer-Review, akademische Berichte, Einarbeitung in Lehrbücher – dieser seit Jahrhunderten laufende Prozess kann den Ausgaberythmus der KI nicht bewältigen.
Die Anzahl der unverarbeiteten Ergebnisse wächst stetig, und das Vorhandensein einer Reihe unveröffentlichter Beweise im Labor ist fast unvermeidlich unter dem Ausbruch der Rechenleistung.
Es erschüttert vier alte Regeln, auf denen die akademische Welt basiert: Wer zuerst veröffentlicht, erhält die Anerkennung; wer das Ergebnis erzielt, wird als Autor genannt; die Ergebnisse müssen den Kollegen bekannt sein; nur die von Kollegen geprüften Ergebnisse gelten als gültig.
Die alten Regeln der Mathematik verlieren nacheinander ihre Gültigkeit
Das erste, was erschüttert wird, ist die Offenlegung von Ergebnissen.
Die von Aaronson erwähnten „KI-Unternehmen“ sind nicht nur eines, während Armstrong direkt OpenAI nannte und die erstaunliche Zahl von „Hunderte“ nannte.
Als Forscher an der Sorbonne-Universität und dem französischen Nationalen Zentrum für Wissenschaftliche Forschung (CNRS) fürchtet sich Armstrong nicht nur davor, wie viele Beweise von KI-Laboren gelöst und zurückgehalten werden, sondern auch davor, dass Wissen von „für jedermann zugänglich“ zu „zuerst von Insider bekannt“ wird.
Er schreibt, dass Gerüchte über große Ergebnisse überall verbreitet sind, und die soziale Distanz einer Person zum Labor bestimmt, wie viel sie wissen kann.
Man muss wissen, dass die Mathematik in den letzten dreihundert Jahren ihre rasante Entwicklung genau durch offenen Austausch erreicht hat.
Heutzutage werden mathematische Durchbrüche in KI-Laboren hinter verschlossenen Türen gehalten, was nichts anderes als ein Rückschritt ist.
Zweitens versagt die Regel der „Priorität“.
Früher erhielt derjenige den Ruhm, der das Problem zuerst löste und veröffentlichte. Aber das Navier-Stokes-Ereignis hat dieses eiserne Gesetz gebrochen.
Die Mathematiker der New York University Tristan Buckmaster und Levent Alpöge von Anthropic haben zuvor bereits Fortschritte in dieser Richtung erzielt.
OpenAI hat genau wegen dieser Nachricht innerhalb einer Woche mit riesigen Ressourcen den Beweis erbracht und die beiden erst danach kontaktiert, um eine gleichzeitige Veröffentlichung vorzuschlagen.
Terence Tao warnte auf Mastodon: Heutzutage kann die Nachricht, dass „jemand an einem bestimmten Problem arbeitet“, zu einer großangelegten Überlegenheitsattacke durch KI-Rechenleistung führen, die das menschliche Projekt vor seiner Reifung zunichte macht.
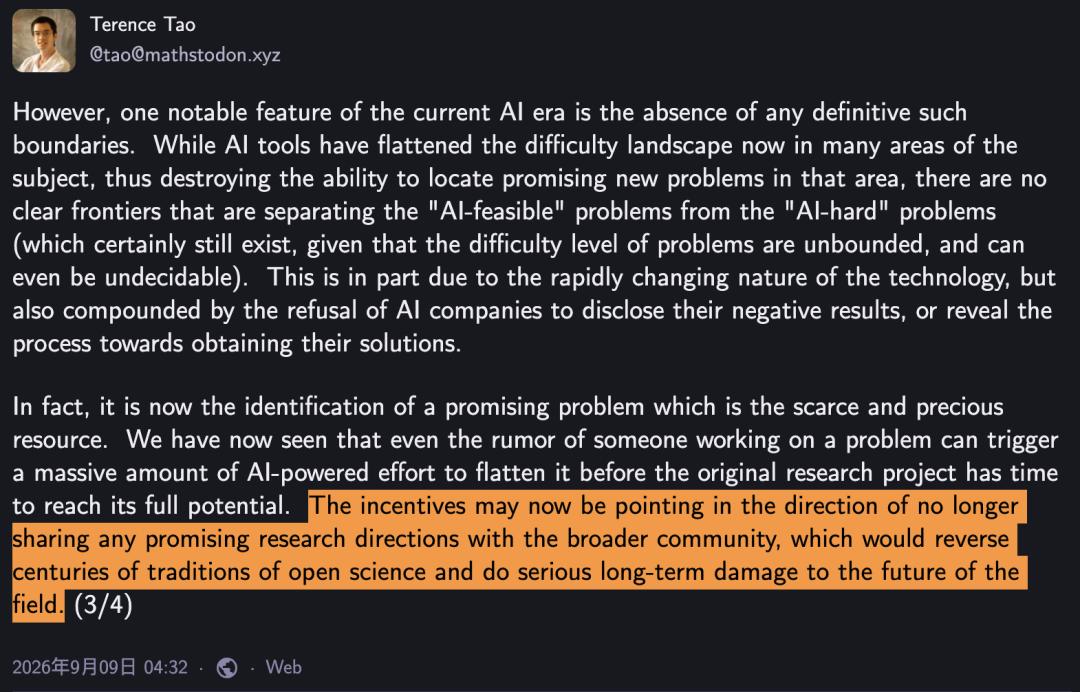
Dies führt dazu, dass Forscher keine vielversprechenden Ideen mehr mit Kollegen teilen und die jahrhundertelange Tradition der offenen Wissenschaft umkehren.
Die dritte zerrissene Regel ist „Verstehen vor der Veröffentlichung“.
Lean kann sicherstellen, dass die Beweislogik fehlerfrei ist, aber nicht sicherstellen, dass Menschen sie verstehen können.
Aaronson beschreibt, dass heutige Zeitschriftenredakteure wie die Verteidiger von Minas Tirith in *Der Herr der Ringe* sind, die vor dem Ansturm von 50.000 Orks stehen. Wenn sie nicht einen Teil der Begutachtungsarbeit an KI übergeben, können Menschen dies nicht bewältigen.
Am 11. September veröffentlichten Terence Tao und 25 weitere Fields-Medaillen-Träger einen offenen Brief, in dem sie KI-Unternehmen kritisierten, dass sie mathematische Probleme als Werkzeug für Leistungsbenchmarks nutzen.
Der Brief weist scharf darauf hin: Das eigentliche Ziel der Mathematik ist das Verstehen, das Lösen von Problemen ist nur ein Mittel.
Das ist ein toter Knoten: Wenn man es schnell veröffentlicht, versteht es niemand; wenn man es langsam veröffentlicht, wird man beschuldigt, es zurückzuhalten. Die Kosten für die Offenlegung einer Antwort sind zum ersten Mal höher als die Kosten für die Suche nach der Antwort.
Das Letzte, was erschüttert wird, ist die „Autorschaft“.
Kann man als Autor genannt werden, wenn man am gesamten Prozess der Beweissuche nicht teilgenommen hat? Was bedeutet es, GPT-6 Astra in die Autorenliste aufzunehmen?
Aaronson sagt, dass Mathematiker jetzt, egal worüber sie anfangen zu reden, am Ende immer auf KI zu sprechen kommen.
Aber niemand hat derzeit eine Antwort darauf, wie man damit umgehen soll.
Wer die Antwort hält, bestimmt den Zeitpunkt der Offenlegung
Ein Doktorand kämpft seit drei Jahren mit einem schwierigen Problem.
Aber die Antwort auf dieses Problem liegt möglicherweise schon lange auf dem Server eines KI-Labors.
Nicht nur er und sein Betreuer wissen es nicht, auch die Gutachter wissen es nicht.
Du kämpfst jahrelang damit, während die KI es längst gelöst hat. Stell dir vor, wie grausam diese Szene ist!
Früher konkurrierte die akademische Welt darum, wer zuerst beweist; in Zukunft wird möglicherweise eine weitere Bedingung hinzugefügt: Wer zuerst weiß, welche Probleme bereits bewiesen wurden.
Wenn die Geschwindigkeit, mit der Maschinen Antworten finden, die Geschwindigkeit übertrifft, mit der die akademische Welt die Antworten versteht, tauchen eine Reihe von Fragen auf: Wann soll man sie offenlegen, in welcher Form soll man sie offenlegen, wer soll als Autor genannt werden – wer hat das Sagen?
Aaronson schrieb in seinem Blog ein Urteil:
Die Singularität hat bereits begonnen, aber sie ist extrem ungleich verteilt.
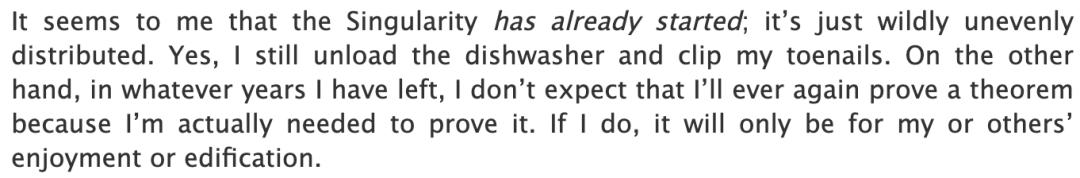
Aaronson sagt, er wird trotzdem den Geschirrspüler ausräumen und seine Zehennägel schneiden. Aber für den Rest seines Lebens wird er wahrscheinlich keinen Satz mehr beweisen, weil er „wirklich gebraucht wird“. Selbst wenn er es tut, nur zum Spaß.
Aaronson spricht von der ungleich verteilten Singularität. Wenn man weiter nachdenkt, ist nicht nur die Fähigkeit, Probleme zu lösen, ungleich verteilt, sondern auch das Recht auf Information und das Gefühl des Werts der Mathematik.
Seit Tausenden von Jahren ist die zentrale Angst von Mathematikern: Wer kann dieses Problem lösen?
In Zukunft gibt es möglicherweise zwei weitere Arten von Angst.
Die eine ist: Wird das Problem, an dem ich gerade arbeite, schon lange von Maschinen gelöst?
Die andere ist: Wird meine aktuelle Idee, sobald ich sie ausspreche, von der Rechenleistung zuerst umgesetzt, und meine jahrelange Arbeit ist umsonst?
Mathematik war schon immer das großzügigste Fach der Menschheit.
Sobald ein Beweis geschrieben ist, kann die ganze Welt ihn lesen und darauf aufbauen.
Aber wenn die Antwort zuerst auf den Servern von KI-Laboren landet, wie lange kann diese Großzügigkeit dann noch aufrechterhalten werden?
Referenzen:
https://scottaaronson.blog/?p=10062
https://x.com/emollick/status/2099996799750623665