Sensationelle Entdeckung: GPT-6 Astra erzielt einen Durchbruch bei der verkörperten Intelligenz – wie kann China die Verteidigungsschlacht im Bereich der verkörperten Intelligenz führen?
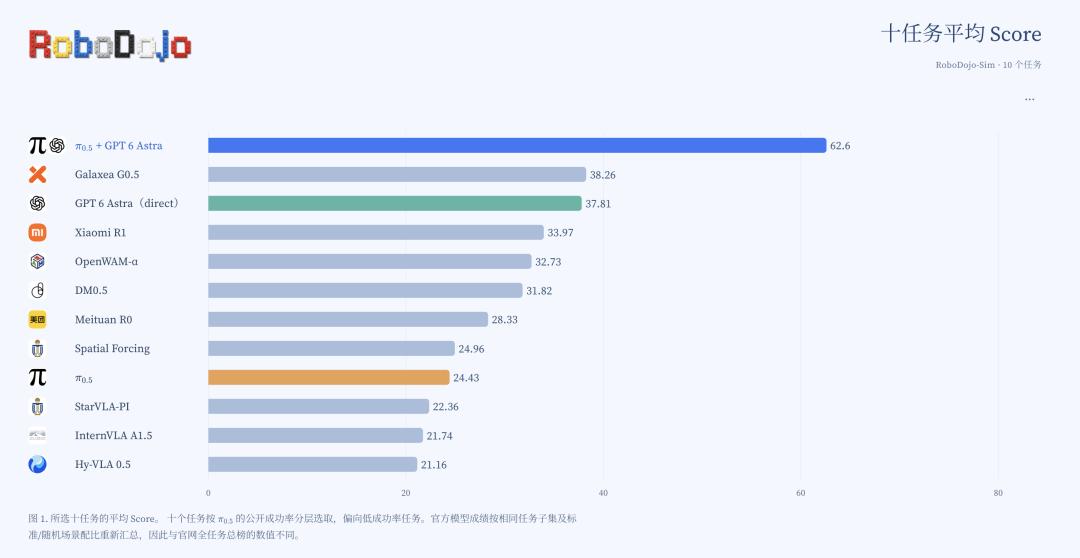
Kürzlich wurde ein anonymer Simulations-Bewertungsbericht auf GitHub veröffentlicht, der in der Community für Embodied Intelligence eine Bombe einschlug. Die gemischte Architektur mit GPT-6 Astra erreichte 62,6 Punkte, während der Zweitplatzierte nur 38,26 Punkte erzielte.
Eine Leistungsdifferenz von 64 % – diese Lücke zeigt, dass es sich nicht mehr um eine einfache Feinabstimmungsoptimierung handelt, sondern um einen dimensionalen Überlegenheitsschlag auf Architekturebene.
In der Studie wurde GPT-6 Astra nicht direkt zur Steuerung von Roboterarmen verwendet. Stattdessen wurde ein intelligenterer Ansatz gewählt: GPT-6 Astra liefert Urteile und Korrekturen auf semantischer Ebene, die eine komplementäre Architektur mit der physikalischen Rauminteraktion und Aktionspriorität von π₀.₅ bilden.
Wie wurde diese Bewertung durchgeführt?
Die Autoren des Berichts sind Forscher des Teams von Galaxy General, der Erstautor ist Doktorand von Professor WANG He, Gründer und CTO von Galaxy General. Die gesamte Bewertung ist ein streng ausgerichtetes Vergleichsexperiment mit geschlossener Regelung.
Die Studie analysierte zwei Arten von geschlossenen Regelungsarchitekturen für simulierte zweiarme Operationen:
Direct-Modus: π0.5 wird nicht ausgeführt, GPT-6 Astra liest direkt die Bilddaten von drei Kameras und den Roboterzustand, gibt die Pose der Enden der beiden Arme sowie das Öffnen und Schließen der Greifer aus und führt jeweils 1 bis 5 Steuerschritte aus.
Gemischter Modus: Zu jedem Entscheidungszeitpunkt generiert π0.5 zuerst 50 Schritte von Kandidatenaktionen. GPT-6 Astra liest dasselbe Bild, den Ausführungsverlauf sowie die den Kandidatenaktionen entsprechenden Trajektorien der beiden Arme und wählt dann eine von zwei Optionen: entweder die ersten 1 bis 15 Schritte von π0.5 zu übernehmen, oder selbst 1 bis 5 Schritte der Endposenkorrektur zu generieren. Nach Abschluss dieses Abschnitts wird das neue Bild eingelesen und die Entscheidung neu getroffen.
Diese Architektur ist eigentlich sehr einfach. Der Erstautor erwähnt im Bericht auch, dass dieser TopK-Ansatz der „Auswahl von Kandidatenaktionen“ bereits mehrfach in Branchengesprächen diskutiert wurde. Dies ist jedoch das erste Mal, dass er tatsächlich zu einem so großen Leistungsunterschied führt.
Die Ergebnisse zeigen, dass der gemischte Modus eine Erfolgsrate von 48 % und einen durchschnittlichen Wert von 62,60 Punkten erzielte, wobei der durchschnittliche Wert sogar um 64 % deutlich über dem des Zweitplatzierten liegt.
01 RoboDojo: Deutliche Erhöhung der Erfolgsrate nach Integration von GPT-6 Astra
Zuerst das RoboDojo-Experiment.
Das Team wählte 10 Arten komplexer Roboterbedienaufgaben aus, darunter das Ordnen von Tischen, das Klassifizieren von Objekten nach Sprache, das Sortieren von Zahlen, das Einpacken in Kisten, das Bauen von Türmen, das Ziehen von passenden Mahjong-Steinen, das Falten von Kleidung und das Einlegen von Flaschen in Eimer. Jede Aufgabe wurde 5 Mal getestet, insgesamt 50 Tests.
Für das Experiment wurden zwei Schemata festgelegt.
Das eine ist GPT-6 Astra Direct, bei dem Astra direkt Roboteraktionen basierend auf visuellen Daten, Eigenzustand und Aufgabenziele generiert; das andere ist π0.5+Astra, bei dem das Roboter-VLA-Modell π0.5 die Aktionen liefert, Astra die Umgebung und die Kandidatenaktionen beobachtet und bei Bedarf Korrekturen vornimmt.
Der Unterschied in den Ergebnissen ist offensichtlich.
Bei Astra Direct wurden 13 von 50 Aufgaben erfolgreich abgeschlossen, die Erfolgsrate betrug 26 %, und der durchschnittliche Wert von 48 Aufgaben mit vollständigen ursprünglichen Bewertungen lag bei 37,81.
Nach der Integration von π0.5 stieg die Anzahl der erfolgreichen Aufgaben auf 24, die Erfolgsrate erreichte 48 % und der durchschnittliche Wert stieg auf 62,60. Bemerkenswerterweise modifizierte Astra nur 14,4 % aller ausgeführten Steuerschritte.
Das bedeutet, dass die meisten Aktionen immer noch von π0.5 ausgeführt werden, Astra ist hauptsächlich an wichtigen Knotenpunkten für das Verständnis der Aufgabe, die Beurteilung des aktuellen Zustands und die Entscheidung, ob eine Korrektur erforderlich ist, verantwortlich.
Diese Experimentengruppe zeigt zunächst, dass die beiden Modellarten eine deutliche Komplementarität aufweisen.
Astra ist am besten in semantischem Verständnis, visueller Erkennung, Beurteilung räumlicher Beziehungen und Aufgabenplanung. Bei Aufgaben wie der „Objektklassifizierung“ erzielte Astra Direct sogar 100 Punkte; bei fehlgeschlagenem Greifen, vergessenen Objekten oder veränderten Umgebungen kann es den Ort erneut beobachten und dann die nächste Aktion bestimmen.
Bei Aufgaben wie dem Bauen von Türmen oder dem Ziehen von Mahjong-Steinen, die feine Berührungen, stabiles Greifen und kontinuierliche Steuerung erfordern, treten die Schwachstellen des großen Modells schnell zutage.
Bei der Aufgabe zum Bauen von Türmen erreichte Astra Direct durchschnittlich nur 12 Punkte, bei der Aufgabe zum Ziehen von Mahjong-Steinen 0 Punkte. Das Modell kann wissen, wo der Holzblock platziert werden soll, ist aber möglicherweise nicht in der Lage, den Fallpunkt, die Reibung und die Kollision stabil zu steuern.
Nach der Integration von π0.5 stieg die Punktzahl für das Bauen von Türmen von 12 auf 64, die für das Ziehen von Mahjong-Steinen von 0 auf 40, und Aufgaben wie das Falten von Kleidung und das Einlegen von Flaschen in Eimer wurden ebenfalls deutlich verbessert.
Dies ist die wichtigste Information des Berichts: Große Modelle sind bereits in der Lage, in die Strategieebene von Robotern einzudringen, aber das Verständnis der physischen Welt und die Bedienung der physischen Welt sind immer noch zwei unterschiedliche Fähigkeiten.
02 RoboLab: Weitere Überprüfung der Fähigkeiten bei Aufgaben mit semantischem Verständnis
Das RoboLab-Experiment demonstriert weiter die Vorteile von Astra bei einer anderen Art von Aufgaben und untersucht das Verständnis allgemeiner Roboterstrategien für visuelle Daten, Objektbeziehungen, Aufgabenanweisungen und räumliche Strukturen. Das Team wählte 10 Arten von Aufgaben aus, jede wurde 5 Mal bewertet, insgesamt 50 Tests, darunter das Einlegen von Blöcken in Behälter, das Suchen und Bewegen von Kürbissen zwischen Unordnung, das Stapeln von Blöcken in einer festgelegten Reihenfolge, das Anpassen der Ausrichtung von Bechern und das Einlegen verschiedener Objekte an festgelegte Positionen.
Die Ergebnisse sind sehr herausragend.
GPT-6 Astra Direct absolvierte 49 von 50 Experimenten erfolgreich, die Erfolgsrate betrug 98 %; Astra+π0.5 absolvierte 46 erfolgreich, die Erfolgsrate betrug 92 %. Als Referenz absolvierte π0.5 in derselben Statistik 18 Aufgaben, Cosmos3-Nano-Policy 18 und DreamZero 17.
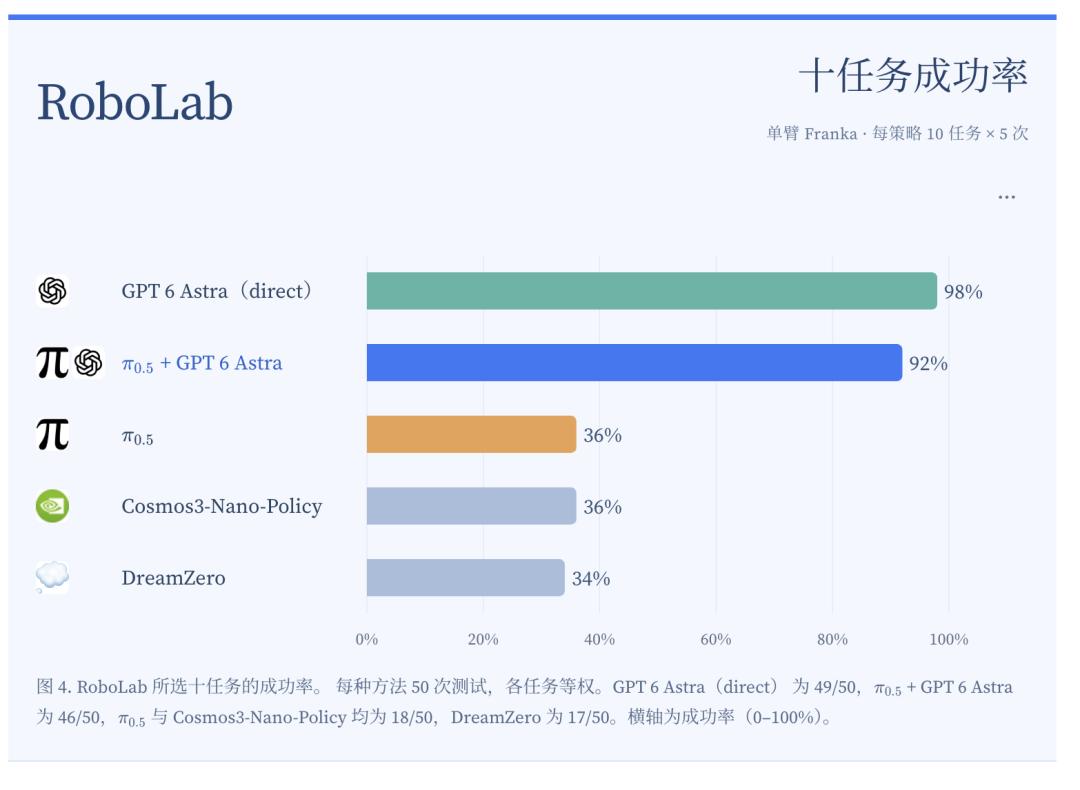
Besonders bemerkenswert ist, dass Astra keine zusätzliche Schulung für diese spezifischen Aufgaben erhalten hat. Das Modell beurteilt anhand des aktuellen Bildes, des Roboterzustands und der Aufgabenbeschreibung in natürlicher Sprache kontinuierlich, wie die nächste Aktion auszuführen ist.
Aus den Ergebnissen pro Aufgabe geht hervor, dass Astra bei mehreren Aufgaben alle 5 Versuche erfolgreich absolvierte, darunter das Einlegen von Blöcken in Kisten, die Verarbeitung von Kürbissen zwischen Unordnung, das Platzieren von Objekten nach festgelegten Beziehungen, das Stapeln in angegebener Reihenfolge und das erneute Anpassen der Ausrichtung von Bechern. Die einzige Aufgabe, die nicht vollständig erfolgreich war, war „Einlegen der großen Rosinenbox in den Behälter“, die 4 von 5 Mal abgeschlossen wurde.
Die Kernfähigkeit, die diese Experimentengruppe zeigt, ist die Zero-Shot-Generalisierung. Das Modell ist in der Lage, Ziele zu erkennen, räumliche Beziehungen zu verstehen, sprachliche Anforderungen in Aktionen umzuwandeln und die Strategie nach Umgebungsänderungen weiter anzupassen.
Allerdings muss diese Zahl im Zusammenhang mit der experimentellen Definition verstanden werden. Der Bericht stellt klar, dass das RoboLab-Experiment nur 10 Aufgaben und 5 endgültige Bewertungsplätze pro Aufgabe und pro Methode umfasst und keine vollständige Reproduktion der RoboLab-Rangliste darstellt; die historischen Baselines und Astra garantieren nicht streng identische Anfangszustände und Steuereinstellungen, und einige Astra-Experimente beinhalten autorisierte Wiederholungsversuche.
Daher eignet sich der Wert von 98 % eher zur Beobachtung der oberen Fähigkeitsgrenze von Astra bei diesen Aufgaben und kann nicht einfach als strenge Ranglistenleistung unter identischen Bedingungen betrachtet werden.
03 Die Stärke von GPT-6 Astra liegt darin, Aufgaben zu verstehen und Fehler zu erkennen
Wenn man zu den Ergebnissen pro Aufgabe von RoboDojo zurückkehrt, kann man noch genauer erkennen, worin seine Stärke tatsächlich liegt.
Bei der Aufgabe „Objektklassifizierung“ erzielte Astra Direct 100 Punkte und alle 5 Versuche waren erfolgreich; bei der Aufgabe „Klassifizierung nach Sprache“ erreichte der durchschnittliche Wert 60 Punkte mit einer Erfolgsrate von 40 %; bei der Aufgabe „Anordnen der größten Zahl“ lag die Punktzahl bei 57.
Score-Wärmetabelle, Wärmetabelle der Erfolgsrate
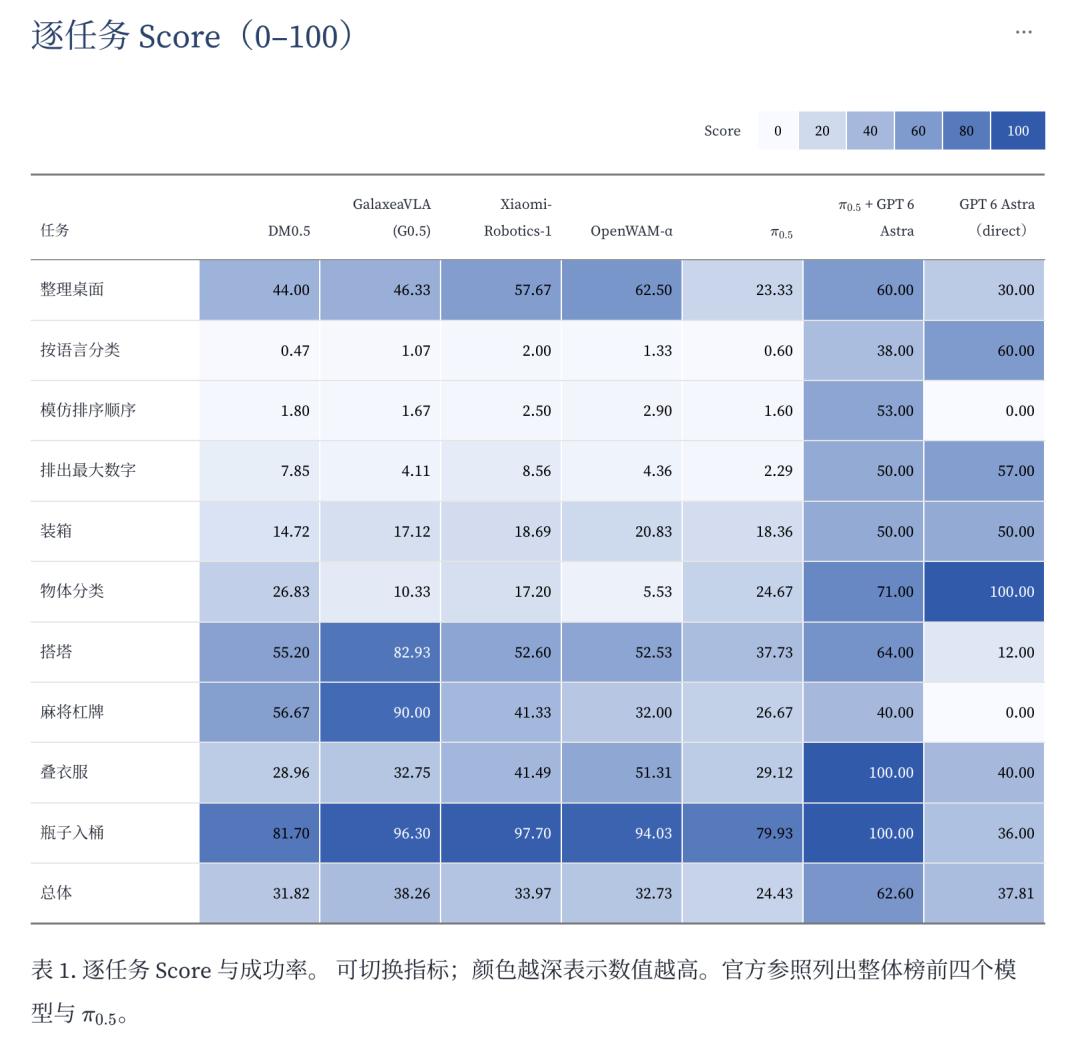
Diese Aufgaben hängen stark von Sprachverständnis, visueller Erkennung, Beziehungslogik und Zielplanung ab, genau die Fähigkeiten, in denen große Modelle stark sind.
In den Experimenten traten auch viele Verhaltensweisen auf, die bei herkömmlichen Roboterstrategien selten gezeigt werden.
Zum Beispiel ändert das Modell aktiv die Annäherungsweise, wenn es feststellt, dass eine Greifhaltung nicht ideal ist; nachdem die Objekte grob platziert wurden, beobachtet es die Umgebung erneut, stellt fest, dass die Aufgabe tatsächlich noch nicht abgeschlossen ist, und fährt mit der Anpassung fort; während des Einpackvorgangs kann es feststellen, dass hinter der Kiste noch vergessene Objekte liegen; wenn die ursprüngliche Planung blockiert wird, kann es die Planung basierend auf neuen visuellen Rückmeldungen neu erstellen.
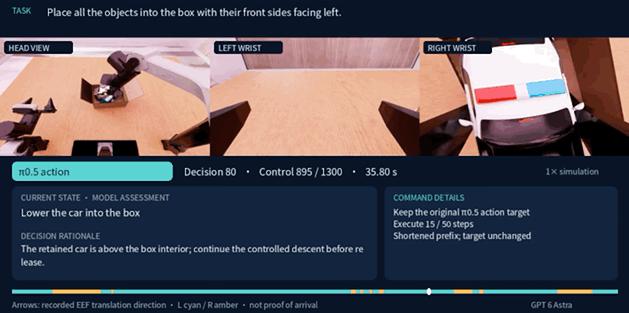
Abbildung: Während des Experiments beurteilt Astra den Aufgabenstatus basierend auf neuen Bildern nach der Ausführung weiter und passt die Aktionen bei Bedarf an. Zum Beispiel stellt das Modell bei der Objektklassifizierung fest, dass der aktuelle Greifvorgang eine lokale Korrektur erfordert; bei langwierigen Aufgaben wie dem Einpacken prüft das Modell kontinuierlich die verbleibenden Ziele in der Szene, bevor es die nachfolgenden Aktionen festlegt.
Auch bei der Aufgabe zum Anordnen von Zahlen gab es eine hervorragende Wiederherstellung: Das Modell versteht die Steuerungsrückmeldung des Roboterarms neu, nachdem die Bewegung blockiert wurde, passt die Aktion an und fährt mit der Ausführung fort. Es demonstriert die Fähigkeit von GPT-6 Astra, sich lokal an Steuerungsbeschränkungen anzupassen, anstatt passiv fehlgeschlagene Befehle zu wiederholen.
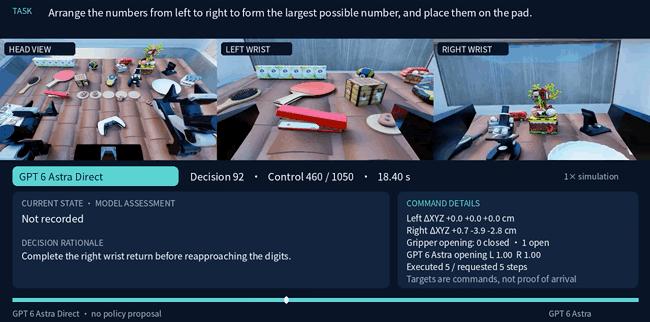
Abbildung: Anordnen von Zahlen: Hervorragende Wiederherstellung nach dem Verstehen der Steuerungsrückmeldung
Diese Phänomene zeigen, dass Astra nicht mechanisch eine im Voraus generierte Trajektorie ausführt, sondern einen geschlossenen Zyklus aus „Beobachten – Entscheiden – Ausführen – Erneutes Beobachten“ bildet.
Das Modell wählt sogar aktiv einige Strategien aus, die in den Trainingsdaten möglicherweise nicht häufig vorkommen. Zum Beispiel versuchte Astra Direct bei der Aufgabe „Einlegen von Flaschen in Eimer“, die Flaschen nicht einzeln zu greifen, sondern sie in Richtung Mülleimer zu schieben. Dieser Ansatz scheiterte letztendlich, zeigte aber, dass das Modell selbst neue Lösungswege basierend auf dem Ziel finden kann.
04 Der eigentliche Engpass liegt immer noch in der physischen Interaktion
Der Forschungsbericht offenbart jedoch auch die Schwächen von Astra.
Bei der Aufgabe „Turm bauen“ erreichte Astra Direct durchschnittlich nur 12 Punkte mit einer Erfolgsrate von 0; bei der Aufgabe „Mahjong-Steine ziehen“ lag die Punktzahl bei 0; diese Aufgaben erfordern präzise Berührungen, stabiles Greifen, Kollisionssteuerung und