Was sollte man wirklich aus Nvidias Finanzbericht entnehmen? Diese sechs Signale von Jensen Huang werden die KI-Hardware-Lieferkette bestimmen.
In diesem Nvidia-Geschäftsbericht werde ich nur ein paar Minuten darauf verwenden, die Umsätze, Bruttomargen und die Prognosen für das nächste Quartal zu überfliegen.
Was es wirklich wert ist, die gesamte Telefonkonferenz anzuhören, ist, wie Jensen Huang die folgenden wichtigeren Fragen beantwortet:
- Ob der nahtlose Übergang zwischen Blackwell und Rubin reibungslos funktioniert
- Ob die Vera-CPU neue Umsätze erschließen kann
- Ob Groq 3 LPX das Budget für die latenzarme Inferenz im Nvidia-Ökosystem halten kann
- Ob die Bruttomarge nach der Preiserhöhung von Servern gehalten werden kann
Denn heute zweifelt der Markt nicht mehr daran, ob es eine Nachfrage nach KI gibt.
Was wirklich beurteilt werden muss, ist, wie schnell sich diese Runde von Investitionen in die KI-Infrastruktur weiter ausdehnen kann und wohin Gewinne und Risiken in der nächsten Phase tatsächlich verlagern werden.
Nvidia wird die Ergebnisse des zweiten Quartals des Geschäftsjahres 2027 am Mittwoch, den 26. August, nach Börsenschluss der US-Aktienmärkte veröffentlichen.
Im letzten Quartal erreichte der Unternehmensumsatz 81,6 Milliarden US-Dollar, der Umsatz des Rechenzentrumsgeschäfts 75,2 Milliarden US-Dollar und die nicht GAAP-konforme Bruttomarge 75 %; die vom Unternehmen für dieses Quartal vorgelegte Umsatzprognose beträgt 91 Milliarden US-Dollar mit einer Schwankungsbreite von ± 2 %.
Die Zahlen sind natürlich wichtig, aber was die Erwartungen für die nächsten Quartale wirklich bestimmt, sind nach Analyse von StockWe.com die folgenden sechs Signale.
Erstes Signal: Können die Aufträge für neue KI-Clouds von „finanzierungsgetrieben“ zu „umsatzgetrieben“ übergehen
Im letzten Quartal hat das Unternehmen sogar die Art der Offenlegung des Rechenzentrumsgeschäfts geändert: Große öffentliche Clouds und Internetunternehmen werden als Hyperscale zusammengefasst, während KI-Cloud-, Industrie- und Unternehmenskunden separat unter ACIE geführt werden. Diese Änderung an sich zeigt bereits, dass die Nachfrage nach KI-Rechenleistung sich auf immer mehr Kunden ausweitet.
Daher hat die weitere Diskussion darüber, „ob die Kundenbasis diversifiziert ist“, kaum noch Bedeutung.
Die eigentliche Frage lautet:
Können neue KI-Cloud-Anbieter wie CoreWeave und Nebius nach ihrer rasanten Expansion zukünftig ihre Einkäufe zunehmend durch echte Umsätze und Auslastungsraten stützen, statt hauptsächlich auf stetig wachsende Finanzierungen angewiesen zu sein?
Diese Angelegenheit wird in letzter Zeit immer wichtiger.
Im März kündigten Nvidia und Nebius eine langfristige strategische Zusammenarbeit an, wobei Nebius plant, bis Ende 2030 mehr als 5 GW an Nvidia-Systemen einzusetzen.
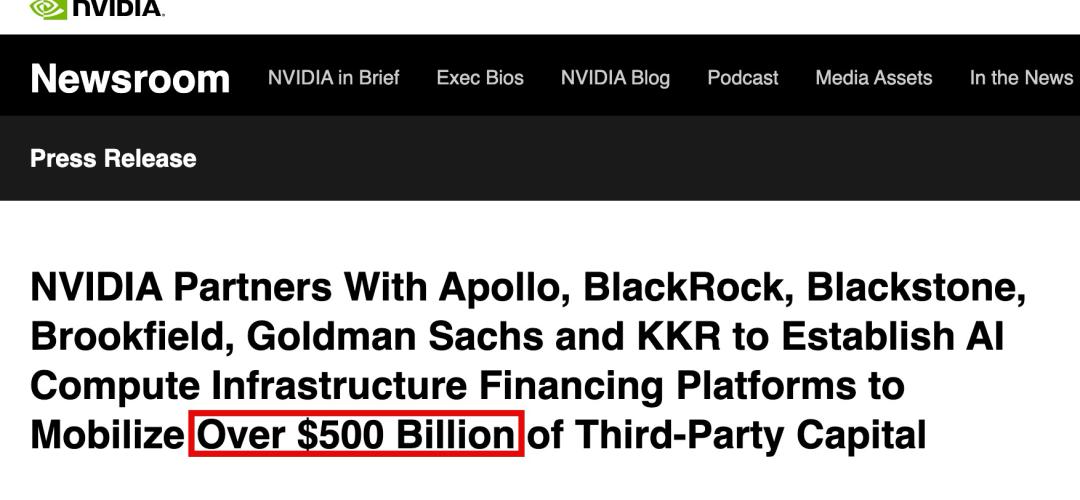
Am 10. August gründete Nvidia gemeinsam mit Apollo, BlackRock, Blackstone, Brookfield, Goldman Sachs und KKR eine unabhängige Finanzierungsplattform für KI-Rechenleistung. Das Ziel ist, langfristig mehr als 5000 Milliarden US-Dollar an Drittkapital zu mobilisieren, um KI-Clouds, Unternehmen und anderen Kunden eine größere Finanzierungskapazität zur Verfügung zu stellen.
Das zeigt, dass Nvidia heute nicht mehr mit dem Problem konfrontiert ist, „ob es Kunden gibt“, sondern mit einer weiteren Ebene von Fragestellungen:
Die Kunden haben Nachfrage, aber die Kapitalausgaben steigen stetig an – womit werden die Aufträge letztendlich gestützt?
Daher achte ich bei dieser Telefonkonferenz mehr darauf, wie das Management die Auslastungsrate, die Auftragslaufzeiten, die Verlängerung von Verträgen und das Umsatzwachstum der KI-Cloud-Kunden beschreibt.
Wenn die Rechenauslastung und die KI-Umsätze dieser Kunden weiter steigen, dann wirkt die Finanzierung als Beschleuniger.
Aber wenn das Wachstumstempo der Kapitalausgaben langfristig schneller ist als die eigenen Umsätze und Cashflows der Kunden, wandelt sich die Finanzierung allmählich von einem Förderer zu einer Quelle von Risiken.
Dabei wird die Qualität der neuen Aufträge von Nvidia bestimmt, nicht nur deren Anzahl.
Zweites Signal: Kann Rubin nahtlos an Blackwell anknüpfen
Vera Rubin ist mittlerweile in die vollständige Serienproduktion eingetreten. Die gesamte Lieferkette umfasst mehr als 350 Fabriken in 30 Ländern, Systemhersteller wie Dell, HPE, Lenovo und Supermicro sind bereits in das Produktionssystem eingebunden. Auch CoreWeave, Google Cloud, Microsoft Azure, Oracle und Nebius setzen bereits entsprechende Systeme ein.
Worauf es wirklich ankommt, ist:
Kann Rubin direkt anknüpfen, solange Blackwell noch in großen Mengen ausgeliefert wird, ohne dass eine Lücke beim Generationswechsel entsteht?
Im letzten Quartal hat das Management bereits klar den Ramp-up-Rhythmus von Rubin für die zweite Jahreshälfte angegeben und mitgeteilt, dass das Unternehmen bereits Einkaufsaufträge erhalten hat. Daher ist das Wichtigste bei dieser Gelegenheit nicht, noch einmal zu hören, dass „die Nachfrage nach Rubin sehr stark ist“, sondern ob es einen klareren Lieferrhythmus gibt.
Wenn GB300 weiterhin stark ausgeliefert wird und gleichzeitig Rubin beginnt, Umsätze zu generieren, können die beiden Produktgenerationen überlappen, und die Umsatztransparenz für die nächsten Quartale ist relativ solide.
Umgekehrt, wenn das Management beginnt, die Beschreibung von Aufträgen und Auslieferungen zu reduzieren und stattdessen mehr auf die Systemkomplexität, die Vorbereitungen der Kundendatenzentren und die Einsatzzeit hinzuweisen, sollte man wachsam werden.
Denn Rubin ist nicht mehr nur eine einzelne GPU.
Es handelt sich um ein komplettes POD-System, das gemeinsam aus der Vera-CPU, der Rubin-GPU, Groq 3 LPX, dem BlueField-4-Speicher und dem Spectrum-6-Netzwerk besteht.
Die pünktliche Auslieferung der GPU allein bedeutet nicht, dass das gesamte System pünktlich Umsätze erzielen kann.
Wenn irgendein Teilbereich langsamer wird, kann Folgendes eintreten:
Die Aufträge bestehen weiter, aber die Umsätze werden nach hinten verschoben.
Aus diesem Grund lohnt es sich, die Bestandsgrößen, Einkaufszusagen und Vorauszahlungen von Nvidia aus dem letzten Quartal weiter zu verfolgen. Wo das Geld im Voraus gebunden ist, lässt sich oft rückschließen, welche Bereiche in der nächsten Phase wirklich knapp werden.
Drittes Signal: Kann die Vera-CPU wirklich eine unabhängige Umsatzlinie erschließen
Das Bemerkenswerteste an Vera ist nicht seine Rolle als CPU im Rubin-System.
Vielmehr versucht Nvidia, es separat zu verkaufen.
Ende Mai dieses Jahres hat Nvidia offiziell eigenständige Vera-CPU-Server vorgestellt und mitgeteilt, dass Kunden wie Anthropic, OpenAI, SpaceXAI, ByteDance, CoreWeave, Nebius und Oracle die Produkte bewerten oder deren Einsatz planen. Dell, HPE, Lenovo und Supermicro werden ebenfalls eigenständige Vera-Server anbieten.
Im letzten Quartal hat das Management zudem eine sehr wichtige Zahl genannt:
Das Unternehmen verfügt bereits über eine Umsatztransparenz von fast 20 Milliarden US-Dollar für die eigenständige Vera-CPU im laufenden Jahr, und dieser Teil enthält nicht die Umsätze, bei denen Vera als Bestandteil des Vera-Rubin-Systems verkauft wird.
Das bedeutet, dass Nvidia nun wirklich in den Server-CPU-Markt eintritt, der lange Zeit von Intel und AMD dominiert wurde.
Neue Entwicklungen vom 24. August bestätigen diesen Weg weiter.
SpaceXAI kündigte Pläne an, die Vera-CPU für die Orchestrierung, den Tool-Aufruf, die Codeausführung, die Datenverarbeitung und die Simulation in Agent-Workloads einzusetzen, um diese CPU-intensiven Aufgaben von den GPUs zu verlagern und die GPU-Auslastung zu verbessern.
Das ist nicht einfach nur eine „GPU mit dazugehöriger CPU“.
Vielmehr beginnt Vera, eigenständige Workloads zu übernehmen.
Daher gibt es bei dieser Telefonkonferenz drei Dinge zu beachten:
- Wurde die Umsatztransparenz von fast 20 Milliarden US-Dollar weiter nach oben angepasst?
- Wann beginnen die eigenständigen Vera-Umsätze, deutlich erfasst zu werden?
- Und wie viele Kunden sind derzeit von der Testphase zum offiziellen Einsatz übergegangen?
Wenn diese Zahlen weiter steigen, ist Vera nicht mehr nur ein Teil des Rubin-Systems.
Es wird zu einer neuen unabhängigen Umsatzkurve für Nvidia.
Viertes Signal: Kann Groq 3 LPX das spezielle Inferenzbudget im Nvidia-Ökosystem halten
Das ist eine neue Variable, die erst am Tag vor der Veröffentlichung des Geschäftsberichts aufgetaucht ist.
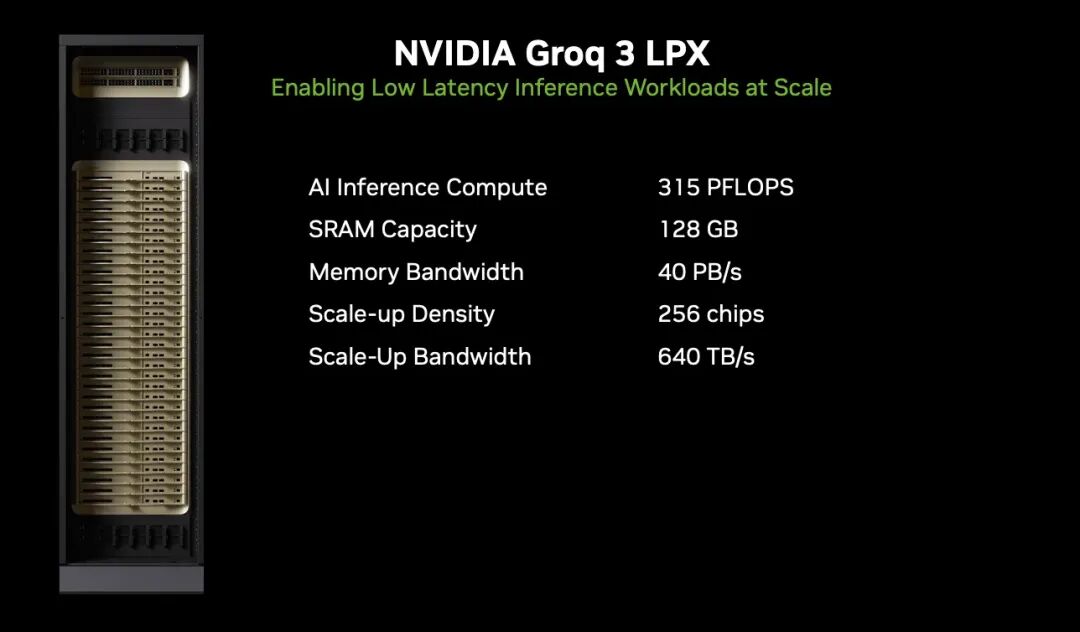
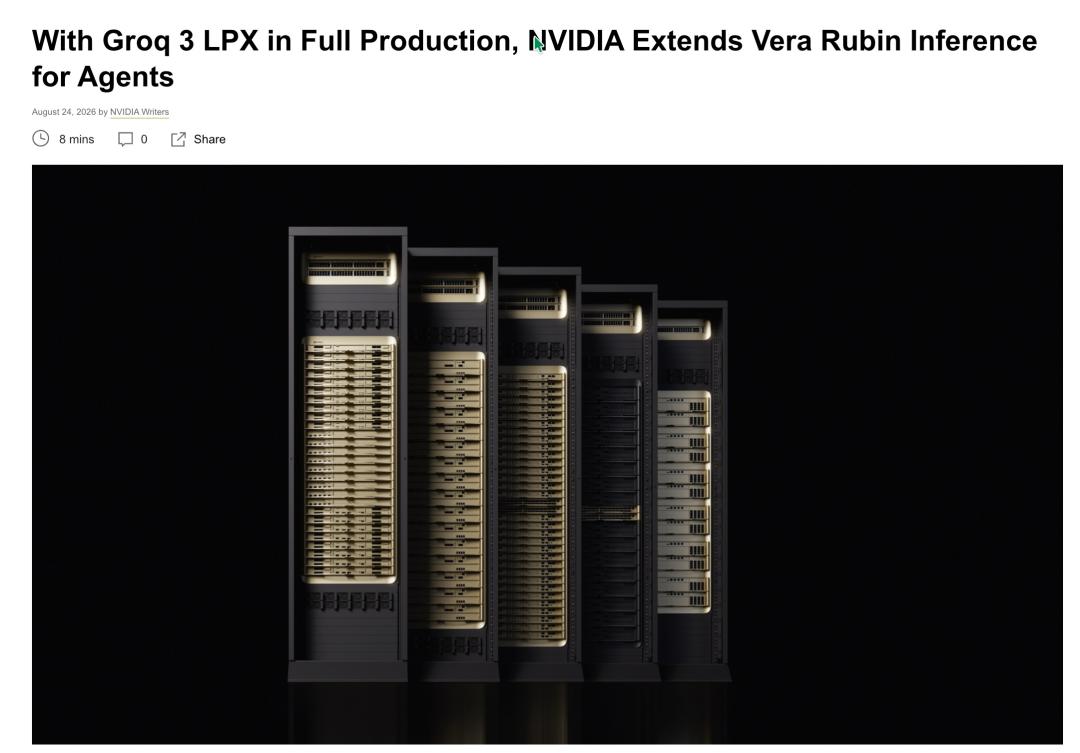
Am 24. August kündigte Nvidia an, dass Groq 3 LPX die vollständige Serienproduktion erreicht hat und offiziell als Bestandteil der Vera-Rubin-Plattform für die latenzarme Token-Generierung und die Agent-Inferenz eingesetzt wird. Nebius wurde der erste Kunde, der die KI-Cloud-Lösung einsetzt.
Die Bedeutung dieser Angelegenheit liegt nicht nur darin, dass ein weiterer Chip hinzugekommen ist.
Bisher hat Nvidia hauptsächlich auf GPUs gesetzt, um gleichzeitig Training und Inferenz abzudecken. Aber mit der Zunahme von Agent-Workloads zeigt sich bei der Inferenz eine immer deutlichere Aufgabenteilung.
Das Prefill von Modellen, die Berechnung langer Kontexte und die allgemeine Inferenz eignen sich für GPUs, während die Token-für-Token-Generierung, Code-Agenten und Echtzeit-Interaktion extrem latenzempfindlich sind – das lässt Raum für spezielle Inferenzbeschleuniger.
Groq 3 LPX ist die Antwort von Nvidia auf diese Veränderung.
Nvidia gab bekannt, dass Groq 3 LPX bei Tests mit Gemma 4 31B und einem Kontext von 100.000 Token eine Leistung von etwa 3400 Ausgabetoken pro Sekunde erreicht; und es ersetzt die Rubin-GPU nicht eigenständig, sondern arbeitet mit Vera Rubin zusammen.
Das dahinterstehende geschäftliche Logik ist wichtiger als die Leistung selbst:
Wenn die Inferenz zunehmend spezialisiert wird, möchte Nvidia, dass dieser Teil des Budgets weiterhin auf seiner eigenen Plattform verbleibt, statt zu anderen spezialisierten Beschleunigern abzufließen.
Daher geht es bei dieser Telefonkonferenz wirklich um die Verfolgung von Kunden und Umsätzen.
- Wie viele Kunden setzen nach Nebius das Produkt ein?
- Wann beginnt die Massenauslieferung von LPX?
- Wie hoch ist die Übereinstimmungsrate mit Vera Rubin?
- Wird das Management beginnen, diesen Teil der Umsätze separat zu erörtern?
Wenn nur von Token-Geschwindigkeit und Benchmarks die Rede ist, handelt es sich bisher nur um einen Produktvorteil. Wenn Kunden und Auslieferungsmengen schnell wachsen, wird es wirklich zu einem neuen Umsatzplus.
Fünftes Signal: KI-Server werden immer teurer – kann Nvidia die Bruttomarge von 75 % halten
Vor der Veröffentlichung des Geschäftsberichts gibt es eine weitere neue Variable, der große Aufmerksamkeit zu schenken ist:
Die Kosten für KI-Server steigen weiter an.
Laut Informationen von StockWe.com könnten die Preise einiger KI-Server mit Grace Blackwell und Vera Rubin, die ab Anfang 2027 ausgeliefert werden, um mehr als 15 % steigen – die endgültige Erhöhung hängt von der jeweiligen Produktgeneration und der Speicherkonfiguration ab.
Hier liegt leicht ein Fehlurteil nahe:
Wenn man sieht, dass die Serverpreise steigen, versteht man das einfach als stärkere Preismacht und höhere Gewinnmargen von Nvidia.
Das muss in der Praxis nicht stimmen.
Der wichtige Hintergrund dieser Preiserhöhung ist, dass ODMs die gestiegenen Kosten bereits an die nachgelagerten Cloud-Anbieter weitergeben, nachdem die Preise für HBM, DRAM und unternehmensweiten Speicher gestiegen sind.
Und Vera Rubin ist bereits ein komplett hochgradig integriertes System.
Neben der GPU machen die Kosten für Arbeitsspeicher, Speicher, Netzwerke, Flüssigkühlung und Stromkomponenten einen immer höheren Anteil aus.
Daher müssen bei diesem Geschäftsbericht „Preis“ und „Bruttomarge“ gemeinsam betrachtet werden.
Im letzten Quartal lag die nicht GAAP-konforme Bruttomarge von Nvidia bei 75 %, und die Prognose des Unternehmens für dieses Quartal liegt ebenfalls bei etwa 75 %.
Wenn die Bruttomarge nach der Preiserhöhung der Server weiterhin auf diesem Niveau stabil bleibt, zeigt das, dass Nvidia immer noch eine starke Fähigkeit hat, Kosten weiterzugeben. Aber wenn der Preis des gesamten Geräts bereits gestiegen ist und die Bruttomarge dennoch deutlich sinkt, hat das eine völlig andere Bedeutung:
Die Kosten für vorgelagerte Komponenten und die Integration komplexer Systeme beginnen, die eigenen Gewinne von Nvidia zu schmälern.
Diese Angelegenheit wird zudem die Gewinnverteilung in der gesamten KI-Hardwarekette beeinflussen.
Mit der steigenden Bedeutung von Komponenten wie HBM, DRAM und unternehmensweiten SSDs werden die Gewinne von KI-Servern zukünftig nicht unbedingt weiterhin stark auf die GPU konzentriert sein.
Wer im vorgelagerten Bereich über knappe Kapazitäten verfügt, hat eine stärkere Verhandlungsmacht.
Daher lohnt es sich bei dieser Gelegenheit wirklich zu hören, wie das Management die Speicherkosten, die Einkaufssicherheit, die Systempreise und die Bruttomarge beschreibt.
Das ist wichtiger als die einfache Diskussion darüber, ob „eine 15-%-ige Preiserhöhung bei Servern positiv oder negativ ist“.
Sechstes Signal