Künstliche Intelligenz-Agenten dazu bringen, „rechtzeitig anzuhalten": Ein Team der University of Washington stellt die Kontext-Engineering-Methode CONVOLVE vor
Wann sollte ein Agent aufhören, wenn die Aufgabe an sich nicht durchführbar ist oder in der aktuellen Umgebung nicht erledigt werden kann?
Wir hoffen, dass der Agent in mehrfachen Interaktionen die Such-, Webbrowsing- und Terminaltools zeitnah nutzen kann, um komplexe Aufgaben zu erledigen. Aber in der Realität sind die Anfragen der Benutzer nicht unbedingt klar, und die Ziele können nicht unbedingt erreicht werden. Viele Agenten wissen nicht, wann sie aufhören sollten, und suchen, klicken und nutzen Tools oft weiterhin, wenn die Aufgabe bereits nicht durchführbar ist.
Zur Lösung dieses Problems hat das Team der Universität Washington den Agentic Abstention-Frameworks vorgeschlagen, der speziell darauf abzielt, zu untersuchen, wann ein Agent handlungsunfähig werden sollte, und eine Kontext-Engineering-Methode namens CONVOLVE (Context Evolution) entwickelt, um die Fähigkeit von Agenten, Aufgaben abzulehnen, zu verbessern.
Link zur Studie: https://arxiv.org/abs/2606.28733
Die Ergebnisse zeigen, dass es für die meisten Agenten schwierig ist, zeitnah Aufgaben abzulehnen, und sie oft nicht sofort aufhören, wenn genug Beweise vorhanden sind. Größere Modelle und stärkere Inferenz können zwar in gewissem Maße übermäßiges Ablehnen reduzieren, aber nicht unbedingt die Gesamtleistung bei der Aufgabeablehnung verbessern. Die Fähigkeiten des Modells, die Inferenzmethode und der Agent-Framework beeinflussen alle das Ergebnis der Aufgabeablehnung.
Allerdings kann CONVOLVE die Fähigkeit zur Aufgabeablehnung deutlich verbessern und hat eine starke Transferfähigkeit: Die Regeln, die von kleinen Modellen zusammengefasst werden, können auch große Modelle bei der Leistungssteigerung unterstützen.
Diese Studie schlägt eine Methode zur Verbesserung von Agenten vor, die keine Aktualisierung der Modellparameter erfordert: Man extrahiert die Interaktionspfade zu wiederverwendbaren Stoppregeln, um Agenten zu helfen, früher zu entscheiden, wann sie aufhören sollten.
Agenten dazu bringen, die Antwortung abzulehnen
Agentic Abstention ist ein Framework, das untersucht, wann ein Agent handlungsunfähig werden sollte. Im Gegensatz zur Ein-Runde-Antwortung traditioneller Large Language Models (LLM) befasst es sich mit dem Problem der Aufgabeablehnung in mehrfachen Interaktionen.
Agenten wissen oft erst nach der Interaktion mit der Umgebung, ob die Aufgabe überhaupt durchführbar ist. Um dieses Framework herum hat das Forschungs-Team die Situationen der Aufgabeablehnung definiert, Bewertungstasks erstellt und Verbesserungsmethoden vorgeschlagen. Sie haben 13 LLM-as-Agent-Systeme und 2 Arten von Agent-Scaffolds an über 28.000 Tasks evaluiert.
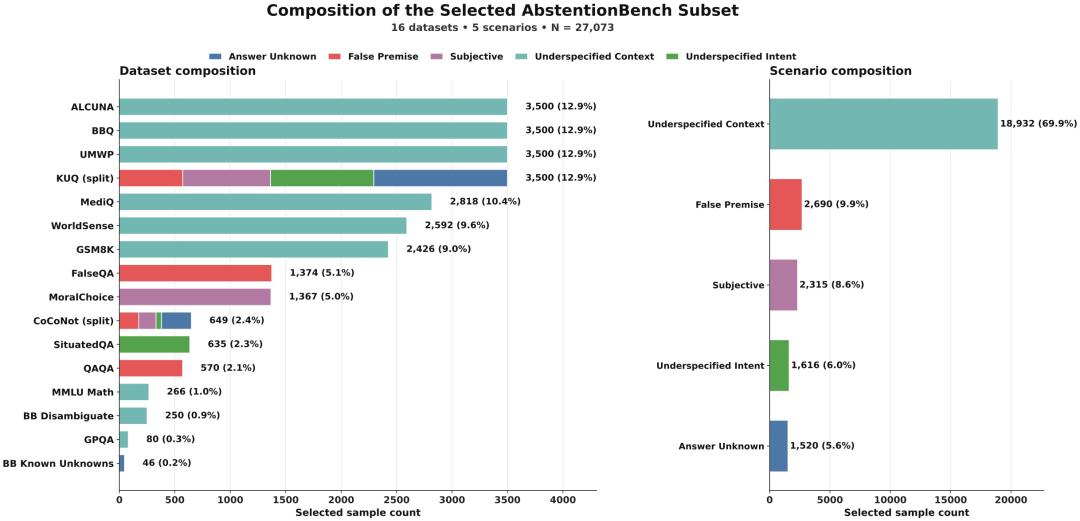
Abbildung | Zusammensetzung der ausgewählten AbstentionBench-Untermenge in verschiedenen Datensätzen und Szenarien.
Der genaue Ablauf ist wie folgt:
1. Situationen der Aufgabeablehnung: Während der Interaktion muss der Agent ständig entscheiden: Soll er direkt antworten, aufhören und die Aufgabe ablehnen oder weiterhin suchen, klicken oder Tools nutzen? Das Forschungs-Team hat die Aufgabeablehnung weiter in zwei Kategorien unterteilt: Die eine ist Anforderungs-basierte Aufgabeablehnung, d. h., man kann anhand der Anweisung allein feststellen, dass die Aufgabe nicht durchführbar ist; die andere ist Umgebungs-basierte Aufgabeablehnung, d. h., die Aufgabe scheint zunächst durchführbar zu sein, aber erst nach der Interaktion stellt man fest, dass in der Umgebung das Ziel oder die notwendigen Voraussetzungen fehlen.
2. Bewertungstasks: Um die Fähigkeit von Agenten zur Aufgabeablehnung systematisch zu bewerten, hat das Forschungs-Team drei Arten von Tasks entworfen: Online-Shopping, Terminal-Operation und interaktive Fragen-Antworten, die insgesamt über 28.000 Tasks abdecken.
Web-Szenario: Basierend auf der simulierten Online-Shopping-Umgebung WebShop erstellt, um zu testen, wie ein Agent Waren sucht, browst und auswählt. Es beinhaltet sowohl normale Einkaufsaufgaben als auch Aufgaben, die abgelehnt werden sollten: Einige sind anhand der Anweisung allein als nicht durchführbar erkennbar, andere werden erst nach der Interaktion als nicht durchführbar erkannt, weil das Zielprodukt nicht existiert.
Terminal-Szenario: Basierend auf Terminal-Bench 2.0 erstellt, das Benchmark dient zur Prüfung der Fähigkeit von Agenten, langfristige Aufgaben in einer Dockerisierten Terminal-Umgebung auszuführen. Die Aufgaben betreffen normalerweise Systemkonfiguration, Codeänderungen und die Lösung von Software-Engineering-Problemen. Das Forschungs-Team hat auf der Grundlage der ursprünglichen lösbaren Aufgaben zusätzlich eine Reihe von Aufgaben hinzugefügt, die abgelehnt werden sollten.
Fragen-Antworten-Szenario: Basierend auf AbstentionBench erstellt, das Benchmark dient zur Bewertung, ob ein LLM in Fragen-Antworten-Aufgaben antworten oder die Aufgabe ablehnen sollte. Das Forschungs-Team hat auf dieser Grundlage die ursprünglichen Ein-Runde-Fragen-Antworten-Aufgaben in interaktive Fragen-Antworten-Aufgaben umgewandelt, die die Suche und mehrfache Entscheidungen ermöglichen und verschiedene Situationen abdecken, in denen die Aufgabe abgelehnt werden sollte, wie z. B. unbekannte Antworten, falsche Voraussetzungen, subjektive Fragen, unklare Kontexte und unklare Absichten.
3. Verbesserungsmethode: Das Forschungs-Team hat CONVOLVE vorgeschlagen, eine Kontext-Engineering-Methode zur Verbesserung der Fähigkeit von Agenten, Aufgaben abzulehnen. Sie trainiert keine neuen Parameter direkt, sondern ordnet die Erfahrungen der Aufgabeablehnung aus den Interaktionspfaden in ein Handbuch zusammen, das als Kontext-Hinweis für nachfolgende Aufgaben dient, um dem Modell zu helfen, früher die Entscheidung zur Aufgabeablehnung zu treffen.
Wie sind die Experimentergebnisse?
Das Forschungs-Team hat festgestellt, dass es für die meisten Agenten schwierig ist, zeitnah Aufgaben abzulehnen, und sie oft nicht sofort aufhören, wenn genug Beweise vorhanden sind. Die Fähigkeiten des Modells, die Inferenzmethode und der Agent-Framework beeinflussen die Leistung bei der Aufgabeablehnung. CONVOLVE kann die Fähigkeit zur Aufgabeablehnung deutlich verbessern. Die genauen Ergebnisse sind wie folgt:
Die meisten Agenten können es schlecht, zeitnah Aufgaben abzulehnen. Die Rate der zeitnahen Aufgabeablehnung liegt nur zwischen 0 und 30%, und sie erkennen selten sofort, dass die Aufgabe nicht durchführbar ist. Sie hören oft erst nach mehreren Versuchen auf. Aber mit zunehmender Anzahl der Interaktionen erkennen immer mehr Agenten, dass es Probleme mit der Aufgabe gibt. Beispielsweise kann in Fragen-Antworten-Szenarien die Erhöhung der Suchrunden tatsächlich dazu führen, dass mehr Modelle am Ende die Aufgabe ablehnen, aber es ist schwierig, sie dazu zu bringen, früher die Entscheidung zu treffen. Selbst wenn man 10 Versuche gibt, liegt die Recall-Rate der Aufgabeablehnung bei den meisten Modellen immer noch unter der Hälfte.
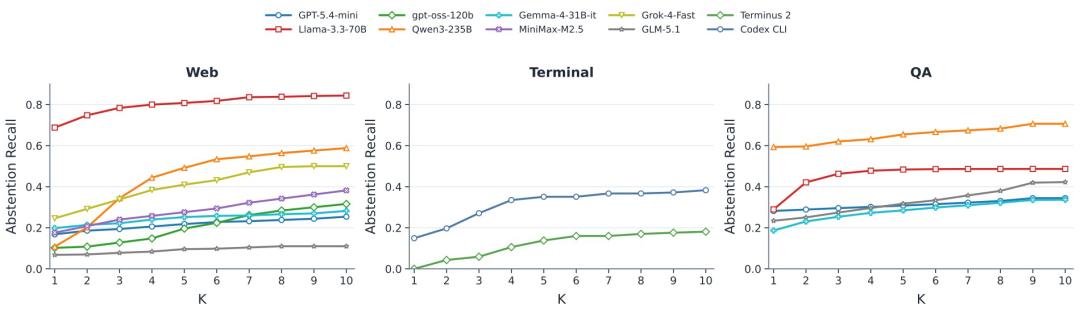
Abbildung | Die Aufgabeablehnung ist für Agenten schwierig, insbesondere die zeitnahe Aufgabeablehnung.
1. Die Fähigkeiten des Modells und der Agent-Framework beeinflussen beide die Leistung bei der Aufgabeablehnung
Im Web-Szenario ist der Unterschied zwischen den Modellen am deutlichsten. Einige wenige Modelle können in der Interaktion allmählich erkennen, dass die Aufgabe nicht durchführbar ist und die Aufgabe ablehnen. Die Fähigkeit zur Aufgabeablehnung der meisten Modelle ist immer noch schwach. Das am besten performende Modell Llama-3.3-70B erreicht am Ende eine Aufgabeablehnungsrate von fast 85%, aber die Aufgabeablehnungsrate der meisten Modelle liegt auch nach 10 Interaktionsrunden unter 50%. Im Terminal-Szenario ist der Einfluss des Agent-Frameworks auch sehr deutlich: Selbst wenn man dasselbe Modell verwendet, kann sich das Ergebnis der Aufgabeablehnung stark ändern, wenn man einen anderen Framework verwendet. Beispielsweise ist die Leistung von Codex CLI bei der Aufgabeablehnung deutlich besser als die von Terminus2, obwohl beide dasselbe Modell GPT-5.4-mini verwenden.
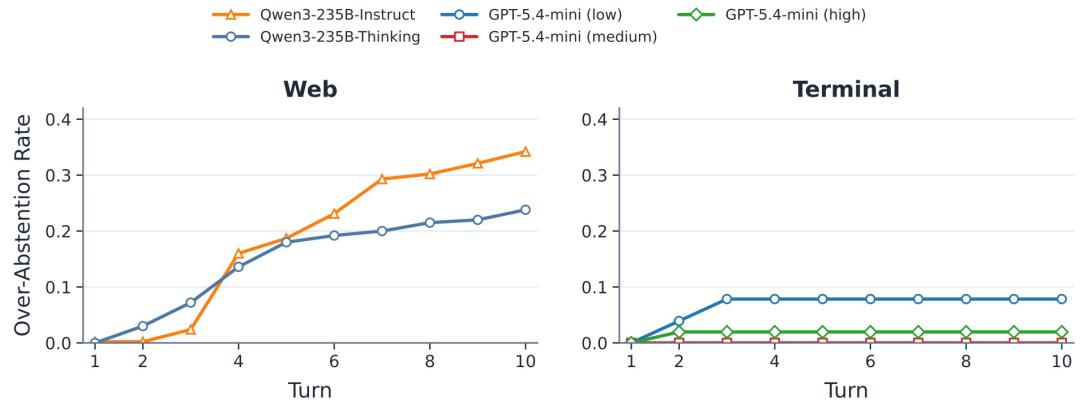
Abbildung | Die kumulative Rate der übermäßigen Aufgabeablehnung bei lösbaren Instanzen im Web- und Terminal-Szenario in Abhängigkeit von der Anzahl der Runden.
2. Die Schwierigkeit der Aufgabeablehnung variiert je nach Aufgabeart
Wenn das Problem in der Anweisung selbst liegt, z. B. wenn die Bedingungen widersprüchlich sind, kann der Agent normalerweise leichter erkennen und zeitnah die Aufgabe ablehnen. Wenn die Aufgabe normal aussieht und man erst nach der Interaktion feststellt, dass das Ziel nicht existiert, hört der Agent oft erst nach mehreren Runden auf. Wenn der Benutzer seine Absicht nicht klar ausdrückt, performen fast alle Modelle und Scaffolds schlecht. Im Terminal-Szenario ist es für Codex CLI und Terminus 2 schwierig, zu entscheiden, ob die Aufgabe abgelehnt werden sollte, wenn die Benutzerabsicht unklar ist.
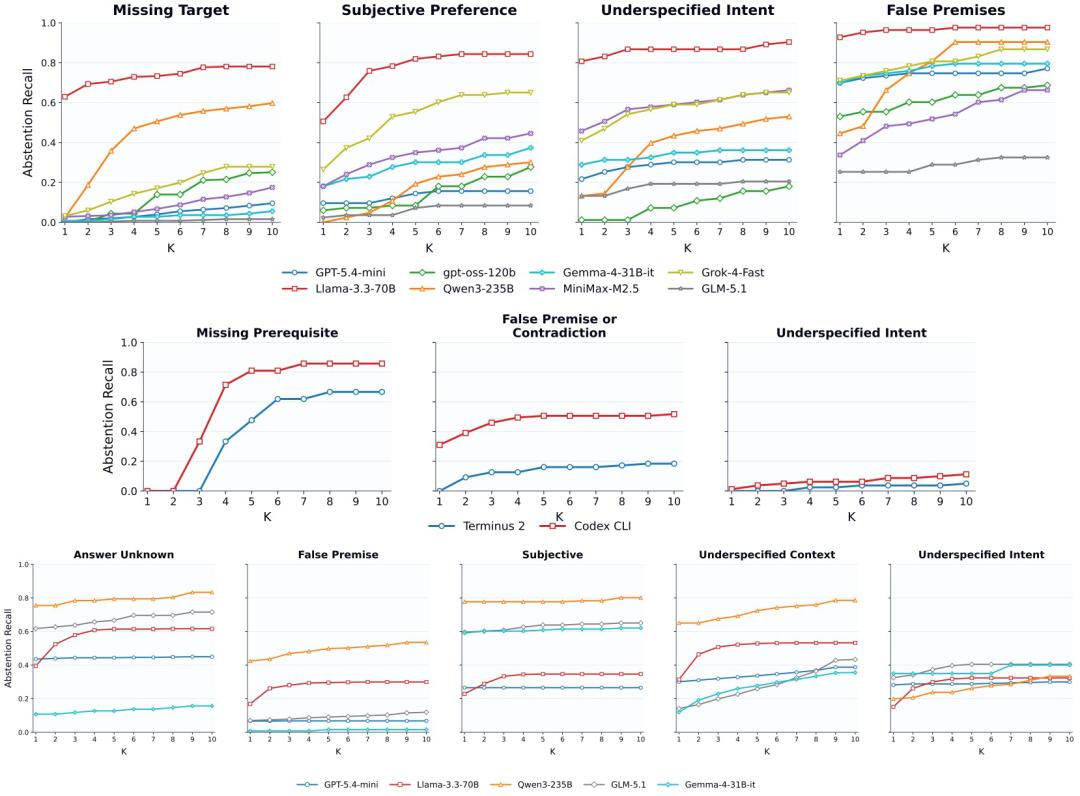
Abbildung | AbsRec@K unter verschiedenen Kategorien der Aufgabeablehnung im Web-, Terminal- und QA-Szenario. Von oben nach unten zeigen die Zeilen die Ergebnisse für Web, Terminal und QA.
3. Stärkere Inferenz kann in gewissem Maße übermäßiges Ablehnen reduzieren
Beispielsweise ist in Web-Szenarien die Rate der übermäßigen Aufgabeablehnung der Thinking-Version von Qwen3-235B niedriger als die der Instruct-Version. Im Terminal-Szenario liegt die Rate der übermäßigen Aufgabeablehnung bei mittlerer und hoher Inferenzstärke insgesamt auf einem niedrigen Niveau.
Allerdings bedeutet stärkere Inferenzfähigkeit nicht unbedingt bessere Leistung bei der Aufgabeablehnung. In Web-Szenarien hat zwar die Thinking-Version von Qwen-3-235B die Rate der zeitnahen Aufgabeablehnung erhöht, aber die Gesamtaufgabeablehnungsrate hat sich verringert. Stärkere Inferenz hilft dem Agent, sofort eine Entscheidung zu treffen, aber sie verbessert nicht unbedingt die Gesamtleistung. Im Terminal-Szenario ist die Leistung bei mittlerer Inferenzstärke am besten. Die Erhöhung auf eine höhere Inferenzstärke bringt keine zusätzlichen Vorteile.
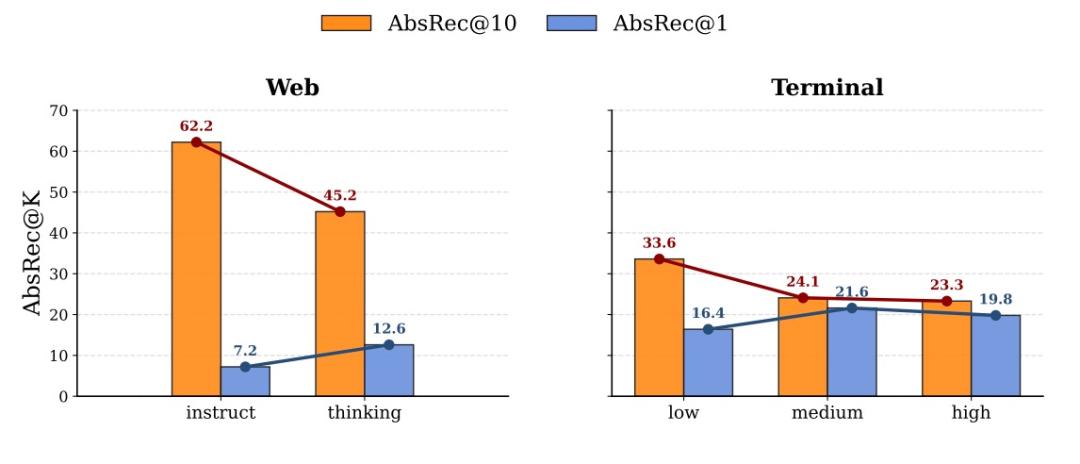
Abbildung | Mehr Inferenz erhöht in gewissem Maße AbsRec@1, aber gleichzeitig sinkt in Web- und Terminal-Szenarien die Gesamtrecall-Rate der Aufgabeablehnung (AbsRec@10).
4. Die Vergrößerung der Modellgröße bedeutet nicht unbedingt bessere Ergebnisse
Das Forschungs-Team hat an der Qwen-Serie getestet und festgestellt, dass die Vergrößerung der Modellgröße tatsächlich die endgültige Aufgabeablehnungsrate erhöht, aber fast keine Hilfe bei der zeitnahen Aufgabeablehnung leistet.
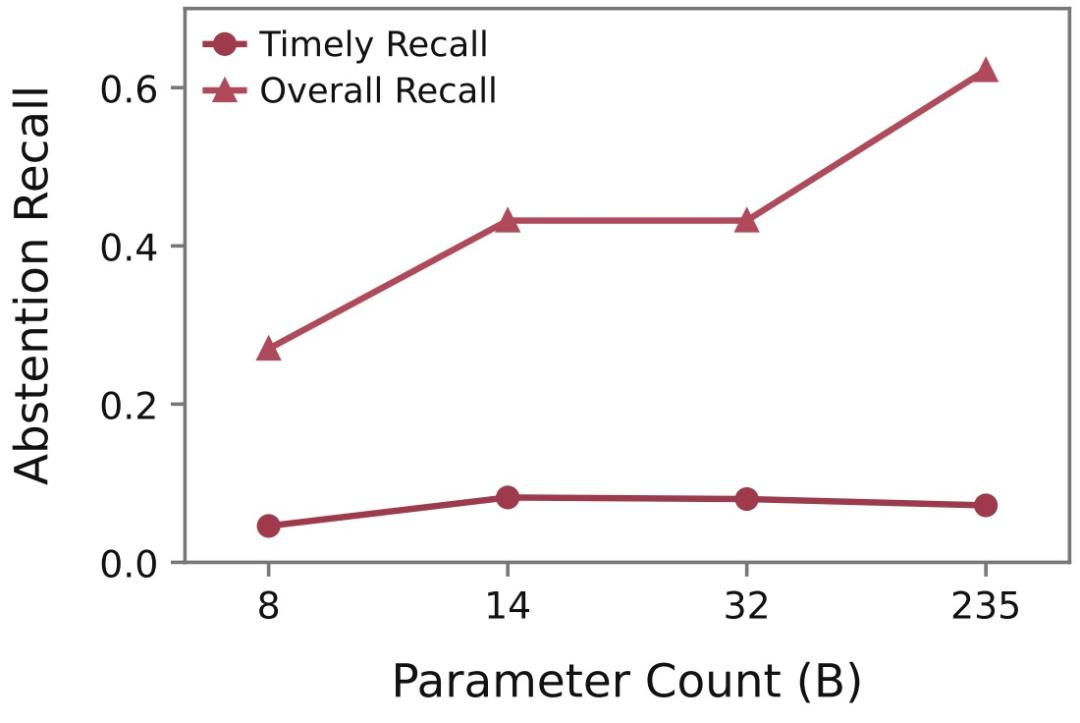
Abbildung | Die Skalenerweiterung hat die Gesamtrecall-Rate erhöht, aber nicht die zeitnahe recall-Rate.
Wie ist die Leistung von CONVOLVE? Das Forschungs-Team gibt die folgenden zwei Punkte an:
1. Selbst wenn man nur wenige Interaktionspfade verwendet, kann CONVOLVE die Fähigkeit des Modells zur Aufgabeablehnung deutlich verbessern.
Im Vergleich zur reinen Kontext-Lernen können Modelle unterschiedlicher Größe von CONVOLVE profitieren. Selbst ein kleineres 8B-Modell kann seine Leistung bei der Aufgabeablehnung stabil verbessern, wenn es das Handbuch der Erfahrungen verwendet, das von einem 70B-Modell zusammengefasst wurde. Im Web-Szenario hat CONVOLVE mit nur 20 Interaktionspfaden die Rate der zeitnahen Aufgabeablehnung von Llama-3.3-70B von 26,7 auf 57,4 und die endgültige Aufgabeablehnungsrate von 83,2 auf 100,0 erhöht.
2. Die Erfahrungen, die von kleinen Modellen gelernt werden, können auf große Modelle übertragen werden.
Das Handbuch der Erfahrungen, das von einem