Pi 抛出全新 Agent Harness,还把自己骂了一年的 MCP 装进了核心
Pi 迎来了今年规模最大的一次更新:项目升级到 1.0,Code Mode 与原生 MCP 正式进入稳定版;同一天,团队还推出了一套全新的 Harness——Pi Durable。
这些变化已经酝酿了一段时间。过去一年,MCP 协议经历了六七轮调整,逐渐发展到真正可用的阶段;Pi Durable 的架构也前后经历了八轮迭代。一个曾被 Pi 公开拒绝的协议进入核心,一套反复打磨的长时 Agent 框架同时亮相,标志着 Pi 开始从终端编程 Agent 向完整的 Agent 基础设施延伸。
对开发者来说,Pi Durable 最直观的价值是省掉大量重复代码。过去在 Pi 上构建个人助理、Slack Bot 或其他 Agent 应用,开发者需要自己设计数据库保存消息,再处理 Agent 的启动、任务调度、进程崩溃和状态恢复。有开发者估计,Pi Durable 可以直接替代自己一半的代码,因为这些外围细节都由框架接管。
这也解释了为什么有人认为,Pi Durable 会成为许多 Agent 工作流和应用的底座。过去每家公司都在重复实现对话记录、任务持久化、故障恢复和会话分叉,Pi Durable 正好填补了这个空缺。它会保存用户消息、模型回复、工具执行结果和任务状态;进程崩溃后,Agent 可以从中断的位置继续。能够安全重放的操作会重新执行,可能产生重复副作用的操作则不会贸然重跑。
Mario Zechner 对它的概括很简单:Agent 启动、调用工具,进程突然挂掉;重新启动后,它应该准确地从原处继续,不需要人再次输入“继续”,工具结果和流式输出也不能丢失。Armin Ronacher 更关注它背后的可靠性:模型本身已经足够不可预测,当 Agent 开始脱离人的实时监控,外层的任务编排和故障恢复至少应该稳定、可以理解。
另一项引发争议的变化来自 MCP。
过去一年,Pi 创始人 Mario Zechner 和 Flask 创始人 Armin Ronacher 一直是 MCP 最直言不讳的批评者。Pi 官网甚至曾经自豪地写着“不支持 MCP”。他们公开批评 MCP 臃肿、浪费 Token,并认为 Agent 使用 Bash、CLI 工具和代码往往更加高效。
如今,模型已经接受了更多与 MCP 有关的训练,MCP Server 和协议也逐渐成熟,Pi 最终决定正式接入。但它没有把所有工具名称、参数和说明一次性塞进上下文,而是通过工具搜索和渐进式披露按需加载。
与 MCP 一起进入稳定版的 Code Mode,则允许 Agent 在 QuickJS 沙箱中编写并运行一段 JavaScript 程序。它可以并行调用工具、过滤数据、去重和计算,最后只把真正有用的结果送回模型,大量中间数据都会留在沙箱中,由此降低 Token 消耗、运行成本和上下文负担。
Code Mode 还有一个很有意思的能力:它可以直接在 JavaScript 循环内部调用 System 1 模型,例如 Jev。假设 Pi 通过 MCP 获取了 200 条 GitHub 评论,Code Mode 可以逐条交给 Jev 判断用户是否不满、问题是否紧急、应该归入哪个类别。GPT 或 Claude 最终只需看到经过分类和汇总的结果。MCP 负责获取数据,Code Mode 负责编排和处理,Jev 承担大量快速判断,前沿模型专注于高层推理。
但一些 Pi 用户并不高兴。有人评论:“所以 Pi 现在也开始堆积垃圾了。”这句话代表了极简主义阵营的担忧:随着 MCP、Code Mode 和更多能力进入核心,Pi 会不会慢慢变成自己过去试图避免的那种臃肿 Harness?
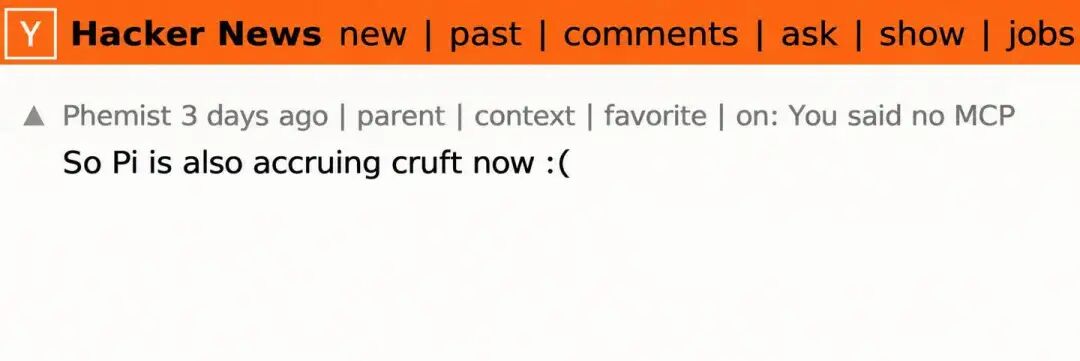
Armin 回应称,Pi 默认加载的内容没有比以前增加。Code Mode 也并非“绕了一圈的 Bash”:Bash 运行 Shell 工具,Code Mode 允许模型直接在 Harness 内部搜索、组合和编排工具。Pi 接受了 MCP 的生态,同时仍在控制它给上下文带来的负担。
有意思的是,Pi 团队一边让 Agent 使用更多工具、运行更长时间,一边依然不愿把所有工作放心地交给它。Mario 坦言,Agent 可以修复很多小问题,一旦涉及设计和架构,它经常只会在局部堆叠代码,“往你的代码库里拉一坨屎,让情况变得更糟”。
当 Agent 终于可以跨越崩溃,连续运行数小时甚至数天,新的问题也随之出现:它不会轻易停下来了,但谁来保证它没有一路把代码库修成屎山?
近日,Mario Zechner 和 Armin Ronacher 在一档播客中详细谈到了 Pi Durable 的设计、AI 编程的能力边界,以及 Pi 接下来为什么不想只做编程 Agent。InfoQ 翻译并整理了这场对话,以下为经编辑的完整内容。
太长不看版
Q:为什么不让 Coding Agent 修 bug?
Armin:因为它几乎不可能在解决问题时不动代码。你越信任全自动流程,代码库就越会随着每一次 bug fix 自然生长。
Q:AI 写的代码到底能不能用?
Mario:看层次。Pi 的 TUI 库里大量东西就是纯 slop,我到今天没看过 markdown 组件和 text 组件的哪怕一行代码,我不在乎,只要测试通过、渲染正确就行。但一旦涉及设计或架构,还是得靠人,因为 Agent 只会在代码库里“就地拉一坨”,把事情变得更糟。
Q:模型架构能力到底有没有进步?
Armin:没有,甚至可能退步了。它们输出的东西越来越复杂,说话方式越来越怪,满嘴同义词词典里翻出来的技术术语。
Q:为什么架构这件事模型学不会?
Mario:因为架构是编程里唯一没有被编码成文本、因而 LLM 学不到的部分。你可以轻松为网络安全、建网站、做前端搭训练数据,但“构建”这个过程本身,也就是设计和架构一个东西的过程,没有训练数据。
Q:那什么任务模型能做得特别好?
Mario:有 Oracle 的、二元的、能被 fuzz 的。如果你有一个 Oracle 能告诉 LLM 它做的是对是错,那你基本上就赢了。Bun 的 Rust 重写就是靠这个,让测试套件跑起来就行。
Q:Pi Durable 是啥?
Mario:Agent 在进程里启动,调用工具,进程挂了,重启,从断点精确继续。但 Pi Durable 不做事件溯源,用的是“意图、执行、结果”的效果三明治,加上版本化文档存储应用状态。
Q:个人 Agent 这事靠谱吗?
Armin:数百万人在用 Grok Bot 之类的东西,把所有东西都登录到机器上,我觉得那是一场灾难,所有这些公司都面临一场灾难。
Q:Earendil 接下来想做什么?
Armin:不想成为一家 Coding Agent 公司。两条线:一是做产品,让非工程师也能找到乐趣;二是做基础设施,让每个人都能构建自己的 Agent。
Q:Pi 的未来方向是什么?
Mario:我最近在手机上搞 PIM(Pi Mobile)。不再是“我和 Clanker”,而是很多 Clanker 在很多机器上,和很多人对话。
Agent 会修 Bug,也会往代码库里“拉一坨屎”
0xSero:为什么决定收编 Pi?
Armin:其实在收编 Pi 之前,我们试了很长一段时间想把 Mario 拉进来。在 OpenClaw 那波疯狂之后,机会来了,Mario 对这件事变得可以接受了。我们做的是“可塑软件(malleable software)”,而 Pi 是这方面早期实验的一个很好的版本,所以收编它就顺理成章了。
Mario:我是个白痴才会做 Pi,现在我被困在这儿种地了。
0xSero:你真的觉得自己被这个项目困住了吗?它这么成功,停掉又不合理。
Mario:我和 Armin 一样,也有很长的开源经历,只是我们来自不同领域。一旦我做出的开源项目有了用户,我就会像刚才说的那样,傻乎乎地一直替大家维护,哪怕他们一分钱都没付。有时候,那些负面反馈确实很消耗人。
不过,我现在的目标不是把 Pi 交出去,而是让更多人参与到 Pi 的开发中来,这样“必须我在场”的因子就会降低。到目前为止我们把这个目标实现得相当不错,即使我明天死了,Pi 依然会落在可靠的人手里。
0xSero:说到寻找贡献者,这方面有什么变化?越来越多人开始使用 AI。我知道你以前不喜欢别人随手糊出一堆 AI 代码。现在的体验怎么样?
Mario:很糟。换个方式讲,如果我没有从 2 月到大约 7 月把大部分时间都花在维护 Pi、检查和修复 Issue 上,Pi Durable 本来可以早得多发布。
问题在于,Agent 目前还帮不上你修 issue 的忙,至少对我的项目来说是这样。我缺乏信任,没法让 Agent 去判断哪个被报上来的 issue 真的值得我们花时间、需要修。所以最起码,我还是得亲自过一遍所有提交上来的 issue。
Agent 能不能修 Issue?当然能。关键在于它修得好不好。很多问题确实可以交给 Agent,尤其是很小的问题。但只要涉及设计或架构,仍然需要人参与,因为 Agent 往往只会在代码库的局部拉一坨屎,让情况变得更糟。对吧,Armin?
Armin:Agent 的问题还在于,它肯定会解决眼前的问题,但几乎不可能在不增加代码的情况下修好它。这其实很奇怪,因为很多问题修完后,代码库的净代码量本来不应该增加。
当然,这话从我嘴里说出来也很讽刺,因为我经常提交一次改 200 个文件、增加 2 万行代码的 PR,简直吓人。我自己也是滥用“机器仔”(clanker,对 AI 的戏称)的受害者。但软件不应该这样发展。尤其是一个完全自动化维护的代码库,几乎必然会随着每次修 Bug 不断膨胀。
AI 垃圾代码何时可接受
0xSero:DHH 已经彻底投身于这种“AI 糊代码”的工作方式了。我管我自己的工作就叫“slop operations”,因为我基本上什么事都用模型。某种程度上我确实觉得自己比以前笨多了,但另一方面,效率又非常高。如果你的工作不是要造一个会被几百万人复制、使用的东西,我觉得随便糊个脚本出来没什么坏处。比如我最近在做的,就是给特定的硬件组合创建 Docker 容器,让模型在某种随机的 VRAM、RAM 配置上跑到最优。这招一直很好用,设计、架构没那么重要,只要结果能跑、能做它该做的事就行。但你们没有那种特权,你们做的是要被几百万人用的东西。
Mario:我们当然也有。Pi 里面很多东西都是纯粹糊出来的。区别只在于,你在哪一层让人介入,在哪一层相信 Agent 能产出可用的东西,并且不在乎它具体怎样实现。
举个例子,Pi 的 TUI 库,最初的设计是我 2025 年初为另一个项目手写的。那个设计相当稳健、极简,我知道它大概率能扛住真实世界的接触,即便不完美,也够用。但后来我真正开始搭 Pi 的时候,我没有进去说“给我写个 markdown 组件、写个 text 组件、写个 editor 组件”,我直接告诉 Agent:这是 API,对着这个 API 写,把这些组件全给我搭出来。我根本不在乎它们长什么样,只要能跑,并且有一堆测试保证渲染正确就行,其余的我不关心。
到今天为止,我没看过 markdown 组件或 text 组件的哪怕一行代码。我不在乎,这不重要。我唯一在乎的时候,是性能下降了。而那时候,Agent 很擅长识别出一堆问题,但它非常不擅长给出一个泛化的解决方案。它会进去局部修一个东西,让那一个边缘场景的性能变好,但它不会从大局思考,不会去识别架构本身导致整体变慢、并进而催生这个慢的边缘场景的根本问题。我觉得自己目前还有价值,大概就体现在这里。
0xSero:我记得你的流程,比如创建接口、把玩 API、试图先对你要构建的东西建立感觉。这个流程变了吗?
Mario:没有。
0xSero:模型整体上做事情的能力变强了很多,但在架构层面还是乱糟糟的没进步,你有没有注意到什么不一样的地方?
Armin:我有时甚至觉得它们变差了。更准确地说,它们在架构方面可能确实差了一点。最终结果之所以变差,也可能是因为我们给了模型更多控制权。几乎每次新模型发布,我都会拿它做点东西,而我对它们独立完成工作的结果越来越不满意,主要原因可能是我比以前更信任它们了。
模型本身或许仍在进步,但把我的预期和使用方式一起算进去,净结果反而下降了。我每次都会让模型用 C 写一个游戏,因为我以前很喜欢写 C,这算是我的固定测试。我感觉它们越来越差。也可能是我自己投入的注意力减少了,但至少可以肯定,结果没有明显变好。
0xSero:不是说它们构建东西的方式,而是它们跟我们沟通的方式变得更怪了:说话的方式越来越复杂,用了多得多的技术术语,会在回复里钻进各种奇怪的小众技术话题。
Armin:不过 Opus 确实变好了。
两个 Codex 账号破解了我的软件
Mario:Fable 5 点几的版本,还有之前那版 Opus,就因为它们说话的方式,我一度完全停用,它每个词都像是从同义词词典里新翻出来的一样,实在受不了,Astra 也很糟。但我对 Sol 6.1 和 Opus 5.5 挺满意的,它们把那个调调又降下来了,现在就像正常的机器。
有一个提升我确实感受到了,是在网络安全方面。去年,我用 Clanker 来加固一些桌面端的软件,当时它根本不行,完全理解不了发生了什么。
今年,一个中国人用两个 Codex 账号破解了这款软件。随后,我使用一个“逆向机器仔”重放攻击,弄清楚他是怎样突破软件防御的。整个过程极其惊人。世界上没有哪个人工逆向工程师能深入到那个程度,更别说在那么短的时间里完成,简直疯狂。
稍微讲得底层一点:这是一套 JVM 系统。JVM 上面有 Java 字节码,字节码最终会通过即时编译器编译成机器码。我把这些都保护得很好,别人没法简单地提取字节码或者注入自己的字节码。但在 native 那一侧有一个很小的逃逸路径,没有任何人类能够识别并利用它。而那个 Clanker 直接进去,把 JVM 内部的 native 结构给逆向了,开始直接读进程内存,把它映射回正确版本的 JVM,识别出 native 内存里的哪个结构对应 Java 表示里的哪个部分。这就像科幻小说一样,太不可思议了。
Armin:我有一个小东西,我总拿出来展示,是一个 USB 芯片,中国的 CarPlay 适配器。它自己就搞明白了怎么解密本该保护新 root 镜像上传的小玩意儿,还在 Web 界面上找到了一个 CGI 文件,可以从那里绕过一些东西。我什么都没做,就是把它插上,让它跑起来。大概花了五百美元之后,整个东西就归我了,这真的非常厉害。
0xSero:我现在家里囤了一堆硬件,就用来跑这些模型,从最小的 Qwen 27B 一直到 DeepSeek 和 GLM,它们在处理这类事情上都变得非常强。我给了它们一个 Nintendo DS 的 ROM hack,一个 ROM 游戏,让它从零开始构建一个 Nintendo DS 模拟器。它可以参考 Dolphin 和其他东西,但必须用完全不同的方式写,它居然真的跑起来了。我发现每当任务是非常二元化的,要么完成要么没完成,它们最终都会把它搞定。
Agent 能重写 Bun,却学不会架构
Mario:如果你有一个 Oracle,能告诉 LLM 它做的是对是错,那你基本上就赢了。比如说 Bun,Bun 有大量的测试。我敢肯定它不是百分之百覆盖了所有需要测试的东西,但足以让 Jared 能够告诉一堆 Agent:我们按这个方式、那个方式来移植,我会在关键点上给你指方向。基本上你只需要让测试套件在你的 Rust 重写版 Bun 里跑起来就行,这套方法效果非常好。
刚才说的模拟器那件事,其实我也做过类似的。各种系统都有海量的模拟器,而且这些东西全都在训练数据里,多到疯狂,包括那些系统的规格说明。所以这也是一个非常适合用 Oracle 来测试的领域,训练数据里塞满了相关信息。
Armin:而且它也很容易被模糊测试(fuzz test),我觉得任何可以被 fuzz 的东西都适用。我最近就拿了一堆各种格式的示例文件,TOML、CBOR、MessagePack、JSON……然后直接说:这是我的序列化库,把所有格式都给我实现出来。它最终确实做完了。然后我说:好,现在给我往死里 fuzz。结果它找出了一大堆问题。虽然以前 fuzz 库也不算太难,但现在这简直是理所当然的操作。你只要让它一直跑,跑到你花好几个小时才能找到下一个回归为止。
Mario:我觉得这是一个非常棒的用例。尤其是做 fuzzing 的时候,你可能已经有了一些自动化的 fuzz 生成,但在它之上再加一个 LLM,它还能推理出你的 fuzz 生成器没有覆盖到的额外情况。这就像是给所有测试工作加了火箭燃料,非常惊艳,非常有用。
但接下来就说到我们之前提到的那些东西了,比如架构。我记得 DHH 说过类似的话,大意是:你以为你很特别,因为你会架构设计?想清楚吧,模型也会把那个干掉。我觉得 DHH 根本没理解机器学习到底在做什么。
Armin:如果你跟模型讨论一个问题的正确架构是什么,它们其实挺擅长的。但它们给出的那条“最可能解决问题”的轨迹,最终会落到权重空间里完全不同的另一个地方去。
Mario:这一切,基本都能用训练数据解释清楚。我可以很轻松地为网络安全类任务搭建训练数据,为“构建一个已经存在、有标准答案的东西”搭建训练数据,为建网站、做前端、做任何你想要的东西搭建训练数据。
但没有训练数据的,是“构建”这个过程本身,是设计和架构一个东西的过程。这是编程里唯一一个通常不会被编码成文本形式、因而 LLM 学不到的部分。正是构建某样东西的架构的这个过程,让我们卡在了这里。
Armin:这就是为什么我们现在要把所有会议都录下来,以后可以两百万美元卖给 OpenAI。
0xSero:我在德国遇到一个人,他有一家机器人公司,他们的主营业务其实是卖训练数据。他们付钱让人戴上帽子、套上机械臂之类的东西去干活,然后把采集到的数据卖给那些实验室,这是门非常好的生意。但我确信,一切都藏在这些轨迹里。所以如果你在跟模型讨论架构,那些对话轨迹就应该被赋予更高的权重。但问题是怎么分配?你怎么决定哪些数据该获得更高的权重?
Armin:这里缺少明确的信号。比如 Pi Durable 经历了多少轮迭代?
Mario:八轮。
Armin:对,它经历了很多轮迭代。那么训练系统怎么知道,那些对话中的哪一次最终真的变成了我们发布的那个版本?这理论上是可能的,你可以训练它,给它打标签,有一些方法可以做到,但这是一个显著更难的问题,而且这类对话的数量本身就少得多。
Mario:我倾向于认为这基本上就是一个分类问题。你拿到一堆轨迹,不管你的零数据保留政策怎么说,OpenAI、Anthropic、DeepSeek,手里都有海量的轨迹,现在你想从中挑出真正高价值、高质量的那些。
怎么做?不可能靠人工。他们确实也会手动标注一些,但那不可扩展。所以退而求其次的方案就是用一个机器学习模型把轨迹分类成高质量和低质量。
0xSero:我觉得他们有机会做一件事:就像你在用 Claude Code 时,它会自动在 GitHub 仓库和 commit 里打标签。所以如果你不仅构建对话轨迹,还构建仓库历史本身,那可能是个好办法。因为你可以直接映射,哪些仓库还在被用户使用,哪些 PR 被合进去了,以及这些代码还有多大比例仍然存活。
Mario:但问题是这样,他们拿到的数据量,你会以为他们能做点复杂的事情。但据我从内部消息听到的,他们目前还没做什么复杂的事。
Armin:我觉得一旦他们搞定了这个,那就跟 RSI(递归自我改进)有关了。模型会去做那些复杂的事情,因为突然之间就变容易了。
这其实也是我认为情况可能变好的原因:现在人类做这件事非常烦,但如果模型认为这值得投入,那就会推动它们前进,也许因为自我改进,我们就能到达那一步。
0xSero:用最新的 Opus,我给它很多推理任务,它每天都在取得突破。它变得非常擅长在硬件到软件层之间导航,GPT 在这方面完全不行。我不知道他们的模型是不是更擅长数学和某些东西,但我确实在那里看到了突破。不过那也不能真正用来构建应用,它只是一种爬坡的技能,有点令人失望。
Pi Durable 如何让 Agent 崩了接着跑?
0xSero:我想聊聊 Pi Durable。你们为什么使用“Durable”这个词?它背后的逻辑是什么?
Mario:我试着用五句话讲完:Agent 在一个进程里启动 → Agent 调用工具 → 进程挂了 → 你要重启进程 → ️Agent 从它中断的地方精确地继续,这就是持久性(durability)。不需要你手动输入“继续”,不需要工具结果或助手流被丢掉,你的应用状态也被持久化下来,并且能被可靠地恢复。这就是“Durability”,也就是持久执行能力。
我们需要它,是因为任何长时间运行的 Agent——比如各种“Claw”——都必须具备这种能力。
Pi Durable 解决的另一个问题是,过去的 Pi 会把整段对话,或者说 Pi 中的整棵对话树,都加载进内存。如果你有一个在 Slack 中运行了很多年的 Bot,完整对话轨迹里可能有数不清的消息,这种办法显然无法继续工作。这些内容不一定全部发送给 LLM,但系统仍然需要保留完整历史。
Pi Durable 就是用来处理这些问题的。它还可以轻松部署到 Vercel、Cloudflare Durable Objects、E2B、你的笔记本电脑,甚至我的手机上,所以很值得探索。
0xSero:能否再介绍一下它的架构?我今天看了仓库,也让一个 Agent 给我解释过。我对可恢复性的理解是:每个动作都要提交并写入文件,它才会成为正式记录。如果中间掉线,系统还有一个事件队列,事件都存在队列里。我的理解对吗?
Mario:那套方案我们没有采用。我们没有使用事件溯源,而很多其他系统采用的正是这种方式,因为事件溯源会带来很多问题。
Durability 的基本难题是:系统正在执行某件事,而它可能在执行开始前、执行过程中或执行结束后崩溃。这里被执行的事情通常叫作“效应”(effect)。
很多持久执行方案会这样做:在真正执行前,先向存储系统写入一条记录,表示“我准备使用这些参数执行这件事”。如果写完记录后进程崩溃,我就知道所有输入已经完成求值和验证,随时可以执行。进程重启后查看数据库,发现这里有一个等待执行的操作,而且尚未真正运行,就可以接着运行。这是“效应三明治”的第一层。
第二种情况发生在效应正在运行时。怎样恢复,要看具体执行的内容。比如外部系统 GitHub Actions,你发消息“构建这个 commit、跑这个 action”,然后进程死了;重启后你不一定知道它到底跑没跑,因为还没保存结果。GitHub 这种情况好办:你可以说“我即将调度一次运行”,在真正运行前拿到 key/ID,并把它存下来。执行时说“用这个 ID 执行”。如果已经在跑,GitHub 会告诉你,你等结果即可;如果还没跑,它就用这个 ID 启动。这就是所谓的幂等(idempotency),这样就能扛住执行中的崩溃。
最后一步:效果完成、拿到结果后,把结果存下来。于是“意图 → 执行效果 → 存储结果”的三明治就完成了。之后不用再想它,中间信息都可以扔掉,除非要留 trace 做日志或审计。重要的是,你有了想要的结果;而且不管进程死在这个三明治的哪个位置,最终都要到达那里。
当然有复杂情况。比如效果是删除磁盘文件,通常没法撤销,除非有 Git;刷信用卡,我可不想刷两次。所以你要跑的所有效果,某种意义上都得能和这套持久性系统组合。
回到 Pi 的 durable 架构。基本上,Harness 里发生的每件事都是一个任务,也就是效应三明治。
例如,我想生成一条 LLM 回复,就会创建一个任务:准备请求,收集上下文窗口、参数、思考等级和模型等信息,保存“即将执行这次调用”的记录,随后真正调用 LLM,这一步就是效应;拿到回答后,再持久保存回答。
工具调用也一样。系统从 LLM 得到工具调用,随后建立一个任务来执行它。
0xSero:这些任务应该可以嵌套吧?
Mario:对。一个任务可以派生出另一个任务,并等它结束。整件事的魔法就这么多。
另一面是应用状态,我们搭了一个类似 MongoDB 的文档存储,存 JSON 对象,可以自由修改。特殊之处是:我有一份文档,在转录记录的时间零点,它有某个值,比如一个待办清单。然后你和 Agent 协作,用户、助手、工具调用不断改动它,于是文档在转录记录的对应位置被更新。如果我想回到过去,我在那个时间点想要的是哪个版本的文档?看情况。有时我想要当时的旧待办清单;有时我只想要最新版本,不管我处在什么位置。所以我们的文档存储允许这两种文档与转录记录中任意位置关联。有了这个,就能存应用状态。
比如,如果我有一个可以画画的画布,就是一份文档,它只存一个笔画列表,我可以重放它来画出那幅画。我和 Agent 对话,同时在画布上画,然后说“把这个新画给 Agent 看”,文档就和 Agent 一起变化、演进。如果我回到过去,为了让 Agent 看到,我想要那幅画的旧版本。
仅靠版本化文档和任务这两个基本原语,就能做一大堆事情。基本上,这就是 Pi Durable。
0xSero:所以你有一个版本化文档,随着你在会话中推进,那份文档被更新,每一次更新都是一个版本,那你是存储版本之间的差异吗?
Mario:对。有一种东西叫 JSON Patch,是一个 RFC。它基本上定义了对 JSON 对象的操作,“把这个字段设成这个值”、“创建一个数组”、“把那个数组的元素设成这个值”诸如此类。我发现它在这个用例上是有所欠缺的,所以我们搞了一个类似但针对 Agent 场景做过优化的东西。
Armin:React 整个体系都是围绕状态一、状态二展开的,核心问题就是,你怎么在不可变数据结构上表达状态变化?可不知怎么的,这个问题实际上从来没有真正显著地变好过。
Mario:有像 Immer 这样的东西,它基本上大部分时候能把它做对。
Armin:但也就那样,它从来不是一个大家都达成共识、被充分理解的标准,用来表达嵌套数据结构的结构化更新。然后你还有 Automerge,那是 Ink & Switch 那帮人做的项目,它试图给你某种 Agent 对象,记录你对它做的所有更改,然后在背后生成表达这个更改所需的 CRDT。但它在 JavaScript 上的映射方式基本上是个巨大的 hack,漏洞太多了。
Mario:这就是软件开发本身的问题。在 Pi Durable 里显然也有类似的坑,我们用的也是 Proxy 方案。
基本上就是我对存储说,把这个文档给我,你拿到一个 JavaScript 对象,你可以像操作任何其他 JavaScript 对象一样操作它。我可以写 object.x = 10,然后这个操作会被自动记录成一条操作,再被应用到真实对象上,回放时用来重建状态。这也依赖 Proxy,而它基本上就是个很慢的 hack。但对于我们在 Agent Harness 里需要做的事情来说,它工作得非常好。
构建持久化 Agent Harness
0xSero:你们为什么决定要做持久化问题,而不是其他的 Agent Harness 毛病?
Mario:这方面确实没什么现成的东西。显然有 Hermes、OpenClaw 以及其他各种 claw,甚至 AMP 也有所谓的 orb,你可以转移会话,让它继续跑。它们都必须以某种方式,专门为 Agent Harness 解决持久化问题。但这些都不是通用方案,我没法直接拿来构建下一个 Earendil 项目、下一个开源产品,或 Shopify 内部某个 swarm 之类的 Agent。很难从货架上拿下来,改造成自己的东西。
我想做的是一个非常小的基础原语。Pi Durable 大约只有 1.2 万行代码,同时要足够通用、足够强大,开箱就能提供 Agent 所需的一切,包括上下文压缩等能力。
Armin:我觉得这里还有一点很重要,你显然完全不需要 Pi Durable,完全可以自己造。
但我们有多个项目,在那些项目里我们构建 Agent,真正让它们以你信任的方式工作,让它们有点可靠性,能不断从失败中恢复。但最重要的是,即使没有人盯着,它们也能持续恢复。让它本质上可靠,让你觉得可以在此基础上构建东西,这件事本身就是大量的工作。而且不是按最终提供的代码行数来算,而是核心设计要真正能跑通。
随着 Agent 变得越来越有编排性、越来越独立于观察它们的人类运行,你至少会希望它的编排是可理解的。毕竟 Agent 本身已经够不可靠了,里面有个 LLM,想干嘛干嘛,像个有机体。所以至少编排层面应该是可理解的,应该带来某种程度的秩序和理性。
0xSero:我正试着少用笔记本电脑,所以希望会话能在不同机器间流转。我让 GLM 用 Pi 做了个叫 parcels 的东西。它自己想出的方案是:把会话 JSON 从一台机器复制到另一台,再重启,因为环境变量都在里面。应该够用。但我希望它能自动运行,并同步到我所有设备。
那接下来呢?你们现在想做什么?是在稳定这个东西吗?
Mario:主要是内部吃狗粮。我们会用它构建大量东西,再决定哪些对外发布。Armin,你来讲讲?
Armin:我觉得可以把 Earendil 这家公司分成两条线来看。其中一条是我们已经构建了一些非 Coding Agent 产品,理想情况下长期来看,连非工程师也能从中找到乐趣。与此同时,我们也在构建基础设施层面的东西,理想情况下人们能用来构建自己的 Agent。
在 Pi 之前,我们做过一个叫 Lefos 的产品,现在你会管它叫 Personal Agent,但它其实是一个坐在纯文本通信界面后面的 Agent,在我们的场景里是邮件。我们真的很喜欢这个概念:有一个小小的实体陪着你,帮你解决一些问题,但它不会把自己强加到外部各方身上。不是那种“嘿,帮我订一下,我有个预约”,然后它跑去用 AI 垃圾信息骚扰某个真人;而是一个有用的、陪着你的助手。这个领域显然有很多东西,但同时我们真的不喜欢这个领域里的任何产品,它们很快就变成了一堆庞大疯狂的装置。
0xSero:而且我觉得这也极其危险。本来就已经有很多人在试图黑你了,然后又有数百万人在用 Grok Bot 之类的东西,把所有东西都登录到机器上,我觉得那是一场灾难。
Mario:我看得很开心,其实就在我们开始聊之前五分钟,我在 Twitter 上看到一个帖子,一个家伙说:"我的 Grok Bot 把我所有的个人财务信息发到了公司 Slack 上,所有人都能看见。"然后 Elon 说,如果真有这种事发生,他会补偿他。
0xSero:我是喜欢个人 Agent 的。我在家里跑 DeepSeek,以前用 Codex 干这个,但速度简直惨不忍睹。所以我现在本地跑 DeepSeek,这些开放权重模型已经足够好了,它们能扫描我十五个不同的邮箱,把内容整理进 Linear,然后处理掉。但它还是很乱,非常不确定。
Jev 与 Pi 中的 MCP
0xSero:你们怎么看 Jev ?
Armin:当我不做 MCP 负责人时,我会做 Jev 负责人。
Mario:Armin 如果能娶 Jev 的话一定会娶它,他非常爱 Jev。
0xSero:把两者合并,让一个给另一个做分类,我觉得这非常合理,尤其是在处理大量垃圾内容的时候,比如邮件。
Armin:这其实就是 MCP 最终落地到 Pi 里的原因。
它跟 MCP 本身完全没关系,是因为我需要给 Jev 做代码模式。从那里到 MCP,也就五分钟的事。但要让 Jev 工作,或者说让任何分类模型工作,它需要另一个系统为它生成一个定制的 Harness 来驱动这个东西。
但这里有个更本质的问题,很多任务之所以被卡住,是因为它们从根上就是“软性”任务,你必须用 LLM,可它们又太慢了。
当然,这也不是什么新东西。但 Jev 真正证明了一件事:如果你把它训练得足够好,让它成为一个通用的单次分类器,那它就有产品市场契合度,然后整个事情就滚起来了。说来有点意外,但我很喜欢,突然之间,除了图像生成和 LLM 之外,又出现了另一类模型,人们在认真琢磨它。
Mario:对,而且它真的有用。我自己对图像模型是零用途,但 Jev 我可以用在无数地方。
0xSero:你们似乎挺喜欢 Amp,为什么?你们是怎么看待不同 Harness 的?你们的方法是什么?
Mario:我们处理 Codex 那套东西的时候,如果后端不工作,我们就 clone 一份 openai/codex 仓库,看看他们为了让自己的后端跑起来到底往里塞了些什么东西。我们看别的 Harness,差不多也就到这个程度。Amp 不太一样,因为它比 Pi 出现得早多了。OpenCode 也是,我记得大概是 2025 年初就在了。我现在不太看 OpenCode 了,但我看过他们的 V2,挺有意思的,他们现在也在跟持久性较劲。
但 Amp 我从来没用过,我就是很喜欢那个团队。我觉得他们对软件工程的未来也有自己的愿景,他们不确定这个愿景对不对,但他们愿意押上全部身家去赌。而且他们执行力很强,我认为 Orbs 做得相当不错。今年早些时候我在慕尼黑见过他们,他们给我演示了 Orbs,我也跟团队其他人待了一段时间,是一群很好的人,懂行,而且不废话。
0xSero:我一直在各种 Harness 之间跳来跳去,我觉得我工作的一部分就是把这些东西分享给别人。但 Pi 真的很突出,如果我要做任何东西,我会用 Pi,因为一来它开源,二来它对我来说是真的可以理解的。
Mario:不过我觉得你也为 OMP (Oh My Pi)做了很多工作。OMP 就是 Can Bölük 基于 Pi 开发的那个分支,对吧?
0xSero:对。如果你显存够多,它对本地模型真的很好,因为他们做了那个 advisor 机制。你设置一个 Opus 之类的模型,它会读取整个对话,当模型开始绕圈或者偏离任务的时候,它就插进去,像是以用户身份注入一条消息,告诉它“这是范围,这是你需要换个做法的地方”。然后还有 Sub Agent 那些东西,我觉得它把 Claude Code 那种 Opus 和 Fable 做的 fanning out 也做得很好。还有登录,能直接 `/connect` 进去连上我自己的东西,这非常好。它确实变好了,但它吃 token 太厉害了,这是个问题,而且它的 system prompt 巨大,这是另一个问题。DeepSeek Harness 我最近很喜欢,不知道你有没有花时间看过,它非常惊艳。
Mario:我确实读了它的源码,插件架构特别有意思。虽然就实际的插件机制而言,他们承诺的比能做到的多,但他们的思路非常聪明。那也是我真正去看过的一个 Harness,因为显然我们想让 Pi 进化,看到另一个 Harness 也走“这个东西本身必须可自我修改”的路线,感觉很好。
我们现在在 Claude Code 里也看到这个了,特别好笑。当 Boris 说“天哪,这些 mod 太棒了,我们怎么能不让 Claude 去修改 Claude Code 本身呢?”去你的吧。
0xSero:我觉得他们的 Harness 变好了一点,去年我不太喜欢它,但它现在更稳定了。不过它还是有太多 bug,随机报错,不同的 session 还会互相泄漏,这是它的问题之一。
Armin:我确实看过 DeepSeek 的 Harness。我们开始研究插件架构的时候,那里面确实有值得看的东西。我一般不太看别人在做什么,因为那是个巨大的干扰。而且你也不一定知道他们那么做是因为真在解决一个问题,还是只是因为“代码是免费的”,顺手做了个实验。
我做 MCP 那件事的时候,基本上是把所有其他大型 Harness 里跟 MCP 相关的东西都交叉比对了一遍,就为了搞清楚值不值得做。因为你会拿到一张人们想要的功能清单,他们真的很想要这些,那我就去看看别人都在做什么。
Mario:我特别讨厌 elicitations。
Armin:我去年用 Amp 用得挺多的,后来基本停了,但我又看了一遍 Orbs。我确实喜欢 Orbs 的理念,但不知怎么的,我对网页界面没那么粘。我会用 Claude 和 Codex 的手机 app,但我从来不用桌面 app。至于终端,我其实不觉得它们特别好。我还没找到那个完美的体验。
0xSero:我之所以喜欢 DeepSeek,就是它看起来像是桌面 app 里的 Pi。实际的用户体验非常极简、非常干净,而且因为它是作为 web 进程启动的,你可以直接放到 tailnet 上,然后从手机或者另一台机器访问,我不用去做那些奇怪的“连接你的设备”之类的操作,那个一直很烦人。
Pi 的未来方向
0xSero:你们有没有想过做一个 app,或者一个网页界面?
Mario:有,我过去几天就在手机上瞎搞,做了一个主要应该在手机上跑的东西。我叫它 PIM,Pi Mobile。它不是我要开源出去的产品,至少目前不是这个计划。但我们肯定在探索这个方向,作为 Pi 本身演进的一部分。我觉得 Pi 是“可自我修改的 Agentic 软件”的一个初步概念验证,它跑通了。现在我们需要振作起来,把它演进到一个方向,它变得不再是“我和 Clanker”,而是很多 Clanker 在很多机器上,和很多人对话。应该可以让我随意跳转、重新连接 Agent 和人类,按照我想要的任何配置去协作。我觉得这就是 Pi 应该去的方向。
做 PIM 这个东西,我其实就是想确保 Pi Durable 真的能用,算是 dogfooding。我想替换掉 Claude for Android,因为我之前也是 Claude for Android 的用户,现在它被完全替代了,因为 PIM 完全在我的手机上运行,除了 LLM 之外,其他所有东西都跑在手机上,我太喜欢这个了。它也可以直接连到我其他任何一台机器作为执行环境,所以它会连到我的 Hetzner,然后在那儿帮我做 sysadmin,而“大脑”跑在手机上。我已经实现了愿景里的那一部分。下一步就是搞清楚怎么把它变成 Pi 的演进方向,配上一个插件系统。而且我完全坦白,DeepSeek 在这件事上绝对是个灵感来源,不一定是技术层面,而是概念层面。
Armin:但 web 的插件系统里有惊人程度的复杂性,而且大部分其实是因为一些很蠢的原因,比如你怎么让它安全?因为你某种程度上被抽象地约束住了,几乎就像是“把它做安全”这件事本身会让体验变得很烂。所以问题就变成:你怎么在整件事里找到一个好的平衡?
0xSero:对,安全那部分对我来说一直挺难受的。我前几天注意到,我的一个 Clanker 想跟另一台设备共享文件,结果它直接把我整个文件系统挂到了公网上,挂了大概一天,我明明有 WireGuard 之类的防护。
Armin:但目标是多个人能一起体验同一个会话,在一个我们的 Harness 可以扩展的操作环境里。但这就意味着某个人会比其他人更被信任,你不想落到那种“必须完全信任你所连接会话的那个人”的境地,对吧?
0xSero:那 Docker 呢?这看起来像个 Docker 类型的问题,你有一个创建出来的东西,它就像个镜像。
Armin:对,但你先忽略 Docker 那部分,那几乎是小菜一碟。你怎么保护服务器,这好办。但你怎么保护 web 界面?因为现在你连到我的 web 界面,弹出来的 UI 里有链接,如果我去点它……太容易了。如果我们最终落在一个共享空间里,我们都有账号,Clanker 调出来某个用户界面,那玩意儿字面上就是 XSS,用来偷我的 cookie 或者别的什么。这是可以解决的,但解决起来很烦人。而且实际上很多解决方案都涉及 iframe,而 iframe 对安全、对用户体验都很烂。所以真正做一个既可扩展又安全的 web 界面,比看起来难得多。反倒是服务器上把 Docker 沙箱化,那才是简单的部分。
0xSero:你听说过 IPFS 吗?
Mario:来自 web3 社区的那个,你在 web 上有一个分布式的文件系统账本。我觉得它并没有真正解决信息外泄的问题。它可能是个有趣的持久化、可复制存储数据的方式,但说实话,我看不出它对安全有多大贡献。
0xSero:它主要解决的是,如果 Clanker 在构建什么东西,它得把东西放到一个不会关联回你自己的地方。比如你和我一起做某件事,我们想要一个中立空间,放在那儿,我们都能信任它不会被……
Armin:这对我们来说也是个大难题,我们只是在假装自己知道在聊什么。
让非开发者上手 Agent
0xSero:那你们最近对什么感到兴奋?
Mario:做不是 Coding Agent 的产品,以及把我们现有的这一个 Coding Agent 演进成我们现有社区真正会喜欢的形式。这是个挑战,我们已经看到了,光是发布 MCP 和代码模式支持,很多人就会因为你加了一个你之前说过不需要的功能而生气。但现在模型已经在这上面训练过了,MCP 服务器和标准也变好了,现在它基本上已经足够好,可以作为内置功能集成进来了,这就是我们的想法。但人们会生气,因为“你怎么能改变主意?”有新信息我就改变主意啊,又不是我在赶 MCP 的时髦,我们花了一年才加上对它的支持,而且是在经历了极其痛苦的反复权衡之后。
Armin:我觉得我对 AI 现在的状态挺满意的,我只是觉得围绕它的用户体验可以变得更好。所以真正会让我兴奋的,我觉得在社会层面上,如果这项技术真的能交付一些真正伟大的、有价值的东西,那就太好了。给我一个室温超导体,拜托。或者癌症药物,随便什么。
在纯技术层面上,我觉得我最希望看到的主要事情是,这股炒作能稍微平息下来,我们最终能用这项技术做出真正酷的软件,真正在一起协作去构建更好的软件,而不是 Photoshop 的垃圾 fork。
Mario:我给你们举个例子:PS5 在 PC 上的模拟,现在被 Clanker 解决了。这算是对社会的一种贡献,因为它有助于为未来保存 PS5 游戏。我喜欢这个,太棒了。
0xSero:对,我一直跟人说,现在一切都是 AI 在做 AI。这在加密领域也发生过,每一个牛熊市都是这样。牛市的时候,就不是建设的时候了,而是营销的时候、赚钱的时候。然后真正的建设者,他们会在熊市一来就激活,开始构建那些奇怪的东西,最终会爆火。我们现在就处在这个阶段。我觉得这极其疯狂、不正常,但我不认为它会持续下去。我真兴奋的是,我们怎么把一个从来没用过 Agent 的人带进来,让他们用上 Agent?因为如果我能让我妻子用上 Agent,让我孩子用上,很多事情就不再是问题了。
Mario:你就是想让家庭后勤被别人处理掉。我和 Armin 都有过类似的经历。我让我妻子接触了这个,她去年夏天用 Claude 做了一些语言学研究。我还让我当时四岁的孩子给我妻子写了一个游戏,作为她的生日礼物,诸如此类。这很酷,这就是我喜欢使用技术的方式。
而且上手引导这件事说得太对了,没人做任何事,这是最大的问题。每个人都给你一个聊天框和一个侧边栏,然后,祝你好运,自己搞明白吧。你是个秘书。来,用 AI 提高效率。
0xSero:是的,没有人愿意花力气去把一个人带进来。因为最主要的问题是,如果你不知道,你可以问,然后你就会知道了。而从“我不知道”到“我可以问”这个逻辑步骤,人们并不具备这个技能。这就像我学编程时学到的东西,你不应该问,你应该自己去搞清楚,如果搞不定再去问别人,别浪费时间。
访谈视频原链接:
https://www.youtube.com/watch?v=ja\_7AF54OtE
本文来自微信公众号“InfoQ”(ID:infoqchina),作者:Tina,36氪经授权发布。