数据的三大定律:价值从来不是数据本身固有的
先说一个我这两年反复遇到的场景。
一家企业花了大几百万做数据治理。标准建了、平台建了、历史数据也清洗了一轮。验收会上 PPT 很漂亮:数据完整率从 62% 提到 96%,一致率从 71% 提到 94%,还顺带拿了一个行业奖项。
半年后回访,业务部门的说法是:"数据还是不准,我们还是自己拉 Excel。"
问题出在哪?
如果只看质量指标,这个项目是成功的。但把视角挪一下你就会发现——那份干净的数据,躺在数仓第三层。业务部门要拿到它,得提工单、等排期、跨两个部门审批。等拿到手,那场促销早就结束了。
质量很高,距离很远,时间也过了。三个变量里,只有一个被认真对待过。
数据的价值,从来不是数据本身固有的属性。
它由质量、距离、时间三个变量共同决定。我管支配这三个变量的规则,叫数据的三大定律。
一、数据惯性定律:质量账只能算在源头
你有没有想过一件事:你手里正在处理的那份数据,早就不是当初的那份数据了。
给数据加上版本、加上年龄、加上生命周期,你会发现它会变老、会分裂、会被复制、会被改写。一份数据从诞生的那一刻起,只要开始流转,它就已经不是原来的它了。
这就是数据惯性定律:低质量的数据一旦进入流通环节,它产生的影响不可回溯,也无法避免。你后面再怎么清洗、再怎么建模,都只是在为前面那一次"偷懒"反复买单。
我常把数据质量这件事比作分娩。生的时候多花一点力气,生出一个健康的孩子,远比生出来之后再一点一点去弥补,要划算成千上万倍。
用公式说,质量变量Q ∈ [0, 1],它衡量的是数据"出生即健康"的程度。注意它的特性:源头污染是不可逆折损。它是一个只能往下走、很难往上抬的变量。
这条定律破掉的误区是:"事后能洗干净"。
典型症状很好认——同一个字段反复清洗,永远洗不干净;每次治理项目结束,半年后又回到原样。因为污染源没动,你只是在下游不断稀释。
行动指向:把治理动作前置到业务源头,而不是前置到入湖那一刻。字段在哪个系统里第一次被敲下来,治理就应该发生在那里。
二、数据互斥定律:通用性和价值,天生互斥
数据越集中越值钱?
恰恰相反——离业务越远,它就越不值钱。
数据每远离业务现场一层,价值就衰减一次。用公式写是V(d) = V₀ · e^(−λd):V₀ 是数据在业务现场产生那一瞬间的价值,d是距业务现场的层级数(业务系统 → 采集 → 清洗 → 建模 → 报表 → 决策),λ是语境衰减系数。
为什么会衰减?因为通用性和价值,天生互斥。
你把它抽得越干净、越通用,它赖以值钱的业务语境,就丢得越多。等到它被抽象到彻底脱离业务语境时,保留下来的是形态,流失掉的是意义。
这条定律有四条推论,每一条都能在企业里找到对应物。
推论一,中台悖论。数据中台为复用而生,但复用度最高的那一层,单点价值最低。这是它的设计目标决定的,不是实施不到位。
推论二,口径僵化。离业务越远的口径,越没人敢改,也越没人敢用。最后变成一份谁都能背、但谁都不信的数字。
推论三,成本放大。在下游补救数据质量的成本,等于在上游省下的成本乘以经过的环节数。这和第一条定律是同一件事的两面。
推论四,最后一公里。数据九成的价值,只产生在回到业务动作的最后那一公里。
行动指向:把指标定义权还给业务。不是让业务来评审 IT 的指标,是让业务自己定义、自己改、自己负责任。
三、数据的时间价值定律:两个黄金期,中间是断层带
数据越新越值钱?
错。它其实有两个黄金期。
公式是V(t) = A · e^(−αt) + B · (1 − e^(−βt)),两项相加,形成双峰。
第一个高峰在产生的那一刻——那时它还能改变结果。决策窗口一关,价值断崖式下跌,α 是业务节奏,节奏越快,衰减越猛。一个实时风控模型,如果算出结果时交易已经完成,它的准确率再高也没有意义。
第二个高峰在足够久之后——当你攒够足够长的历史,它就又能用来建模、归因、判断趋势,价值二次上升。β 是历史厚度,厚到什么程度能释放,取决于你要回答的问题。
麻烦的是中间那段。既不新鲜,也不够老——这就是价值的断层带。
多数企业的数仓里,80% 的存储成本,压在这段价值最低的数据上。
这是最常见、也最不容易被发现的一种浪费。
还有一条容易被忽略的推论,我管它叫连续性溢价:历史数据的价值在于"连续"。断掉一年的历史,损失远不止 1/N,因为规律推断直接失效——你没法用一份有缺口的序列去判断周期。
行动指向:分层存储不该只按"访问频率"设计,应该按时间价值曲线设计。另外三件事现在就能做:实时化投入先看决策窗口有多长,只有窗口以分钟计的业务才值得做秒级链路;归档策略要留一条低成本但可回热的复活通道;别为了省存储费删历史,那是最贵的一种省钱。
四、为什么必须是乘法:这是整套东西里最重要的一句
把三条定律合起来,数据的价值函数是这样的:
V = Q × D × T
展开写是V(d, t) = Q · V₀ · e^(−λd) · [A·e^(−αt) + B·(1−e^(−βt))]。
请注意中间那个符号:是乘号,不是加号。这一点至关重要。
如果是加法,你可以用一项的长板去补另一项的短板。但乘法不行。
质量再好,离业务太远,价值仍趋近于零——一份完美干净、却躺在数仓三层之外的表,没人用,价值就是零。距离再近,过了决策窗口,价值归零——实时算得再准,等你算出来,促销已经结束。既不脏也不远,但卡在断层带,价值最低——这条最隐蔽,也最烧钱。
由此得出一个不太舒服的推论:数据治理不能"单点突破"。
很多团队的失败正在这里。他们把质量治理做到了 90 分,但数据离业务三个层级,Q = 0.9,D = 0.1,乘出来只有 0.09。投入产出比极差,然后得出"数据治理没用"的结论。
这其实是最小因子定律(李比希定律)在数据领域的映射:三个变量里最低的那一个,决定了整体价值的上限。往另外两个变量上砸钱,天花板不会动。
五、怎么用:先诊断,再投入
四条实操建议,按顺序做。
第一,先诊断,别先立项。把Q / D / T三个变量分别打个分,找出你团队当前最低的那一个。这一步花不了两周,但能省掉一年的预算。
第二,最低的那个,就是当下唯一值得投入的方向。不是"重点投入",是"唯一"。其他两个维持不恶化就行。
第三,不要三个变量同时铺开做。那等于把预算摊薄在三张桌子上,每张桌子都不够吃。
第四,每半年重新诊断一次。因为最低的那个会变。质量补上来之后,距离往往就变成了新的瓶颈——这其实是好事,说明前一阶段做对了。
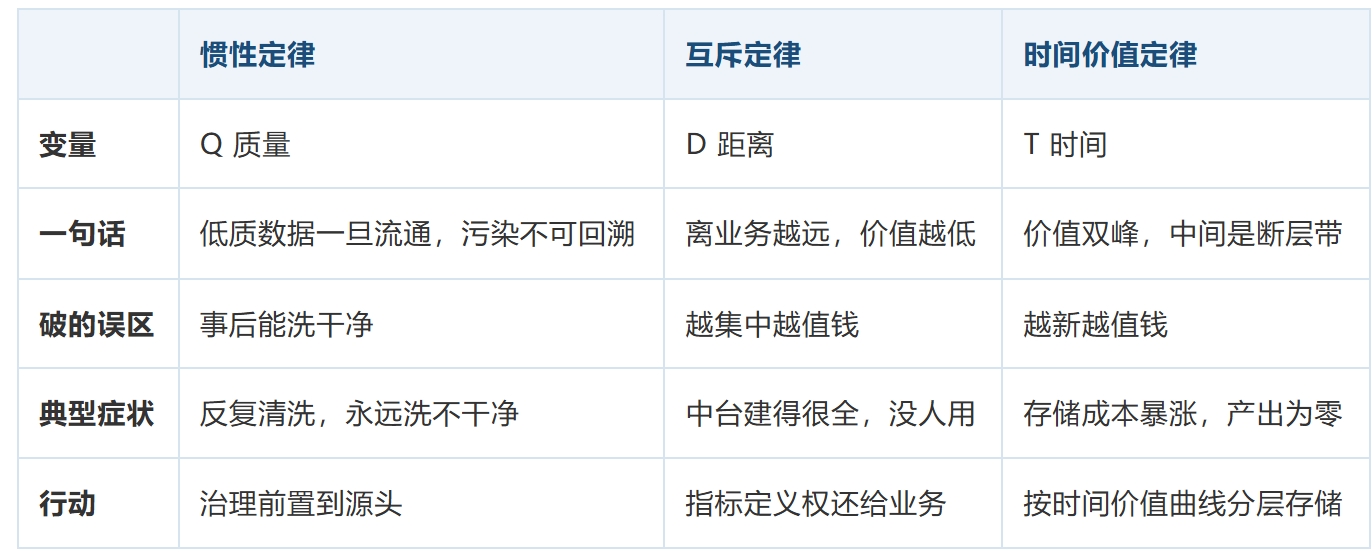
三条定律速查,建议存下来:
最后的话
讲了三条定律,其实说的是同一件事:数据的价值,从来不是它本身固有的。
它是质量、距离、时间三个变量的函数。而治理的全部工作,就是让这三个变量同时朝有利的方向移动。
回到开头那家企业。它的问题不在于不舍得投入,而在于只投了三个变量中的一个,然后期待整体价值翻三倍。乘法世界里没有这种好事。
所以下次再有人问"数据治理到底有没有用",我建议先反问一句:你团队现在最低的那个变量,是哪个?
答不上来,说明还没开始。
你所在的团队,三个变量里最低的是哪一个?评论区聊聊。
附一句:这三条定律,我各录了一条 40 秒左右的口播版,已经发在视频号上了。想先快速过一遍的,可以去那边听;想看推导和落地动作的,这篇里都有。
本文来自微信公众号“数据驱动智能”(ID:Data_0101),作者:王建峰,36氪经授权发布。