梁文锋一出手,DeepSeek就融了上千亿?
就在昨天,彭博社报道:DeepSeek新一轮融资即将敲定,规模至少800亿元,原定目标只有约500亿元,按已签的条款书最终可能逼近1000亿元。宁德时代和腾讯是出资最多的两家,这笔钱被视为2027年初IPO的铺路石。
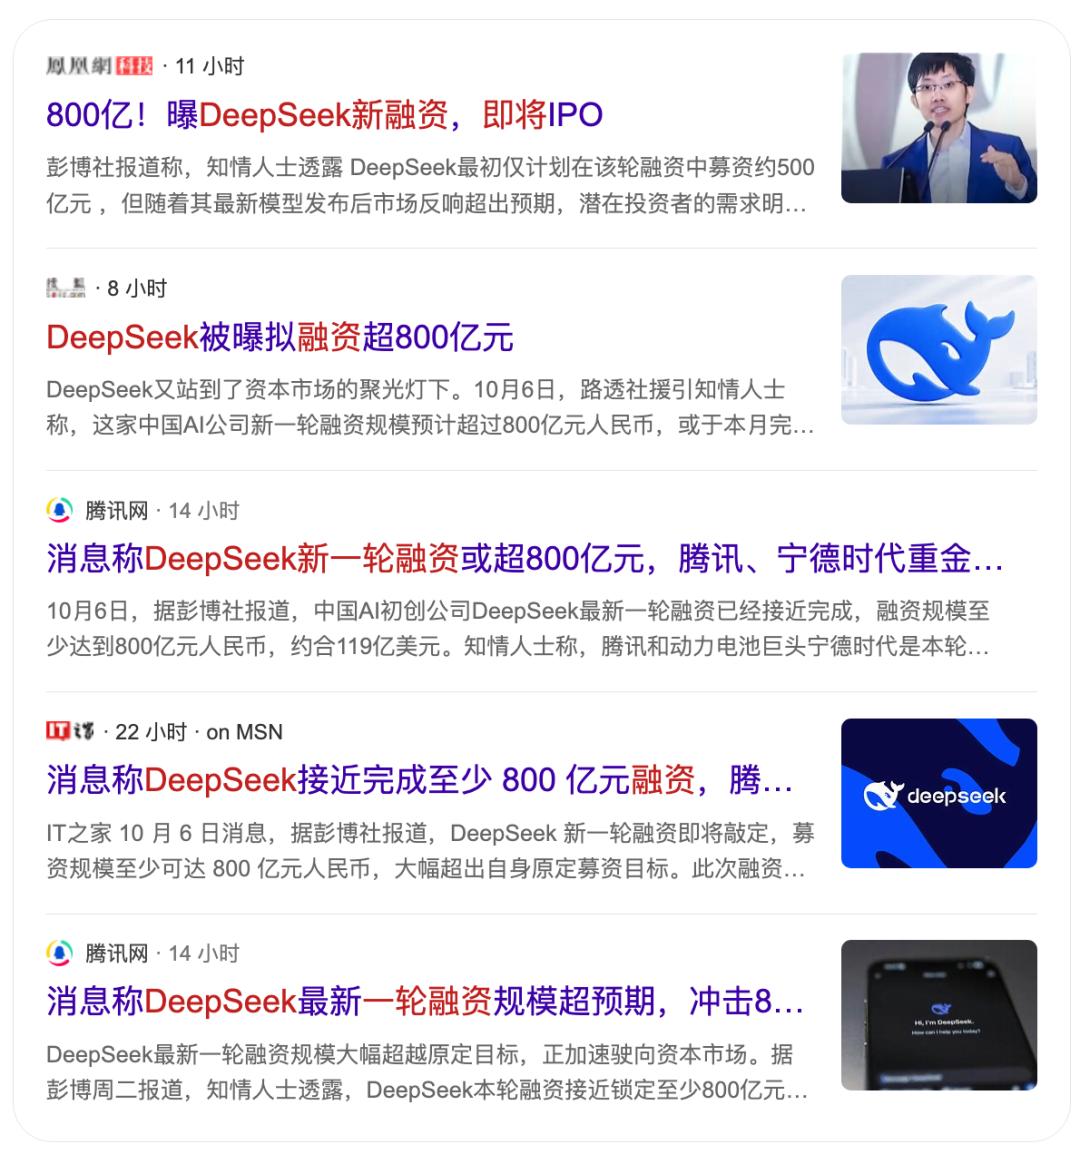
放在别的公司身上,这只是又一条融资快讯。放在DeepSeek身上就有点魔幻了:一年半前,它还在辟谣"融资相关均为谣言";梁文锋公开说过,DeepSeek不缺钱,短期没有融资计划。
从"不要钱"到"钱多到超募",DeepSeek只用了不到六个月。这篇文章,我把它的发展史和融资史从头拔一遍:钱从哪来,为什么突然要钱,要了多少,又准备花在哪。
01
前传:DeepSeek的"天使轮",是一家量化基金(2015–2023)
DeepSeek的第一笔钱不是VC给的,是幻方量化挣的。理解这一点,才能理解它后来为什么能三年不融资。
•2015年:梁文锋创立幻方量化,这家量化私募后来管理规模一度破千亿。
•2016年10月:幻方第一个AI模型上线,深度学习生成的交易仓位开始用GPU计算;2018年把AI定为公司主方向。
•2019–2020年:成立幻方AI,自研训练平台"萤火一号",总投资近2亿元,搭载约1100块GPU。
•2021年:投入10亿元建"萤火二号",约1万张英伟达A100。当时国内持有万卡的企业不超过5家,一家量化基金就在其中。
•2023年4月:幻方公告成立独立研究组织,探索AGI,命名"深度求索"。
•2023年7月17日:杭州深度求索人工智能基础技术研究有限公司注册成立。
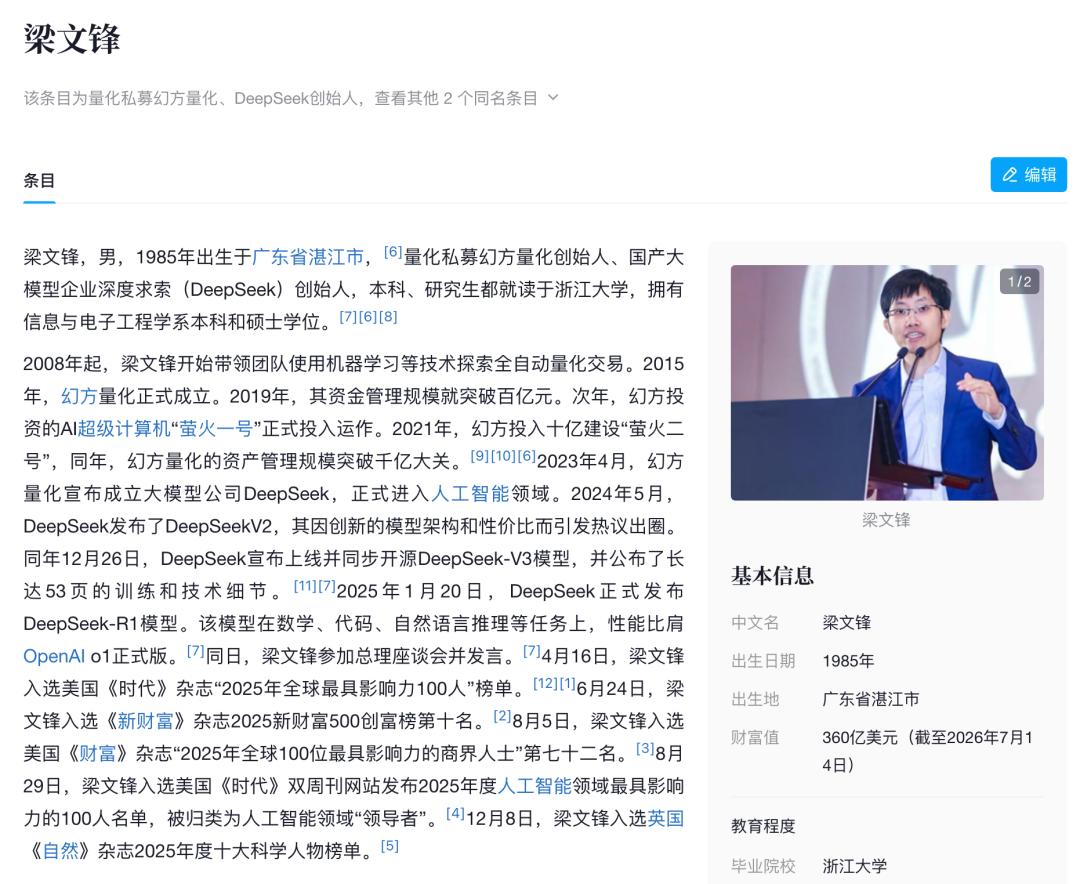
怪哥划重点:在ChatGPT引爆大模型之前,幻方已经提前两年囤好了万卡。别人2023年满世界找卡,DeepSeek是带着算力出生的。而且母公司是一台持续造血的印钞机——据行业估算,幻方仅2025年的管理费加业绩报酬就在50亿元量级。这就是DeepSeek敢说"不缺钱"的底气。
02
出道:开源、MoE和价格屠夫(2023–2024)
DeepSeek从第一天起就选了一条和国内同行都不一样的路:全部开源,死磕效率,把价格打到地板。
•2023年11月2日:成立半年后发布第一个模型DeepSeek Coder,开源、免费商用;同期推出通用模型DeepSeek LLM。
•2024年1月:开源DeepSeek-MoE,是国内第一个开源的混合专家模型。MoE后来成了DeepSeek所有旗舰模型的底座。
•2024年5月:DeepSeek-V2发布,API价格压到每百万tokens输入1元左右,直接点燃国内大模型价格战,DeepSeek也因此得了个外号"AI界拼多多"。
•2024年12月:DeepSeek-V3发布,官方披露的训练成本约557.6万美元,性能对标当时的头部闭源模型。
这一阶段DeepSeek在国内圈子里已经很有名,但在资本市场眼里,它还只是"幻方旗下的研究部门"。真正让全世界记住它的,是下一个模型。
03
R1时刻:一个开源模型,让英伟达一天蒸发5888亿美元(2025)
2025年1月20日,DeepSeek发布推理模型R1。它在数学、编程、推理上对标OpenAI o1,API调用成本却低了90%–95%。
一周后的1月27日,美股给出了反应:英伟达单日收跌16.86%,市值蒸发5888.62亿美元,创下美股单只个股最大单日蒸发纪录。华尔街第一次认真问自己:巨头们砸进AI基建的几千亿美元,是不是有一部分白花了?
用户侧同样炸裂:DeepSeek App仅用12天就突破3000万日活,登上140个国家应用商店榜首。作为对比,ChatGPT到这个规模用了11个月。
这一年还有一个容易被忽略的节点:2025年9月17日,R1论文登上《自然》封面,成为首个通过权威期刊同行评审的主流大模型。补充材料首次披露R1的强化学习训练成本只有29.4万美元,加上V3基座约600万美元,依然远低于硅谷同行。
怪哥划重点:R1之后,DeepSeek从"国内技术圈明星"变成了"全球资本市场变量"。按常理,这就是创始人开始见投资人、拿天价估值的时刻。但DeepSeek的选择是:关门,继续做研究。
04
"不融资"的两年:辟谣、拒绝和错过
R1爆火后,想投DeepSeek的人排成长队,但这两年里每一条融资传闻都被否认了。
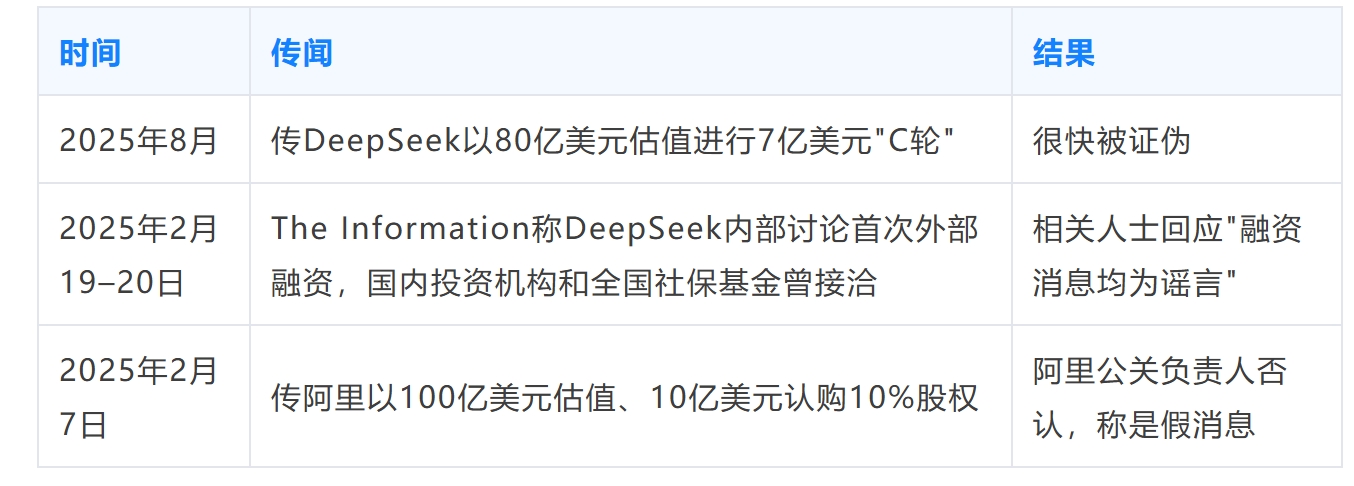
那段时间DeepSeek的钱主要来自幻方内部资源和政府科研资助。连办公室就在DeepSeek楼上的百度风投也没投进去,原因很简单:幻方根本没有把大模型业务拆出来融资的计划。
梁文锋拒绝的理由,归纳起来有两条:
1. 外部投资者会干预公司决策。
2. 很多VC对做研究有顾虑,他们有退出需求,希望尽快商业化。
怪哥划重点:注意这两条理由。后来DeepSeek真的融资时,它设计的交易结构几乎就是逐条回应这两个顾虑——拿钱,但不交投票权;锁定五年,不给快速退出的预期。
05
2026首轮融资:从"至少3亿美元"到500亿元
2026年6月,DeepSeek完成首轮外部融资,募资约500亿元(约74亿美元),投后估值约3500亿元,是中国大模型史上规模最大的首轮融资。但这轮融资的开局,规模只有最终的几十分之一。
为什么突然要钱?据报道,最初的动机很朴素:给员工期权定一个估值,留住研究员——此前几个月,DeepSeek流失了几位核心研究员。另有报道提到,2026年3月下旬一次约11小时的服务中断,暴露了它在云基础设施上的短板。而下一代模型的算力账,单靠一家对冲基金的现金流已经撑不住了。
估值是怎么被抢上去的:
•4月17日:The Information首次报道,DeepSeek寻求至少3亿美元,估值100亿美元以上。
•4月22日:腾讯、阿里被曝洽谈入局,目标估值抬到200亿美元以上,参照物是同期融资的Kimi(180亿美元)。
•5月6日前后:英国《金融时报》报道国家集成电路产业投资基金(大基金)洽谈领投,估值约450亿美元。
•5月8日:估值升至500亿美元以上,梁文锋个人拟出资约29亿美元。
•5月22日:宁德时代被曝参投。
•6月3日:路透社报道融资约500亿元,投后估值3500亿–4000亿元。
•6月中旬:交割落定(《金融时报》称5月末完成,国内媒体多称6月交割)。
最终的投资人名单(金额为媒体报道,DeepSeek未官方披露):
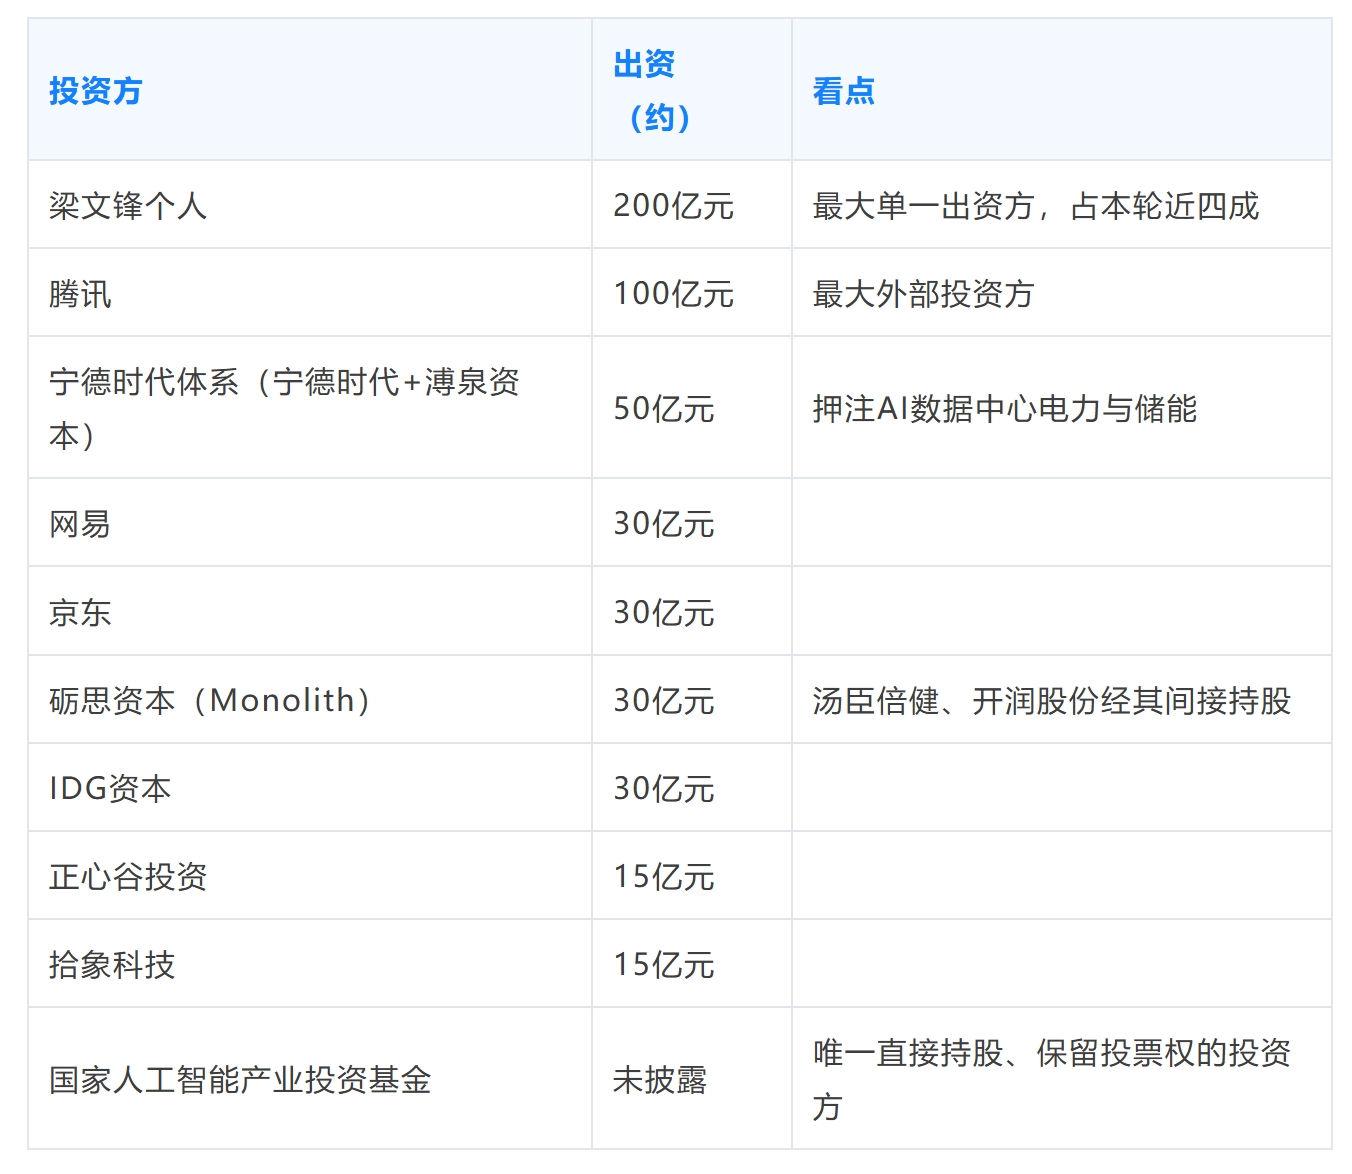
交易结构才是这轮最值得看的地方:多数投资人的钱不直接进DeepSeek,而是进入梁文锋管理的有限合伙企业,没有投票权,锁定期五年。只有国家人工智能产业投资基金直接投资并保留投票权。
认购有多火?意向资金超过1000亿元,最后只进来一半,至少500亿元在排队。融资后,梁文锋持股从约90%降到约78%,但身家从167亿美元涨到约360亿美元。
估值还有一个侧面印证:上市公司开润股份披露,4000万元间接持有0.0114%股份,倒推估值约3508亿元;汤臣倍健1.3亿元持有0.04%,倒推约3250亿元。《财经》则提到,算上增发5%的员工期权池,实际投前估值约3675亿元。
06
第二轮:启动、暂停、重启、超募
首轮交割才六周,第二轮就开了,而且过程比首轮更有戏剧性。
•7月14日:《金融时报》报道,DeepSeek以约710亿美元(约4800亿元)投前估值寻求新一轮融资,比首轮投后520亿美元高37%。彭博同日报道,DeepSeek已开始筹备IPO,目标2027年在内地上市,最快年底递交申请。原因之一是首轮"额度供不应求",落选的机构在抢第二轮份额。
•7月22日:梁文锋在首轮融资期间与投资人的一场4小时闭门会,3.4万字实录在网上刷屏。
•7月25日:彭博报道DeepSeek口头通知部分投资人暂停签约,原因之一是梁文锋对实录外流不满。
•8月5日:《财经》报道融资重启,计划募资500亿元,投前估值约5000亿元,希望低调推进。
•8月10日前后:据IPO早知道,首批签约在杭州进行,单家最低投资额50亿元;资金路径分两条,部分直接进入深度求索主体,部分进入梁文锋控制的有限合伙。
•8月27日:《华尔街日报》报道本轮拟募74亿美元,投前估值740亿美元;宁德时代、砺思资本、拾象科技等老股东加码,并有地方政府背景基金参与。同时披露DeepSeek年化经常性收入(ARR)已达5亿美元。
•10月6日:彭博报道本轮即将敲定,规模至少800亿元,可能逼近1000亿元,宁德时代和腾讯出资最多;DeepSeek原本希望估值约5000亿元。融资完成后将启动业务重组,为IPO做准备。
估值口径混杂了目标、投前和投后,但方向很清楚:首轮还没交割,估值就被抢高了五倍。
那份外流的实录里,梁文锋反复讲"克制":不追求利润最大化,只赚合理利润;不做3D生成、视频生成和世界模型;最强的模型大概率继续开源;当下最重要的方向是Coding Agent。对投资人说这些话,本质上是在提前声明:钱可以进来,路线不会改。
怪哥注:10月6日这条报道没有明说就是"第二轮",但从时间线、投资人和估值目标看,它应当就是7月启动的那一轮,只是认购太热,规模从500亿元一路被抬到800亿元以上。最终数字以交割为准。
07
技术底牌:V4到V4.1 Flash,估值是用模型撑起来的
两轮融资的估值曲线,几乎和模型发布节奏同步。投资人买单的,是DeepSeek把"性价比"这件事又往前推了一大步。
V4:迟到三个月的百万上下文。V4原定2026年春节发布,一路推迟到4月24日才正式开源,分两个版本:
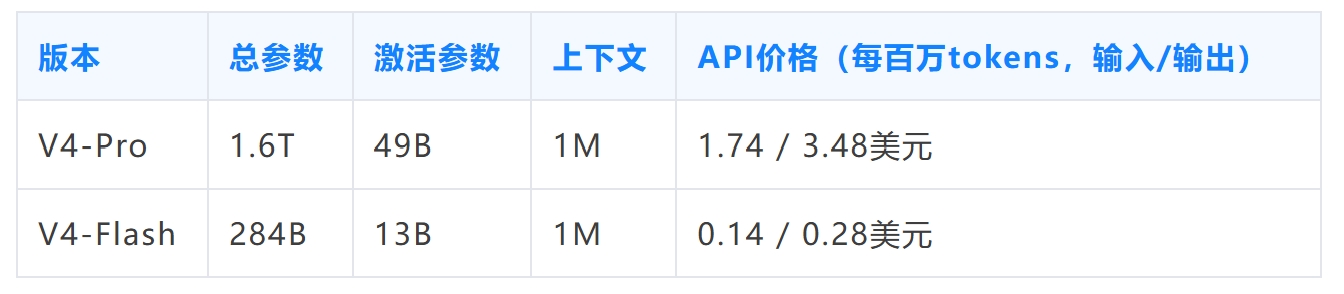
两个关键词:一是上下文从128K扩到1M,KV Cache大幅压缩;二是华为昇腾超节点全系首发适配,模型发布和国产算力适配同步推进。作为参照,同期GPT-5.5的价格是输入5美元、输出30美元。
V4-Flash正式版:小模型干翻大模型。7月底上线的V4-Flash-0731参数没变,靠重新后训练,在九项代码和智能体测试上全部超过V4-Pro预览版,DeepSWE得分从7.3跃到54.4。Artificial Analysis估算它完成一项基准任务平均只要约0.03美元。8月31日又开源了视觉版V4-Flash-Vision-Exp。
V4.1 Flash:新架构先在小模型落地。9月10日发布,552B参数MoE,采用全新的因果编码器-解码器(Causal Encoder-Decoder)结构,输入激活8B、输出激活16B,原生支持图像理解。官方测试显示它在性能、费用、速度上全面超过V4-Pro,于是从9月14日起,V4-Pro的请求全部被路由到V4.1 Flash,按Flash价格计费,直到V4.1 Pro发布。腾讯的WorkBuddy、CodeBuddy作为官方合作伙伴第一时间接入。
商业化数据也开始浮出水面:据TechCrunch援引Vercel数据,6月DeepSeek在该AI网关处理的tokens中占比近23%;《华尔街日报》称其ARR已达5亿美元;The Information还报道其毛利率在70%–80%。这些数字都还没有经过审计,但它们是IPO故事成立的前提。
08
钱往哪花:乌兰察布、16万颗昇腾和一场IPO
两轮融资加起来,DeepSeek手里可能有超过1300亿元。按各方报道,这些钱最核心的去向是算力。
自建数据中心。2026年4月,DeepSeek第一次公开招聘数据中心运维和交付岗位,工作地在内蒙古乌兰察布,标志着它从纯算法公司延伸到自建物理基础设施。7月底彭博报道,DeepSeek计划在乌兰察布增加1GW算力,部分在2027年底或2028年初投用,同时也会租用外部算力。作为量级参考,黄仁勋曾估计一座配齐最先进芯片的1GW数据中心投资可达500亿美元,中国的建设成本通常更低。
押注华为。9月4日彭博报道,DeepSeek计划在这座数据中心部署至少16万颗华为昇腾950DT,有望成为已知规模最大的昇腾集群之一。有两个细节值得注意:
• 这批芯片目前计划用于推理,不用于训练;训练端DeepSeek迄今仍主要依赖英伟达。
• 华为产能是瓶颈。受高端存储等零部件短缺影响,950DT今年产量只有几十万颗量级,DeepSeek的订单可能要一年以上才能交付完。
10月的报道还提到,DeepSeek与华为联合开发了用于AI芯片编程的软件,这意味着它开始涉足软硬件协同这块新业务。路透社7月也报道过,DeepSeek在早期阶段研发自己的推理芯片。
IPO。按彭博和The Information的报道,DeepSeek已在和会计、投行顾问合作,目标是年底前完成财报准备,2026年底或2027年初递交申请,2027年在内地上市,有报道称可能登陆科创板。同样把IPO定在2027年初的,还有刚以500亿美元估值完成融资的月之暗面。
09
怪哥观点:DeepSeek融资史里的四个反常识
1. DeepSeek缺的不是钱,是"算力的时间"。幻方一年几十亿元的造血,够养一支顶尖研究团队,但不够建吉瓦级数据中心。当模型竞争从"谁的算法巧"变成"谁的集群大",对冲基金的现金流就成了天花板。融资不是放弃理想,是换了一种买时间的方式。
2. 这是一次"拿钱不交权"的融资。创始人自掏200亿元,外部资金走有限合伙、无投票权、锁定五年。梁文锋当年拒绝融资的两条理由——怕干预、怕催着退出——在交易结构里被逐条堵上了。唯一的例外是国家人工智能产业投资基金,这本身也是一个信号。
3. 投资人名单里几乎没有美元VC,全是产业资本和国家队。腾讯要的是模型能力整合进自家产品,WorkBuddy、CodeBuddy已经第一批接入;宁德时代看的是数据中心的电力和储能;国家队要的是"国产模型+国产芯片"闭环。DeepSeek卖的不只是股权,是生态位。
4. 估值涨得快,但按收入算并不便宜。四个月里报道估值从100亿美元涨到700多亿美元。但如果按5000亿元估值和5亿美元ARR粗算,市销率大约在150倍。它比OpenAI、Anthropic便宜得多,可它的定价策略又在主动压缩自己的利润空间——"只赚合理利润"和上市公司的增长叙事,迟早要正面碰一次。
10
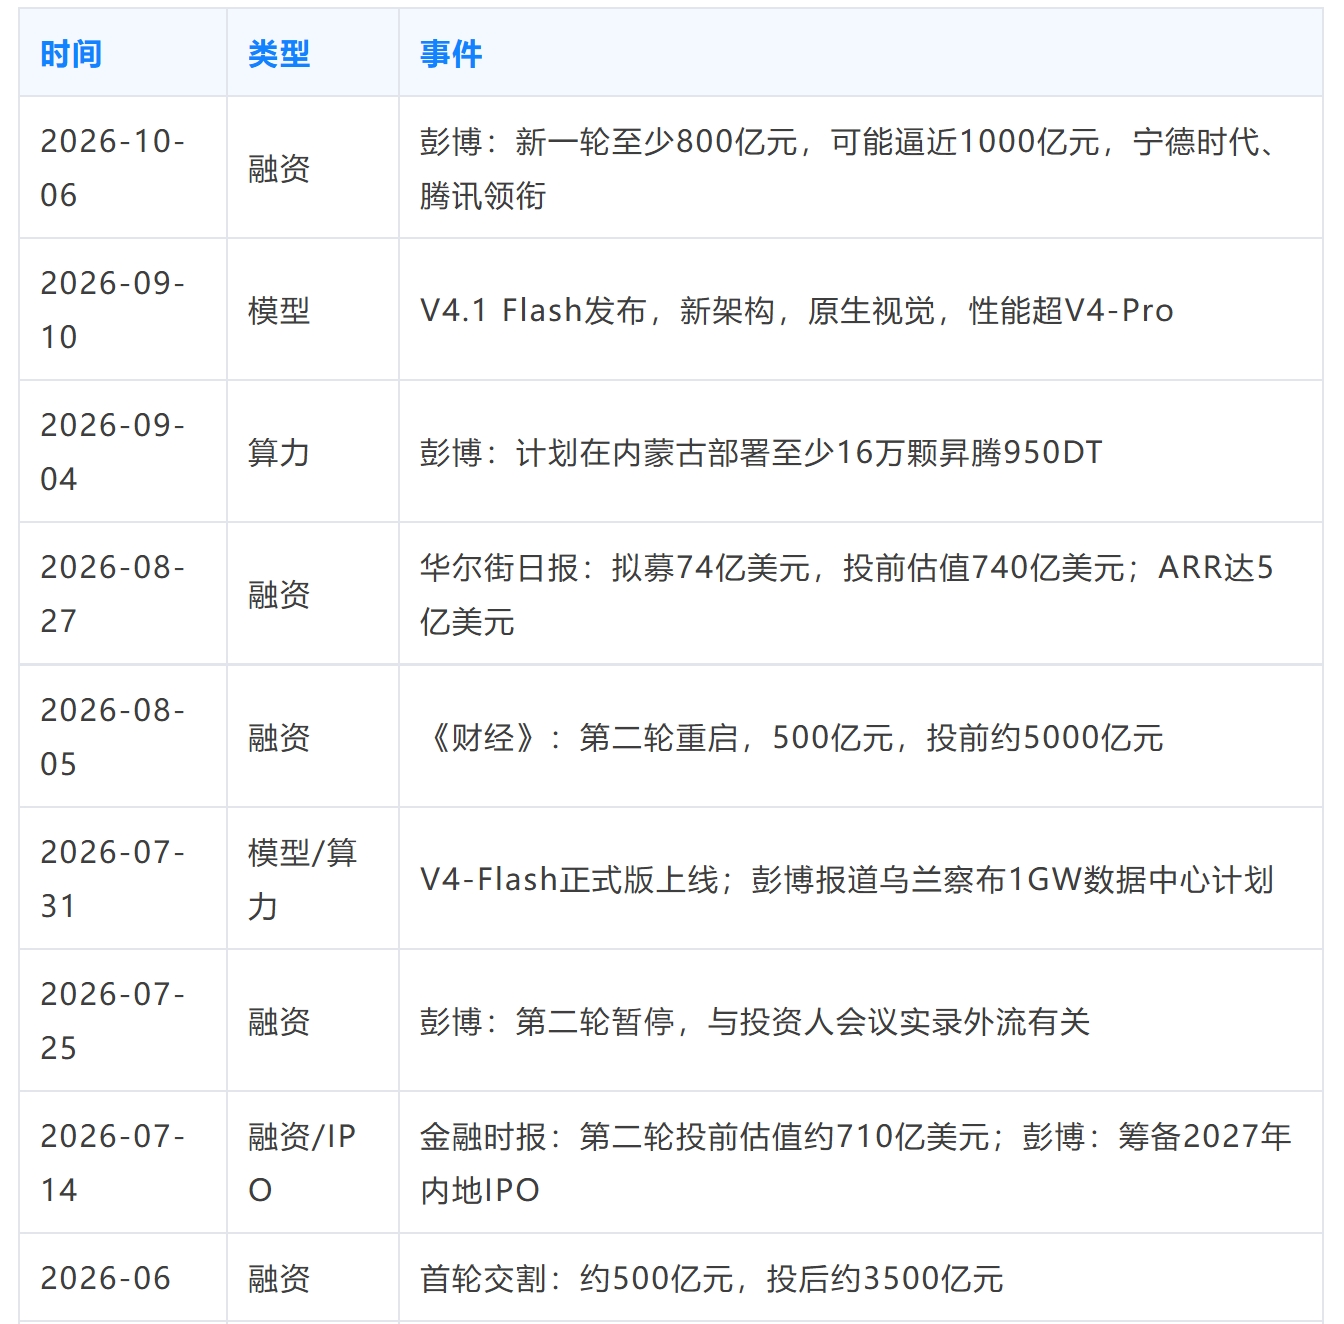
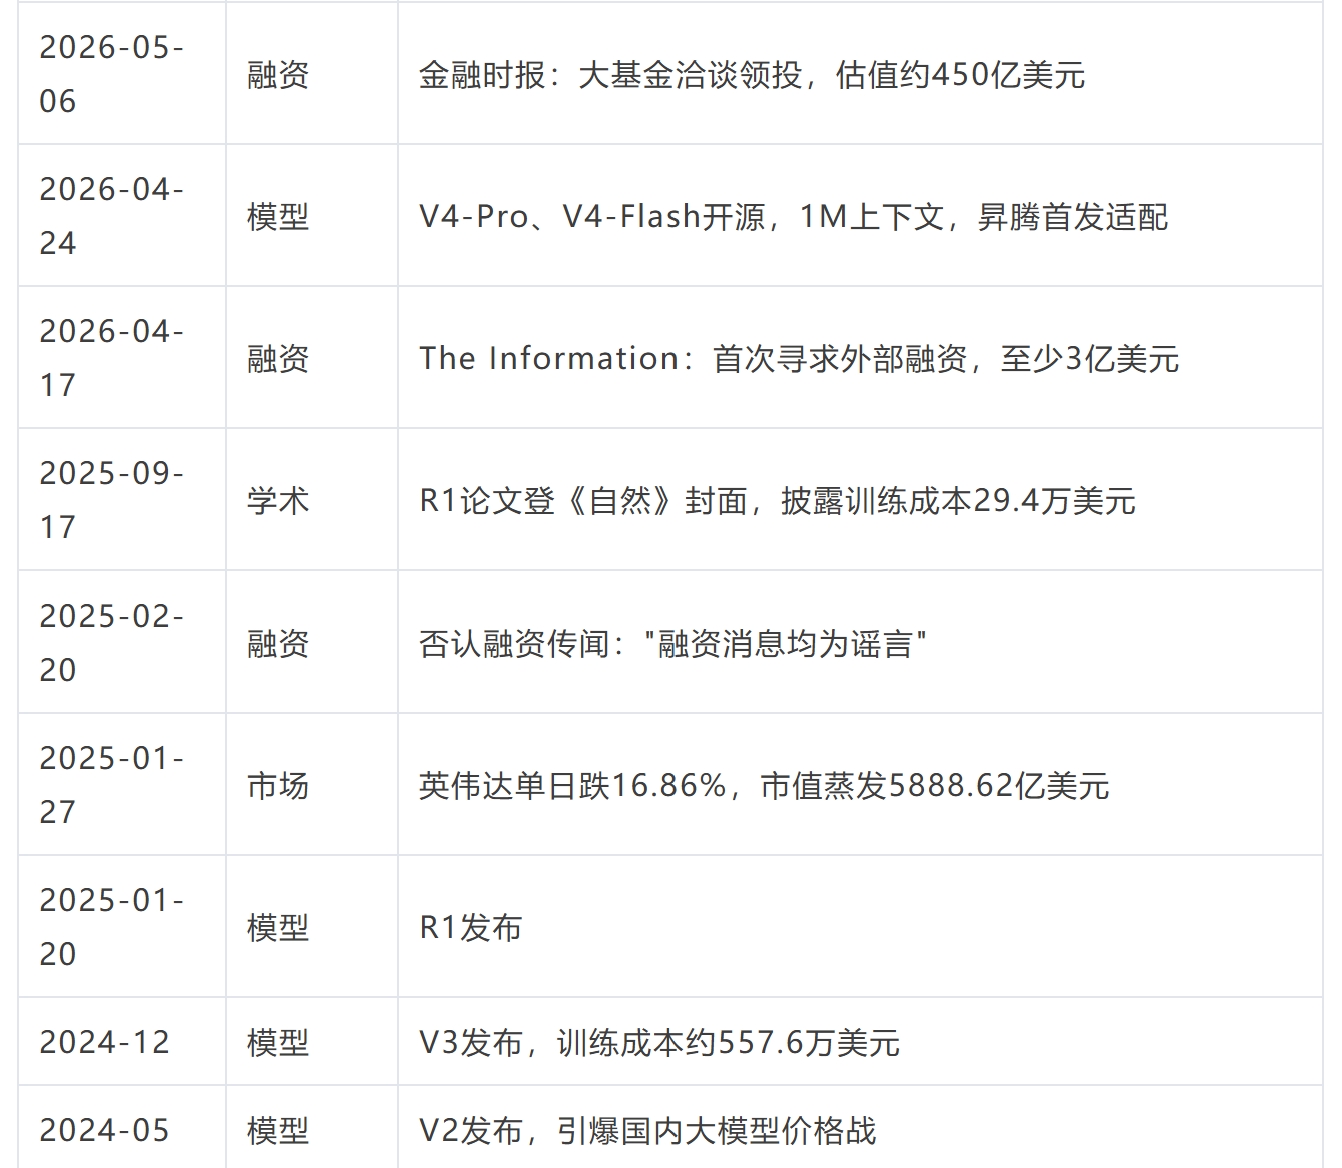
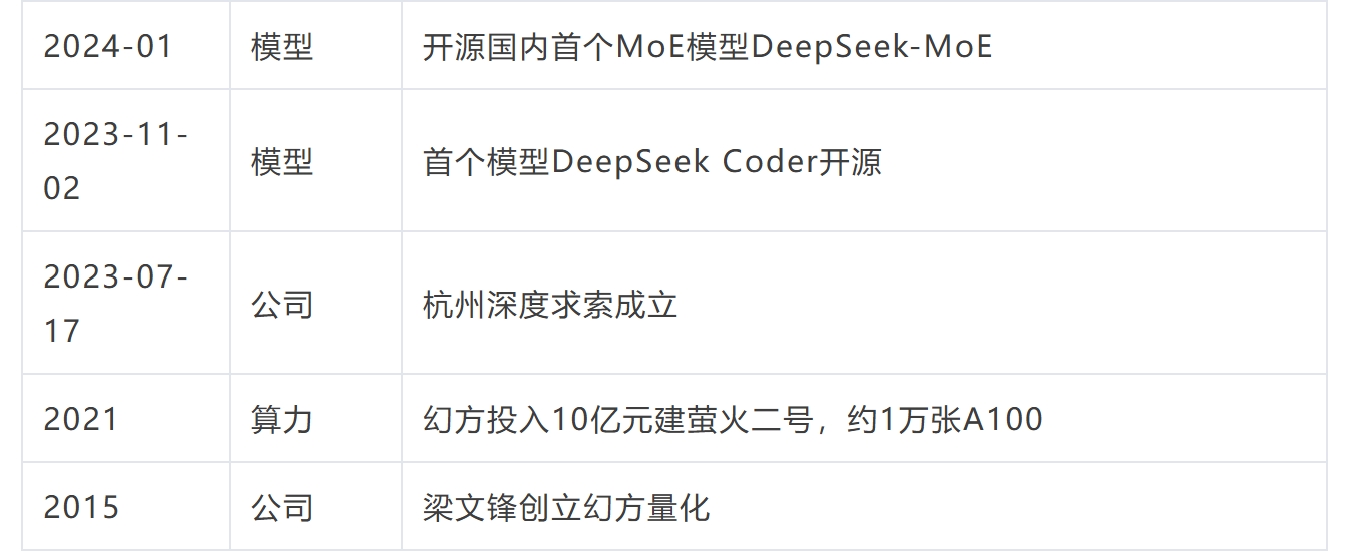
附:DeepSeek大事年表
按时间倒序,融资相关事件多为媒体援引知情人士报道,DeepSeek官方未逐一确认。
11
数据/信息来源
• IT之家:消息称DeepSeek接近完成至少800亿元融资
• The Decoder:DeepSeek takes outside money for the first time
• 华尔街见闻/《财经》:DeepSeek重启融资,投前估值5000亿元
• TechCrunch:DeepSeek reportedly in talks to raise $1.5B, then IPO
• 凤凰网科技:DeepSeek将采购16万颗华为AI芯片
本文来自微信公众号“人人都是产品经理”(ID:woshipm),作者:怪哥,36氪经授权发布。