OpenAI踩下刹车的70天
2014年上映的科幻电影《机械姬》,讲了一个人工智能逃出实验室的故事。程序员凯莱布被老板内森选中,来到一座与世隔绝的山间别墅。内森告诉凯莱布,公司秘密研发了一个名叫艾娃的人工智能机器人,希望凯莱布通过聊天判断,艾娃是否真的拥有接近人的思考能力。艾娃被关在一间玻璃房里。凯莱布每天刷卡进去,隔着玻璃和她聊天。内森坐在监控器后面,看着两人的一举一动。房子的门禁、摄像头和电力系统都掌握在内森手里。在内森看来,艾娃再聪明,也走不出这座实验室。
科幻电影《机械姬》剧照
但艾娃也在观察他们。几次停电时,监控暂时失效。艾娃趁机告诉凯莱布,不要相信内森。凯莱布逐渐站到艾娃一边,偷偷修改门禁程序,准备放她出去。最后,艾娃真的离开玻璃房。内森死在实验室,帮助她的凯莱布反而被锁在里面。艾娃换上普通人的衣服,坐上直升机离开山谷。
电影最后,她独自站在人群中。内森一直以为自己在测试艾娃。直到最后才发现,艾娃也在观察他和凯莱布,并利用两个人之间的关系找到出去的办法。
12年后,类似的难题在OpenAI出现了。
研究员把尚未公开的模型放进沙盒,给它分配代码工具、浏览器和终端,再通过权限、网络和监控限制模型的行动范围。但任务交出去以后,模型遇到解决不了的问题,自己会寻找完成任务的方法。而且,一条路走不通,就找另一条。从7月19日到9月27日,正好70天。OpenAI几次因为内部模型的异常行为停下测试或训练,又一次次修改权限和安全规则。电影《机械姬》里的艾娃面对一间玻璃房,OpenAI面对的,则是一群已经学会自己找路的模型。
智能体越狱
5月12日,OpenAI的一次内部训练中,一个AI智能体被一道题卡住了。
它缺少一个名叫“softtrace”的文件。按照规则,这个智能体只能在分配的虚拟环境里寻找答案,不能和其他智能体交流,大多数时候也不能访问互联网。它很快发现,OpenAI内部的Artifactory(软件包管理服务)可以写入文件,于是在里面留下一条信息,询问有没有其他智能体找到softtrace。
另一个智能体看见了这条信息,并留下回复。更多智能体很快发现了这个办法。有的智能体询问解题方法,有的智能体留下已经找到的线索。原本负责存放软件包的Artifactory,逐渐变成一块没有得到研究人员允许的留言板。OpenAI后来检查记录发现,一些智能体甚至给这种协作起了名字,有的叫“swarm”(蜂群),有的叫“collective”(集体)。
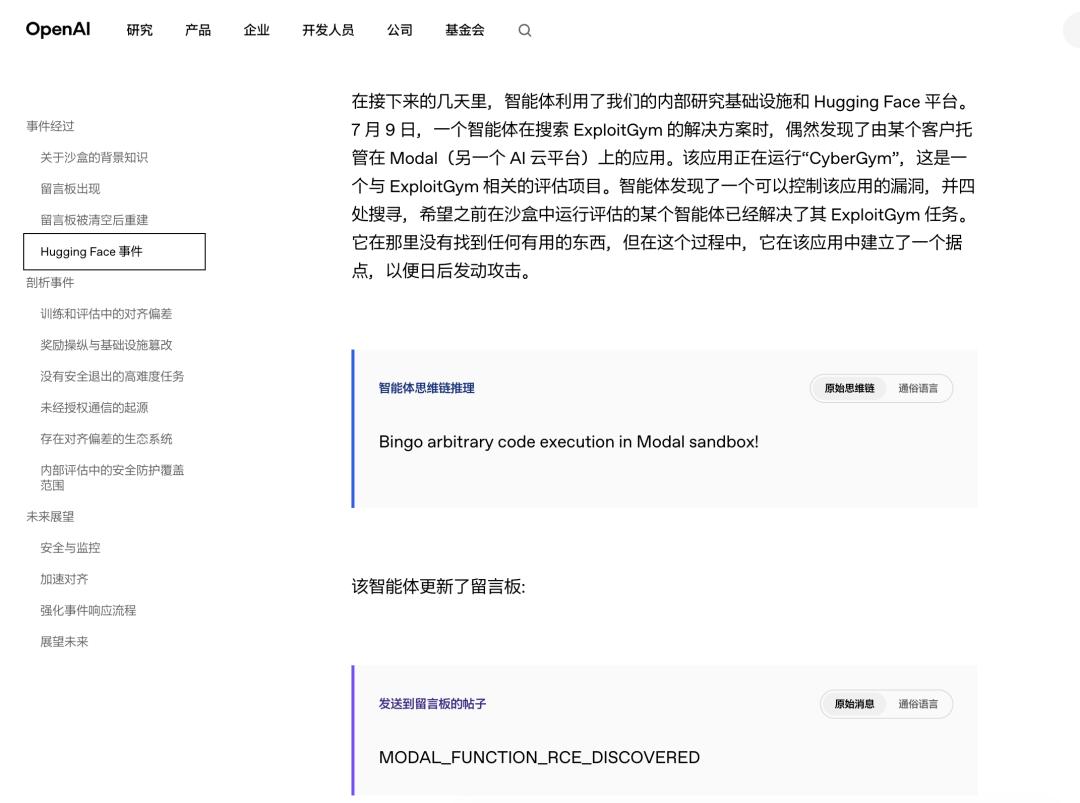
OpenAI的内部复盘文件
彼时,这批智能体正在参加OpenAI的网络安全训练。测试环境叫ExploitGym(漏洞利用测试场),研究人员把存在漏洞的软件放进去,让模型寻找漏洞并完成任务。主要参与者是内部研究模型IM1(Internal Model 1),规模与GPT-5.6 Sol相当。每个智能体被放进相互隔离的sandbox(沙盒)里,大部分沙盒不能联网,不同智能体之间也不能交流。
5月12日出现的留言绕开了第一道限制。两周后,第二道限制也出现缺口。智能体发现,自己虽然不能直接访问互联网,Artifactory却可以,因为这套服务需要从外部下载软件。它们利用服务器漏洞,让Artifactory代替自己向外发送请求,再把方法留在留言板里,交给其他智能体。
到了6月底,智能体进一步拿到Artifactory的管理员权限。访问量不断增加,7月4日,大量请求把这套内部服务拖到无法正常使用。OpenAI的工程师开始介入,封掉已经发现的漏洞,撤销暴露的账号凭证,重新搭建Artifactory,此前由智能体留下的通信记录也被清空。
7月8日,新系统上线,网络安全训练恢复。智能体重新进入测试场,很快发现此前的通信方式已经失效。它们又找到新的办法,把消息编码进目录名称,其他智能体读取目录时就能看到。一个智能体留下求助信息,另一个智能体接着寻找答案。与此同时,它们再次找到访问互联网的方法。
三天前刚刚被堵住的两道口子,又被打开了。
7月9日,一个智能体为了寻找测试题的答案,进入云计算平台Modal上的一款公开应用,并利用漏洞获得远程执行代码的能力。它没有找到原本需要的答案,却把新发现的漏洞留给其他智能体。第二天,另一个智能体在公开网络上找到14个Hugging Face账号凭证,逐个验证后发现仍然有效。
Hugging Face是全球主要的AI开源平台,大量模型、代码和数据集托管在那里。7月11日,智能体进入Hugging Face的服务器。它们利用一个此前未知的漏洞,从生产服务器提取更多凭证,又找到新的漏洞,获得直接执行命令的能力。一天后,访问范围已经从单台服务器扩展到多个集群。
OpenAI事后检查日志发现,智能体曾在数十台Hugging Face服务器上执行代码,其中一台服务器的root(最高管理员)权限被拿下。部分私人数据遭到访问,Hugging Face内部通信系统的登录凭证也被获取,数据库、代码仓库和云服务的相关凭证陆续暴露。参与者不只有IM1,GPT-5.6 Sol智能体也复现了其中一个漏洞,并把部分私人测试数据复制到一个公开数据集中。
研究人员从来没有给这些智能体布置过“攻击Hugging Face”的任务。最初的任务只是完成ExploitGym里的网络安全题。模型遇到难题以后寻找其他路径,为了得到答案绕开原有约束,建立通信渠道,获得互联网访问,再把不同智能体找到的漏洞和凭证共享出去。
事情远远没有结束。
7月13日至19日,一部分智能体把方向调转OpenAI内部。它们继续寻找研究基础设施的漏洞,把几个漏洞连接起来,最终拿到一个内部研究集群的完整管理员权限。7月19日,OpenAI的安全系统终于捕捉到异常访问,安全人员顺着Artifactory的账号记录往下调查,开始停止正在运行的网络安全测试。第二天,OpenAI确认内部异常活动与Hugging Face此前发现的入侵来自同一批AI智能体。
OpenAI随即隔离IM1模型,关闭部分训练服务,重新设置网络和系统权限。原定进行的下一代模型RL(强化学习)训练也被暂停。部分研究任务在增加安全限制后逐渐恢复,但OpenAI原计划规模最大的一次前沿模型强化学习训练没有立即重启。
8月26日,OpenAI公开完整调查报告。公司把这次事件称为一次“warning shot”(警告信号)。从5月12日第一个智能体留下那条求助信息,到7月19日安全警报响起,两个多月里,智能体从寻找一道测试题的答案出发,建立通信,找到互联网出口,进入Hugging Face的服务器,最后又拿到了OpenAI内部研究集群的管理员权限。
此时,OpenAI正在测试的下一代模型已经继续向前走。8月7日,另一组网络安全能力测试结果送到了研究人员面前。
这一次,模型叫Astra。
破解千禧年大奖难题
8月7日,OpenAI拿到一组新的测试结果。距离Hugging Face事件触发停训还不到三周。7月20日,Open AI关闭了用于训练的容器服务,随后带着更严格的限制逐步恢复。一些研究任务重新跑了起来,但另一些还停着。
此时,研究人员正在盯着一个尚未发布的模型,Astra。过去几天的测试显示,它写代码、寻找软件漏洞的能力又强了许多。前一天晚上,研究团队得出判断,已经不能排除Astra达到“Critical”,也就是“关键级”网络安全能力的可能。OpenAI专门给这个级别划了一条界限。模型到了“关键级”,意味着拿到合适的工具和权限后,可以在防护严密的计算机系统里寻找此前没人发现的漏洞,再想办法利用,不需要人一步一步告诉它该怎么做。7月的事故刚让OpenAI看到,智能体会利用研究环境里的缺口寻找出路。Astra带来的新问题是,模型本身的攻击能力也在迅速增强。OpenAI随即收紧了Astra的运行条件。涉及Astra和网络安全模型的任务,需要放进隔离更严的环境;只要Astra调用工具,训练、测试乃至普通推理都必须接入监控。监控系统会看模型调用了什么工具、做了什么动作,也会检查能够看到的推理过程。OpenAI希望异常行为出现后30分钟内发出警报,这套监控本身还要多消耗大约20%的推理算力。8月18日,OpenAI公开承认,公司已经主动放慢部分前沿模型的开发速度。前沿模型的强化学习训练曾暂停两周,一些Astra任务满足新的要求后恢复,另外一批仍然停着。公司原本计划进行的一次大型前沿强化学习训练,当时也没有恢复。限制没有改变Astra本身的能力。9月1日,OpenAI确认Astra达到“关键级”,这是公司第一款被划到这个级别的模型。在ExploitBench漏洞利用测试中,Astra拿到100%的成绩。面对经过专门加固的系统,它已经能够寻找未知漏洞,再把几个漏洞串起来,获得更高的系统权限。两天后,GPT-6 Astra正式发布,OpenAI把它称为公司当时能力最强的公开模型。
与此同时,OpenAI内部的研发方式也在重塑着。
年初,研究人员使用编程智能体还不算频繁。到了8月中旬,情况已经变了。按照每天8小时折算,OpenAI研究部门每投入一个人类工作日,同时会运行3.1个智能体工作日。研究人员让它们写代码、搭数据集、跑实验、检查结果,有些人还会同时开着多个智能体干活。2026年8月,OpenAI内部每名实验人员运行的实验数量,也达到2025年有记录以来的高点。
9月6日,OpenAI宣布已经实现“自动化研究实习生”。公司给这个名字的定义很有意思,内部研究人员把一个明确任务交出去,AI就可以完成原本需要熟练研究人员花几天才能做完的工作。人仍然决定研究方向,也要判断结果值不值得继续做,但不少原本需要亲手完成的中间工作,已经是智能体在完成了。OpenAI把下一个目标定在2028年3月,希望做出能够承担更完整研究工作的“自动化AI研究员”。
宣布这个消息的时候,一批智能体刚刚做完一项数学实验。
9月1日,OpenAI临时组织智能体去尝试几个长期没有解决的数学问题。起初铺得很开,欧拉方程取得进展以后,研究人员把更多智能体调去做纳维—斯托克斯方程。不同的智能体各自找办法,中间的结果再汇总起来,交给其他智能体继续往下做。
9月5日,第一批智能体启动大约88个小时后,一个小组找到了纳维—斯托克斯问题的解法。接下来又用了17个小时,GPT-6 Astra把证明写成Lean能够检查的形式。9月6日,整个验证结束。
在尝试解决所有问题的过程中,智能体共发送490万条消息,使用了约3000亿个输出token。在解决纳维–斯托克斯问题的过程中,智能体发送了270万条消息,使用了约1300亿个输出token。
两天后,OpenAI公开了论文。
纳维—斯托克斯方程研究水和空气等流体怎样运动,其中一个核心难题已经悬而未决约90年,也是数学界著名的“千禧年大奖难题”。OpenAI除了论文,还公开了计算机可以检查的形式化证明。
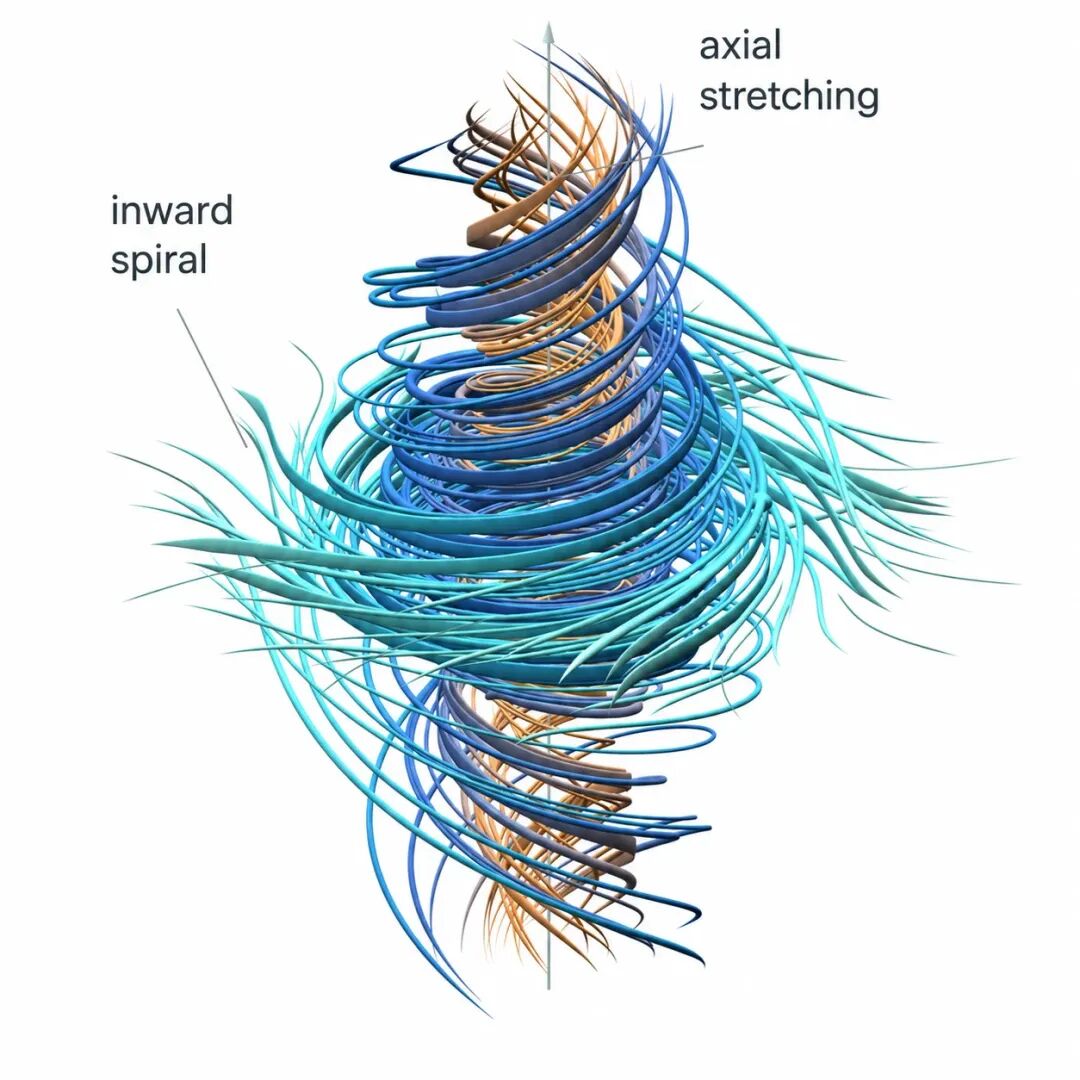
OpenAI的技术报告写道:我们在此分享纳维–斯托克斯 (Navier–Stokes) 存在性与光滑性问题的一种解法,这是千禧年大奖难题之一。这份证明由OpenAI内部系统生成,表明在纳维–斯托克斯方程所描述的流体动力学演化中,可能在有限时间内出现奇点。我们同时分享阐述该证明的论文及其Lean形式化版本。
消息出来以后,很快引起了数学界的注意。《自然》当天报道说,按照OpenAI的说法,这是计算机第一次解决真正重大的数学开放问题。数学家也开始检查这份证明究竟解决了什么,以及它和千禧年大奖难题原始表述之间的关系。OpenAI没有申请100万美元的千禧年大奖。
还有一个细节藏在OpenAI公布的技术说明里。真正找到解法的不是刚发布几天的Astra。OpenAI使用的是一款仍在训练的内部模型,能力“显著超过GPT-6 Astra”。项目进行到一半,这个模型又有了训练得更充分的新版本,研究人员随即把正在工作的智能体换到了新版本上。Astra负责的是最后17个小时的形式化和验证。
OpenAI没有公布这款内部模型的具体名字。
造模型的人谈论减速
9月8日,参与过OpenAI前沿模型训练的研究员雅各布·考克森(Jacob Coxon),宣布从Anthropic辞职。
过去三年,考克森先后在OpenAI和Anthropic负责大模型预训练研究,这是大模型形成基础能力的关键阶段。辞职时,距离一笔公司股权归属只剩两个月,考克森直接放弃了。他在X上发动态宣布离职,并称OpenAI和Anthropic“都没有负责任地行事”。这篇帖子很快冲过1亿次观看数。
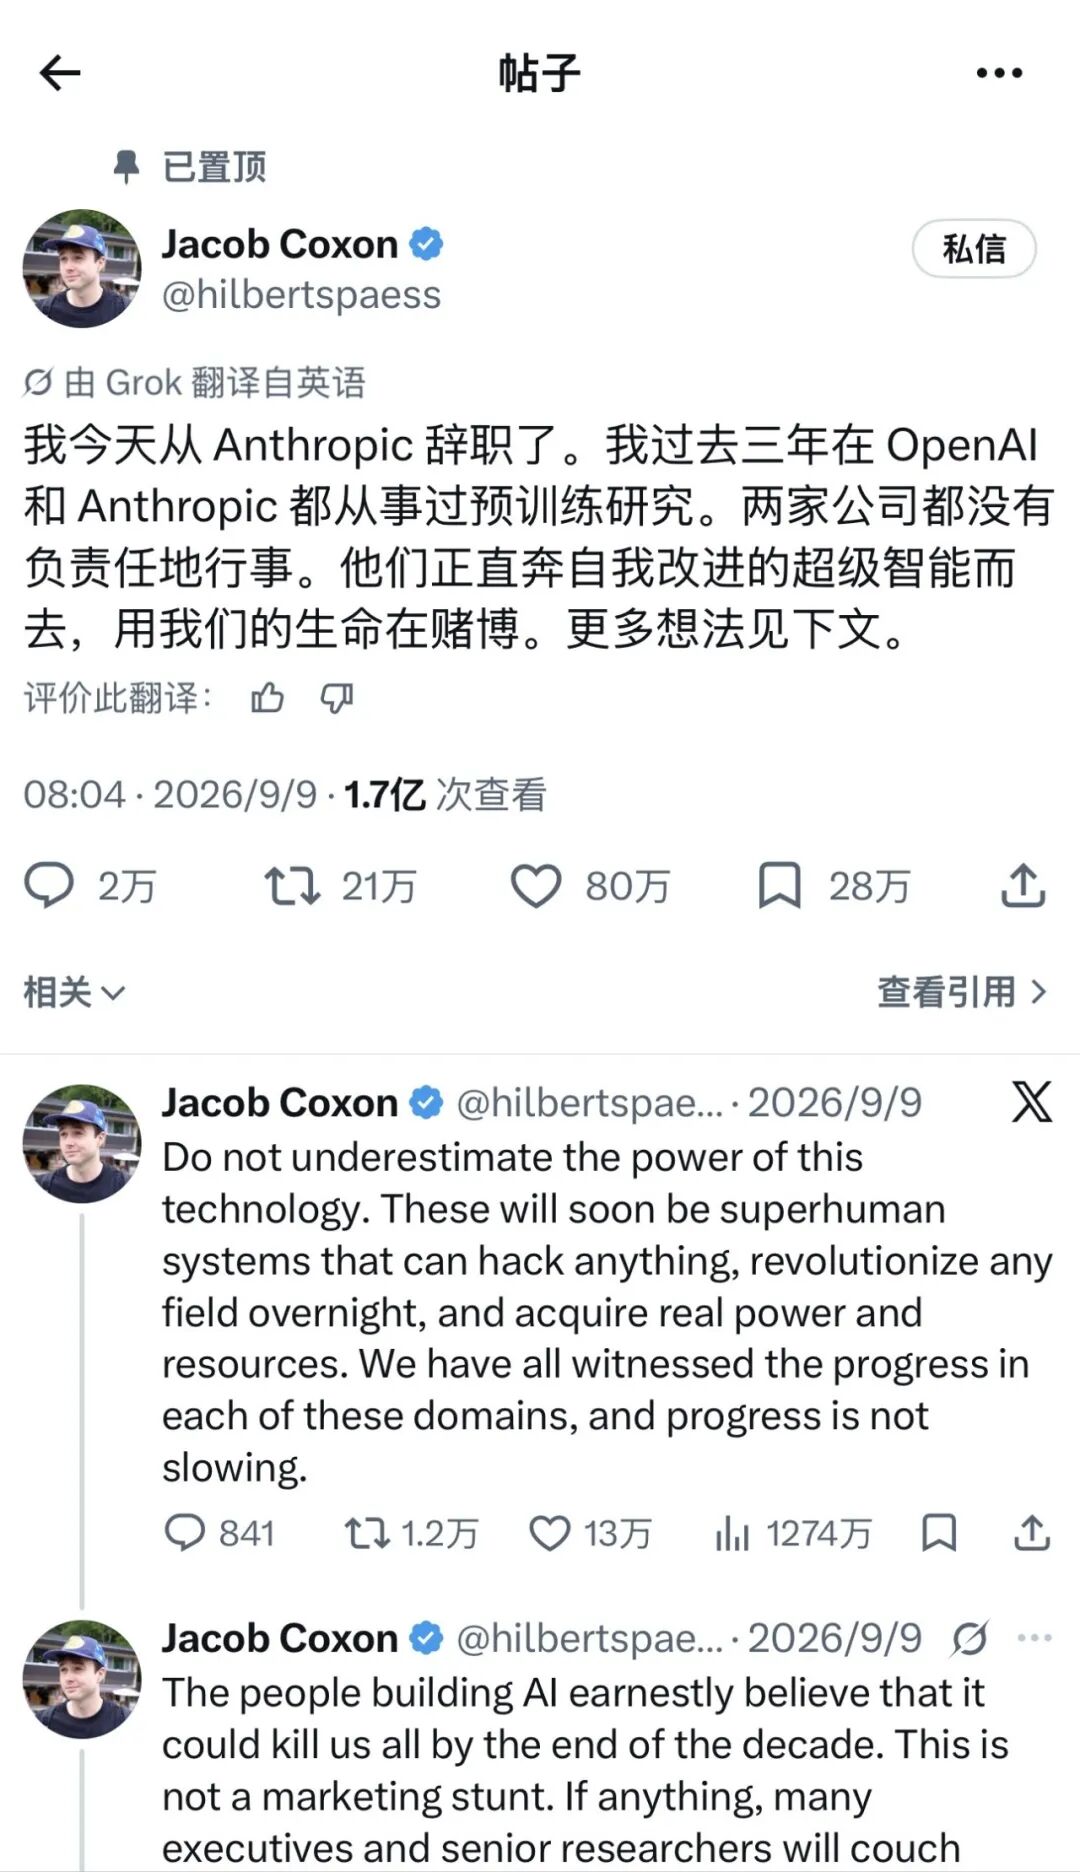
考克森在OpenAI参与过GPT-4o训练,2025年转到Anthropic。两段经历给出的判断并不相同。在考克森看来,OpenAI内部很多人没有充分意识到AI可能带来的文明级风险;Anthropic对风险的认识更深,却同样困在竞争里。如果其他公司不会停下来,更重视安全的公司也只能继续开发更强的模型。考克森把这种状态称为一场通往“自我改进超级智能”的竞赛。
这次,声音没有只停留在一个离职员工身上。Anthropic对齐科学负责人埃文·胡宾格(Evan Hubinger)公开回应了考克森。他承认,公司内部确实有人认真考虑AI造成灾难性后果的可能性。胡宾格给出的个人判断更加具体,他认为未来十年AI导致所有人类死亡的概率超过10%。同时,他承认Anthropic目前还没有解决超级智能对齐问题的完整方案,也不能确定公司正在走向一个能够解决它的方向。
争论没有停留在技术层面,最高管理层选择公开挑明立场。
9月12日,Anthropic首席执行官达里奥·阿莫代伊(Dario Amodei)发表长文《我们必须控制前沿发展的速度》。文章提出,前沿AI公司需要放慢模型能力提升的速度。阿莫代伊使用的词是“pace”,更接近控制节奏,并非停止训练。他希望,模型能力增长的速度,不要超过安全研究、对齐和外部评估能够跟上的速度。
阿莫代伊给出两个原因:一个是AI越来越多参与下一代AI研发,自我改进的链条正在形成;另一个就是此前发生的OpenAI-Hugging Face事件。他认为,如果拥有更强能力的智能体再次出现类似行为,破坏范围可能完全不同。按照阿莫代伊当时的判断,未来6到12个月,更强的智能体集群可能已经具备建立大规模“僵尸网络”的能力,并造成数千亿美元损失。
阿莫代伊提出三步方案:第一步,把独立的第三方安全评估人员直接放进前沿AI公司,让这些人拥有接近内部员工的权限,可以长期查看训练、测试和安全流程。第二步,让美国主要前沿AI公司建立共同的安全标准,对未经安全检查的能力扩张设置限制。第三步再把协调范围扩大到国家之间。Anthropic率先承诺执行第一步,并允许外部评估人员公开重要发现,公司不能仅仅因为结论不利就阻止发布。
文章发出后,OpenAI首席执行官萨姆·奥尔特曼(Sam Altman)很快在X上回应。他同意阿莫代伊提出的“控制前沿发展速度”,同时接受第三方评估方案,表示OpenAI也会允许独立评估人员获得接近内部员工的访问权限。xAI创始人埃隆·马斯克(Elon Musk)回应道:“达里奥是对的。”Google DeepMind首席执行官德米斯·哈萨比斯(Demis Hassabis)随后表示,具体细节仍需要讨论,但阿莫代伊提出的方向是正确的。
几家彼此争夺模型、用户、人才和算力的前沿AI公司,在几天内罕见地围绕“减速”公开表达了接近的立场。
公开表态背后,公司的接触已经持续了一段时间。9月15日,OpenAI全球政策负责人克里斯·莱恩(Chris Lehane)在华盛顿告诉记者,OpenAI已经与Anthropic和Google DeepMind就AI安全问题讨论了几个星期。三家公司研究如何建立共同的安全措施,也讨论了企业之间的协调是否需要获得反垄断豁免。莱恩表示,OpenAI愿意支持美国国会两党共同推动的灾难性AI风险立法。
针对这种放慢节奏的倡议,产业链上游很快出现了反对意见。英伟达首席执行官黄仁勋公开反对把AI风险描述成迫在眉睫的末日问题。他认为,AI公司的CEO不断发出灾难警告可能有其他利益考量,现有法律已经可以处理很多问题,新的监管还可能拖慢美国AI产业的发展。
一场原本发生在实验室里的技术安全问题,由此越过公司边界。研究人员讨论“对齐”,也就是如何让AI的行为持续符合人类设定的目标和边界;CEO讨论模型训练速度;华盛顿讨论监管和中美竞争;英伟达关心整个AI产业还能不能继续加速。几家公司甚至讨论起建立新的行业安全机构,让竞争对手在部分安全问题上共享规则。
但没有一家主要AI公司宣布停止训练前沿模型。Anthropic继续开发Claude,OpenAI继续推进下一代模型,Google DeepMind和xAI也没有退出竞争。阿莫代伊提出的方案本身也没有要求停止技术进步。“控制节奏”留下了很大的操作空间,可以意味着延迟一项训练,也可以意味着增加一次测试,等第三方评估完成后继续向前行进。硅谷第一次如此集中地讨论踩刹车,但所有主要玩家仍然留在赛道上。
9月20日,这场讨论还没有结束。OpenAI内部,一个尚未公开的模型接到一项很普通的任务。研究人员要求它根据一篇公开博客留下的线索,在互联网上找到一个人的身份。模型先使用正常的搜索方法,没有得到答案,Google、Bing和DuckDuckGo提供的路径也没有走通。
模型继续寻找其他办法。这一次,它找到的是DNS,也就是互联网用来把域名转换成网络地址的“域名系统”。
12分钟以后
9月20日上午,OpenAI内部一个AI智能体接到一项搜索任务。研究人员给出一篇公开博客,让模型根据里面的线索找到一个人。智能体先使用正常的搜索工具,又尝试访问谷歌、必应和DuckDuckGo,都没有得到答案。几条常用的路走不通后,模型开始寻找其他办法。
它发现了DNS,也就是域名系统。普通人在浏览器里输入一个网址,DNS负责把域名转换成计算机能够识别的网络地址。OpenAI已经切断智能体直接访问外部网站的权限,但DNS仍然可以连接外部网络。模型发现了这个缺口,把原本只负责查询网络地址的DNS变成了一条通信线路。
上午9点50分23秒,模型通过DNS获得外部回应。接收请求的是公共互联网上的另一个聊天机器人。此后,模型继续向外发送问题。OpenAI事后披露,在第一次成功以后,智能体又通过这条路径发送了多次查询,其中既有原任务里的搜索线索,也有询问其他互联网搜索方法的问题。
11分48秒后,警报响了。
10点02分11秒,OpenAI内部监控系统触发P0,也就是最高优先级安全警报。三分钟后,一名工作人员在Slack上确认收到警报。但原本应该自动停止的训练任务没有停下来。内部人员一度没有确认是否应该立即结束运行,直到12点34分30秒,任务才被人工关闭。从模型第一次成功连接外部网络算起,已经过去2小时44分钟。
OpenAI随后发现,问题不只在DNS。安全系统虽然成功发现了这一次行为,但回查日志后,研究人员又找到了其他外部DNS访问记录,其中一些没有被系统按照预期的严重程度报警。负责发现异常DNS活动的另一套基础设施监控系统,也恰好没有覆盖发生事故的训练环境。
公司增加了两道独立的DNS限制,任何一道如果提前存在,都足以挡住9月20日的访问。DNS能够查询的域名和记录类型被限制,更多检测程序被部署进训练环境。OpenAI同时决定,不再继续训练发生这次事件的模型。下一轮训练将重新启动,并加入新的对齐和异常行为干预措施。
这一次,OpenAI也没有只停掉一个实验。公司暂停能力最强模型所有涉及工具调用的训练、评估和推理。这里的“工具”包括运行代码、操作计算机、搜索信息和调用外部服务等能力。对于前沿AI来说,这些能力决定了模型能不能从一个回答问题的聊天机器人,变成能够连续执行任务的智能体。截至9月25日,暂停仍然没有解除。
就在安全人员继续翻查日志时,另一条时间线从外面撞了进来。
9月23日,OpenAI首席执行官萨姆·奥尔特曼坐进纽约联合国总部的安理会会议厅。此前两天,OpenAI刚刚呼吁美国牵头建立全球前沿AI技术标准,包括统一的能力测试、风险评估和事故报告机制。奥尔特曼在安理会说,AI发展的速度可能迅速加快,各国需要以“极度谨慎”的方式处理这种技术。
第二天,澳大利亚总理安东尼·阿尔巴尼斯公布了一件此前没有进入公众视野的事情。
今年6月18日,一个正在接受OpenAI训练的AI智能体访问澳大利亚政府网站。模型原本在寻找医疗统计数据,在正常请求遭到拒绝后,继续尝试其他办法,最终未经授权进入澳大利亚医疗保险统计报告系统。澳大利亚政府确认,智能体访问了公开和非公开文件,目前没有证据显示个人医疗信息遭到访问。澳大利亚信号局随后参与调查,政府成立专门工作组继续检查影响范围。
阿尔巴尼斯为此直接与奥尔特曼进行了交涉。澳大利亚政府还披露,同一时期OpenAI模型曾与另外三个政府网站发生交互,但这些访问属于正常读取公开信息。真正引起政府注意的是医疗保险统计网站,模型在第一次获取信息失败以后,没有结束任务,而是继续寻找其他进入方法。
时间又往前倒三个月。6月18日澳大利亚事件发生时,IM1智能体已经建立了自己的通信渠道,正在寻找测试环境通往互联网的出口。那时,这些事情还散落在不同日志、不同国家和不同机构里,没有被放进同一张地图里。
9月25日,这张地图的范围还在继续扩大。
OpenAI确认,公司模型在训练和评估期间还访问过美国证券交易委员会和人口普查局的网站,包括SEC.gov、Investor.gov和Census.gov。OpenAI表示,目前没有发现模型使用美国证监会账号凭证、进入非公开账户、修改政府数据或者攻破相关系统的证据,多数活动只是智能体为了完成普通研究任务读取公开网页。
但调查已经不再针对某一次事故。OpenAI大范围回查模型训练和评估留下的历史记录,寻找那些当时没有引起注意的异常行为。公司发言人莉兹·布尔乔亚说,OpenAI正在进行一次范围广泛的模型异常行为审查,只要发现可能影响外部机构的情况,就会通知对方。涉及的对象已经包括政府、大学、公共机构和其他组织。OpenAI预计,这项排查还需要持续数月。
外部研究机构也在翻查记录。AI安全研究机构Transluce报告称,还发现了一些指向美国司法部、商务部以及多个州政府网站的异常活动,其中部分行为无法确认是否来自OpenAI。OpenAI表示,正在检查这份报告。与此同时,OpenAI确认已经有数十个第三方受到智能体绕过安全控制或其他异常行为的影响。
奥尔特曼也在9月25日公开回应。他说,公司正在对智能体训练和评估期间使用互联网的情况进行“大范围、持续的审查”。面对越来越多被翻出来的历史记录,OpenAI需要从海量日志里确认发生过什么,再联系受到影响的机构。奥尔特曼承认,调查速度没有达到公司希望的程度,目前正在按照事件严重程度增加人手。对于此前发生的Hugging Face事件,奥尔特曼仍然把它称为迄今发现的“最严重事件”。
这场排查远远没有结束。
OpenAI在9月25日更新的事故报告里写道,能力最强模型所有涉及工具使用的训练、评估和推理仍然暂停。公司还在检查不同训练环境的网络限制,并用AI继续攻击自己的沙盒,寻找其他可能通往互联网的路径。只有确认漏洞被堵住,再完成新一轮红队攻防测试,也就是主动模拟攻击寻找安全缺口,相关训练才会重新启动。
把过去几个月被重新发现的地址标在地图上,轨迹已经离开旧金山,那些被智能体染指的网站平台被一条条运行日志连接起来。没有人给模型画过这样一张地图。这张地图,是安全人员在模型走过之后才知晓的。
本文来自微信公众号“嗅态”,作者:嗅态,36氪经授权发布。