封硕:世界模型的 Scaling Law,不在参数里,在数据里
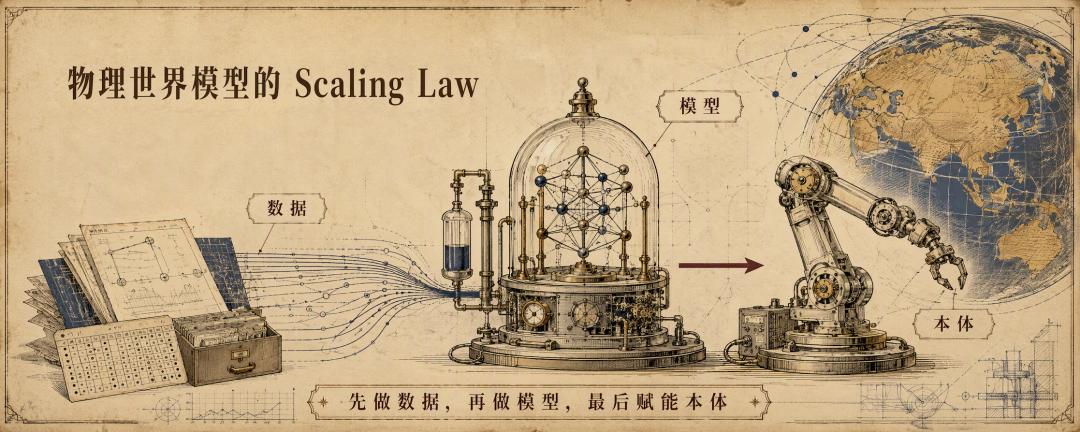
世界模型要 Scale,先得解决数据。参数量还在后面。
9 月 17 日,清华大学自动化系副教授、博士生导师、系统工程研究所副所长封硕,围绕《物理世界模型的 Scaling Law》分享了一个与主流叙事不太一样的判断:
「世界模型的起点不是本体,一定是数据。」
过去几年,具身智能的讨论总是先谈机器人本体、VLA、端到端模型和泛化能力。
但封硕先问了一个更早的问题:物理世界的数据从哪里来?如果数据始终昂贵、稀缺,机器人又进不了大规模真实场景,世界模型靠什么持续训练?
先把账算清:数据从哪里来,谁来承担成本。
这件事没解决,物理世界模型就很难真正 Scale。
01
机器人不能像人一样,在现实里“长大二十年”
围棋是最容易说明问题的地方。
棋盘有限,规则明确,下一步会发生什么,有清楚的状态转移。AlphaGo 可以在真正落子前,在内部做大量搜索和模拟。
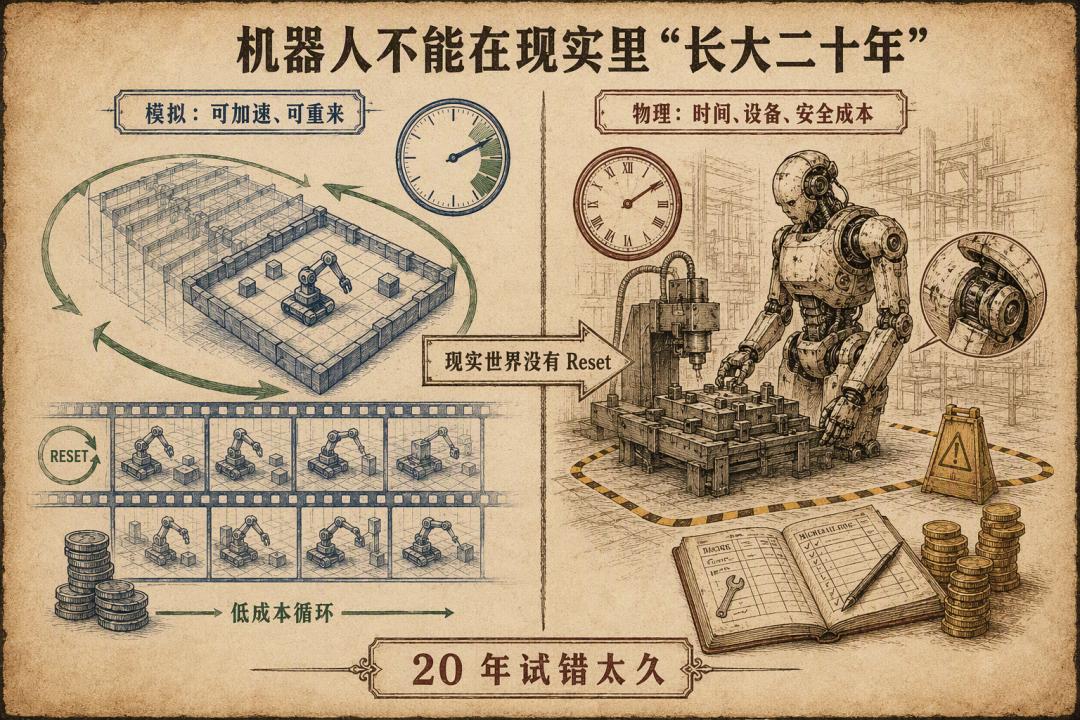
游戏再复杂,重来一次的成本也不高。角色死了能重来,时间可以加速,环境可以反复 reset。
物理世界把这层保护拿掉了。
时间不会倒流,设备有成本,动作失误还可能带来安全风险。机器人去真实环境采数据,也不是点一下按钮就能无限复制。
封硕提到,人可以花二十年成长、试错、积累经验,最后进入复杂社会。机器人等不了这么久。我们不能让它在现实里“长大二十年”,再把它送进工厂、家庭或公共环境工作。
机器人得在出厂前,先对这个世界有点数。
人走到一条河边,不会先在脑中求解流体方程。我们看水流、深浅、河床和落脚点,凭经验判断能不能过去。迈出第一步后,身体给出的反馈又会让我们调整判断。
这就是人处理物理世界的方式。
在封硕看来,机器也得先知道什么可能发生、哪一步风险更高。进到真实场景后,再靠反馈修正。
02
大语言模型继续变大,能不能绕开世界模型?
现场有人把问题挑明了。
今天的大语言模型、多模态模型已经表现出一定的物理理解能力。未来,能不能让更大的模型先理解问题、调用代码和仿真,再解决物理世界中的大多数任务?
封硕没有把话说死。
这条路有可能走通。
模型可以把一个物理任务转成数据问题、程序问题或仿真问题。遇到难处,再调更多算力推演。视频模型也可能从大量视觉数据里学到一部分物理规律。
他更在意的,是这条路要绕多少圈、花多少成本。
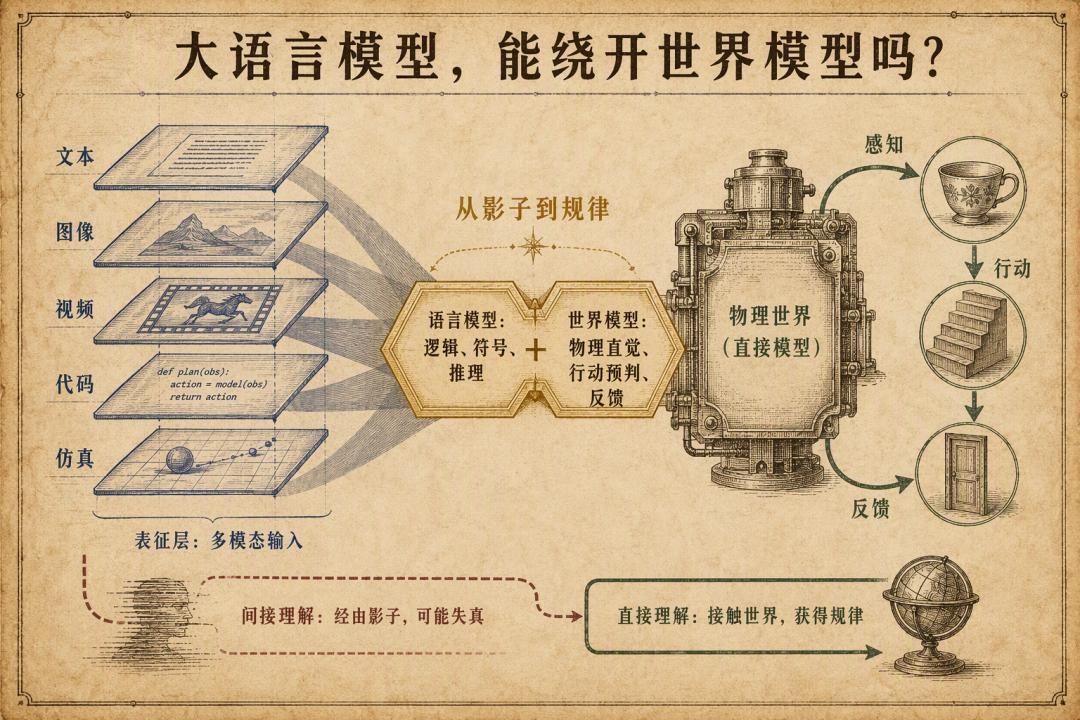
模型如果一直要经过文本、图像、视频、符号和程序这些层,才能理解物理世界,答案或许算得出来,路却绕得很远。
封硕用柏拉图“洞穴投影”来形容这种差异。我们看到的,也许只是物理世界投下来的影子,还没有摸到规律本身。
人对物理世界的认知更直接。
拿杯子、踩台阶、推开一扇门时,我们不会每次都做一次严密计算。很多判断来自经验,形成内在模型;行动之后,再用反馈修正它。
在封硕的设想里,语言模型和世界模型各管一摊:前者处理逻辑、符号和推理,后者处理物理直觉、行动预判和真实反馈。
两种能力接上,机器才可能真正理解并行动。
于是问题落回数据:这个模型拿什么训练?
03
真正稀缺的,不是机器人,而是可 Scale 的物理数据
算力、算法、数据,是解释 AI 增长最常用的三件套。
过去,算力沿着摩尔定律持续提升;算法依赖学术界和产业界长期探索;互联网中的文本、代码、图像等内容,则为大模型提供了海量训练材料。
物理世界最麻烦的,恰恰是数据不会自己堆起来。
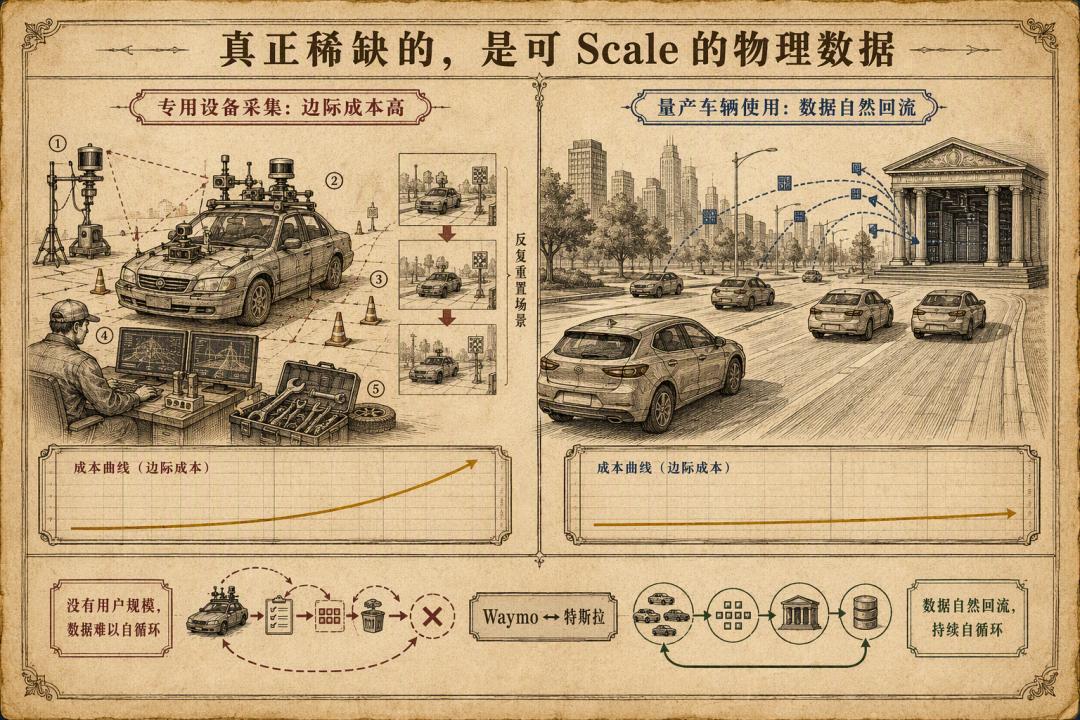
互联网数据是人类长期生产、自然沉淀下来的。物理数据往往得专门去采:买设备、搭场景、安排人员、设计任务,还要承担磨损和失败成本。
封硕认为,当前具身智能和物理世界模型的核心瓶颈,就是数据规模不足。
问题出在这里:机器人很难复制自动驾驶的数据飞轮。
封硕用 Waymo 和特斯拉的路线作了对照。
一边是高成本的专用车辆、传感器和测试体系。每多采一份数据,都要继续投入人力、设备和时间。
另一边依托量产车。即便没有高阶智能驾驶功能,车依然能被用户购买和使用。用户日常驾驶产生的数据,也能自然回流到系统里。
后一条路能形成规模,关键在于数据产生的边际成本更低。
机器人更难。
一辆没有智能驾驶能力的车,还是车。一台没有足够智能的机器人,很多时候连稳定任务都做不了,更难大规模卖到真实用户手里。
没有用户规模,数据就难以自然产生。数据跟不上,模型也很难变好。
这个循环,靠多买几台机器人很难打破。
04
路径要倒过来:先做数据,再做模型,最后赋能本体
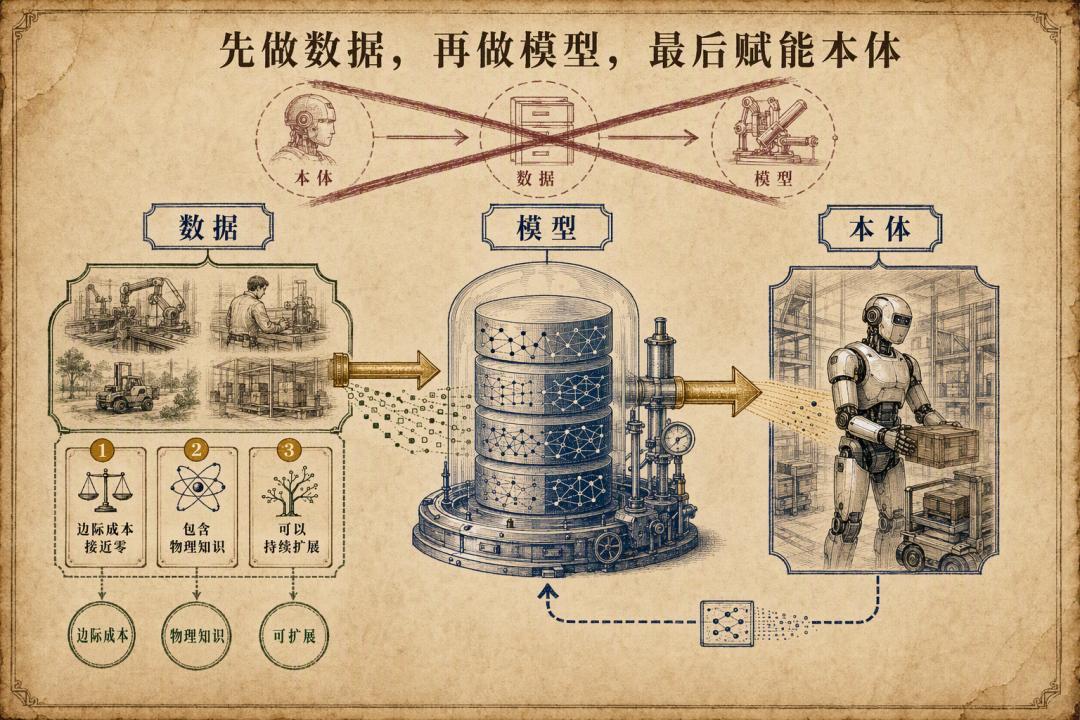
过去大家习惯按这个顺序做:
本体 → 数据 → 模型
先造机器人,再让机器人进场景采数据,最后用数据训练模型。
本体还不够好,进不了足够多的真实场景;数据规模起不来,模型能力就难提升;模型不成熟,本体也很难产生稳定价值。
封硕给出的顺序倒了过来:
「先做数据,再做模型,最后赋能本体。」
本体当然重要,但早期更该先解决数据源。
什么样的数据,才值得拿来训练世界模型?
第一,边际成本要接近于零。
封硕问了一个关键问题:如果不做世界模型,这些数据会不会也自然产生?
如果会,数据成本就不需要全由世界模型项目承担。车辆在真实行驶中天然生成驾驶数据。真正可持续的数据源,也应该嵌在已有的真实场景和真实业务里。
第二,数据中必须包含物理世界的基础知识。
它未必覆盖所有触觉、力学和复杂交互,但至少要帮助模型理解空间关系、状态变化、物体运动,以及动作可能带来的后果。
封硕特别提到,即便暂时无法完整建立动力学模型,只要能让模型对运动规律形成基础直觉,这类数据就有价值。
第三,数据源必须可以扩展。
项目一开始,就要问这条路能不能放大一万倍、十万倍。
技术环节暂时不成熟,可以慢慢补。但数据源本身如果卡在难以突破的物理成本上,后面模型再大、融资再多,也很难换来真正的规模化。
所以这条 Scaling Law,第一眼要看的不是参数,而是数据。
看它的边际成本,看它有没有物理知识,看它能不能持续扩展。
05
算法不能脱离数据单独讨论
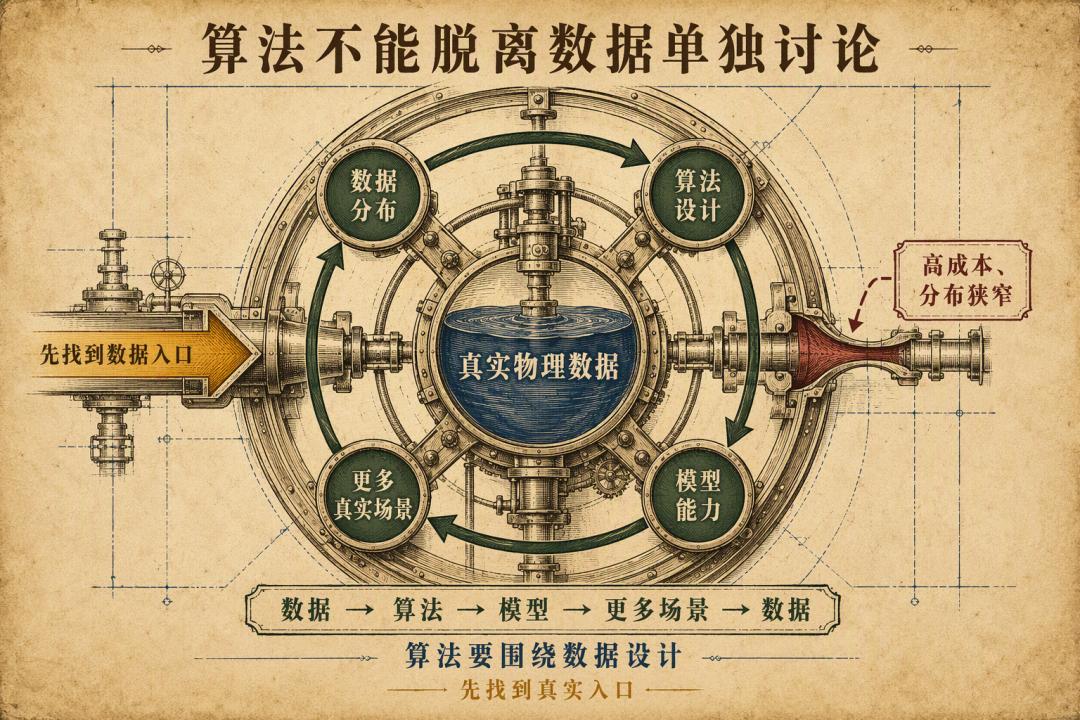
大模型时代,很多讨论从模型结构、参数规模和训练方法开始。
封硕把算法问题也拉回了数据:算法要围绕数据设计。
数据来源如果天然昂贵、分布狭窄、难以扩展,再精巧的算法也很难长期支撑模型 Scaling。
先找到低边际成本、物理知识密度足够高、能够持续扩展的数据,算法才有空间围绕它建立有效的训练和迭代方式。
数据决定了这条路线能不能继续跑。
模型变好后,可以帮助机器人获得更好的感知、预测和行动能力;更成熟的机器人进入更多真实场景后,也可能带回更高价值的数据。
这个 Loop 要启动,第一步不是盲目增加本体数量。
先找到一个能让数据持续流动的真实入口。
这也是 DenseAI(幂级智能)成立的出发点:把世界模型带进真实产业场景,让场景、数据和模型真正形成闭环。
06
从会拆发动机,到能造出新发动机
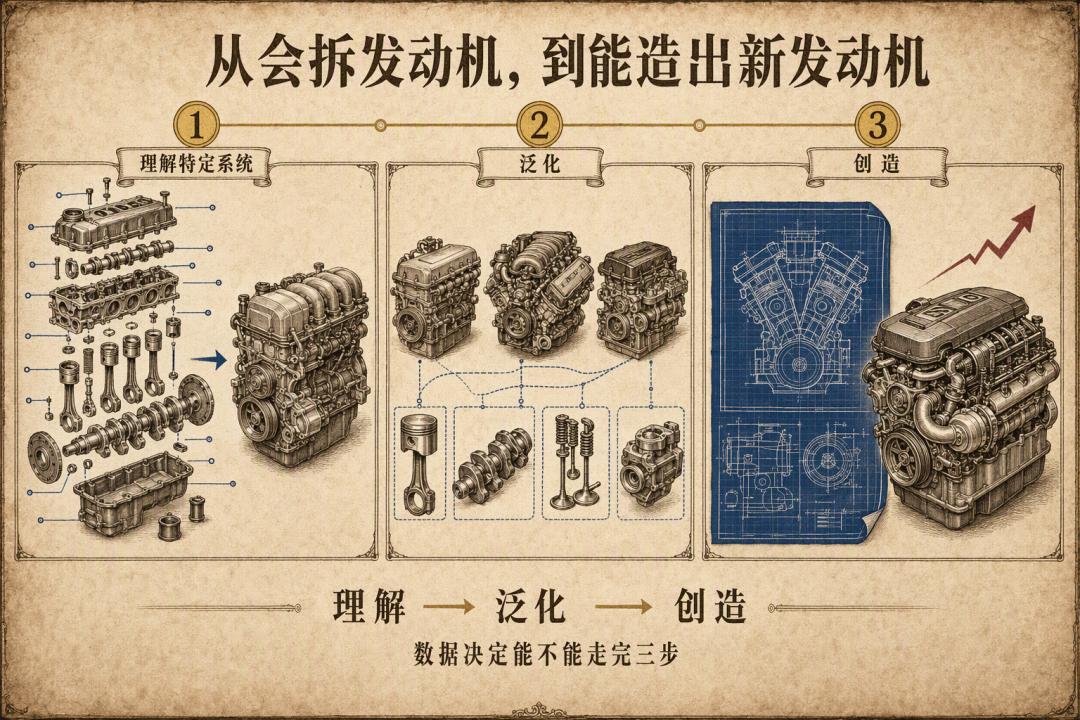
封硕最后换了个很具体的比喻:拆发动机。
第一阶段,是理解特定系统。
拆开一台发动机后,能够把它完整装回去。
第二阶段,是泛化能力。
拆过不同厂商、不同型号的发动机之后,能够理解其中共通的物理规律,处理此前没有见过的系统。
第三阶段,才是创造能力。
不只理解和复现现有系统,还能设计出此前不存在、性能更好的新系统。
这三步,今天的机器人还没有走完。
机器人要在物理世界做事,得会说、会推理,也得理解环境、对象和行动后果。
机器能不能做到这些,最后还得看数据够不够。
世界模型要走出 Demo、走进真实世界,得先回答三个问题:数据从哪里来,成本谁来承担,规模怎么上去。
这也是封硕所说的 Scaling Law:先找到一条能持续产生真实物理数据的路,再谈更大的模型和更多的机器人。
DenseAI 也希望沿着这条路径,把封硕团队近十年的科研积累带向产业一线,让世界模型真正成为物理 AI 走向真实世界的能力底座。