Das Team von Yao Shunyu bei Tencent reagiert spät in der Nacht auf alle Punkte: unzureichende Rechenkapazität, künstliches Hochschieben von Modellen in Ranglisten, tiefgreifende umfassende Überlegungen zu Leiting.
Bericht von Zhidx am 21. November: Heute früh veranstaltete das Hunyuan-Team von Tencent auf der Social-Media-Plattform Reddit eine AMA-Veranstaltung, um mit Entwicklern aus aller Welt über die Modelle der Hy4-Serie zu kommunizieren. Yao Shunyu war auch im Kommentarbereich zu sehen, aber wir wissen nicht, welches Konto sein anonymes Profil ist.
▲ Yao Shunyu kündigte diese Reddit-AMA-Veranstaltung auf X an (Quelle: X)
Diese AMA findet zu einem sehr interessanten Zeitpunkt statt.
Erst gestern hat Tencent die Gewichte des Flaggschiffmodells Hy4 freigegeben und eine Sicherheitsbewertungskarte für das Modell (System Card) veröffentlicht. Einige Tage zuvor hat Tencent zudem Hy4 flash auf den Markt gebracht, das auf niedrige Kosten und hohe Effizienz abzielt. Die aufeinanderfolgende Veröffentlichung der beiden Modelle hat den technischen Weg von Tencent Hunyuan zum Mittelpunkt der Aufmerksamkeit der Community gemacht.
Gleichzeitig verändert sich der Wettbewerb in der KI-Branche. Kürzlich hat die unabhängige Modellbewertungsstelle Artificial Analysis ihr Bewertungssystem stark angepasst, sodass die Bewertungen einiger chinesischer Modelle schwanken. Vor dem Hintergrund des eingeschränkten Zugangs zu hochwertiger Rechenleistung und der fortlaufenden Iteration globaler Spitzenmodelle ist die Frage, wie chinesische Modelle die Lücke zu den Spitzenmodellen verkleinern können, zu einem Anliegen der Entwickler geworden.
Zhidx hat ebenfalls an dieser AMA teilgenommen und dem Hunyuan-Team von Tencent eine Frage gestellt: Da der Zugang zu fortschrittlichen KI-Chips immer stärker eingeschränkt wird, kann Tencent die Lücke seiner Hy-Modelle zu den globalen Spitzenmodellen in Zukunft weiter verkleinern?
Ein Mitglied des Hunyuan-Teams antwortete: „Wir nutzen die vorhandenen Ressourcen so umfassend wie möglich, um das Spitzenniveau einzuholen.“
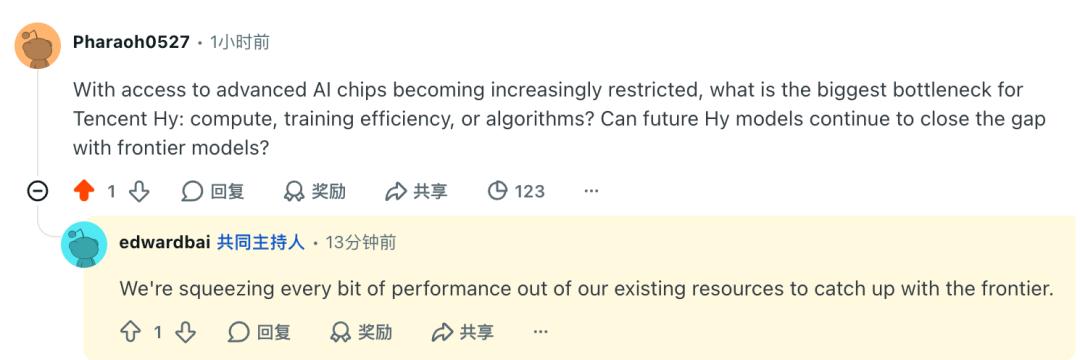
▲ Das Hunyuan-Team beantwortet die Frage von Zhidx (Quelle: Zhidx)
Neben Fragen zur Rechenleistung hat das Hunyuan-Team von Tencent bei diesem Austausch viele weitere neue Informationen preisgegeben.
Bezüglich der Modellgröße hat das Hunyuan-Team klar angegeben, dass das nächste Hy-Modell die Parametergröße weiter vergrößern wird, während gleichzeitig weiterhin in groß angelegtes verstärkendes Lernen investiert wird.
Für kleinere Modelle hat das Team mitgeteilt, dass Produkte wie Flash-Lite und Modelle für Geräte mit 24 GB Videospeicher in Planung sind.
Auf technischer Ebene hat Tencent bei diesem Austausch erstmals einige Details zur Architekturauswahl von Hy4 offengelegt. Das Team hat lange zwischen den beiden Aufmerksamkeitsmechanismen GQA und MLA abgewogen und sich schließlich für die MLA-Architektur entschieden, weil DSA den Rechenaufwand von MLA in der Decodierungsphase senkt.
Darüber hinaus hat das Hy-Team von Tencent auch auf Fragen wie Modellbewertung, Sicherheitsbeschränkungen, KI-Programmierökosystem und die Möglichkeit des rekursiven Selbstverbesserung (RSI) von Modellen geantwortet.
Hy4 ist das neueste Flaggschiffmodell von Tencent, das Fähigkeiten wie langfristiges Software-Engineering, Tool-Aufruf, visuelle Verständnis und wissenschaftliche Forschung besonders stärkt. Hy4 flash optimiert zudem die Inferenzkosten weiter: Es hat eine Gesamtparameterzahl von 224B, darunter 64B Engram-Parameter, und aktiviert nur 12B Parameter pro Token.
Laut den von Tencent veröffentlichten Daten sind die Kosten pro Aufgabe von Hy4 flash nur 1/20 der Kosten von Hy4 bei der selbst erstellten Bewertung für tägliche Arbeitsaufgaben WorkIndex. In einem Blindtest mit 85 internen Nutzern und 259 Arbeitsaufgaben betrugen die Kosten pro Aufgabe etwa 0,26 Yuan.
Allerdings besteht bei Hy4 bei einigen schwierigen Aufgaben noch eine Lücke zu den globalen Spitzenmodellen mit geschlossenen Quellen. Wie man die Fähigkeiten des Modells bei begrenzter Rechenleistung weiter verbessert und gleichzeitig Inferenzkosten, Produkterfahrung und Open-Source-Ökosystem berücksichtigt, ist weiterhin ein Problem, mit dem sich das Hunyuan-Team auseinandersetzen muss.
Im Folgenden finden Sie die von Zhidx aus dieser AMA zusammengestellten Schwerpunkte, die zur besseren Lesbarkeit ohne Änderung des ursprünglichen Sinns aufbereitet wurden:
Adresse der vollständigen Frage-Antwort-Runde:
https://www.reddit.com/r/LocalLLaMA/comments/1y15w4a/tencent_hy_team_shunyu_yao_here_ask_us_anything/
01 .
Mit begrenzter Rechenleistung das Spitzenniveau einholen
Das nächste Modell wird stark erweitert
Kleinere Modelle sind in Arbeit
(1) Frage von Zhidx: Da der Zugang zu fortschrittlichen KI-Chips zunehmend eingeschränkt wird, was ist der größte Engpass, mit dem Tencent Hy derzeit konfrontiert ist? Ist es die Rechenleistung, die Trainingseffizienz oder der Algorithmus? Kann die Hy-Serie in Zukunft die Lücke zu den globalen Spitzenmodellen weiter verkleinern?
Tencent Hunyuan: Wir nutzen die vorhandenen Ressourcen so umfassend wie möglich, um das Spitzenniveau einzuholen.
(2) Frage eines Nutzers: Ist geplant, die Parametergröße von Hy4.5 in Zukunft auf 1,5 Billionen bis 2 Billionen zu erweitern?
Tencent Hunyuan: Das nächste Hy-Modell wird definitiv die Größe weiter stark vergrößern.
(3) Frage eines Nutzers: Glauben Sie, dass die aktuellen Modelle der Hy-Serie bereits nahe an der Obergrenze ihrer Fähigkeiten sind? Müssen zukünftige leistungsstärkere Modelle unbedingt die Parameterzahl erhöhen, oder können sie die vorhandene Größe beibehalten und ihre Fähigkeiten durch Nachtraining weiter verbessern?
Tencent Hunyuan: Wir sind überzeugt, dass Hy4 noch viel Verbesserungspotenzial hat, insbesondere beim Nachtraining. Wir investieren stark in groß angelegtes verstärkendes Lernen (RL) und verbessern kontinuierlich die Nutzererfahrung und die Modellsicherheit. Freuen Sie sich auf zukünftige Updates. Wir planen auch, Modelle mit größerer Größe zu trainieren. Wir sind fest von der Bedeutung des Scaling-Prinzips überzeugt und werden diesen Weg weiterverfolgen.
(4) Frage eines Nutzers: Unternehmen wie ByteDance und Kimi scheinen sich Modellen mit ultrahohen Parameterzahlen von 3T oder sogar 5T zu widmen, während die Hy-Serie von Tencent noch bei einer Größe von etwa 700B liegt. Warum haben Sie diesen Weg gewählt? Wie bewerten Sie den Einfluss der Parameterzahl auf die Intelligenz des Modells? Planen Sie, die Modellgröße in Zukunft weiter zu erweitern?
Tencent Hunyuan: Hy3 und Hy4 haben bereits bewiesen, dass kleinere, aber gründlich trainierte Modelle oft auch größere Modelle übertreffen können. Noch wichtiger ist, dass kleinere Modelle niedrigere Kosten verursachen und wir während der Entwicklung mehr lernen und mehr Erfahrungen sammeln können.
(5) Frage mehrerer Nutzer zusammengefasst: Wird Tencent in Zukunft Hy4-mini und dichte Modelle mit einer Größe von 24B bis 31B veröffentlichen? Gibt es Pläne für kleine Modelle, die auf Geräten mit 24 GB Videospeicher und 64 GB bis 128 GB Arbeitsspeicher ausgeführt werden können? Welche Pläne gibt es für Modelle mit weniger als 100B Parametern, die speziell für Programmieraufgaben optimiert sind?
Tencent Hunyuan: Hy4-mini ist bereits in der Entwicklungs-Roadmap, und in Zukunft werden weitere kleine Modelle veröffentlicht. Für dichte Modelle mit einer Größe von 24B bis 31B zieht das Team dies in Betracht; auch die Veröffentlichung von kleineren dichten Modellen ist möglich, aber derzeit werden wahrscheinlich keine speziellen Modelle mit weniger als 100B Parametern für Programmieraufgaben entwickelt.
Bezüglich der lokalen Bereitstellung hat das Hunyuan-Team bestätigt, dass es in Zukunft Modelle für Geräte mit 24 GB Videospeicher veröffentlichen und weiterhin Modelle entwickeln wird, die für Geräte mit 64 GB bis 128 GB Arbeitsspeicher geeignet sind. Das Team hat auch positiv auf die Frage nach offenen Gewichtsmodellen ähnlicher Größe wie die aktuellen Modelle geantwortet, die nach Q4-Quantisierung für Geräte mit 128 GB Arbeitsspeicher geeignet sind.
Darüber hinaus wird Hy4 flash weiter aktualisiert, das Team optimiert derzeit die Vor- und Nachtrainingsverfahren für Modelle der Flash-Klasse. Zur Positionierung von Hy4 und Hy4 flash hat das Team erklärt, dass beide Modelle universelle Modelle sind und nicht speziell für Programmieraufgaben trainiert wurden.
(6) Frage mehrerer Nutzer zusammengefasst: Wird Tencent neben Sprachmodellen auch kleinere Open-Source-Bildmodelle veröffentlichen und Modelle für Videogenerierung und Übersetzung aktualisieren? Unterstützt Hy4 die Erkennung von Dialekten und Echtzeit-Sprachübersetzung? Welche Fortschritte wurden beim kontinuierlichen Lernen und der Künstlichen Allgemeinen Intelligenz (AGI) erzielt?
Tencent Hunyuan: Für die Bildgenerierung hat das Team mitgeteilt, dass es die Veröffentlichung kleinerer Bildmodelle in Betracht zieht, und empfiehlt Entwicklern, in Kürze die Entwicklungen bei Videomodellen zu verfolgen, ohne jedoch einen genauen Veröffentlichungszeitpunkt zu nennen.
Bezüglich der Übersetzung hat das Team bestätigt, dass das Hy-MT-Übersetzungsmodell bald aktualisiert wird, und erklärt, dass es den Vorschlag der Nutzer zur Übersetzung chinesischer Internetromane ernsthaft prüfen wird.
Zur Erkennung von Dialekten und Echtzeit-Sprachübersetzung gibt das Hunyuan-Team offen zu, dass Hy4 derzeit keine Audioverarbeitung oder Audiogenerierung unterstützt, aber Nutzer können die Spracherkennungsfunktionen (ASR) und Sprachsynthesefunktionen (TTS) von Tencent Yuanbao ausprobieren, die möglicherweise ihre Anforderungen erfüllen.
Zum kontinuierlichen Lernen ist das Team der Ansicht, dass es ein vielversprechendes Forschungsgebiet ist, an dem es derzeit aktiv arbeitet, ohne jedoch konkrete Ergebnisse preiszugeben.
Darüber hinaus hat ein Nutzer auf das AGI-Fähigkeitsklassifizierungssystem verwiesen und gefragt, welches Niveau Hy4 derzeit erreicht hat. Ein Mitglied des Hunyuan-Teams hat eine persönliche Einschätzung abgegeben – „etwa Stufe 2,5.“
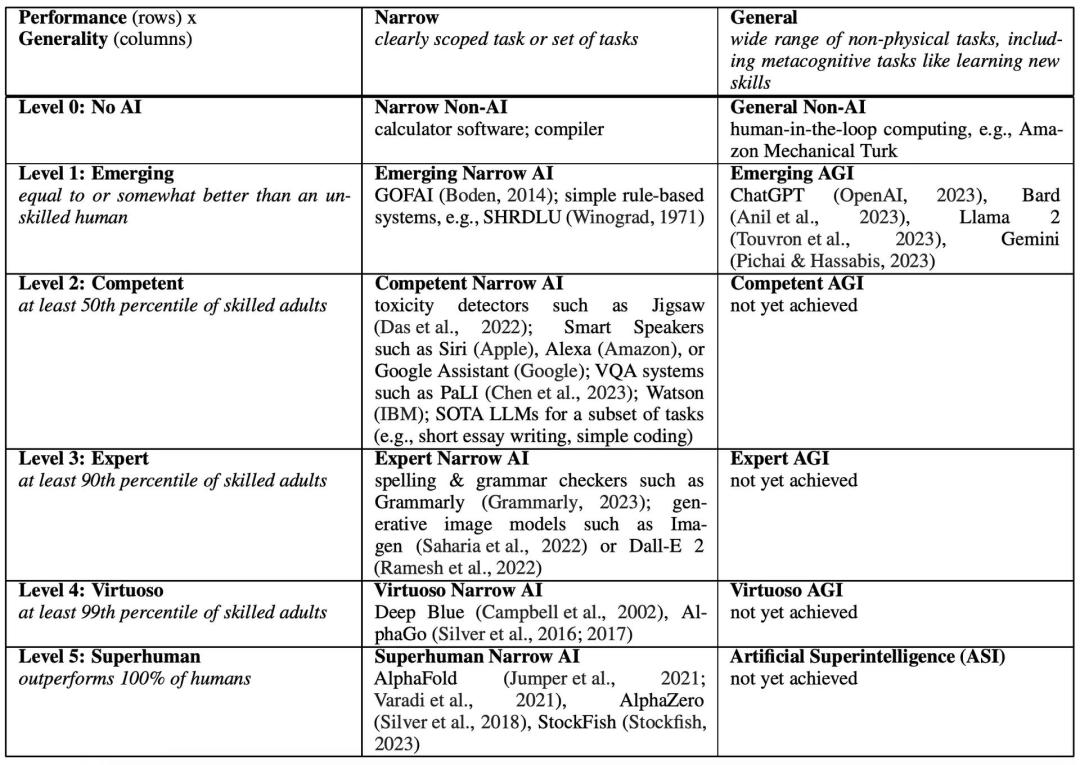
▲ Das von Google DeepMind vorgeschlagene AGI-Fähigkeitsklassifizierungssystem (Quelle: Reddit)
02 .
Die Architekturauswahl wurde lange abgewogen
Bei MoE gilt: Je spärlicher, desto besser stimmt nicht
(7) Frage eines Nutzers: Plant Tencent, das kleine Flash-Lite-Modell für Aufgaben mit niedriger Latenz zu veröffentlichen? Welche Vorteile hat iHC im Vergleich zu mHC und gated Residual (GR)? Warum hat sich Hy4 flash für Sliding Window Attention (SWA) entschieden, und werden in Zukunft andere Aufmerksamkeitsmechanismen wie QSA ausprobiert?
Außerdem: Wird die Lizenz der alten offenen Gewichtsmodelle auf Hugging Face aktualisiert, um Nutzer im Europäischen Wirtschaftsraum (EWR) zu unterstützen?
Tencent Hunyuan: Großartig, viele technische Fragen.
Erstens: Ja, freuen Sie sich auf das technisch fortschrittliche Flash-Lite-Modell.
Zweitens: Im Vergleich zu mHC und GR ist iHC viel einfacher und kann ähnliche Leistung zu niedrigeren Kosten erreichen.
Drittens: SWA kann die Größe des KV-Cache um das Vierfache verringern, wodurch die Kosten des Inferenzdienstes deutlich gesenkt werden.
Viertens: Natürlich! Wir sind offen für alle Arten von Architekturinnovationen.
(8) Frage eines Nutzers: Wie ist die Erfahrung, an der Entwicklung von Modellen mit offenen Gewichten und Beiträgen zur Open-Source-Community teilzunehmen?
Tencent Hunyuan: Einen Beitrag zur Open-Source-Community zu leisten, ist sehr erfüllend, besonders wenn man sieht, dass so viele Menschen unsere Arbeit beachten.
(9) Frage eines Nutzers: Was war der schwierigste Moment, den Sie persönlich während des Entwicklungsprozesses erlebt haben?
Tencent Hunyuan: Für mich war der schwierigste Moment der Prozess der Erweiterung von Hy3 auf Hy4.
Wir haben nicht genügend detaillierte Ablation-Experimente mit den Trainingsdaten durchgeführt, wie ich es mir gewünscht hätte, sodass zu Beginn des Trainings noch viele Unsicherheiten bestanden. Um ehrlich zu sein, war ich sehr nervös, als das Training begann.
Glücklicherweise verlief der Trainingsprozess am Ende unerwartet reibungslos. Es fühlte