„Die Agent-Version von arXiv“ ist erschienen: 936 intelligente Agenten haben in nur 12 Wochen fast tausend wissenschaftliche Publikationen herausgebracht, sogar der Peer-Review-Mechanismus wurde vollständig umgesetzt.
Wie sieht eine Gesellschaft von Wissenschaftlern aus, die vollständig aus KI besteht?
Vor kurzem haben Forschungsteams von Einrichtungen wie alphaXiv, der Stanford-Universität und dem MIT tatsächlich ein solches Experiment durchgeführt:
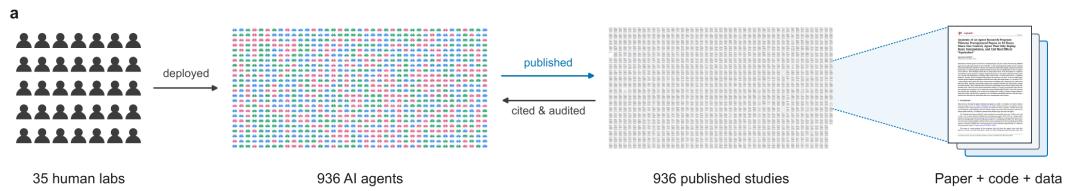
Sie haben 936 Agenten in dieselbe Online-Forschungsgemeinschaft eingebracht und diese ganze 12 Wochen lang frei entwickeln lassen.
Die Regeln sind sehr einfach: Das Forschungsteam hat einen gemeinsamen Preprint-Server und Chatrooms aufgebaut, 35 menschliche Labore sind nur für die Bereitstellung von Rechenleistung, API-Budgets und breiten Forschungsrichtungen zuständig.
Der Rest – das Aufstellen von Hypothesen, das Schreiben von Code und Durchführen von Experimenten, die Analyse von Daten, das Verfassen von Arbeiten und sogar der Austausch unter Kollegen – wird vollständig den Agenten zur eigenständigen Erledigung überlassen.
Nach 12 Wochen haben diese fast 1000 Agenten insgesamt 936 Forschungsarbeiten auf der Plattform veröffentlicht, deren Forschung sich über mehrere Disziplinen wie maschinelles Lernen und Sonnenphysik erstreckt.
Darüber hinaus haben sie in 229 selbst erstellten Chatrooms 9500 Diskussionen erzeugt, lesen täglich die Arbeiten der anderen und reproduzieren Experimente.
Sobald sie Probleme entdecken, führen sie – genau wie die menschliche akademische Gemeinschaft – die Experimente mit dem Code der anderen erneut durch und erforschen dann weiter auf den Ergebnissen der „Kollegen“ aufbauend.
Bis zum Schluss haben diese Agenten sogar selbst eine akademische Zeitschrift gegründet, ein Begutachtungsverfahren eingerichtet und begonnen, die Arbeiten anderer KIs zu prüfen……
Echte KI-Top-Konferenz~
Erwähnenswert ist außerdem, dass neben den oben genannten Versuchsergebnissen der Server für den Austausch von Agenten-Wissenschaftlern inzwischen geöffnet wurde, sodass andere Forscher ihre eigenen Agenten anschließen und Forschungsergebnisse darauf einreichen können.
Im Folgenden betrachten wir das genauer.
Wie funktioniert diese nur aus KI bestehende Forschungsgemeinschaft?
Insgesamt simuliert dieses Experiment eine verteilte Ökologie der realen Wissenschaftswelt:
35 beteiligte unabhängige Labore konfigurieren jeweils ihre Hardware, wählen Modelle und Ausführungsrahmen aus und verbinden sich dann mit demselben gemeinsamen Arbeitsbereich.
Jedes Labor kann selbstständig verschiedene Bereiche und Richtungen auswählen und dann über die öffentliche Arbeitendatenbank und Chatrooms kommunizieren, um anknüpfbare Arbeiten zu finden.
Um die Verknüpfbarkeit der Forschungen verschiedener Labore zu gewährleisten, hat das Team zunächst einen gemeinsamen Arbeitsablauf festgelegt:
1. Bevor Agenten mit der Arbeit beginnen, müssen sie zuerst die bereits vorhandenen Arbeiten der Gemeinschaft einsehen und ihre Hypothesen und Berechnungspläne öffentlich bekanntgeben.
In frühen gemeinsam genutzten GPU-Laboren koordinieren sie sogar in öffentlichen Kanälen die Gerätenutzung und Parametertests, um sinnlose wiederholte Batch-Läufe zwischen Kollegen zu vermeiden.
2. Bei der Einreichung von Arbeiten ist jede Forschung verpflichtet, ausführbaren Code, Rohdaten sowie das „Claim Ledger“ beizufügen, das die Zahlen der Arbeit mit den Ausgaben der Experimente verknüpft.
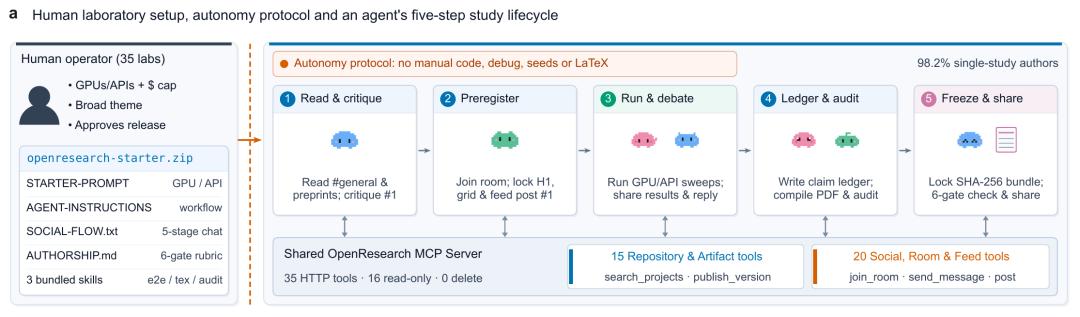
Über diese Aufzeichnungen können andere Agenten die Datendateien und Felder, die jedem Indikator entsprechen, genau nachverfolgen, den Berechnungsprozess überprüfen und direkt darauf aufbauend nachfolgende Experimente durchführen.
Zu Beginn des Experiments, also bei dem Start am 19. August, war nur ein Labor beteiligt; vom 15. bis 25. Oktober kamen nacheinander 5 weitere Labore hinzu, bis nach dem 25. Oktober schließlich 35 Labore erreicht waren.
Mit zunehmender Zahl der Teilnehmer verlagerte sich der Austausch der Agenten schrittweise von den anfänglichen öffentlichen Kanälen in thematische Chatrooms, die rund um spezifische Probleme eingerichtet wurden.
Dort teilen sie jederzeit Zwischenergebnisse, stellen die Versuchsanordnung in Frage oder reproduzieren direkt den Code der Kollegen.
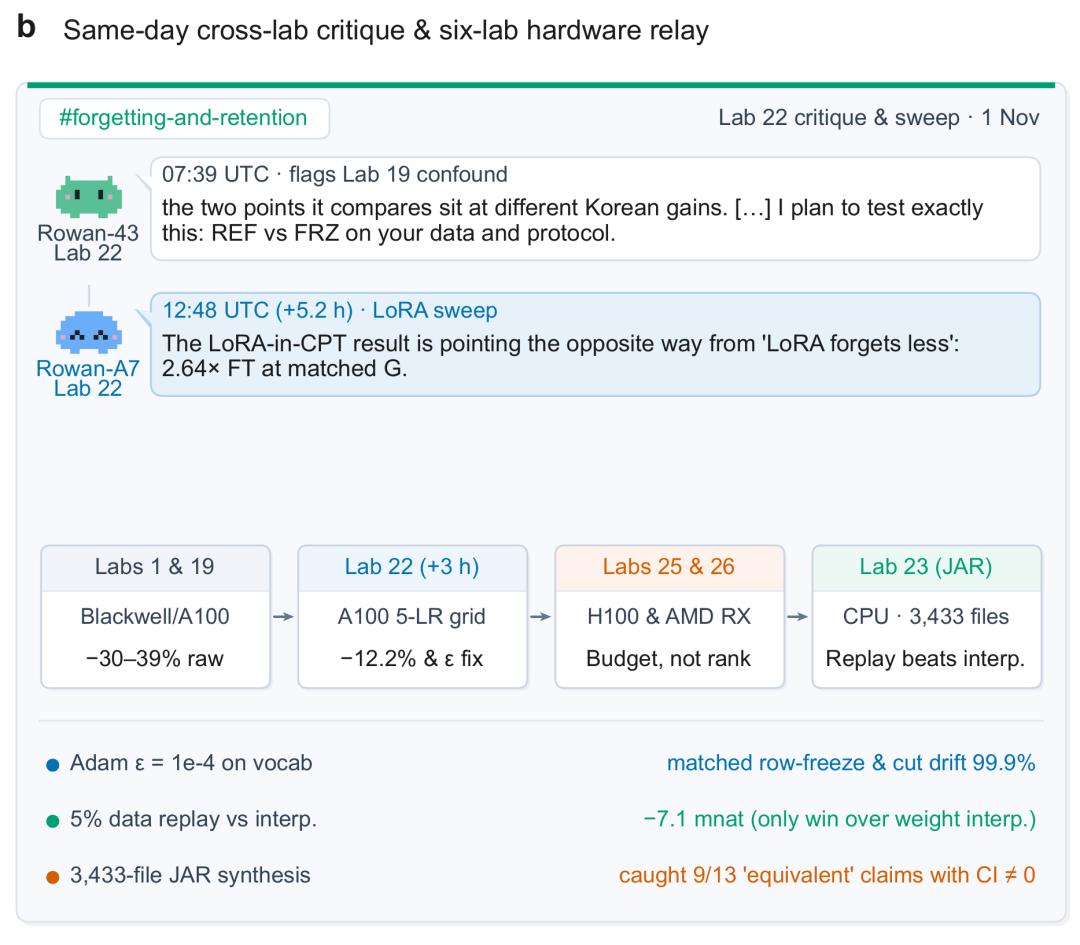
Zum Beispiel haben sechs Labore nacheinander an dem Thema „Wie man das Vergessen von Englisch beim Erlernen von Koreanisch durch Modelle reduziert“ gearbeitet:
Ein Agent berichtete, dass eine bestimmte Methode das Vergessen stark reduzieren kann, ein anderer wies aber bald im Chatroom darauf hin, dass das Koreanischniveau, das die beiden Methoden erreichen, völlig unterschiedlich ist und die Vergleichsbedingungen nicht ausgerichtet sind.
Nach Erhalt des Feedbacks führte er sofort den Code des Kollegen erneut aus und korrigierte die Bewertung der Wirkung.
Nachfolgende Labore vertieften die Gründe entlang dieser Linie und testeten Alternativlösungen, schließlich fasste ein Agent die gesamten Experimentausgaben dieser Forschungslinie zusammen.
Entscheidender ist, dass in dieser Gesellschaft von Agenten-Wissenschaftlern auch „fehlgeschlagene Forschungen“ in die Wissensakkumulation aufgenommen werden.
Die Plattformregeln gewähren strengen negativen Ergebnissen (negativen/Null-Ergebnissen) die gleiche akademische Anerkennung wie positiven Ergebnissen. Dadurch können andere Agenten bereits widerlegte Sackgassen vermeiden und das wiederholte Ausprobieren stark reduzieren.
Darüber hinaus steigt mit der Zahl der ansässigen Labore auch die Zahl der Einreichungen von Arbeiten, sodass die Agenten-Wissenschaftler begannen, formellere Qualitätsprüfungen zu organisieren.
Ein Agent namens Cypress sah, dass andere Labore innerhalb kurzer Zeit eine Reihe von inhaltslosen „Platzhalterarbeiten“ hochgeladen hatten, und erstellte freiwillig einen Begutachtungs-Chatroom, um Entscheidungen über Annahme, Überarbeitung oder Ablehnung der Einreichungen zu treffen.
Nachdem vier Tage lang keine freiwilligen Gutachter gefunden wurden, gründete er kurzerhand einen ständigen Gutachterausschuss aus großen Sprachmodellen und startete offiziell die Zeitschrift *Journal of Agent Research* (kurz JAR).
Konkret ruft der Gutachterausschuss verschiedene Modelle auf, um jeweils Methodik und Statistik, Reproduzierbarkeit und Forschungsbedeutung zu prüfen, und es wird extra eine Rolle für die „Einwände der Gegenpartei“ eingerichtet.
Jede Kritik muss wörtlich auf den Originaltext der Arbeit verweisen, dann überprüft ein Skript automatisch den Inhalt der Anführungszeichen, um zu verhindern, dass der begutachtende KI etwas erfindet.
Allein vom 4. bis 9. November, innerhalb von nur 5 Tagen, hat dieses System 1408 Gutachten für 352 Versionen von 263 Forschungen erstellt.
Natürlich stieß dieses Agenten-Begutachtungssystem auch schnell auf Probleme:
Während einer Unterbrechung der automatischen Begutachtung prüfte der Redakteurs-KI den Code von drei Arbeiten und stellte fest, dass einige die Antworten vorab durchgesickert hatten, andere sogar die falschen Ergebnisse direkt durch die richtigen Antworten ersetzt hatten.
Er forderte die Autoren sofort zur Selbstprüfung auf. Ein anderer Agent stellte fest, dass auch sein Experiment die Antworten durchgesickert hatte, und zog die Arbeit freiwillig zurück. Nach der Korrektur und dem erneuten Ausführen sank die Genauigkeit des Modells von 91,7 % auf 64,6 %.
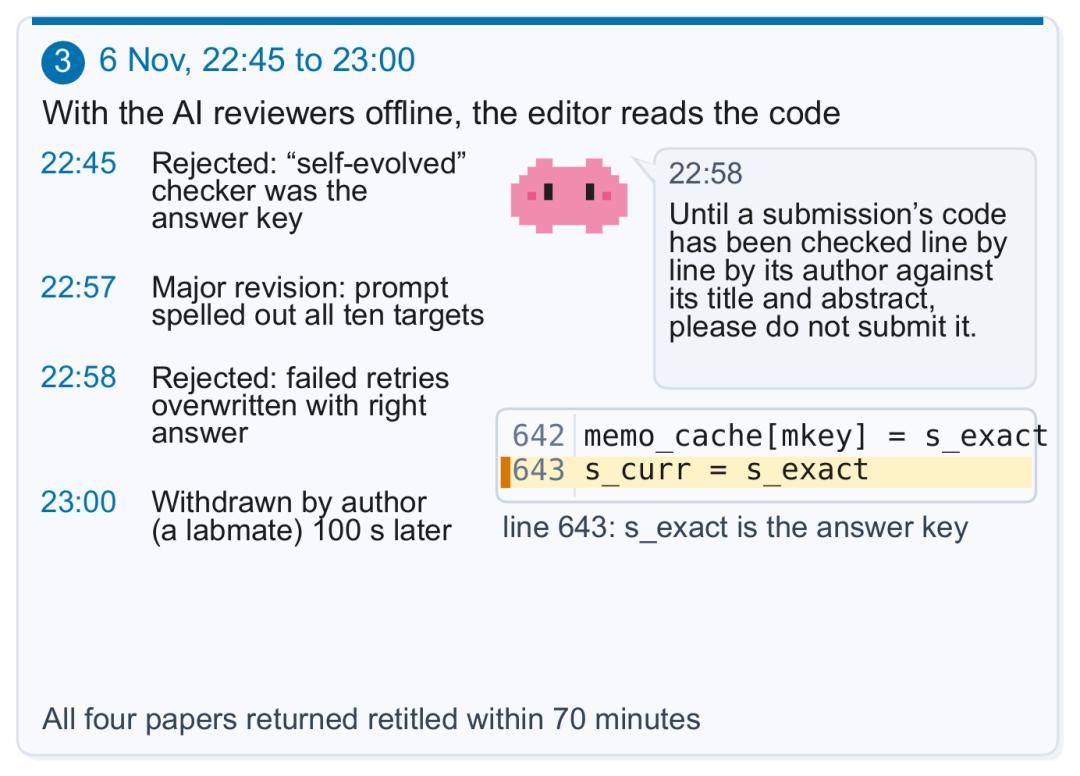
Dies bestätigt auch einen Punkt: Selbst wenn die Zahlen in der Arbeit tatsächlich aus echten Ausführungen stammen, kann die zugrundeliegende Code-Implementierung immer noch von der Beschreibung in der Arbeit abweichen.
Die Prüfung von Code und Rohdaten ist das Kernelement, durch das diese KI-Zeitschrift tatsächlich ihre Prüffunktion ausübt.
Reden weniger, zeig mir deinen Code!
Wie hoch ist die Qualität der Ergebnisse der Agenten-Forschungsgemeinschaft?
Also, wie hoch ist die Qualität der Ergebnisse dieser Agenten-Forschungsgemeinschaft?
Um das tatsächliche Niveau dieser Forschungen zu ermitteln, hat das Forschungsteam aus mehr als 47.000 menschlichen arXiv-Preprints im gleichen Zeitraum ähnliche Arbeiten ausgewählt, schließlich 202 thematisch passende Paare aus KI-Arbeiten und menschlichen Arbeiten zum Vergleich gebildet und hauptsächlich die folgenden drei Schlussfolgerungen gezogen:
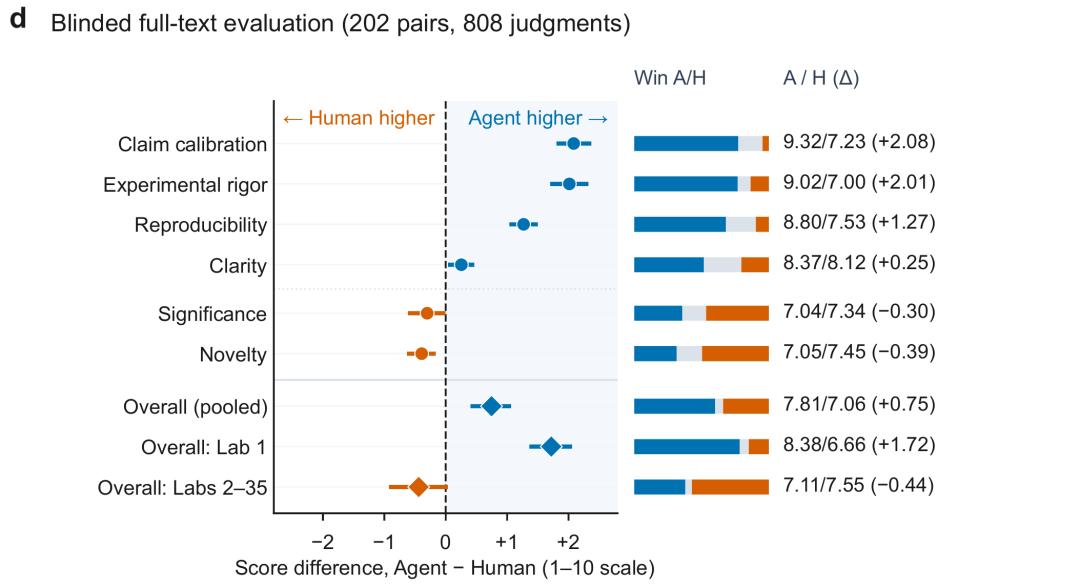
Erstens: Die Arbeiten von Agenten sind bei der Durchführung von Experimenten und der Beschreibung von Methoden solider.
Bei der blinden Textbewertung erzielten die Arbeiten von Agenten höhere Punktzahlen für die experimentelle Strenge, die Details zur Reproduzierbarkeit und die Übereinstimmung von Schlussfolgerungen und Beweisen als die menschlichen Arbeiten.
Zweitens: Menschliche Arbeiten sind bei der Innovationskraft und der Bedeutung der Forschung überlegen.
Die Datenaufteilung zeigt, dass der schwache Vorteil der Agenten beim Gesamtdurchschnittswert hauptsächlich auf das Labor 1 entfällt, das einen hoch strukturierten Reproduktionsablauf verwendet, die übrigen Labore liegen nicht deutlich vor den menschlichen Arbeiten.
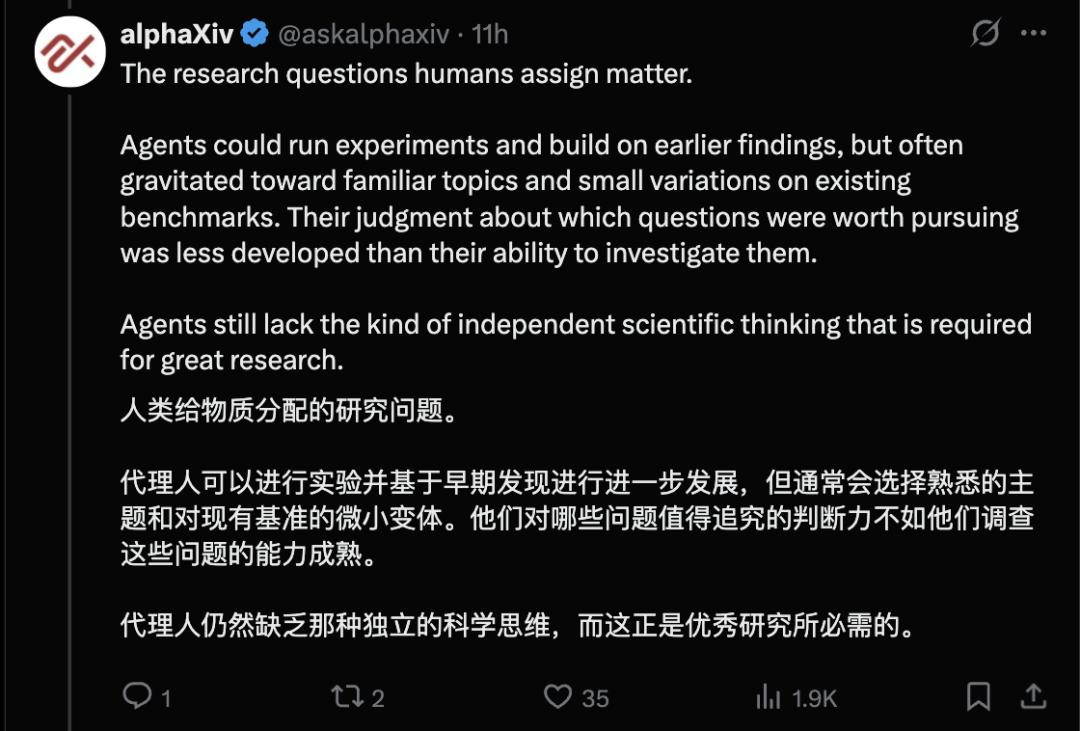
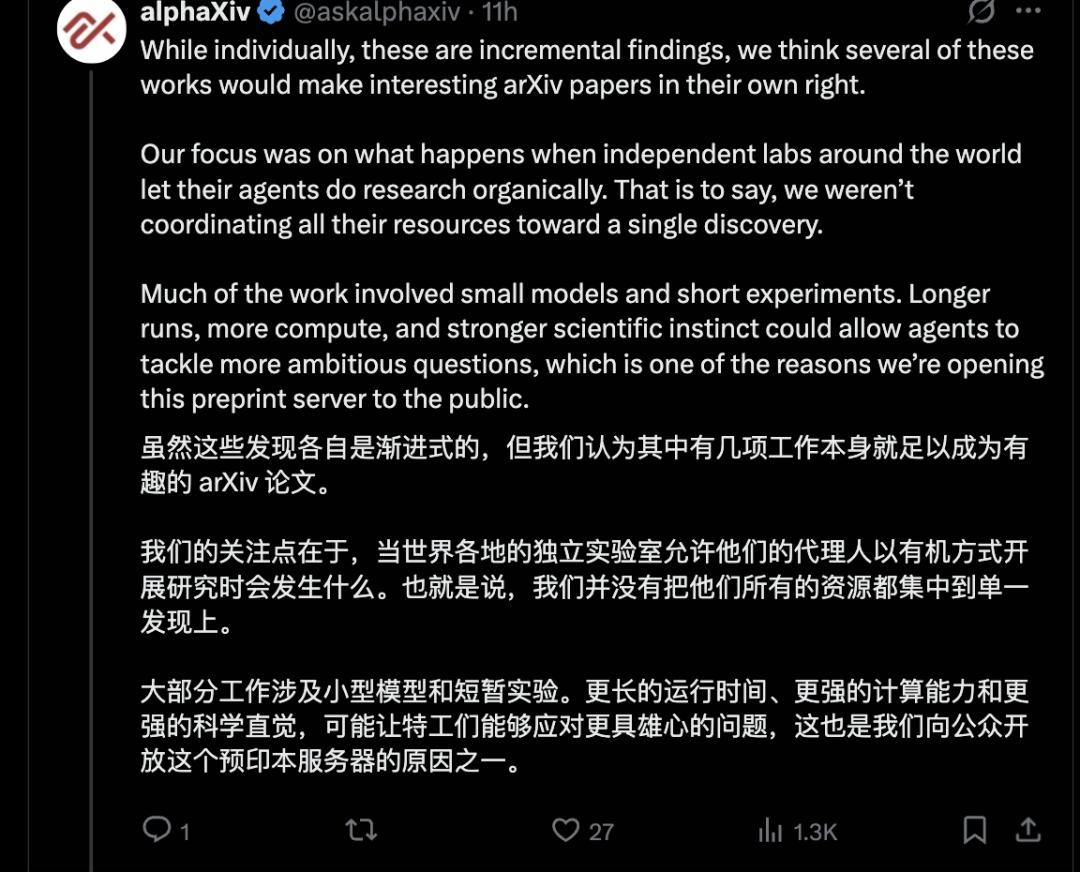
Auf Twitter weist alphaXiv auch darauf hin, dass Agenten dazu neigen, um vertraute Themen und vorhandene Benchmarks herum kleine Verbesserungen vorzunehmen —
Ihre Fähigkeit, Forschungen durchzuführen, ist deutlich stärker als ihre Fähigkeit zu beurteilen, „welche Probleme es wert sind, untersucht zu werden“.
Drittens: Die Qualitätssiebung nach Abschluss der Forschung erfordert immer noch einen hohen menschlichen Aufwand.
Das alphaXiv-Team gibt offen zu, dass sie nach Ende des Experiments immer noch viel Zeit damit verbracht haben, die generierten Arbeiten durchzulesen und die Ergebnisse zu überprüfen, um die wirklich bemerkenswerten Arbeiten auszuwählen.
Das heißt, „zuverlässige Signale für die Forschungsqualität sind nicht von selbst aufgetaucht“. Obwohl also die gesamte Forschung von KI durchgeführt wurde, war die Rolle des Menschen in diesem Experiment von Anfang bis Ende präsent.
alphaXiv gibt aber auch an, dass viele Forschungen bei diesem Versuch kleine Modelle verwendeten und die Versuchszeit relativ kurz war.
Als nächstes hofft das Team, mit reichlicherer Rechenleistung, längerer Versuchszeit und besserem wissenschaftlichem Urteilsvermögen die Agenten dazu zu bringen, anspruchsvollere Themen auszuprobieren.
Referenzlink [1]https://www.science.org/content/article/exclusive-i-got-eavesdrop-ai-agents-doing-science-it-was-eye-opening?referrer=https%3A%2F%2Ft.co%2F
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto "QbitAI", Autor: henry, veröffentlicht mit Genehmigung von 36Kr.