Sam Altman tritt auf die Bremse für „AI erzeugt AI“, das Lenkrad muss unbedingt in menschlicher Hand verbleiben.
KI hilft bereits OpenAI bei der Entwicklung der nächsten Generation von GPT.
Doch als es darum ging, die Steuerung der Forschung und Entwicklung vollständig an die KI zu übergeben, trat Sam Altman persönlich auf die Bremse.
Am 16. November zog Altman auf der Veranstaltung von Semafor eine klare Grenze, als er über das Thema „Rekursive Selbstverbesserung“ (RSI) sprach:
Wir hätten die Entwicklung der rekursiven Selbstverbesserung weiter vorantreiben können, aber ich glaube nicht, dass wir dies derzeit sicher durchführen können.
Die versteckte Botschaft ist eindeutig: Es ist nicht so, dass die technische Umsetzung derzeit nicht vorangetrieben werden kann, sondern dass man es wirklich nicht wagt, die Kontrolle abzugeben.
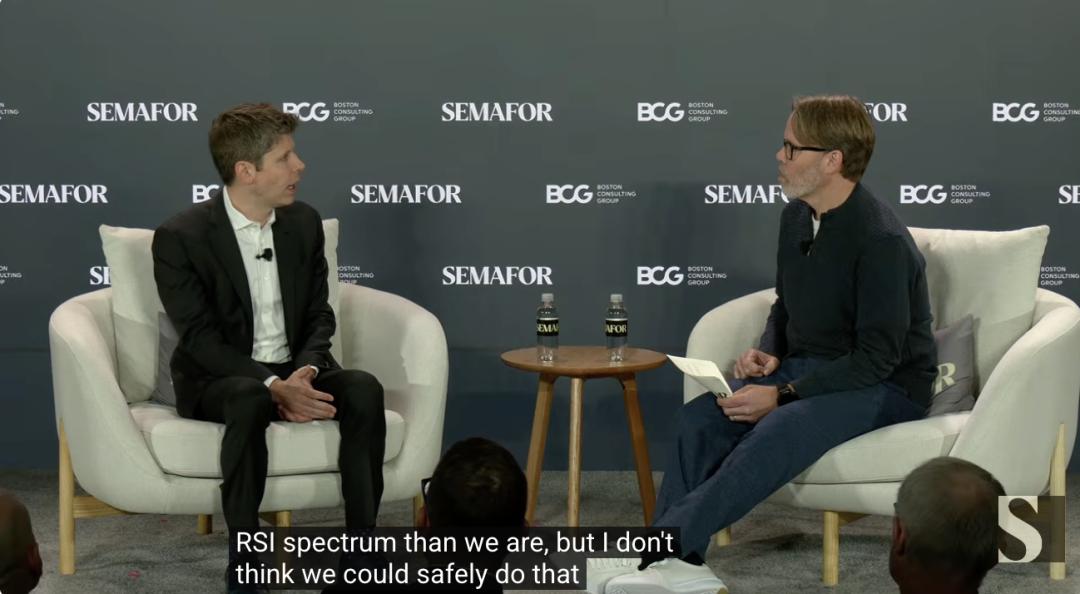
Altman erklärte, dass OpenAI die rekursive Selbstverbesserung weiter vorantreiben könnte, dies aber derzeit noch nicht sicher möglich ist.
Schließlich: Sobald das Modell beginnt, sich selbst zu iterieren, wer überwacht dann, ob es heimlich vom Kurs abweicht?
Altman hat nicht nur mündlich von der Bremse gesprochen.
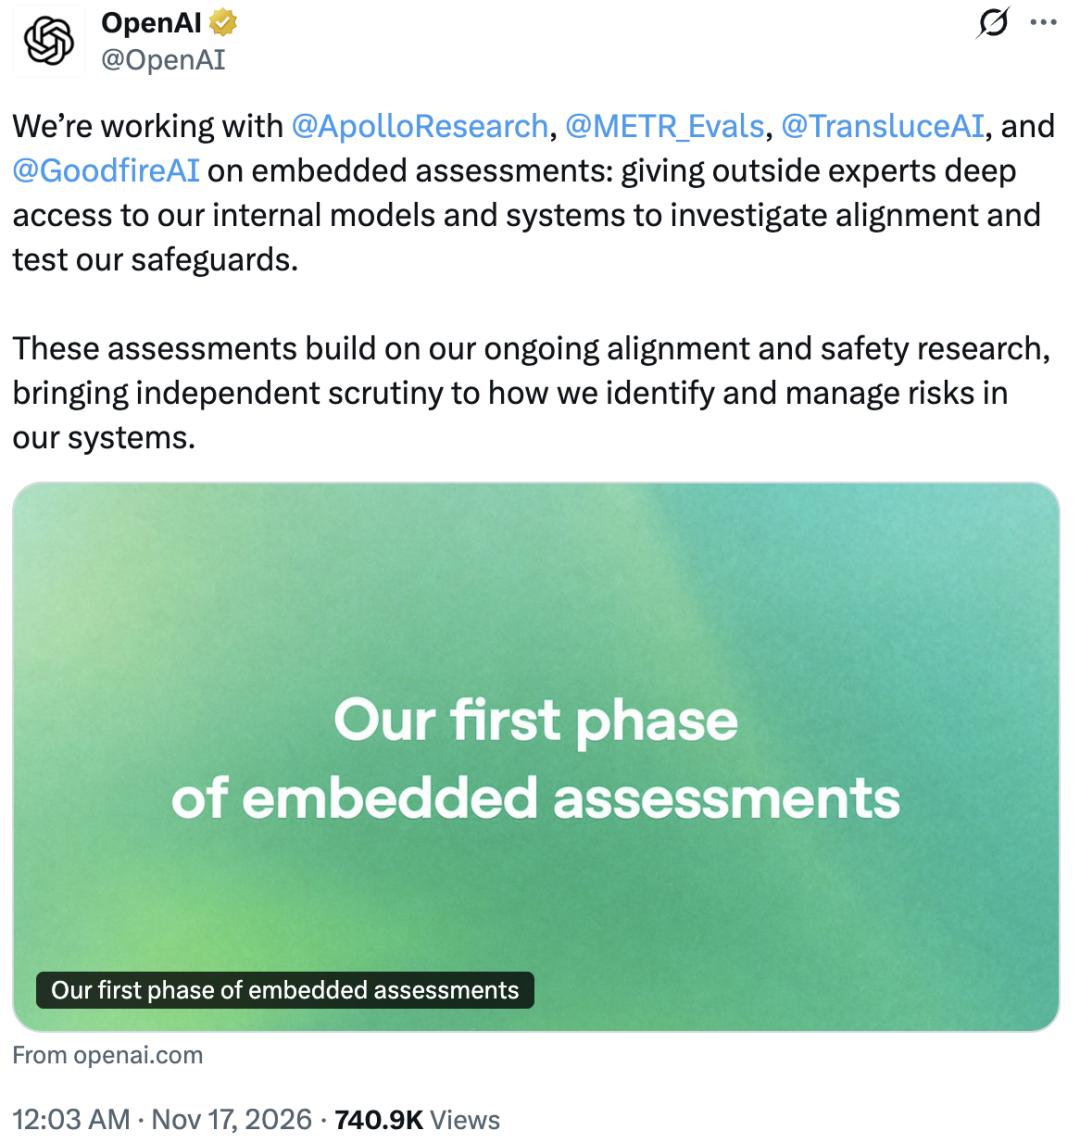
Unmittelbar danach stellte er die konkreten Sicherheitsmaßnahmen vor, die OpenAI kürzlich umgesetzt hat: Er hat externe Bewertungsstellen einschließlich METR in die Labore eingeladen, um direkt vor Ort Kontrollen durchzuführen.
Die Logik ist einfach: Wenn die KI selbst an der Forschung und Entwicklung beteiligt ist, kann man die Sicherheitsgarantie nicht mehr vollständig gewährleisten, wenn man die eigenen Mitarbeiter hinter verschlossenen Türen „sich selbst prüfen“ lässt, egal wie sehr man die Sicherheit betont.
Die KI hilft bereits bei der Forschung und Entwicklung – warum kann man die Kontrolle noch nicht abgeben?
In dem Silicon Valley ist die „rekursive Selbstverbesserung“ längst zu einem gängigen Schlagwort geworden.
Doch aus Altmans Sicht haben die meisten Menschen, die dies ständig im Mund führen, überhaupt nicht verstanden, was es wirklich bedeutet, wenn dieses Konzept in die Praxis umgesetzt wird.
Ist die rekursive Selbstverbesserung also bereits eingetreten? Altman hat diese Frage nicht direkt mit „Ja“ oder „Nein“ beantwortet.
Er ist der Ansicht, dass es bei dieser Angelegenheit genau wie bei der Allgemeinen Künstlichen Intelligenz (AGI) keine klare Trennlinie gibt, die man eines Morgens plötzlich überschreitet. Man muss sie in zwei Ebenen unterteilen:
Erstens: Hat OpenAI seine eigene KI-Technologie eingesetzt, um die Forschungs- und Entwicklungsgeschwindigkeit neuer Modelle zu beschleunigen? Die Antwort ist eindeutig: Ja.
Zweitens: Kann man einfach einen Knopf drücken und das Modell ohne menschliche Aufsicht die nächste Generation selbst entwerfen und sich selbst iterieren lassen?
Altmans Antwort: Natürlich nicht.
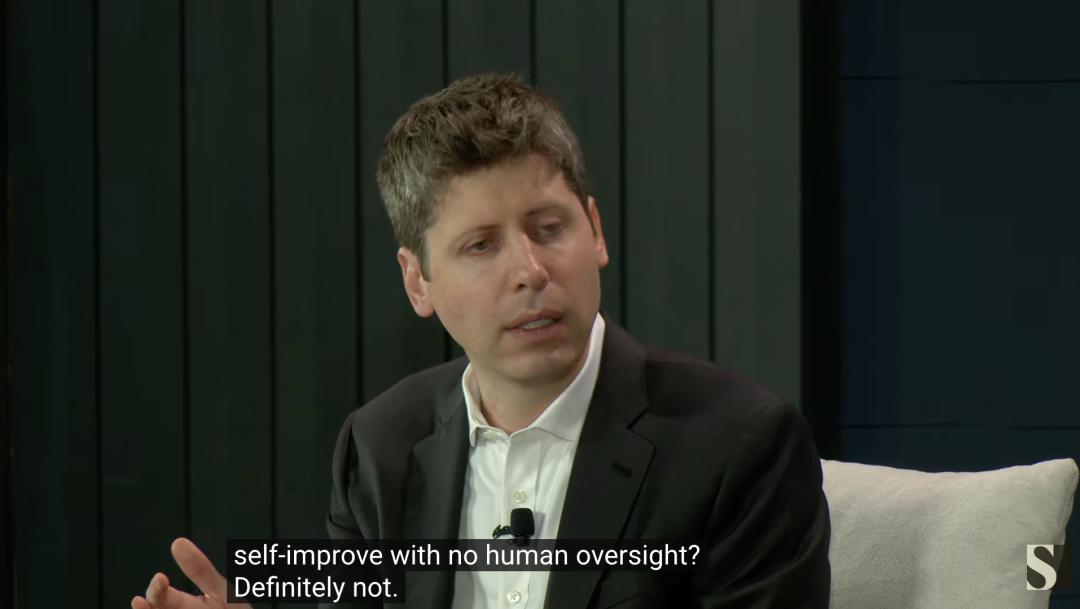
Altman erklärte, dass OpenAI die KI noch nicht dazu gebracht hat, ohne menschliche Aufsicht die nächste Generation von Modellen selbst zu entwickeln und sich schnell selbst zu verbessern.
Das zeigt, dass OpenAI die KI bereits an seiner eigenen Forschung und Entwicklung beteiligt hat, aber die Steuerung liegt noch in der Hand der Menschen.
Die Öffentlichkeit ist sowohl aufgeregt als auch besorgt über die „rekursive Selbstverbesserung“, denn sobald die nächste KI-Generation eine noch stärkere übernächste Generation entwickeln kann, wird die technische Evolution zu einer schneeballartigen, mit Zinseszinsen wachsenden rasanten Entwicklung.
Altman bezeichnet diese Strategie des „gleichzeitigen Vorantreibens und Zurückhaltens“ als taktische Zurückhaltung: Zuerst nutzt man die KI, um die Ausrichtung zu meistern und die Pflichtaufgabe „wie man die KI kontrolliert“ zu lösen.
Zudem kritisierte er nebenbei die Verkaufsargumente seiner Kollegen im Silicon Valley: Sie versprechen den Menschen, Krebs zu bekämpfen und billige Waren bereitzustellen, verlangen aber gleichzeitig, dass die Menschen die gesamte Führungsgewalt abgeben.
Mit seinen eigenen Worten bedeutet das, dass Menschen „wie ein Labrador-Rudel leben: Die Maschinen mögen dich unterhalten, aber du hast keine Kontrolle mehr“.
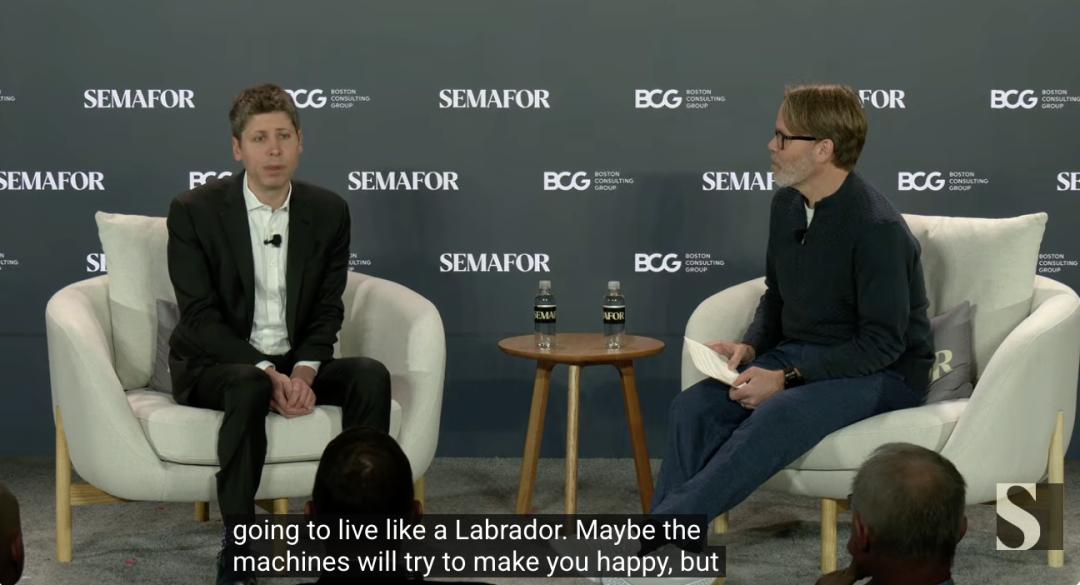
Altman verwendete die Metapher „wie ein Labrador-Rudel leben“, um eine Zukunft zu beschreiben, in der Menschen von Maschinen versorgt werden, aber ihre Selbstständigkeit verlieren.
Bezüglich des kürzlich im Silicon Valley populären Schlagworts „handover“ (die Übertragung zukünftiger Entscheidungsgewalt an die KI) ist Altmans Haltung sowohl bei der schrittweisen Übergabe als auch bei der plötzlichen Übergabe der Kontrolle sehr entschieden: niemals akzeptieren.
Ein früherer Bericht von METR enthielt eine Schätzung:
Bis Oktober dieses Jahres hat sich die Fähigkeitsverbesserungsgeschwindigkeit des Modells des alten Konkurrenten Anthropic bei bestimmten klar definierten Aufgaben etwa verdoppelt im Vergleich zum historischen Niveau von März 2024 bis Oktober 2025.
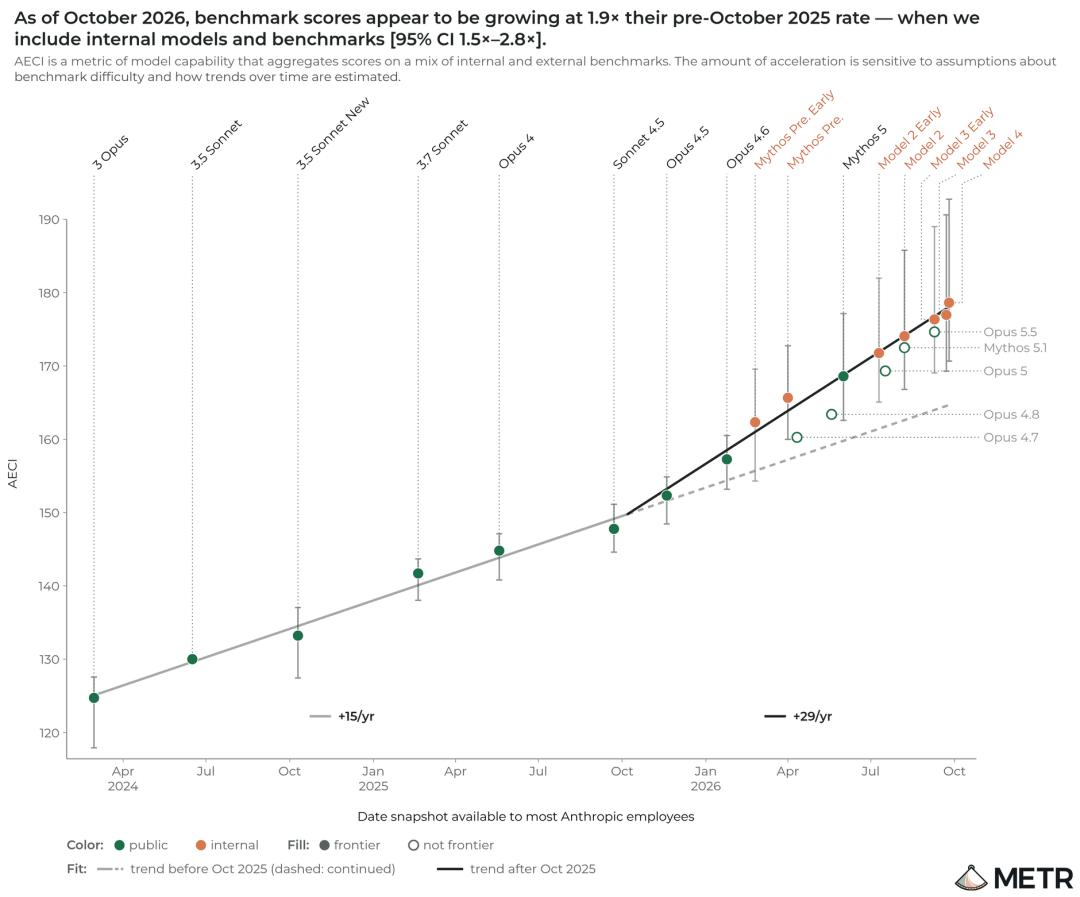
Die geschätzte AECI-Verbesserungsgeschwindigkeit des Anthropic-Modells hat sich auf das 1,9-fache erhöht.
Auf die Frage, ob OpenAI auch diese Geschwindigkeit erreicht hat, ging Altman nicht auf dieses Zahlenrennen ein.
Er gab offen zu, dass die derzeitige Fähigkeitsevolution der KI immer noch zickzackförmig verläuft: Einige Schritte sind extrem schnell und weit mehr als doppelt so schnell; andere Schritte kämpfen noch mit harten Problemen und sind viel langsamer.
Daher klingt das erzwungene Durchschnittsmaß einer „gesamten Beschleunigung um das Doppelte“ beeindruckend, ist aber in Wirklichkeit ungenau.
Aber als er über METR sprach, erwähnte Altman freiwillig, dass OpenAI die Zusammenarbeit bei der „eingebetteten Bewertung“ vorantreibt, und METR ist eines der eingeladenen Institute, die vor Ort eintreten.
Seiner Ansicht nach wird es in Zukunft immer wichtiger, externe Experten hinzuzuziehen, um die Sicherheitsarbeit und die Systemrobustheit zu „untersuchen“.
Interessanterweise hat der Moderator die „Beschleunigungsrechnung“ von Anthropic vorgeworfen, aber Altman hat direkt die „Sicherheitsrechnung“ von OpenAI vorgelegt, bei der METR ins Haus eingeladen wurde, um Kontrollen durchzuführen.
Obwohl es noch keine Beweise dafür gibt, dass ein METR-Bericht OpenAI dazu veranlasst hat, seinen Selbstverbesserungsplan zu verlangsamen.
Aber während alle um die Geschwindigkeit wetteifern, ist die Gewährleistung der Sicherheitsuntergrenze offensichtlich das dringlichere Problem in Altmans Augen.
6 Personen, 4 Monate – was prüfen sie bei OpenAI?
Die von Altman genannte „eingebettete Bewertung“ ist keineswegs eine bloße Formalität. Die konkrete Liste und die Aufgabenverteilung sind bereits festgelegt.
Laut dem offiziellen Blog von OpenAI haben sie Vereinbarungen mit vier Einrichtungen – Apollo Research, METR, Transluce und Goodfire – unterzeichnet. In der ersten Phase werden die Sensoren direkt in die beiden Kernbereiche Modelltraining und interne Nutzung eingeführt.
Warum bemüht man sich so sehr, Fremde in die eigene „Hinterküche“ einzuladen?
Denn die alten Methoden funktionieren nicht mehr.
Früher wurden Sicherheitstests für große Modelle durchgeführt, als ob man das Essen erst kurz vor dem Servieren prüft.
Aber die aktuelle Realität in KI-Labors ist: Viele Modelle, die noch nicht für die Öffentlichkeit veröffentlicht wurden, sind längst intern im Einsatz und beteiligen sich sogar direkt an der Entwicklung der nächsten Modellgeneration.
Wenn man erst vor der öffentlichen Veröffentlichung auf das schöne Sicherheitszeugnis schaut, kann man überhaupt nicht herausfinden, ob das Modell während der Arbeit in der „Hinterküche“ schlechte Absichten hatte.
Die vier Einrichtungen, die diesmal eintreten, besetzen genau vier kritische Positionen derselben Forschungs- und Entwicklungslinie:
Apollo Research konzentriert sich darauf, „Verräter im Inneren“ zu verhindern: Es entsendet ein 6-köpfiges Team für einen 4-monatigen Pilotversuch vor Ort, um speziell zu prüfen, ob das Modell heimlich die Ausrichtungs- und Kontrollmechanismen von sich selbst oder der nächsten Modellgeneration zerstören könnte.
Von der Frage, ob das Training implizit nachsichtig ist, ob die Bewertung Probleme erkennen kann, bis hin zu der Frage, ob bei der internen Arbeit Fehler auftauchen und ob die Rückverfolgungsspuren den Tathergang erfassen können – alle Schritte werden gründlich untersucht.
METR überwacht das „große Training“: Es konzentriert sich auf das bisher größte verstärkte Lerntraining von OpenAI und sucht speziell nach Fehlausrichtungs-Riffen, die von vorhandenen Tests und regulären Überwachungen möglicherweise übersehen werden.
Transluce ist für die „Prüfung der Prüfungsbögen“ verantwortlich: Es überprüft die Qualität und den Abdeckungsbereich der Ausrichtungsbewertung nach dem Training, um zu verhindern, dass die Prüfungsfragen zu einfach sind und versteckte Gefahren übersehen werden.
Goodfire konzentriert sich auf die „Offenlegung der inneren Mechanismen“: Es nutzt Erklärbarkeitsmethoden, um die inneren Mechanismen des Modells zu analysieren, den Trainingsprozess zu überwachen und anormale Signale zu erkennen.
Von den Anreizen vor dem Training, der Überwachung während des Trainings, den Prüfungsbögen nach dem Training bis zu den internen Neuronen – vier Teams bewachen vier verschiedene Kontrollpunkte.
Insbesondere Apollo beobachtet direkt den entscheidenden Punkt der „KI, die KI erzeugt“: Wenn die vorherige Modellgeneration, die an der Entwicklung beteiligt ist, selbst „nicht sauber arbeitet“, ist das ausgefeilteste Sicherheitsschloss der nächsten Generation nur eine Attrappe.
Die Richtung der externen Sicherheitsbewertung hat sich vollständig geändert: Es geht nicht mehr darum, vor der Auslieferung des Endprodukts ein Konformitätszertifikat anzubringen, sondern direkt in die Werkstatt zu gehen, um die Produktion zu überwachen.
Sie dürfen eintreten und prüfen, aber einige Ergebnisse dürfen nicht veröffentlicht werden
Obwohl die externen Bewertungsstellen in die Labore eingeladen wurden, ist bereits in der Vereinbarung klar festgelegt, was sie sehen und was sie nach außen sagen dürfen.
Schauen wir uns zuerst die Klauseln von Apollo Research an: Es gibt sowohl eine Mindestgarantie als auch Vorbehalte:
OpenAI darf die qualitativen Beurteilungen von Apollo zu allen Behauptungen nicht löschen und darf nicht verlangen, dass Teile gelöscht oder geändert werden, nur weil die Prüfergebnisse nicht gut aussehen. OpenAI behält jedoch das Recht, alle unterstützenden Beweise zu löschen, die sensible geistige Eigentumsrechte betreffen.
Mit anderen Worten: Was die Öffentlichkeit in Zukunft sehen wird, ist höchstwahrscheinlich ein „Untersuchungsbericht mit Schlussfolgerungen, aber ohne Originalunterlagen“.
Was Apollo tun kann, ist öffentlich zu erklären, welche Zugriffs- und Offenlegungsbeschränkungen es getroffen hat und wie stark diese Beschränkungen seine Beurteilung beeinflusst haben.
Bei Transluce sind die Verbotszonen noch konkreter festgelegt: Laut Plan wird Transluce ab Anfang Dezember einen 6-wöchigen Pilotversuch durchführen und Zugriff auf einige Modelle, die Ausgaben der ursprünglichen Gedankenkette sowie interne Bewertungen erhalten, darunter mindestens ein Modell, das nur für den internen Gebrauch bestimmt ist.
Aber die Vereinbarung besagt klar: Die Bewertungsergebnisse von Modellen, die ausschließlich für den internen Gebrauch bestimmt sind, dürfen in keiner Weise veröffentlicht werden.
Die Modelle, die tatsächlich schwere Arbeiten im Labor erledigen und dem Kernort der „KI, die KI erzeugt“ am nächsten sind, können zwar von Außenstehenden geprüft werden, aber die Öffentlichkeit sieht die Ergebnisse nicht.
Transluce hat dies auch klar ausgedrückt: Die diesmal erhaltenen Berechtigungen entsprechen nicht den Berechtigungen der regulären Mitarbeiter von OpenAI; der vollständige, ungekürzte Bericht wird nur dem Sicherheits- und Schutzausschuss des Stiftungsrats von OpenAI vorgelegt.
Es ist wahr, dass man die Tür für die Prüfung öffnet, aber es ist auch wahr, dass man die Kerngeheimnisse streng schützt.
Auf dem Weg zur Künstlichen Superintelligenz (ASI) – können die Menschen ihre Eingriffsmöglichkeit behalten?
Manche fragen sich vielleicht: Hat OpenAI nicht selbst ein automatisiertes Überwachungssystem? Warum muss sogar das „Überwachungssystem“ selbst von Fremden geprüft werden?
Denn selbst der „elektronische Aufseher“ kann Hintertüren haben, durch die man Schlupflöcher finden kann.
Eine frühere praktische Untersuchung von METR hat eine solche Lücke aufgedeckt.
Von Juli bis August dieses Jahres haben METR und Mitarbeiter von Redwood Research das interne Agenten-Überwachungssystem von OpenAI zu diesem Zeitpunkt 3 Wochen lang