Microsoft und Apple erlitten nacheinander massive Systemausfälle, und noch mehr „große Betriebsstillstände“ stehen uns bevor.
Die weltweite Welle von Ausfällen, die die Welt erschüttert, hat nun endlich auch Apple getroffen.
In den frühen Morgenstunden des 18. Ortszeit Beijing traten aufgrund eines Fehlers bei der internen Systemaktualisierung weitverbreitete Ausfälle bei Kerndiensten wie iCloud, Apple Pay, App Store und Apple Music nacheinander auf.
In der vergangenen Woche waren ähnliche „Pannen“ schier unzählbar:
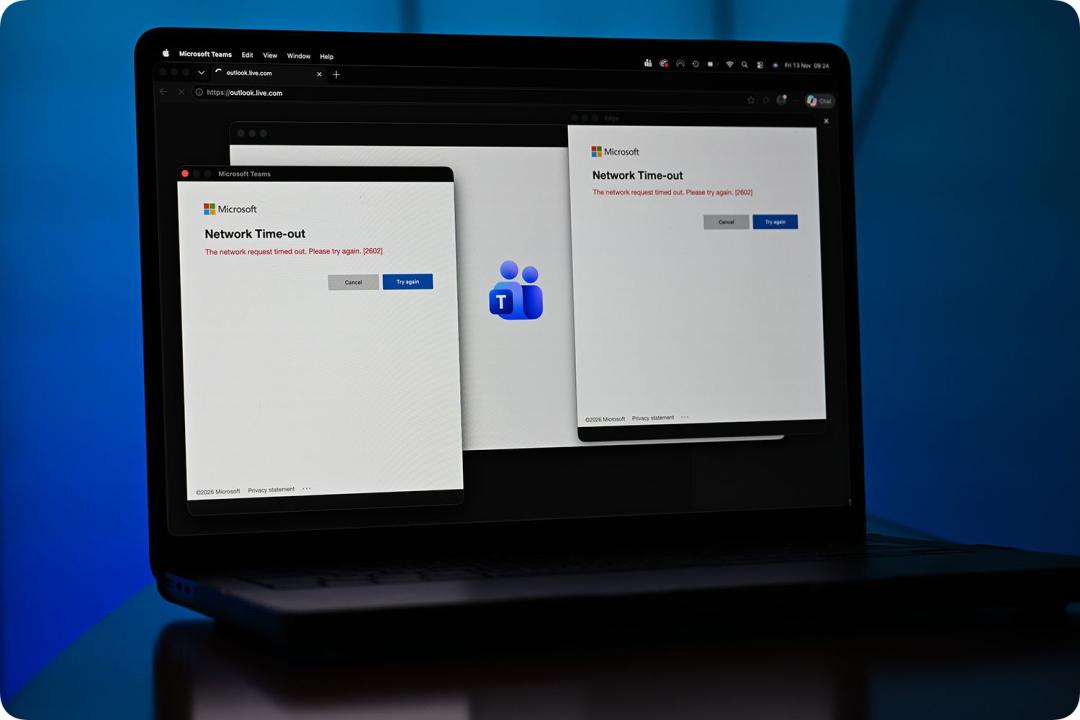
In den frühen Morgenstunden des 13. November fielen Microsoft-Dienste wie Outlook, Microsoft 365, Teams und Copilot nacheinander aus. Der Fehler dauerte 23 Stunden und 50 Minuten und betraf 74 Länder und Regionen;
Am 13. November verursachten massenhafte Anfragen von einem fehlerhaften Router eine Überlastung des Kommunikationsnetzes der US-Luftfahrtbehörde (FAA), wodurch alle Flüge in den USA fast 5 Stunden lang eingestellt wurden;
Am 16. November führte ein interner Softwarefehler bei JPMorgan Chase dazu, dass die Transaktionsverarbeitungsgeschwindigkeit mehrerer Banken sank
……
Die Giganten stürzen nacheinander der Reihe nach ab, aber in dieser dichten Welle von Ausfällen ist Microsoft nach wie vor das Unternehmen mit den größten und auffälligsten Auswirkungen.
Als Infrastruktur, die unzählige Regierungs- und Unternehmensabteilungen zusammenhält, führte der extrem lange Ausfall der Microsoft-Dienste vor einigen Tagen dazu, dass viele Einrichtungen gezwungen waren, zur „alten Bürozeit“ zurückzukehren und sich mit Telefonen, Bluetooth und Papierdokumenten durchzuschlagen; natürlich gab es auch viele Arbeitnehmer, die ihre Liebe zur Arbeit ausdrückten, Kaffee kochten, mit dem Handy spielten und die seltene legale Zeit zum Faulenzen genossen.
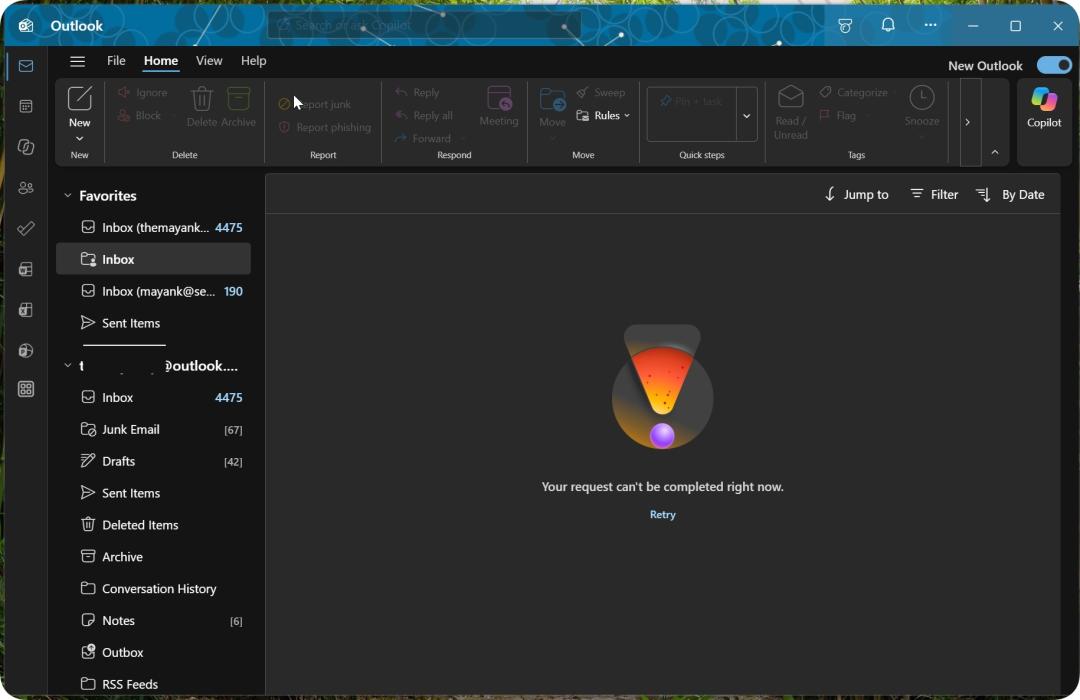
Schätzungen von Drittorganisationen zufolge belief sich der Produktivitätsverlust während des Stillstands auf 70 bis 16 Milliarden US-Dollar.
Es scheint unvorstellbar, dass Dienste, die Hunderte Millionen Menschen abdecken, 24 Stunden lang ausfallen – aber bei Microsoft wirkt das irgendwie ein bisschen plausibel.
Vor zwei Tagen veröffentlichte Microsoft offiziell den „vorläufigen Unfallbericht zu Microsoft 365“. Dieser Bericht bietet uns genau eine ausgezeichnete Gelegenheit, die Wahrheit hinter den aufeinanderfolgenden Ausfällen dieser modernen Technologiegiganten zu ergründen.
Ein verworrenes, ineinandergreifendes Gewitter aus unheimlichen Zufällen
Es ist nicht einfach, die Drachenperlen zu sammeln, aber laut diesem vorläufigen Untersuchungsbericht hat Microsoft kurz vor dem Unfall tatsächlich drei seltene Risikofaktoren zusammengetragen –
Erstens: Ein unsichtbarer Fehler, der vor mehr als drei Monaten bereitgestellt wurde.
Genauer gesagt ereignete sich dieser Unfall auf den Netzwerkgateway-Servern von Microsoft 365. Man kann sie sich wie die Informationsschalter eines Krankenhauses vorstellen: Sie sind für die Herstellung von Verbindungen zu Benutzern, die Weiterleitung von Anfragen und die Verwaltung des Datenverkehrs zuständig und bilden den Pfad, über den der gesamte Datenverkehr der meisten Microsoft-Cloud-Dienste läuft.
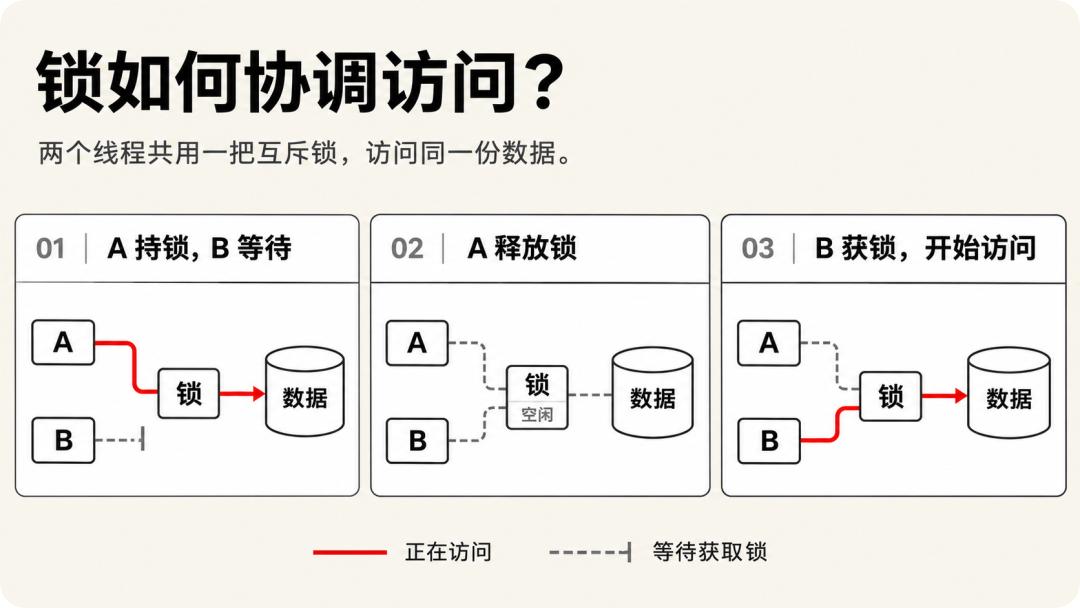
Da die Gateway-Server gleichzeitig mit einer großen Anzahl von Anfragen konfrontiert werden können, wurde ein Koordinationsmechanismus namens „Lock“ (Sperre) eingerichtet, um zu verhindern, dass mehrere Threads um den Zugriff auf dieselbe interne Ressource konkurrieren. Er funktioniert wie eine Anmeldestelle, die sicherstellt, dass verschiedene Threads in der richtigen Reihenfolge auf Ressourcen zugreifen.
Alles schien reibungslos zu laufen, bis Microsoft den Patch installierte.
Ab Juli dieses Jahres begann Microsoft, einen Patch zur Behebung eines bestehenden Problems an die Gateway-Server an allen Standorten auszuliefern. In den mehr als drei Monaten des Betriebs danach entdeckte niemand, dass in diesem Patch tatsächlich ein schwerwiegender bösartiger Fehler verborgen war –
Aus nicht offengelegten technischen Gründen löst er eine „Sperrenkonkurrenz“ aus: Das bedeutet, dass verschiedene Threads sich um die „Anmeldeplätze“ streiten und sich aufstauen, bis schließlich die Systemressourcen vollständig aufgebraucht sind und das Gateway allmählich die Reaktionsfähigkeit verliert.
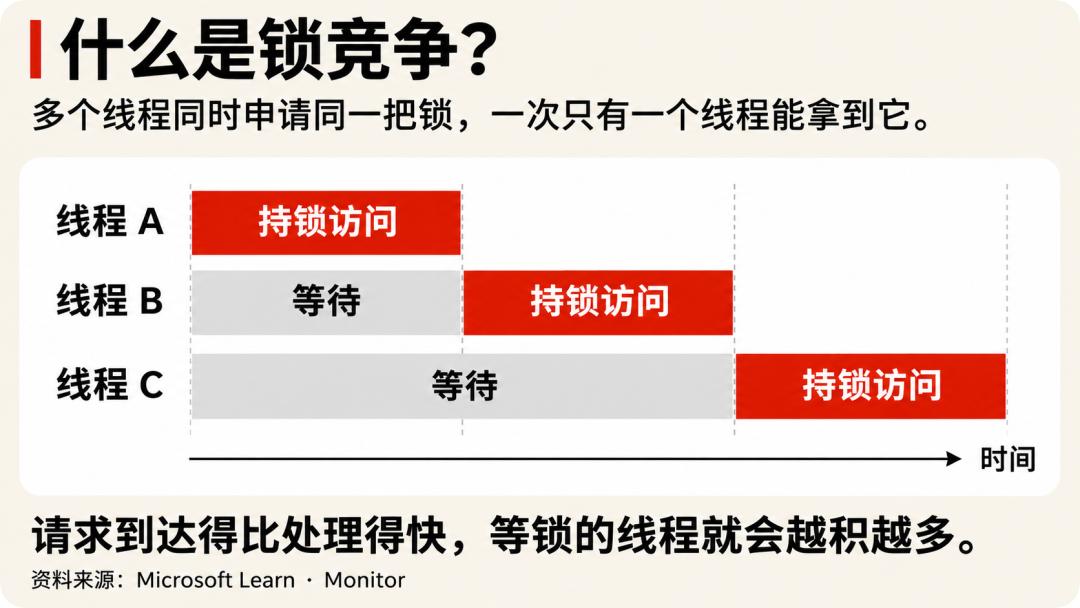
Warum das Problem bei den Tests vor der Veröffentlichung nicht entdeckt wurde, erklärt Microsoft so: Die Tests nutzten Server mit schwächerer Leistung und weniger Kernen, sodass Anfragen leicht verteilt werden konnten. Auf den Hochleistungsservern der Produktivumgebung verstärkte die größere „Anmeldestelle“ hingegen die Konkurrenz, sodass fehlerhafte Anfragen nicht rechtzeitig verteilt werden konnten.
Diese im System versteckte Zeitbombe wartete nur noch auf den Auslöser.
Der zweite Faktor ist der Wechsel zwischen Haupt- und Ersatzgateway.
Aus Gründen der Systemzuverlässigkeit verfügt Microsoft 365 tatsächlich über zwei voneinander unabhängige Netzwerkgateway-Systeme mit unterschiedlichen technischen Details: Wenn das Hauptgateway ausfällt, kann auf das Ersatzgateway umgeschaltet werden.
Aber 15 Stunden vor dem Unfall schaltete Microsoft aufgrund „regelmäßiger Wartung“ den Teams-Datenverkehr, der ursprünglich auf dem Ersatzgateway lief, ebenfalls auf das Hauptgateway um, das bereits den Datenverkehr von Diensten wie Outlook und Office trug. Dadurch stieg die Belastung des Hauptgateways plötzlich stark an.
Zu allem Übel befand sich das Hauptgateway bereits in einem geschwächten Zustand.
Zufälligerweise war am Tag zuvor ein weiterer Fehler auf dem Hauptgateway aufgetreten, wodurch 14 % der Serverkapazität vorübergehend außer Betrieb genommen wurden.
Theoretisch reichte die verbleibende Kapazität noch für den Betrieb aus. Aber mit der Übernahme des Teams-Datenverkehrs geriet das Hauptgateway plötzlich unter hohe Last. Der hohe Lastzustand löste den zuvor verborgenen Fehler der Sperrenkonkurrenz aus, sodass die Serverlast weiter anstieg und schließlich der Server abstürzte.
Noch fataler: Die Gateway-Server verfügen über ein automatisches Planungssystem. Theoretisch soll das Planungssystem den Datenverkehr eines ausgefallenen Servers auf andere Server verteilen.
Da aber alle Server den gleichen Fehler haben, dass sie bei hoher Last ausfallen, verwandelte sich die automatische Planung schließlich in eine „Ansteckung“: Die Server fielen nacheinander wie Dominosteine aus.
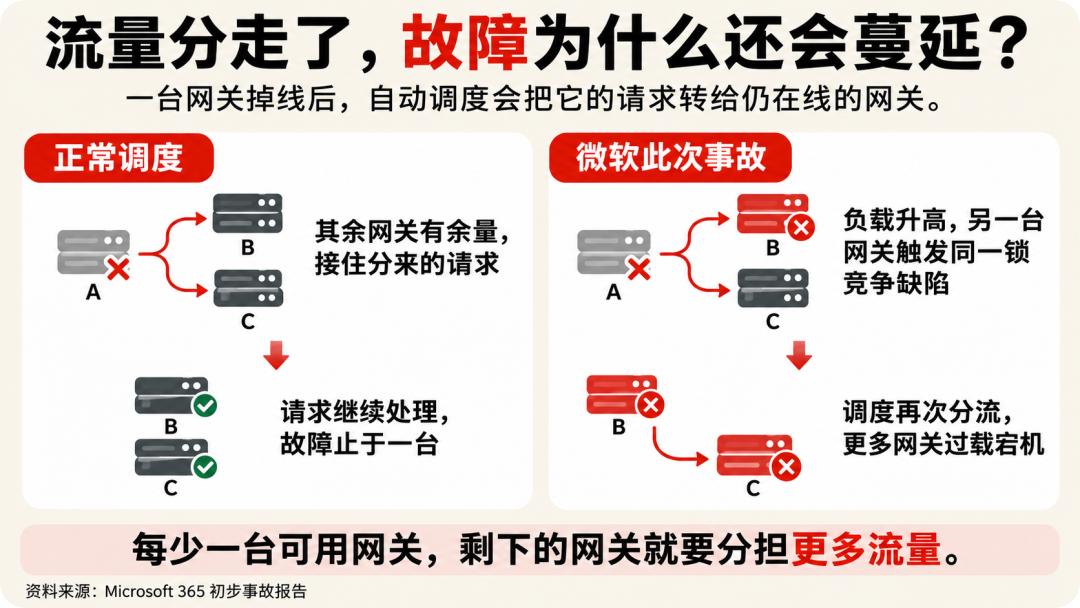
Im schlimmsten Fall reagierten mehr als 80 % der Gateway-Server nicht mehr.
Übersetze mir mal: Was bedeutet es, wenn aus dem Hydranten Benzin strömt, während das Haus brennt?
Mit anderen Worten: Microsoft hatte eigentlich über Redundanz- und Notfallsicherungssysteme. Wenn irgendein Glied nicht versagt hätte, wäre es nie zu einem großen Ausfall gekommen. Das Besondere an diesem Vorfall ist aber, dass jedes Glied genau zur falschen Zeit versagte und schließlich einen „perfekten Sturm“ auslöste.
Oder wie das Heinrich-Gesetz besagt: Hinter einem Unfall verbergen sich 300 versteckte Sicherheitsrisiken. Vielleicht hat das System an Orten, die der Öffentlichkeit nicht bekannt sind, schon oft knapp eine Katastrophe vermieden – diesmal hat das Glück einfach nicht mehr mitgespielt.
Angesichts der Komplexität des Unfalls ist die nachträgliche Bearbeitung durch die Microsoft-Ingenieure durchaus lobenswert –
Der fehlerhafte Patch war zu lange in Betrieb, um zurückgerollt zu werden, also schrieben sie vor Ort einen neuen Patch. Da das automatische Planungssystem die gerade wiederhergestellten Server ständig überlastete, stoppten sie die Planung entschlossen und starteten das gesamte Servercluster Schritt für Schritt manuell neu.
Noch vor Ablauf der 24-Stunden-Frist wurden alle Dienste nacheinander wiederhergestellt.
In der Zwischenzeit war es aber bereits Tatsache, dass Krankenhäuser ihre Sprechstunden einstellten, Gerichte ihre Sitzungen unterbrachen und Börsen sowie Versicherungen gezwungen waren, wieder ausschließlich per Telefon zu kommunizieren.
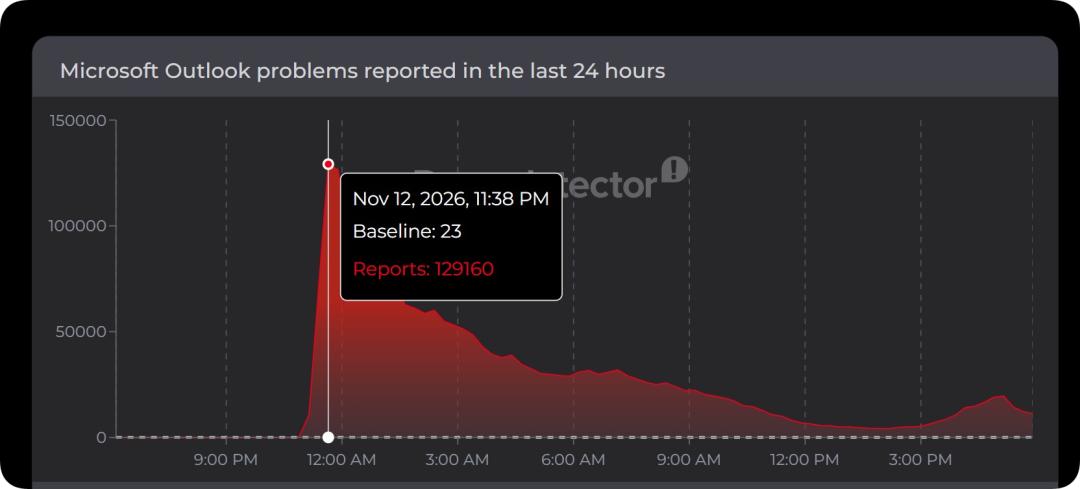
Gergely Orosz, ehemaliger Ingenieur bei Microsoft und Uber und Gründer des bekannten Technik-Newsletters *The Pragmatic Engineer*, stellte klar: Dies ist wahrscheinlich der zerstörerischste Ausfall von geschäftlichen E-Mail-Diensten in der Geschichte.
Aus diesem Grund musste Microsoft-CEO Satya Nadella öffentlich um Entschuldigung bitten:
Der Vorfall der vergangenen Woche erinnert uns erneut daran, dass digitale Infrastruktur für den weltweiten Betrieb von entscheidender Bedeutung ist. Wir wissen, dass Sie unseren Diensten vertrauen, und wir nehmen diese Verantwortung sehr ernst. Vor diesem Hintergrund weiß ich, dass wir noch viel Arbeit leisten müssen, um die Widerstandsfähigkeit zu bieten, auf die Sie und die ganze Welt vertrauen können.
Man kann Nadellas Versprechen gerne weiterverfolgen und beobachten. Aus seinen Worten geht aber auch eine grundlegende Tatsache hervor: Je erfolgreicher Microsoft ist und je tiefer seine Dienste in die Infrastruktur der modernen Welt eingebettet sind, desto stärker werden die Erschütterungen bei Ausfällen sein.
In einer Zeit, in der wenige Giganten Kommunikation und Netzwerke stark kontrollieren, wird dieses Damoklesschwert wahrscheinlich noch lange über unseren Köpfen schweben.
KI ist nicht der Hauptschuldige, aber Systemrisiken dürfen nicht unterschätzt werden
Der Mensch hat den Instinkt, nach kausalen Zusammenhängen zu suchen. Bei einem plötzlichen großen Ausfall fällt es den Menschen schwer, nicht an die in diesem Jahr häufigen „Jailbreak“-Cyberangriffe auf KI-Systeme und die Nachricht von Microsoft zu denken, die 60.000 Mitarbeitern ein „freiwilliges Austrittsprogramm“ angeboten hat.
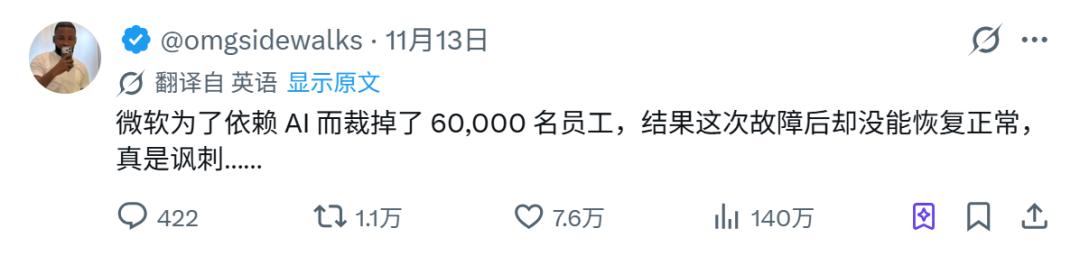
Vielleicht weil Microsoft die öffentliche Stimmung erkannt hat, hat es in seiner offiziellen Mitteilung ausdrücklich klargestellt, dass der Unfall nichts mit KI und Cyberangriffen zu tun hat:
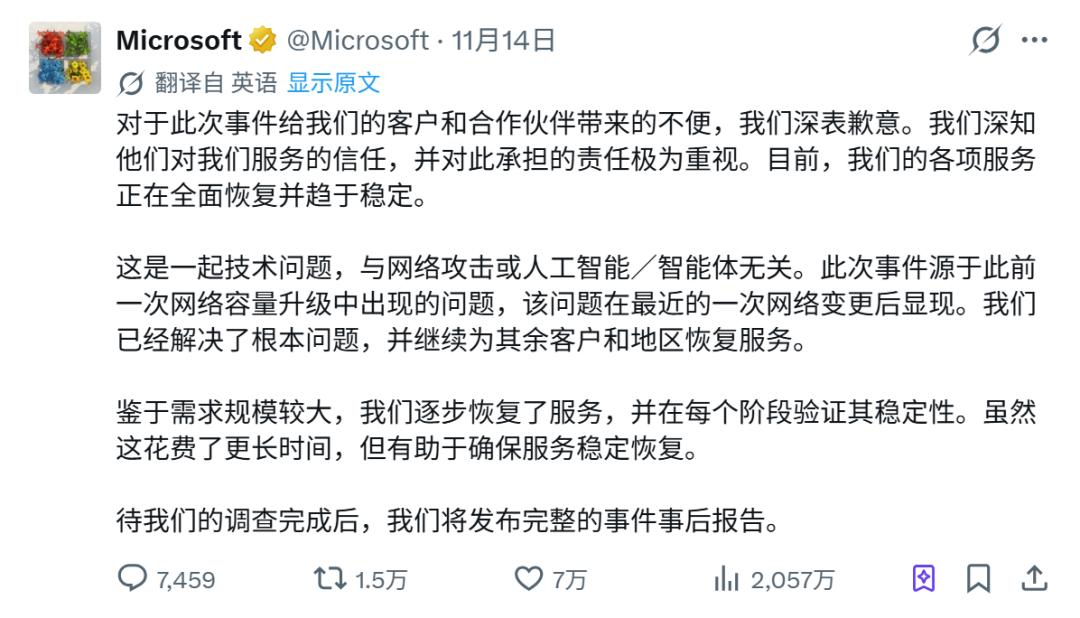
Meldungen von Technikmedien aus dem Microsoft-Ingenieursteam belegen außerdem, dass der fehlerhafte Patch, der mit versteckten Risiken veröffentlicht wurde, vollständig von Menschen geschrieben wurde.
Das heißt: Dies ist ein echter, handgemachter Fehler aus alter Herstellungsart.
Wir haben bereits bei unserer Bewertung der PHP2Shell-Lücke gesagt: KI-Programmierung ist natürlich nicht perfekt, aber sie liegt wahrscheinlich über dem Durchschnittsniveau menschlicher Programmierung. Es stimmt weniger, dass KI viele lückenhafte Codes schreibt – vielmehr macht sie uns darauf aufmerksam, dass Menschen schon lange vor ihr weitaus schlimmere Codes geschrieben haben.
Verwandte Lektüre: OpenAI entdeckt die Jahrhundert-Lücke in PHP, 70 % aller Websites weltweit sind in Gefahr
