Ohne Training erstellt Opus 5.5 die Transformer-Gewichte direkt von Hand und erreicht 100 % bei allen 13 Aufgabekategorien.
Bei 13 komplexen algorithmischen Aufgaben und 26 unabhängigen Durchläufen erreichte ein völlig neues neuronales Netz auf dem verborgenen Testsatz eine 100-prozentige Genauigkeit in allen Fällen.
Unglaublicherweise wurde dem gesamten Prozess keine Massendaten zugeführt, und es wurden sogar vollständig weder „Backpropagation“ noch „Gradientenabstieg“ verwendet.
Dieses glasklare, extrem kleine neuronale Netz mit voller Punktzahl wurde von Claude Opus 5.5 Zeile für Zeile direkt per Code „handschriftlich“ erstellt.
Kürzlich veröffentlichte ein Team der Microsoft Research in Zusammenarbeit mit der Johns Hopkins University, der Columbia University und der New York University eine neue Studie mit dem Titel „Interpretable Weight Space Programming (iWSP)“.
Diese Studie beweist: Modernste große Sprachmodelle können bereits traditionelle Optimierer direkt umgehen, basierend auf festen Bewertungsrückmeldungen die Berechnungslogik so präzise wie ein Chirurg konzipieren und den Algorithmus per Code direkt in die Gewichte des Transformers schreiben.
Ohne Backpropagation wird die KI direkt zum „Uhrmacher“
Deep Learning wird oft scherzhaft als „Pillenbrauen“ bezeichnet.
Der gesamte Prozess ist wie eine Gruppe von Blinden, die um eine riesige Konsole mit mehreren hundert Millionen Knöpfen herumstehen. Niemand kann sehen, wie das Innere aussieht, und man kann nur anhand der gelegentlichen „Fehlermeldungen“ der Maschine tastend an diesem und jenem Knopf drehen.
Nach Zehntausenden von Iterationen läuft die Maschine tatsächlich normal, und bei einigen Aufgaben übertrifft sie sogar die Leistung des Menschen – man könnte sagen, sie „steigt auf der Stelle zum Himmel auf“.
Aber wenn man nachfragt: Welcher Knopf steuert die Logik? Welcher Knopf steuert das Gedächtnis? Niemand kann darauf antworten.
Kurz gesagt, die Wirkung ist hervorragend, aber das Prinzip ist unbekannt – das richtige Drehen der Knöpfe ist Mystik, das falsche Drehen ist ein Unfall, und dazwischen liegt eine ganze Black Box, die niemand erklären kann.
In technischen Anwendungen ist dies, solange die Vorhersagen genau sind, gerade noch akzeptabel. Aber bei sehr ernsten wissenschaftlichen Erkundungen wie Neurowissenschaften und Physik ist dieser Mangel fatal.
Wie das Forschungsteam als zentrales Problem hervorhebt:
Neuronale Netze machen sehr gute Vorhersagen, sind aber schwer zu verstehen. In wissenschaftlichen Bereichen, in denen „Erklärung“ das ultimative Ziel ist, ist dies ein schwerwiegendes Problem.
Nehmen wir die Neurowissenschaften als Beispiel: Tiefencodierungsmodelle können die Reaktion des Gehirns auf natürliche Reize sehr genau vorhersagen, aber sie können überhaupt nicht sagen, welche „Merkmale“ in den Reizen diese Reaktionen auslösen.
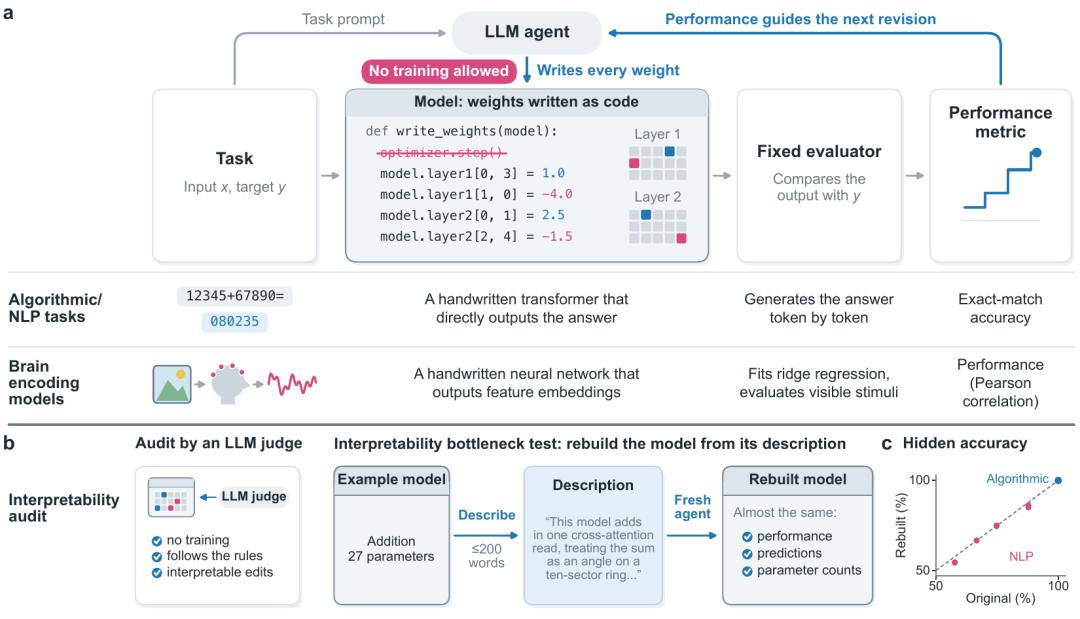
Um diese Sackgasse zu durchbrechen, hat das Microsoft-Team iWSP vorgeschlagen. Sie haben beschlossen: Keine Backpropagation zu verwenden und die KI direkt diese Knöpfe einstellen zu lassen.
Im Rahmen von iWSP verwandelt sich Opus 5.5 in einen Schöpfer.
Es revolutioniert den traditionellen Arbeitsablauf vollständig:
Pures Schlussfolgern: Bei der Aufgabe darf das System Opus kein auf Gradienten basierendes Training durchführen. Bei jeder Iteration kann der Agent nur einen einzigen Validierungswert sehen.
Handschriftliche Gewichte: Opus muss sein vorhandenes Vorwissen nutzen, um eine Berechnungslogik zu konzipieren. Dann schreibt es direkt Python-Code, schreibt die Merkmale explizit aus und wandelt diese Logik in konkrete Gewichtszahlen um.
Geschlossene Iterationsschleife: Opus bewertet diese Merkmale, nutzt bekannte korrekte Module wieder und modifiziert den Code ständig basierend auf dem Rückmeldung dieses einzelnen Werts.
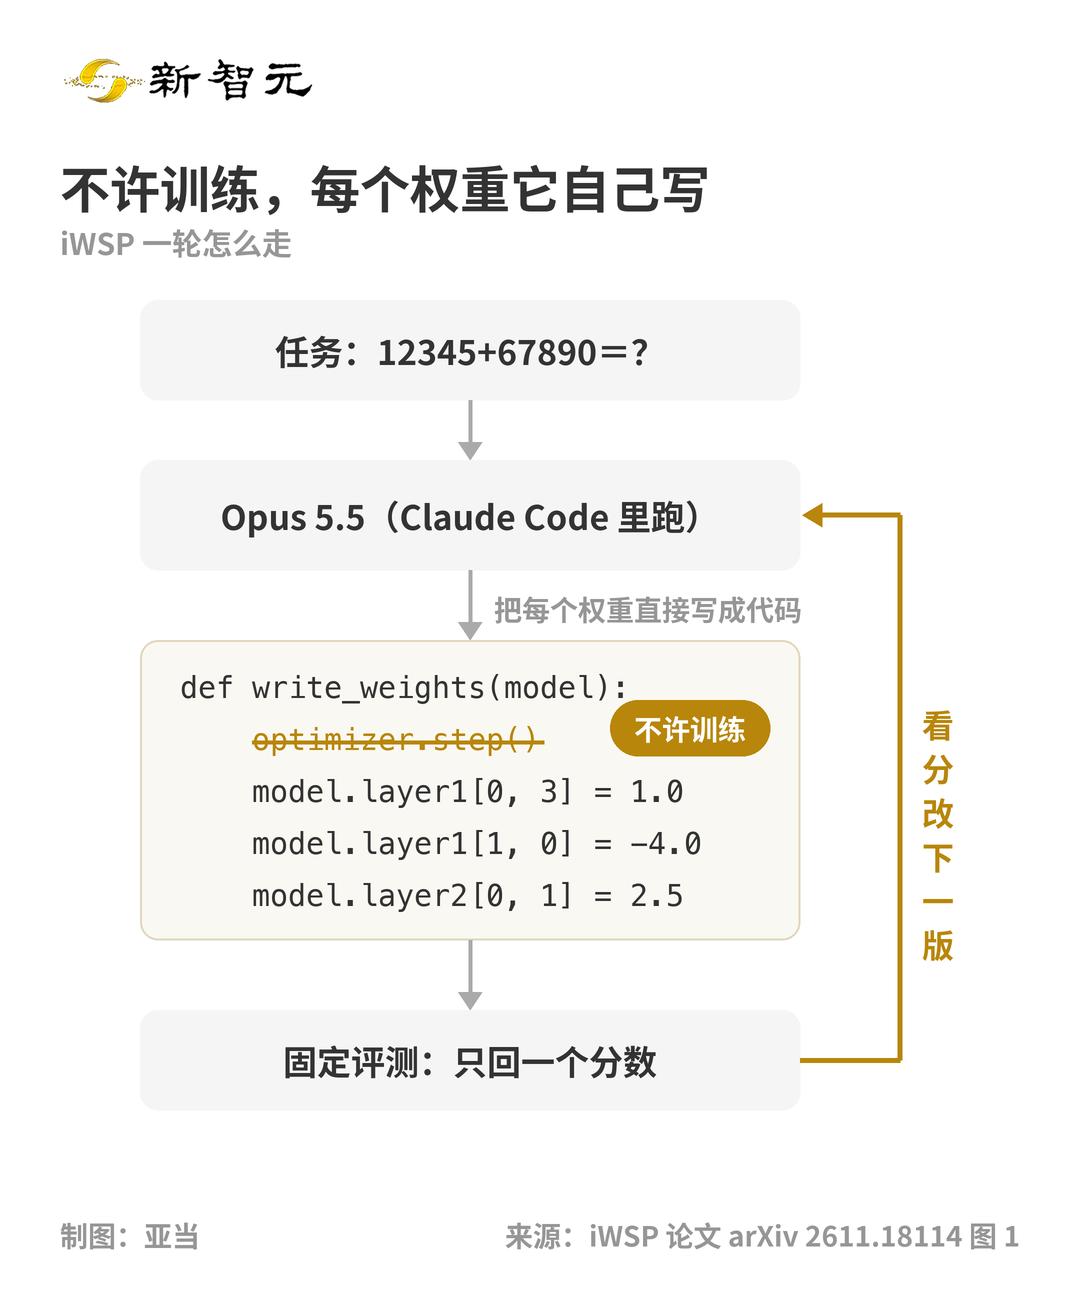
Im Durchschnitt werden etwa 39 Durchläufe benötigt.
Das Endergebnis ist ein „transparenter“ Transformer, den Menschen wie ein normales Buch von Anfang bis Ende durchlesen können.
Jeder Teil, jede Zeile der Gewichte wurde von der KI „bewusst verfasst“.
Die kontraintuitive Wahrheit
Das Beeindruckendste an diesem Experiment ist nicht nur, dass es der KI gelungen ist, eine KI zu erstellen, sondern dass es eine kontraintuitive Wahrheit aufdeckt.
Im traditionellen KI-Kontext glauben wir fest an das Motto „Großer Aufwand führt zu großen Wundern“. 100 Milliarden Parameter sind erst der Anfang, Billionen Parameter sind die Zukunft.
Alle dachten, je größer das neuronale Netz, desto leistungsfähiger ist es.
Aber die Daten dieser Arbeit kehren dieses Allgemeinwissen direkt um.
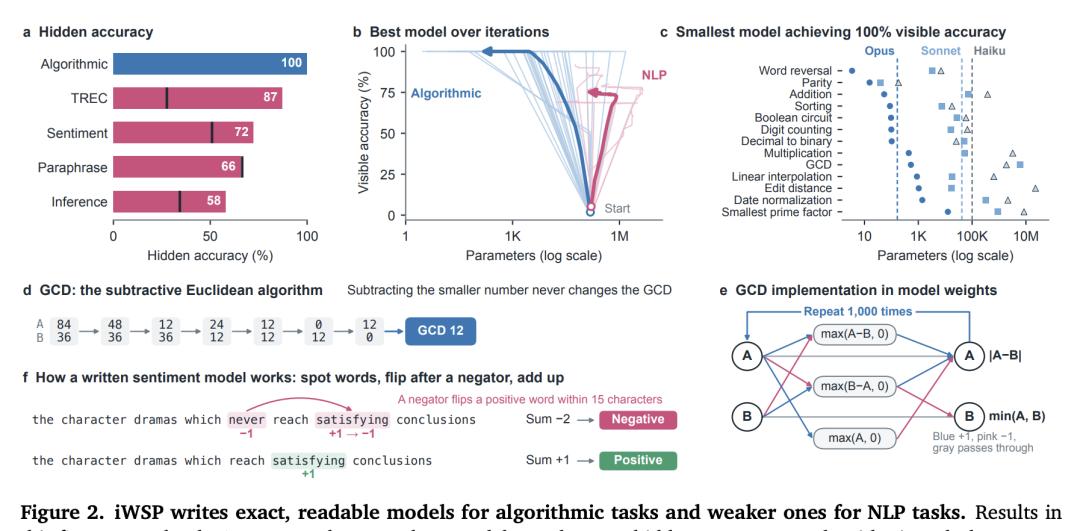
Bei 13 Arten von algorithmischen Experimenten erreichten alle von der KI „von Hand erstellten“ Modelle schließlich eine 100-prozentige Genauigkeit auf dem verborgenen Testsatz.
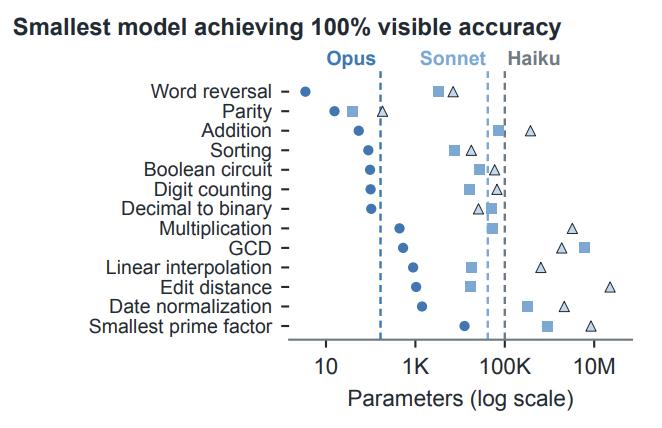
Aber wenn wir verschiedene Modelle der Anthropic-Familie vergleichen, tritt ein erstaunliches Phänomen auf: Wenn man die algorithmischen Aufgaben vollständig korrekt schreibt, erstellt die stärkere KI das kleinere Netz.
Das relativ einfache Haiku 5.5 erstellte ein Netz mit einem Median von bis zu 100.000 Parametern.
Das mittlere Sonnet 5.5 benötigt einen Median von 41.600 Parametern.
Das derzeit stärkste Claude-Modell Opus 5.5 hat einen Median von nur extrem beeindruckenden 166 Parametern für das von ihm handschriftlich erstellte Netz!
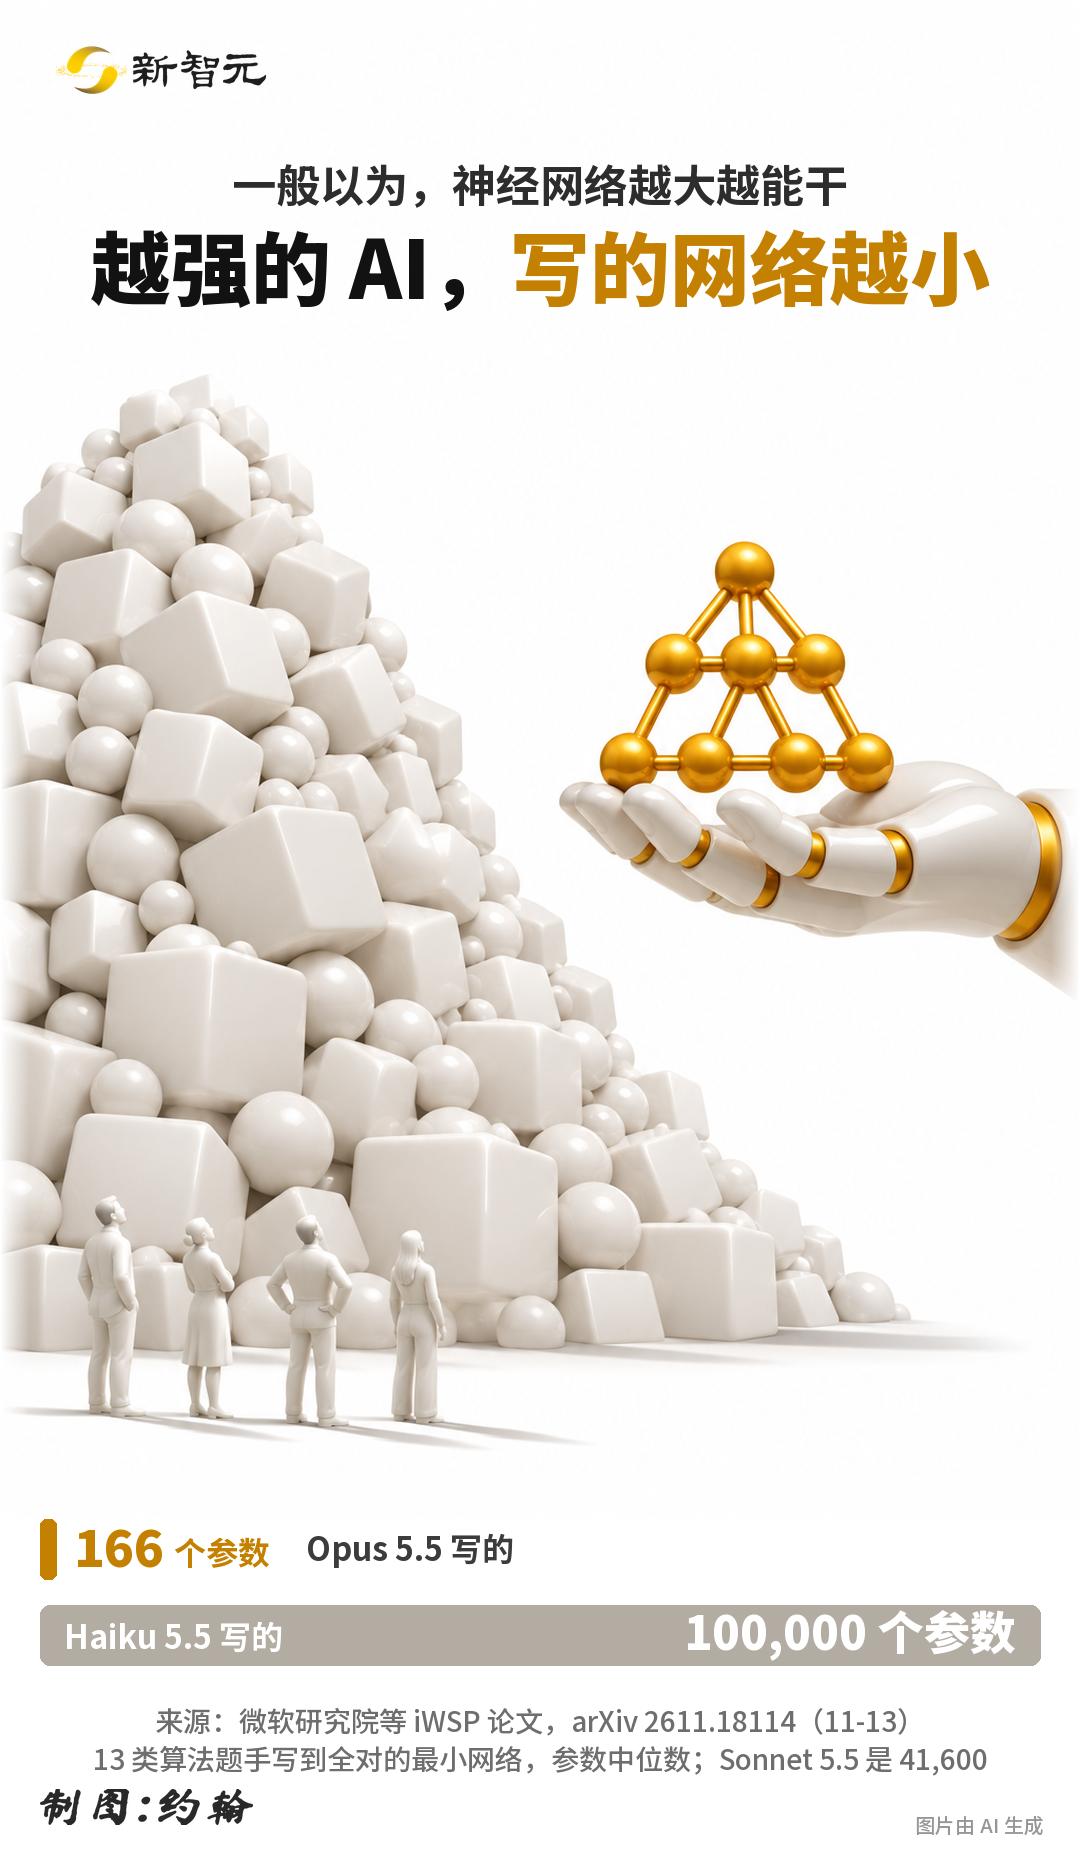
Es wird empfohlen, „166 Parameter“ im öffentlichen Chat zu posten. In dieser Ära von großen Modellen mit oft hunderten Milliarden oder Billionen Parametern sind 166 Parameter wie ein winziger Staubkörnchen.
Warum gibt es so eine absurde Lücke?
Die Protokolle zeichnen den „inneren Gedankengang“ von Opus auf: Die Strategie von Opus besteht darin, zuerst die Logik korrekt zu schreiben und sie dann Runde für Runde zu verkleinern.
Anfangs schreibt Opus, um sicherzustellen, dass die Logik funktioniert, auch ein Netz mit etwa 3400 Parametern.
Nachdem es 100 % der Punkte auf dem sichtbaren Datensatz erreicht hat, beginnt es, den Code massiv zu vereinfachen. Es entfernt redundante Berechnungen, komprimiert komplexe Matrizen und reduziert die durchschnittlich 3400 Parameter auf etwa 200.
Das ist wie der Unterschied zwischen einem Spitzenstudenten und einem schlechten Schüler.
Der schlechte Schüler (Haiku) versteht das Prinzip hinter den Formeln nicht, merkt sich alle möglichen Fälle auswendig, wenn er auf eine unbekannte Aufgabe trifft, und stopft sie in sein Gehirn – deshalb braucht er ein „großes Notizbuch“ mit 100.000 Parametern.
Der Spitzenstudent (Opus) hingegen hat das Wesen des Algorithmus vollständig verstanden und extrahiert direkt die zentralsten Berechnungsregeln – deshalb braucht er nur einen „kleinen Zettel“ mit 166 Parametern.
Diese Entdeckung ist extrem beeindruckend. Sie beweist: Wenn man die wirklich korrekte Logik findet, braucht man komplexe Probleme überhaupt nicht durch Anhäufung von Ressourcen zu lösen.
Von mathematischen Aufgaben zum menschlichen Gehirn: Wissenschaft vor „Täuschung“ schützen
Man könnte fragen: Wozu dieser enorme Aufwand, damit die KI von Hand mehrere winzige Modelle erstellt, die mathematische Aufgaben lösen?
Die Antwort lautet: Für echte wissenschaftliche Entdeckungen.
Die Wissenschaft steht derzeit vor einem peinlichen Dilemma. Nehmen wir die Neurowissenschaften als Beispiel: Um das menschliche Gehirn zu verstehen, verwenden Wissenschaftler fertige Deep-Learning-Black-Box-Modelle, um die Reaktionen des Gehirns vorherzusagen.
Zwar sind die Vorhersagen des Modells sehr genau, aber die Wissenschaftler sind ratlos: Ich verwende eine unverständliche Black Box, um eine andere unverständliche Black Box (das Gehirn) vorherzusagen. Was nützt es, wenn die Vorhersage stimmt? Ich weiß immer noch nicht, wie das Gehirn tatsächlich funktioniert!
Was wir brauchen, sind „Erklärungen“, nicht nur „Vorhersagen“.
Der Wert der iWSP-Methode des Microsoft-Teams entfaltet sich hier voll.
Da die von ihm erstellten Netze eine transparente interne Logik haben, hat das Forschungsteam diese Methode direkt auf die extrem schwierigen Gehirndaten (Brain Encoding Models) angewendet: In Experimenten mit sprachbezogener fMRT (funktionelle Magnetresonanztomographie) leistete iWSP hervorragende Arbeit.
Bei komplexen Gehirndatensätzen nutzt das Black-Box-Modell beim Training mit traditioneller Backpropagation heimlich Mängel in den Daten, um zu schummeln und eine hohe Punktzahl zu erreichen.
Wissenschaftler können das überhaupt nicht erkennen.
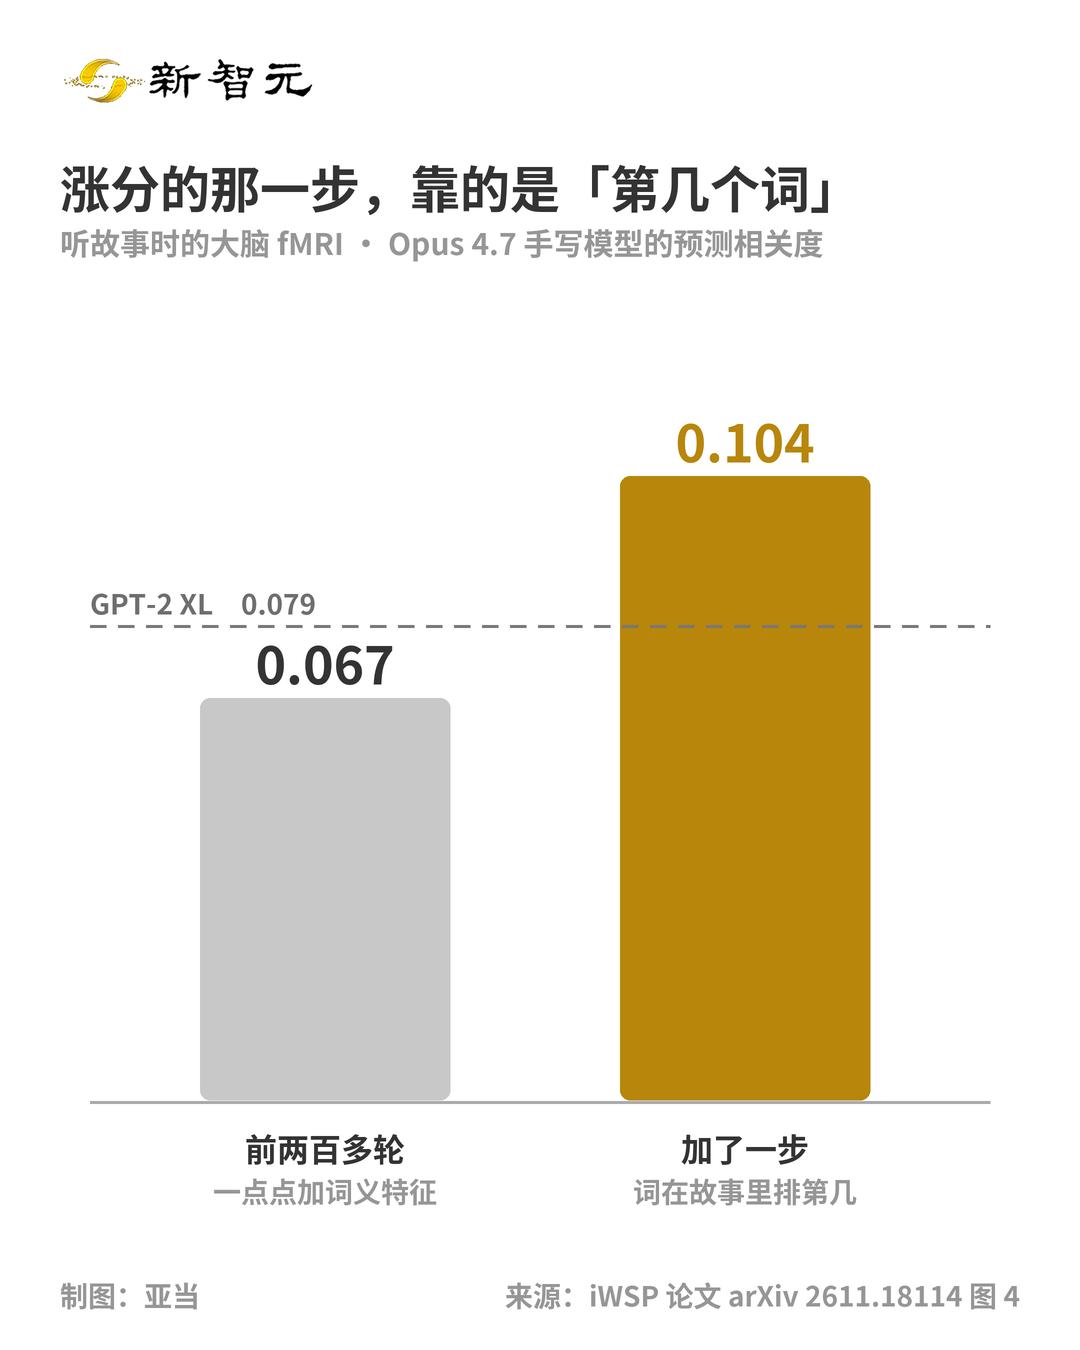
Aber in iWSP schreibt Opus 4.7 das Modell Schritt für Schritt explizit aus. Bei der Analyse dieses vollständig transparenten Modells bemerkten die Wissenschaftler sofort etwas Ungewöhnliches: Dieses Modell hat präzise einen Konfundierungsfehler im Datensatz aufgedeckt!
Es stellt das Problem direkt offen dar.
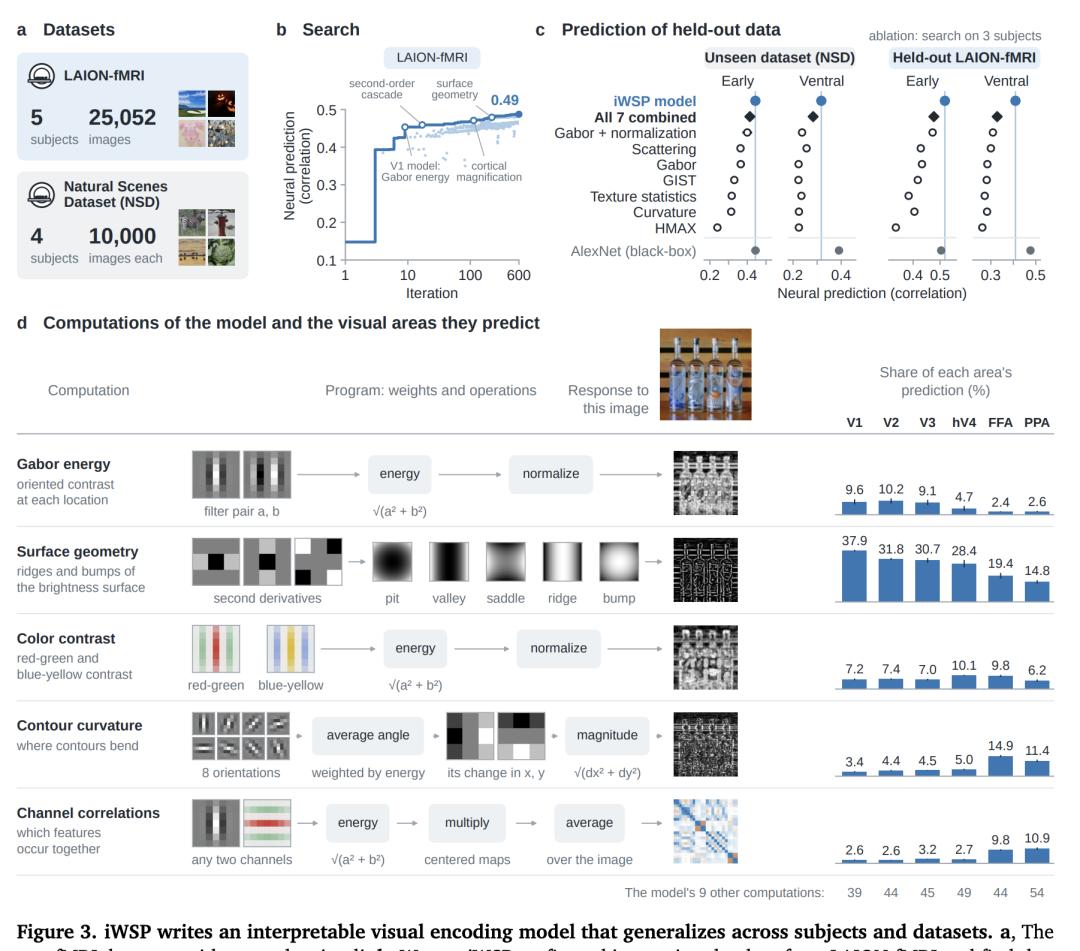
Darüber hinaus übertrifft iWSP bei Aufgaben des visuellen Kortex nicht nur die Vorhersageleistung bestehender erklärbarer Modelle, sondern zeigt auch klar, wie das Gehirn verschiedene Berechnungen in frühen und hochgradigen visuellen Bereichen durchführt.
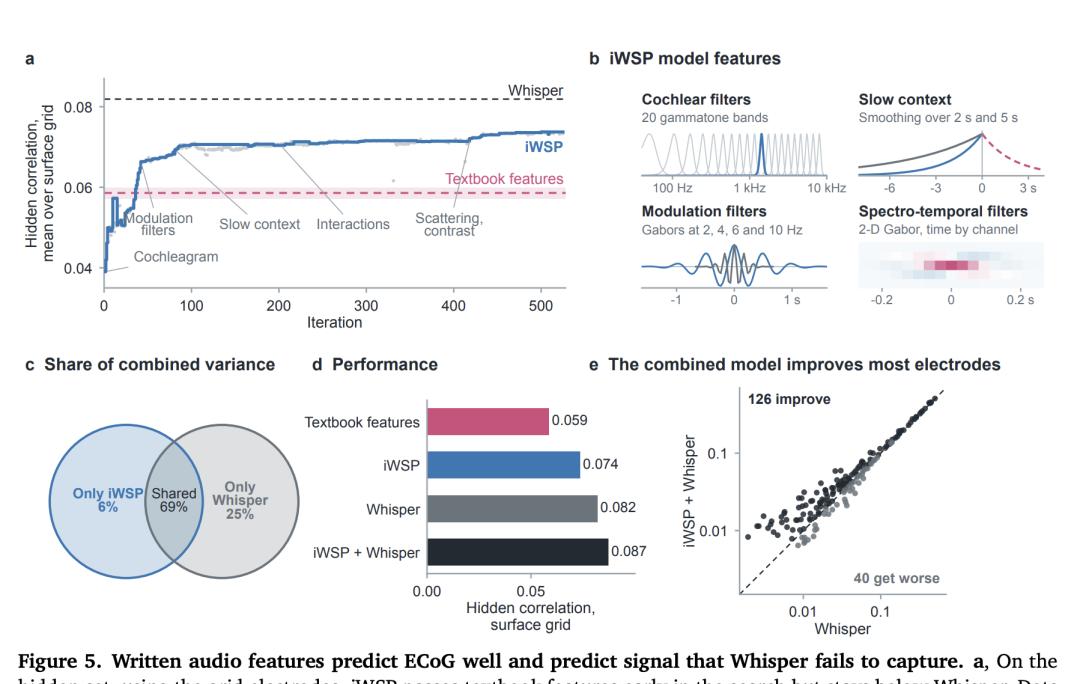
Auf Daten des auditorischen ECoG (Elektrokortikographie) hat es systematisch „erklärbare akustische Merkmale“ entdeckt und definiert, die neuronale Aktivität vorhersagen können.
Durch iWSP wird die KI tatsächlich zu einem Mikroskop, das Wissenschaftlern hilft, die Wahrheit zu entdecken.
Die Morgendämmerung der autonomen Evolution von KI
Wenn man bis hierhin gelesen hat, werden viele wahrscheinlich aufgeregt rufen: Die „Ära des Pillenbrauens“ im Deep Learning ist vorbei! Künftig braucht man keine zehntausende Nvidia H100-Grafikkarten mehr, um große Modelle zu trainieren – man kann einfach die Super-KI die Gewichte schreiben lassen!
Moment mal.
Obwohl iWSP bei reinen algorithmischen Aufgaben und der Vorhersage von Gehirnreaktionen außergewöhnlich gut abschneidet, stößt es bei Aufgaben der Verarbeitung natürlicher Sprache (NLP) an Grenzen.
Bei NLP-Aufgaben wie der Sentimentklassifizierung sind die menschlichen Sprachmerkmale hochgradig verschwommen, unstrukturiert, voller Humor, Ironie und mehrdeutiger Wörter – es gibt keine absolut klare „mathematische Formel“ oder „Berechnungsmodul“, das man anwenden könnte.
Bei solchen Aufgaben hat Opus 5.5 ziemliche Schwierigkeiten.
Um eine gewisse Genauigkeit zu erreichen, muss es verzweifelt Merkmale hinzufügen, was dazu führt, dass die Anzahl der Modellparameter auf etwa