GPUs werden nicht vollständig ausgelastet, CPUs kommen mit der hohen Arbeitslast nicht zurecht – kann die DPU die Vorherrschaft an sich reißen und die dominierende Position einnehmen?
Im März 2019 erwarb NVIDIA den Hersteller von Server- und Netzwerkchips Mellanox für 6,9 Milliarden US-Dollar und schlug dabei Giganten wie Intel, Microsoft und Xilinx.
Eineinhalb Jahre später nannte NVIDIA Mellanoxs „Smart-NIC“ BlueField offiziell DPU und reihte es neben CPU und GPU als „dritten Hauptchip“ im Rechenzentrum ein: Die CPU ist für allgemeine Berechnungen zuständig, die GPU für beschleunigte Berechnungen und die DPU für Datentransport und Datenverarbeitung.
Nach dem von Jensen Huang öffentlich vorgegebenen Zeitplan werden innerhalb von fünf Jahren jedes Rechenzentrum weltweit DPU einsetzen.
Gestützt auf diese groß angelegte Vision folgten zahlreiche Chip-Unternehmen schnell nach: Intel brachte 2021 die IPU-Produktlinie auf den Markt, AMD erwarb 2022 den DPU-Hersteller Pensando, und inländische DPU-Startups wie Zhongke Yushu, Nebula Link und Yunbao Intelligent erhielten nacheinander hohe Finanzierungsbeträge.
Im Ergebnis hat sich die Prophezeiung von Jensen Huang nur teilweise erfüllt.
DPU hat sich zwar in hyperskaligen Rechenzentren verbreitet, aber die Chips, die einen großen Betriebsmaßstab erreichen, sind hauptsächlich selbst entwickelte Chips von Cloud-Anbietern: AWS hat bereits 2017 die Nitro-Karte in großem Maßstab eingeführt, Google hat gemeinsam mit Intel die IPU E2000 maßgefertigt, Microsoft hat nach der Übernahme von Fungible die Azure Boost DPU vorgestellt... Die kommerziellen DPU von NVIDIA und AMD sind lange Zeit „hoch gelobt, aber kaum angewendet“ geblieben.
Bis zur Welle der intelligenten Agenten im Jahr 2026.
Nach den Prognosen von AMD werden im Jahr 2026 etwa 60 % der weltweiten KI-Rechenleistung für Modellinferenz verwendet. Mit der Verbreitung von Inferenz mit langem Kontext und intelligenten Agenten hängt die tatsächliche Leistung eines Rechenzentrums direkt davon ab, wie die riesige KV-Cache und der Echtzeit-Speicher schnell an die GPU übergeben werden können.
Als Datentransport und Datenverarbeitung zu dem entscheidenden Glied wurden, das die Token-Produktionskapazität einschränkt, hat die DPU endlich die Chance erhalten, ihre dominante Position auszubauen.
01. Die Sorge um „Ersetzung von Berechnung durch Speicherung“: Warum ist die CPU zum Engpass geworden?
Dass DPU wieder in den Fokus rückt, hängt untrennbar mit der „Speicherwand“ und der „Wirtschaftlichkeitsrechnung“ bei der Inferenz großer Modelle zusammen.
Bei der autoregressiven Inferenz müssen große Modelle die bereits berechnete KV-Cache speichern, um zu vermeiden, dass bei der Generierung jedes neuen Tokens der gesamte Kontext neu berechnet werden muss. Das Problem besteht darin, dass je länger das Kontextfenster des Modells ist, desto mehr KV-Cache muss gespeichert werden.
Von 2023 bis 2025 ist das Kontextfenster gängiger großer Modelle von 128K auf eine Größenordnung von einer Million Token angestiegen. Am Beispiel einiger Modelle mit großen Parametern kann die KV-Cache einer einzelnen Sequenz von einer Million Token bereits 10 GB bis 100 GB Speicherplatz belegen.
Nach der von Microsoft auf einem 72-GPU-Rack demonstrierten Durchsatzrate von 1,1 Millionen Token pro Tag kann unter einer bestimmten Modellkonfiguration die tägliche erzeugte KV-Cache-Datenmenge einer einzelnen GPU bis zu 92 TB erreichen. Bei einer einfachen Umrechnung reichen 80 GB HBM-Grafikspeicher nur für etwa 1,2 Minuten, und selbst 1 TB DRAM reicht nur für etwa 16 Minuten.
Intelligente Agenten verschärfen den „Speicherdruck“ weiter.
Wenn ein intelligenter Agent eine Aufgabe ausführt, durchläuft er normalerweise Zyklen wie Modellüberlegungen, Aufrufen von Tools, Warten auf Ergebnisse, erneutes Überlegen und erneutes Aufrufen. Jeder Schalter wechselt zwischen der Generierung auf der GPU und der Ausführung durch CPU- und E/A-Tools, und jede Runde muss Systemprompts, Tool-Listen und Rückgabeergebnisse mitführen.
Nach Berechnungen von Micron Technology kann der Bedarf an Speicherkapazität in Szenarien mit intelligenten Agenten das 10- bis 40-fache der normalen Inferenz betragen.
Da Grafikspeicher und Arbeitsspeicher nicht ausreichen, um alle Daten aufzunehmen, hat die Branche einen Übergang vollzogen: Die vorübergehend inaktive KV-Cache wird auf NVMe-SSD ausgelagert und bei Bedarf wieder in den Grafikspeicher zurückgeholt.
Nach den von Omdia im Jahr 2025 statistisch erfassten Medienkosten beträgt HBM3E etwa 14 US-Dollar pro GB, DDR5 etwa 8,50 US-Dollar pro GB; nach den Kosten pro Byte nach der Bereitstellung ist DRAM etwa 44-mal so teuer wie NVMe-SSD.
Das vLLM-Team hat einen Test durchgeführt: In einer Umgebung mit 2×H100 und getrennter PD kann bei mehr als 128 gleichzeitigen Sitzungen und gefülltem CPU-Arbeitsspeicher die Auslagerung auf die Speicherschicht weiterhin eine hohe Trefferquote aufrechterhalten und den Prefill-Durchsatz verdoppeln.
Das Problem liegt genau im Vorgang, „Daten von der SSD zurück zur GPU zu holen“.
In der traditionellen Serverarchitektur spielt die CPU seit langem die zentrale Rolle für den Datenfluss: Wenn die GPU Daten aus dem externen Speicher lesen möchte, muss sie normalerweise das Host-Betriebssystem, das Dateisystem, den Speicherprotokollstapel und die Speicherverwaltungsmechanismen durchlaufen, um den Datentransport endgültig abzuschließen.
Die unterschiedlichen Implementierungswege variieren, aber im regulären E/A-Modus können Metadatenabfragen, Protokollverarbeitung, Verschlüsselung und Entschlüsselung sowie mehrfache Speicherkopien eine große Menge an CPU-Ressourcen verbrauchen. Für traditionelle Unternehmensanwendungen ist dieser Overhead noch akzeptabel.
Bei Inferenzanforderungen, bei denen jede Sekunde zählt, wird dies zu einem Engpass: Wenn die Parallelität der Inferenz stetig steigt, treffen massenhafte Lese- und Schreibanforderungen für KV-Cache kontinuierlich auf die CPU und das Host-E/A-System. Die CPU, die ursprünglich für die Koordination des Datenflusses zuständig war, kann selbst zu einem Engpass werden, der die GPU ausbremst.
Bereits während der GTC im Oktober 2020 demonstrierte NVIDIA die Machbarkeit der GPU Direct-Beschleunigung für Speicher: Durch die Reduzierung des Datentransportpfades, an dem die CPU beteiligt ist, wurde in bestimmten Tests eine Bandbreitensteigerung von bis zu 2,8-fach erreicht und der CPU-bezogene Overhead um das 3- bis 5-fache gesenkt.
Wenn „wie viele effektive Token pro Megawatt Strom erzeugt werden können“ zu dem zentralen Betriebsindikator von KI-Fabriken wird, ist es zu einem Problem geworden, dem sich Architekten stellen müssen, wie man Daten an den redundanten Verarbeitungsabläufen vorbeiführt, an denen die CPU beteiligt ist – und dies gibt der DPU die Chance, wieder an Bedeutung zu gewinnen.
02. Giganten steigen ein, DPU beschleunigt den Ausbau ihrer dominanten Position
Unter den Akteuren, die versuchen, die Machtgrenzen der CPU neu zu gestalten, ist NVIDIA einer der radikalsten.
Im Oktober 2025 veröffentlichte NVIDIA die BlueField-4-Serie, die die Grenze zwischen der traditionellen Smart-NIC und einer unabhängigen Rechenplattform weiter verwischt.
Die Standard-BlueField-4-DPU verfügt über etwa 126 Milliarden Transistoren, integriert einen 64-Kern-Grace-CPU, bis zu 128 GB LPDDR5X-Arbeitsspeicher, einen PCIe 6.0 x16-Bus und eine Netzwerkschnittstelle mit bis zu 800 Gb/s... Es ist kaum noch möglich, es mit dem traditionellen Begriff „Smart-NIC“ zu definieren.
Auf der Seite der Speicherknoten hat NVIDIA auch Lösungen in unterschiedlichen Formen vorbereitet.
Zum Beispiel die auf der OCP 2026 vorgestellte STX-Version, die die Vera-CPU-Architektur verwendet; die auf der Hot Chips 2026 vorgestellte Dual-BlueField-4-Vera-Lösung, die die Speicherzugriffsbandbreite auf 3,2 Tb/s anhebt und eine 10-fache IOPS- und 5-fache Energieeffizienzsteigerung verspricht.
Dahinter verbirgt sich ein größeres Ehrgeiz von NVIDIA.
In der Vergangenheit war DPU hauptsächlich dafür zuständig, Netzwerk-, Sicherheits-, Virtualisierungs- und teilweise Speicheraufgaben zu entlasten, um die CPU von wiederholenden Arbeiten zu befreien; jetzt hofft NVIDIA, dass DPU den wichtigsten Datenflussabschnitt bei der Inferenz großer Modelle weiter übernimmt.
DPU entwickelt sich von einem Hilfsprozessor der CPU zu einem neuen Knotenpunkt zwischen GPU und Speicher.
Um das Ziel zu erreichen, hat NVIDIA zwei zusammenwirkende Lösungen vorbereitet.
Erste Lösung: Neudefinition der Speicherhierarchie.
Die traditionelle Speicherarchitektur von Rechenzentren kann grob in vier Ebenen unterteilt werden: G1 ist der HBM-Grafikspeicher innerhalb der GPU, der die höchste Geschwindigkeit und die höchsten Kosten aufweist; G2 ist der Host-DRAM; G3 ist die lokale SSD; G4 ist der gemeinsam genutzte Speicher mit größerer Kapazität, aber höherer Zugriffslatenz.
Dieses System läuft seit vielen Jahren in traditionellen Rechenszenarien, aber in der Ära der groß angelegten Inferenz mit intelligenten Agenten zeigen sich allmählich seine Grenzen.
Obwohl lokale SSD schnell ist, kann sie nicht flexibel zwischen verschiedenen Rechenknoten gemeinsam genutzt werden; obwohl der gemeinsam genutzte entfernte Speicher über ausreichende Kapazität verfügt, können Zugriffslatenz und Netzwerk-Overhead die Reaktionseffizienz der GPU beeinträchtigen; insbesondere wenn mehrere intelligente Agenten dasselbe Wissen, dieselben Tools und denselben historischen Kontext gemeinsam nutzen, entsteht eine große Menge an redundantem Datentransport, wenn jeder Knoten die KV-Cache separat speichern und wiederholt laden muss.
Die Antwort von NVIDIA besteht darin, eine neue G3.5-Ebene zwischen die traditionellen Speicherhierarchien einzufügen, nämlich die Kontextspeicherebene (CMX).
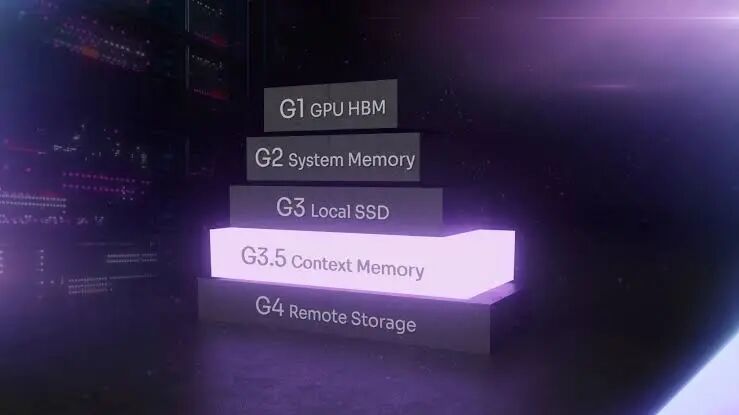
Nach dem Design von NVIDIA organisiert CMX über BlueField-4 die Flash-Speicherressourcen auf Rack-Ebene zu einem gemeinsam genutzten Speicherpool, der speziell die durch groß angelegte Inferenz erzeugte KV-Cache übernimmt, sodass die GPU nicht mehr darauf achten muss, auf welcher SSD und in welchem Speicherknoten ein bestimmter Kontext gespeichert ist.
Zweite Lösung: DOCA-Softwareökosystem.
Personen, die mit der Geschichte von NVIDIA vertraut sind, assoziieren dies leicht mit CUDA. NVIDIA hat über CUDA ein Softwaresystem aufgebaut, das Entwicklungstools, Programmierframeworks und Anwendungsökosysteme abdeckt, und wandelte allmählich die Hardware-Leistungsvorteile in Plattformwettbewerbsfähigkeit um.
Ein ähnlicher Gedanke wiederholt sich jetzt im DPU-Bereich.
In der Architektur von BlueField-4 sind Softwarekomponenten wie DOCA Memos dafür zuständig, Inferenzframeworks mit dem unterliegenden Speichersystem zu verbinden: Die übergeordnete Inferenz-Engine bestimmt, welche Kontextdaten wann benötigt werden, und die untergeordnete DPU verarbeitet Aufgaben wie NVMe-oF, RDMA, Verschlüsselung/Entschlüsselung, Prüfsummen und den Datenfluss zwischen Knoten über Hardware-Beschleunigung und Software-Offloading.
CUDA hat NVIDIA bereits geholfen, das GPU-Rechenökosystem aufzubauen, und DOCA trägt den Ehrgeiz von NVIDIA, die Plattformfähigkeiten auf den gesamten Datenkanal auszudehnen. Sobald immer mehr Inferenzframeworks und Speicherhersteller eine tiefe Anpassung an DOCA durchführen, hat NVIDIA die Chance, seine Wettbewerbsvorteile von der GPU-Rechenstufe auf den gesamten KI-Datenkanal auszudehnen.
Offensichtlich ist NVIDIA nicht das einzige Unternehmen, das dieselbe Idee verfolgt.
In der im Jahr 2026 vorgestellten rackweiten Helios-Lösung kombiniert AMD EPYC Venice-CPU, Pensando Salina-DPU und Vulcano 800G-Netzwerkkarte, um eine KI-Infrastruktur auf Basis von offenem Ethernet aufzubauen.
Auch hier wird über DPU und Hochgeschwindigkeitsnetzwerk die von der GPU zugängliche Speicherressource erweitert, sodass groß angelegte KV-Cache von der Beschränkung der lokalen Grafikspeicherkapazität befreit wird.
Huawei bietet einen anderen Gedankenansatz.
Auf der Full Connect 2026 veröffentlichte Huawei den OceanStor M900, der Rechen-, Netzwerk- und Speicherkontrollfähigkeiten weiter in die Systemarchitektur integriert und über Technologien wie UnifiedBus den Datenzugriffspfad zwischen Ascend-NPU und SSD verkürzt, um den redundanten Overhead in der traditionellen Host-E/A-Kette zu reduzieren.
Die technischen Routen der drei Giganten sind nicht vollständig identisch, aber sie haben einen Konsens erzielt: Bei dem Wettbewerb um die nächste Generation von KI-Infrastrukturen wird die Effizienz des Datenflusses zu einer Variablen, die ebenso wichtig ist wie die Rechenleistung. Zahlreiche häufige Aufgaben im Netzwerk, im Speicher und sogar in der Kontextplanung werden allmählich von der CPU entkoppelt und der DPU oder anderer spezialisierter Hardware überlassen.
Nach dieser Logik besteht das „Ausbau der dominanten Position“ der DPU im Wesentlichen darin, dass die Kontrolle über den Datenkanal, die die CPU seit langem innehat, auf spezialisierte Prozessoren übergeht.
03. Alternative Routen und die TCO-Frage: Muss man unbedingt DPU kaufen?
Aus der Perspektive von Cloud-Anbietern und großen Unternehmen ist die Antwort wahrscheinlich nicht so einfach. Mindestens drei Variablen stellen die kommerzielle Wertschätzung von DPU in Frage.
Die erste Variable ist die „Verkleinerung“ auf Seiten des Modells.
Der Speicherdruck, der durch KV-Cache entsteht, hängt von der Modellarchitektur, der Kontextlänge, dem Parallelitätsmaßstab und der Organisationsweise der zwischengespeicherten Daten ab. Wenn die erzeugte Menge an KV-Cache durch Innovation der Modellarchitektur reduziert werden kann, ist es natürlich nicht erforderlich, externe Speicherressourcen im gleichen Umfang zu investieren.
Die zweite Variable ist die CXL-Arbeitsspeicher-Poolbildung.
Im Gegensatz zur Auslagerung von KV-Cache auf SSD bietet CXL einen anderen Gedankenansatz: Mehrere Rechenknoten können Arbeitsspeicherressourcen flexibel zugreifen und gemeinsam nutzen. Eine Studie des Teams der Peking-Universität zeigt, dass bei Tests mit DeepSeek-V3.2 der Durchsatz der CXL-Arbeitsspeicher-Poolbildung das 2,1-fache der RDMA-B