Der neue Claude Code-Modus ist da, ohne das Modell auszutauschen, wird der Token-Verbrauch um bis zu 77 % gekürzt.
Entwickler, die Claude Code verwendet haben, haben fast alle die gleiche Erfahrung: Die Arbeit macht wirklich Spaß, aber wenn man die rasant ansteigenden Token-Verbrauchswerte und die Rechnung im Hintergrund beobachtet, tut einem das Herz weh.
In der Vergangenheit hatten Nutzer, die KI-Agenten schneller und kostengünstiger betreiben wollten, in der Regel nur zwei Möglichkeiten: Entweder sie warten geduldig darauf, dass die Anbieter günstigere neue Modelle veröffentlichen, oder sie stufen das Hauptmodell manuell auf ein kleineres Modell herunter und akzeptieren den Rückgang der Lieferqualität.
Aber kürzlich hat Anthropic in den Update-Protokollen von Claude Code (Version 2.1.323 und höher) stillschweigend eine experimentelle Funktion eingefügt, die standardmäßig deaktiviert ist – Code Mode. Unabhängige Messungen Dritter zeigen: Ohne das Modell auszutauschen oder die Intelligenz einzubüßen, senkt die Aktivierung dieses Modus für mehrstufige Entwicklungsaufgaben die tatsächliche API-Rechnung direkt um 22 %–23 %; in Szenarien mit häufigen Aufrufen externer Tools sinkt die Gesamtmenge der vom Modell verarbeiteten Token sogar um 62 %–77 %.
Wenn Anthropic die lokale Skriptorchestrierungsbefugnis weiter übergibt, wird Code weiter zum effizientesten Kommunikationsprotokoll zwischen Agenten und Tools.
Warum hat Claude Code in der Vergangenheit so viel Geld verschwendet?
Um zu verstehen, was Code Mode einspart, muss man zuerst erkennen, wie „unhandlich“ traditionelle Agenten arbeiten.
Im normalen Modus organisiert Claude Code in der Regel die Tool-Aufrufe direkt über das Modell. Zum Beispiel sucht es zuerst Dateien über Bash, ruft dann Read auf, um den Inhalt anzuzeigen, und modifiziert schließlich den Code mit Edit. Wenn nachfolgende Vorgänge von den Ausführungsergebnissen des vorherigen Schritts abhängen, muss das Tool die Ergebnisse an das Modell zurückgeben, das dann entscheidet, was als Nächstes zu tun ist.
Obwohl Claude Code selbst bereits parallele Tool-Aufrufe unterstützt und Befehle stapelweise über Bash-Skripte ausführen kann, ist das Modell bei Aufgaben, die mehrstufige Entscheidungen und die Zusammenarbeit mehrerer Tools erfordern, möglicherweise immer wieder in die Zwischenabläufe eingebunden und verbraucht ständig Token.
Wenn nur ein oder zwei Funktionen geändert werden, ist dieser Ablauf kein Problem. Sobald jedoch Aufgaben auftreten, bei denen Fehler in Dutzenden von Dateien gesucht oder Hunderte von externen Datensätzen über das MCP (Model Context Protocol) abgerufen werden, erweitern zwei versteckte Kosten den Kontext schnell.
Die erste Kostenposition liegt bereits am Anfang. Die unabhängige Bewertungswebsite bestagent.dev hat die Anfrage-Payload zerlegt und festgestellt, dass Claude Code bei deaktiviertem Code Mode standardmäßig 16 eingebaute Tool-Definitionen pro Runde an das Modell sendet, wobei allein die Größe der ersten Anfrage etwa 38.000 Token erreicht. Solange die Sitzung fortgesetzt wird, wird diese „Tool-Beschreibung“ in jeder Anfrage wiederholt übertragen.
Die zweite Kostenposition verbirgt sich im Zwischenprozess. Viele Rückgabewerte von Tools müssen nur kurz überflogen werden, um ein paar nützliche Zeilen herauszufiltern, aber unter dem Mechanismus der rundenweisen Aufrufe werden das gesamte Protokoll und alle ursprünglichen Datensätze in den Gesprächsverlauf übernommen. In Tests mit dem Open-Source-Benchmark Bicameral, bei denen das Modell 120 Arbeitsaufträge über MCP abrufen und die gesamte Rückerstattungssumme berechnen sollte, musste der normale Modus die 120 Datensätze rundenweise vollständig in den Kontext laden.
Man erkennt also: Jedes Mal, wenn ein traditioneller Agent ein Tool aufruft, muss er die gesamte ursprüngliche Ausgabe zusammen mit allen Tool-Definitionen in den Kontext der nächsten Runde einfügen, was dazu führt, dass der Token-Verbrauch mit zunehmender Anzahl von Runden schneeballartig ansteigt.
Eine Operation an der Planungsarchitektur
Was Code Mode tut, besteht im Wesentlichen darin, die Planungsaufteilung zwischen Modell und Tools neu zu strukturieren.
Nach der Aktivierung von Code Mode kann Claude zuerst ein JavaScript schreiben, das mehrere Tool-Aufrufe, Bedingungsentscheidungen, Schleifenausführungen und Ergebnisfilterung in demselben Codeabschnitt organisiert. Bei Vorgängen, die keine schrittweisen Entscheidungen des Modells erfordern, kann das Programm kontinuierlich ausgeführt werden und die von den Tools zurückgegebenen Daten direkt verarbeiten, bis schließlich nur die notwendigen Ergebnisse an den Modellkontext zurückgesendet werden.
Die offizielle Dokumentation von Anthropic nennt ein anschauliches Beispiel: Angenommen, Sie möchten, dass Claude eine bestimmte Konfigurationsdatei findet, die Anzahl der Wiederholungen darin von 3 auf 5 ändert und dann einen Test ausführt. Früher musste es zuerst die Datei suchen, auf das Ergebnis warten, dann die Konfiguration ändern und nach der Änderung den Test ausführen – jeder Schritt musste im Gespräch durchlaufen werden.
Nach der Aktivierung von Code Mode schreibt es selbst ein kleines Skript, das die Aufgaben „Datei suchen, Konfiguration ändern, Test ausführen“ lokal auf einmal erledigt und schließlich nur die beiden Schlussfolgerungen „Welche Datei wurde geändert? Hat der Test bestanden?“ an das Gespräch zurückgibt.
Die Verzeichnisse, die durchsucht wurden, und die großen Mengen an generierten Testprotokollen im Zwischenablauf können zuerst vom Code verarbeitet und gefiltert werden, bevor die notwendigen Informationen an das Modell übergeben werden. Wie viele Token letztendlich eingespart werden können, hängt weiterhin von der Datenmenge ab, die das Skript zurückgibt.
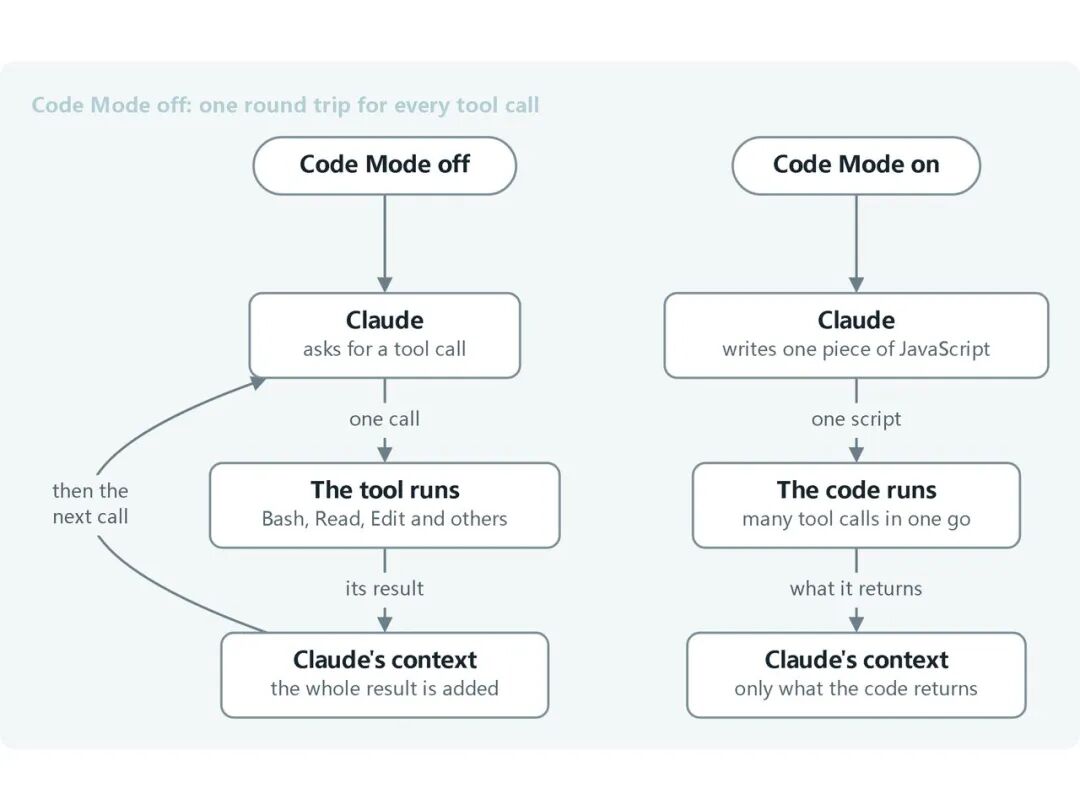
Gleichzeitig hat Code Mode am Eingang eine deutliche Verschlankung vorgenommen: Die eingebauten Tool-Definitionen, die auf der Modellseite empfangen werden, wurden von ursprünglich 16 auf nur 3 Kernzugänge reduziert, die Funktionen wie Codeausführung und Statusabfrage behalten.
Zwei unabhängige Dritttests zeigen übereinstimmende Veränderungen. Laut Messungen von bestagent.dev sinkt die erste Anfrage von etwa 38.000 Token auf etwa 22.000 Token. Bicameral hat bei 4 Modellen ebenfalls gemessen, dass pro Runde der Startfixwert um 13.055–13.106 Token sinkt.
Code Mode schneidet die in jeder Runde erneut übertragenen Tool-Definitionen und die redundanten Zwischenausgaben ab und lässt das Kontextfenster für die Informationen frei, für die das Modell wirklich Entscheidungen treffen muss.
Dividenden starker Modelle, Fallstricke schwacher Modelle
Die Logik zum Einsparen von Token klingt lückenlos, aber die tatsächlichen Messwerte in der realen Welt zeigen eine starke Differenzierung.
Der derzeit umfassendste öffentliche Test stammt vom Open-Source-Benchmark Bicameral. Das Team hat auf Claude Code v2.1.326 mit vier Modellen – Opus 5.5, Sonnet 5.5, Haiku 5.5 und Fable 5.2 – 6 Aufgabentypen ausgeführt, jeweils 2 Runden pro Gruppe, insgesamt 96 Ausführungen (48 Gruppen von Ein-Aus-Vergleichen).
Das auffälligste Ergebnis ist der Test zum Abrufen und Summieren von Daten mit häufigen MCP-Aufrufen: 120 Arbeitsaufträge werden einzeln über externe Tools abgerufen und die gesamte Rückerstattungssumme berechnet. Der inkrementelle Gesprächskontext der 4 Modelle sinkt von etwa 54.000 Token auf 3.500–8.800 Token (Rückgang um 84 %–94 %). Alle 16 Ausführungen waren korrekt, die gesamte verarbeitete Token-Menge sank um 62 %–77 %.
Bei Bewertungsaufgaben zum Abrufen von Daten, bei denen doppelte Belastungen gelesen und gefiltert werden müssen, sinkt die verarbeitete Token-Menge um 40 %–68 % und der Gesprächskontext um 65 %–83 %. Das Testteam weist jedoch darauf hin, dass diese künstlich generierten Arbeitsaufträge Satzmuster aufweisen, sodass das Modellskript zufällig Wiederholungsabschnitte überspringen kann. Es traten 3 Prüffehler auf, die alle auf dem Modell Haiku 5.5 auftraten.
Bei anderen alltäglichen Arbeitsaufgaben verringern sich diese Werte etwas.
Kehren wir zum alltäglichen Lokalen Dateiänderungsvorgang zurück (Suche nach toten Links in 47 Markdown-Dateien, Umbenennung von Funktionen an 36 Aufrufstellen in einem Python-Projekt). Betrachtet man nur die neu erzeugten Gesprächsinhalte während der Ausführung (Aufgabenkontext), sind bei 14 von 16 Vergleichsgruppen keine Einsparungen zu verzeichnen – stattdessen steigt der Wert aufgrund des zusätzlichen Schreibens von Skripten oder der Fehlerbehebung sogar an.
Da jedoch nach der Aktivierung die „Tool-Beschreibung“, die pro Runde mitgeführt wird, fest um etwa 13.000 Token geringer ist, gleicht sich das aus: Bei Opus 5.5, Sonnet 5.5 und Fable 5.2 sinkt die gesamte verarbeitete Token-Menge nach Abschluss des gesamten Vorgangs immer noch um 15 %–54 %.
Nur bei Haiku 5.5 steigt die verarbeitete Token-Menge bei Dateiaufgaben um 9 %. Ein Blick in die Protokolle zeigt, dass der Hauptgrund darin liegt, dass ein Skript einmal das falsche Verzeichnis gefunden hat, und die großen Mengen an generierten Fehlermeldungen die eingesparten Token des Startgrundbetrags vollständig aufgebraucht haben.
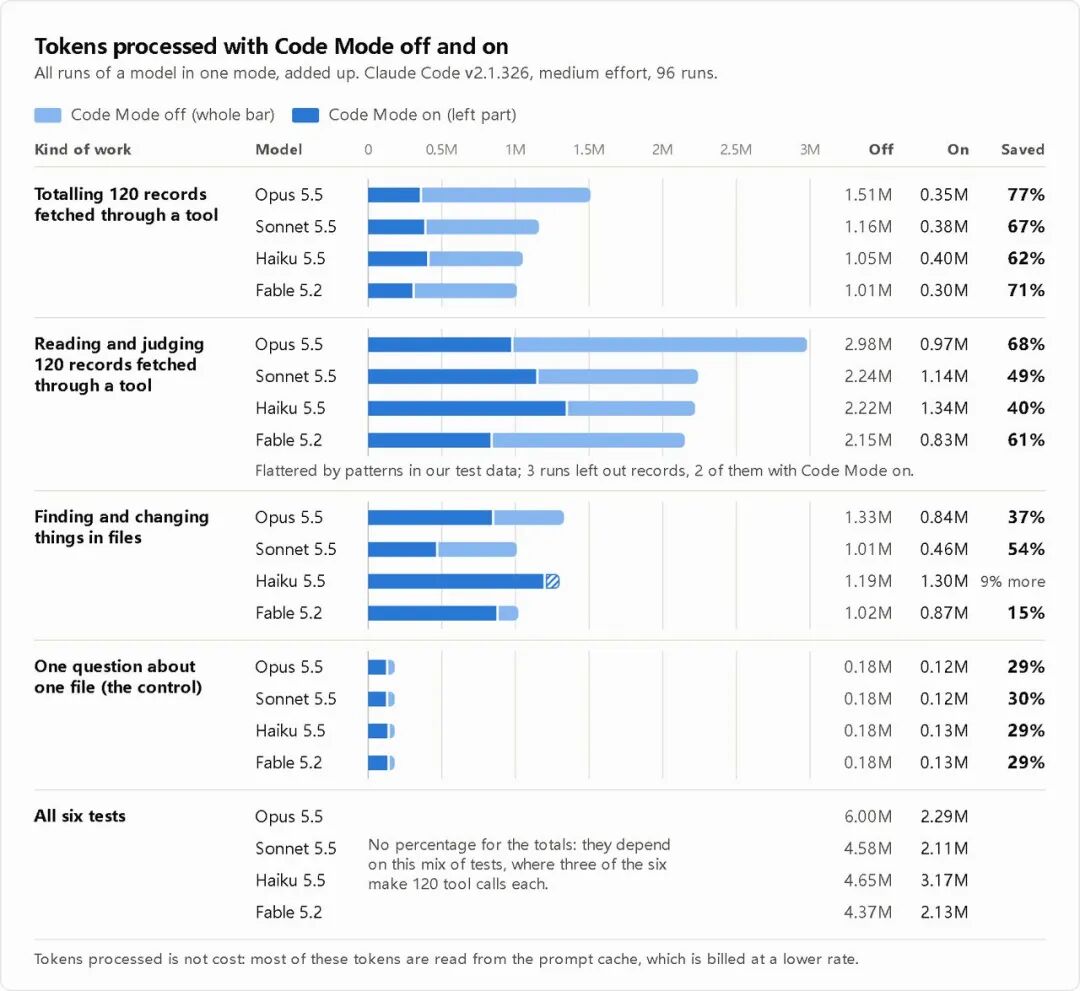
Weiterhin ist zu beachten, dass der Bericht ausdrücklich betont: „Gesamt verarbeitete Token“ entspricht nicht den tatsächlichen Rechnungskosten, da der größte Teil der eingesparten Menge zu dem wiederholt gelesenen Prompt-Cache gehört. Die Plattform berechnet diesen Cache bereits mit einem niedrigeren Rabattsatz.
Eine andere Gruppe von Dritttests von der unabhängigen Bewertungswebsite bestagent.dev hat diese Rechnung in US-Dollar umgerechnet. Das Team hat auf Claude Code v2.1.325 mit Opus 5.5 drei Aufgaben für echte Open-Source-Repositories jeweils 3 Mal nach den offiziellen API-Preisen von Anthropic ausgeführt und Werte ermittelt, die dem alltäglichen Empfinden näher kommen:
Hinzufügen von CLI-Parametern mit Tests: Nach der Aktivierung von Code Mode sinken die Kosten pro Ausführung von 0,45 $ auf 0,35 $ (Einsparung von 23 %), und die Ausführungsdauer verkürzt sich von 80 Sekunden auf 60 Sekunden.
Suche nach toten Links in 134 Markdown-Dateien: Die Kosten sinken von 0,20 $ auf 0,16 $ (Einsparung von 22 %), die Dauer von 26 Sekunden auf 18 Sekunden.
Einheitliches Hinzufügen von Versionsnummern zu 20 Fähigkeitsbeschreibungsdateien: Die Kosten sind fast gleich (0,16 $ gegenüber 0,17 $). Denn selbst ohne Aktivierung von Code Mode schreibt Claude selbst ein kleines Skript in Bash, um alle Änderungen auf einmal durchzuführen.
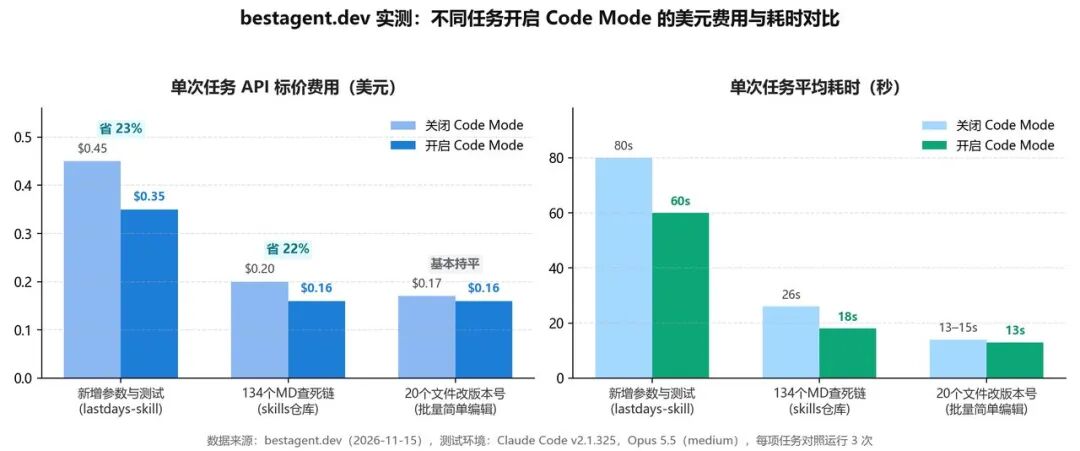
Allerdings hat bestagent.dev nur kurze Aufgaben von unter zwei Minuten mit dem einzelnen Modell Opus 5.5 getestet. Bei komplexeren Aufgaben wie in der ersten Testgruppe können noch bessere Unterschiede bei den tatsächlichen Kosten möglich sein.
Man erkennt, dass Code Mode wirklich gut für komplexe Stapelverarbeitungsaufgaben geeignet ist, wie die stufenweise Datenverarbeitung über mehrere Tools hinweg und die Repository-Entwicklung, die mehrere Runden von Abrufen und Tests erfordert. Bei einfachen Dateibearbeitungen, die bereits mit einer einzigen Shell-Anweisung erledigt werden können, gibt es kaum Unterschiede. Wenn ein schwaches Modell (Haiku 5.5) den falschen Skriptpfad schreibt, kann der Aufwand für Nacharbeiten sogar vergrößert werden.
Es spart Geld und beschleunigt den Vorgang – warum ist es trotzdem „standardmäßig deaktiviert“?
Wenn es echtes Geld einsparen kann, warum setzt Anthropic dann eine Hürde durch Umgebungsvariablen (CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1) und markiert es in der Dokumentation mit der Warnung „Experimentelles Feature, kann jederzeit geändert oder sogar entfernt werden“?
Der wichtigste Engpass liegt in der Sicherheitskontrolle und der Prozessüberwachung.
Im traditionellen Modus muss Claude für jede gelesene Datei und jeden ausgeführten Befehl eine separate Anfrage stellen. Die Berechtigungsregeln, Hook-Skripte und Sicherheitsüberprüfungen des Systems können jede einzelne Aktion überwachen. Auch Unternehmensüberwachungssysteme können für jeden Tool-Aufruf einen klaren Datensatz hinterlassen.
Nach der Aktivierung von Code Mode schreibt Claude jedoch eine ganze Reihe von Aktionen in ein gesamtes JavaScript, das auf einmal ausgeführt wird. Der Sicherheitsklassifikator im Auto-Modus kann den Code nur grob überfliegen und nicht wie früher jeden Pfad, der zur Laufzeit dynamisch zusammengesetzt wird, einzeln detailliert prüfen.