Das um zwei Monate verspätete GPT-6.2 ist überraschenderweise ein totaler "Berichtsfreak"?
Am 17. November Ortszeit in den USA hat OpenAI offiziell GPT-6.2 Astra und GPT-6.2 Sol vorgestellt.
Diese Vorstellung kam später als von der Öffentlichkeit erwartet. Bereits Ende Oktober haben Nutzer im Nutzungsverlauf von ChatGPT Spuren einer Grautestphase ausgegraben, die auf GPT-6.2 hindeuteten, danach strömten ständig Modellkennzeichnungen und Test-Screenshots heraus. Früher hatten Medien vorhergesagt, dass das neue Modell frühestens am 6. November veröffentlicht wird, das endgültige Veröffentlichungsdatum liegt 11 Tage hinter dieser Erwartung.
OpenAI hat dieses Mal die Fähigkeit von KI zur Übernahme professioneller Arbeiten besonders hervorgehoben.
Von der Nachbildung einer vollständigen Präsentation aus dem Screenshot einer PPT über die Extraktion von Finanzdaten und die Erstellung von Bewertungsmodellen bis hin zur Bedienung von Blender zur Generierung von 3D-Modellen von Autos, zur Simulation der physikalischen Bewegung von Fahrzeugaufhängungen und sogar zur Nutzung von CAD zur Konstruktion mechanischer Teile und zur Überprüfung von Montagebeziehungen dringt GPT-6.2 zunehmend in Bereiche vor, die früher nur von Fachkräften mit komplexer Software erledigt werden konnten.
OpenAI betonte insbesondere, dass das neue Modell ungültige Ausgaben und wiederholte Überarbeitungen reduzieren kann, sodass die von KI gelieferten Ergebnisse näher an den Standards professioneller Arbeit liegen.
In den vergangenen mehr als zwei Monaten hat OpenAI nacheinander Modelle wie GPT-6 Astra, Sol und Luna sowie GPT-6.1 Sol, Terra und andere vorgestellt. Das gerade veröffentlichte GPT-6.2 Astra ist das Upgrade des Flaggschiffmodells nach GPT-6 Astra im September, das die Verarbeitungsfähigkeit für komplexe professionelle Aufgaben verbessert; GPT-6.2 Sol stärkt hauptsächlich die Effizienz bei alltäglichen Arbeiten, der Programmierung und mehrstufigen Agentenaufgaben.
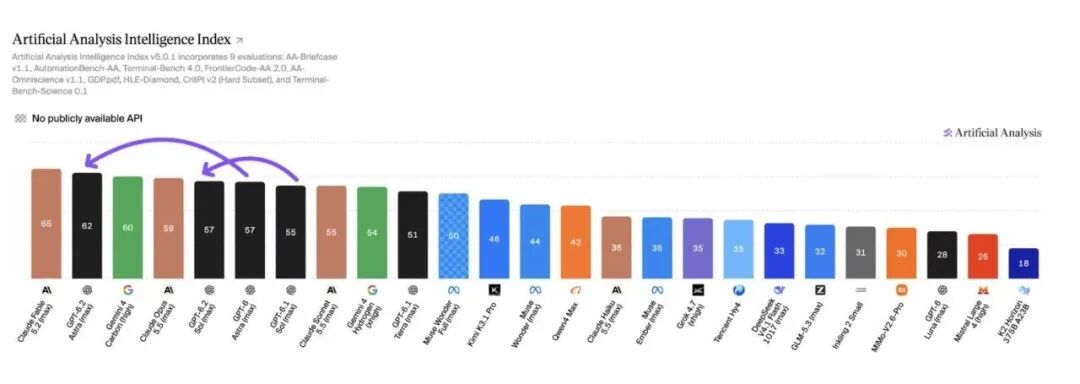
Gemäß der neuesten Rangliste von Artificial Analysis ist Astra mit 62 Punkten auf den zweiten Platz weltweit aufgestiegen, 5 Punkte mehr als die Vorgängergeneration; Sol erreicht 57 Punkte. Was den Preis betrifft, wurden die Preise für API-Eingaben und -Ausgaben von Astra um 20 % gesenkt, der Preis für Cache-Eingaben um 60 %; Sol behält den ursprünglichen Preis bei, aber die Gesamtkosten für die Erledigung einiger Aufgaben sinken weiter.
Es ist bemerkenswert, dass GPT-6.2 Astra auch das erste öffentliche Modell von OpenAI ist, das bewertet wurde, die Hochschwelle der Fähigkeit zur autonomen Verbesserung von KI zu erreichen.
Allerdings haben die beeindruckenden Demonstrationen und Benchmark-Ergebnisse auch unterschiedliche Bewertungen hervorgerufen. Am Veröffentlichungstag äußerten mehrere Entwickler, die das neue Modell bereits seit einigen Wochen ausprobiert hatten, öffentlich ihre Enttäuschung und meinten, dass Astra bei lang andauernden Softwareentwicklungsaufgaben immer noch vorzeitig anhalten kann und dass zu knappe Ausgaben manchmal notwendige Informationen auslassen.
Gleichzeitig werden die Grenzen der Modellfähigkeiten und die Sicherheitskontrolle zu wichtigen Höhepunkten dieser Vorstellung, während die Modelle immer näher an echte professionelle Arbeiten heranrücken.
Sam Altman, Geschäftsführer von OpenAI. Das Bild wurde per KI generiert
01. Leistung und Kosten
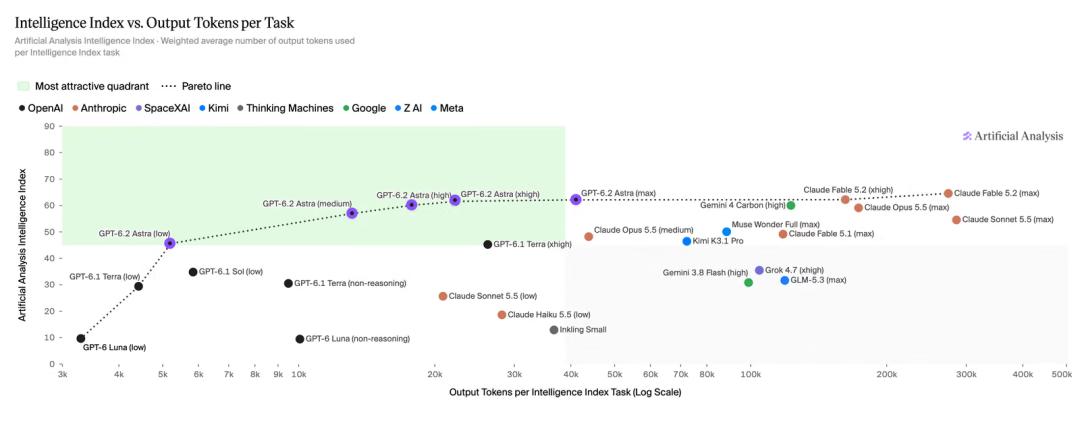
Der API-Preis von GPT-6.2 Astra beträgt 8 US-Dollar pro Million Eingabe-Token, 40 US-Dollar pro Million Ausgabe-Token und 0,40 US-Dollar für Cache-Eingaben. Im Vergleich zur Vorgängergeneration sind die Preise für Eingaben und Ausgaben um 20 % gesunken, der Preis für Cache-Eingaben ist von 1 US-Dollar auf 0,40 US-Dollar gefallen, was einem Rückgang von 60 % entspricht. GPT-6.2 Sol behält den Preis von 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Million Ausgabe-Token bei.
Bei mehrstufigen Agenten können die Einzelpreise der API die tatsächlichen Ausgaben nicht vollständig widerspiegeln. Wenn das Modell Aufgaben ausführt, muss es möglicherweise mehrmals Tools aufrufen, Dateien lesen, Fehler verarbeiten und neu versuchen. Selbst wenn der Einzelpreis unverändert bleibt, sinkt die endgültige Rechnung, wenn weniger Token zur Erledigung der Aufgabe benötigt werden.
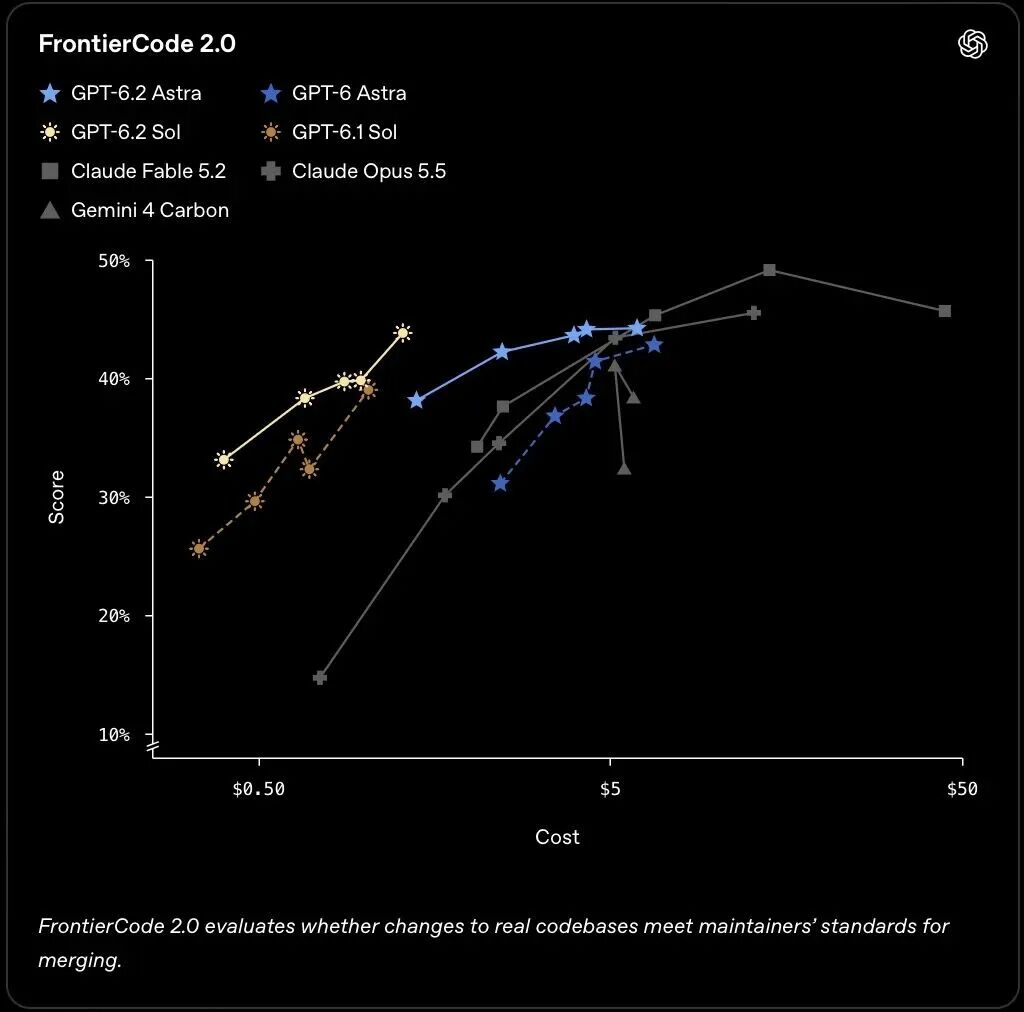
Beim FrontierCode 2.0-Programmiertest von Cognition liegt die Punktzahl von GPT-6.2 Sol nur 0,5 Punkte unter der von Astra, und die Kosten betragen etwa ein Fünftel von letzterem. Bei der LifeVal-Bewertung für alltägliche komplexe Angelegenheiten übertrifft die Punktzahl Sol das Vorgänger-Flaggschiff GPT-6 Astra, und die Kosten für einzelne Aufgaben betragen etwa ein Siebtel von letzterem.
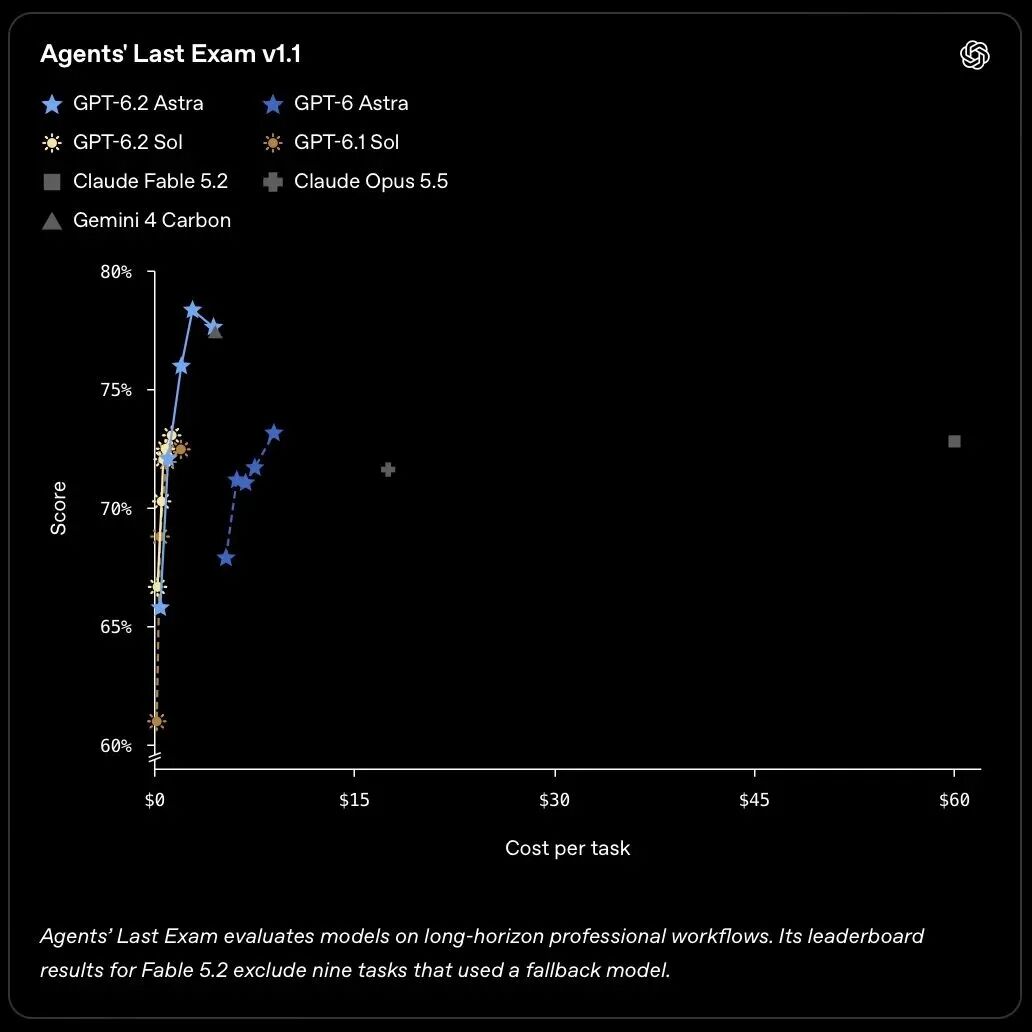
Die Leistung von Astra bei schwierigen Aufgaben hat sich ebenfalls verbessert. Bei der Bewertung Agents' Last Exam hat es um 5,2 Punkte gegenüber GPT-6 Astra zugenommen, und die Kosten für die Erledigung von Aufgaben betragen weniger als ein Drittel der Vorgängergeneration. Im Vergleich zu Claude Fable 5.2 liegt die Punktzahl von Astra um 5,5 Punkte höher, und die Kosten pro Aufgabe betragen etwa 5 % von letzterem.
02. Auslieferung professioneller Arbeit
Professionelle Arbeiten wie Finanzen, Recht und Beratung erfordern, dass KI eine große Menge an Rohmaterialien verarbeitet, Daten überprüft und nach Branchennormen lieferbare Ergebnisse erstellt. Laut OpenAI hat sich die Leistung von GPT-6.2 Astra bei solchen Aufgaben verbessert, sodass es Arbeiten wie Finanzmodellierung, Fusions- und Übernahmeanalyse, Rechtsrecherche und Datenwissenschaftsanalyse erledigen kann.
Der interne GDPval v2-Test von OpenAI deckt Bereiche wie Beratung, Finanzen und Design ab. Die Punktzahl von Astra ist um 6,2 Prozentpunkte höher als die der Vorgängergeneration, und die Ausgabe-Token sind um 22 % gesunken.
Was die Rechtsrecherche betrifft, übertrifft die Bestehensquote von Astra beim Harvey LAB-AA v1.1-Test, der echte Aufgaben von Anwaltskanzleien simuliert, die von Claude Fable 5.2 um das Doppelte, und die Kosten pro Aufgabe betragen etwa ein Sechstel von letzterem.
Der interne GDPval v2 von OpenAI deckt Arbeiten wie Beratung, Finanzen und Design ab. Die Testergebnisse zeigen, dass die Punktzahl von Astra um 6,2 Prozentpunkte höher als die der Vorgängergeneration ist, und die Ausgabe-Token um 22 % gesunken sind.
03. Eintritt in die dreidimensionale Welt
Eine weitere Fähigkeit, die GPT-6.2 Astra dieses Mal demonstriert hat, ist die direkte Beteiligung an 3D-Modellierung und Ingenieurdesign. Das Modell generiert nicht nur einen Code für die Modellierung, sondern kann auch professionelle Software bedienen, Teile verarbeiten, Strukturen anpassen und die Berechnungsergebnisse in visuelle Inhalte umwandeln.
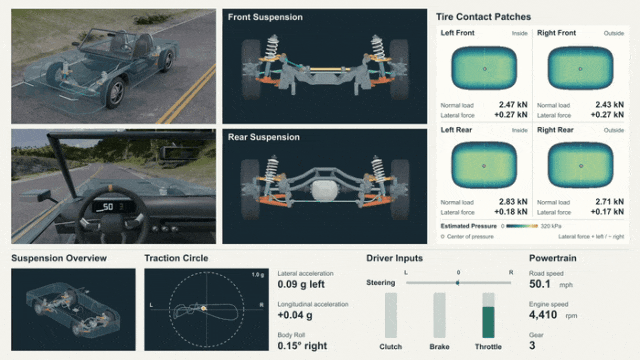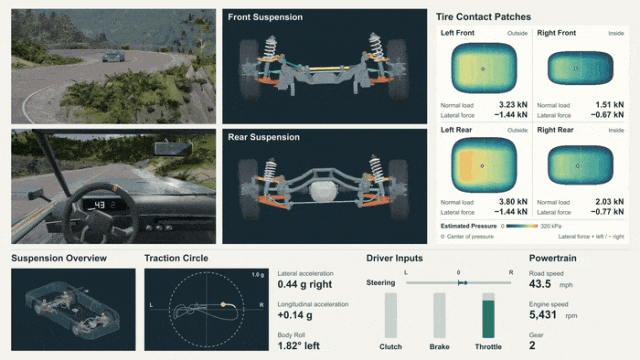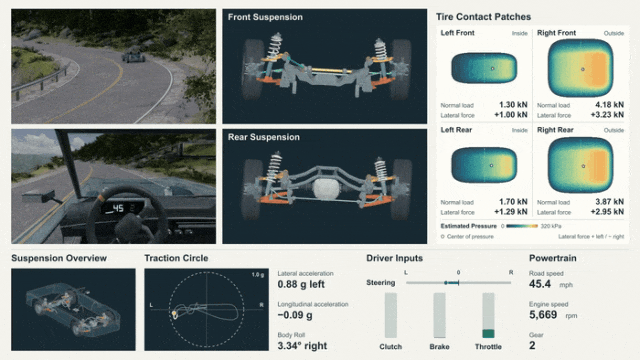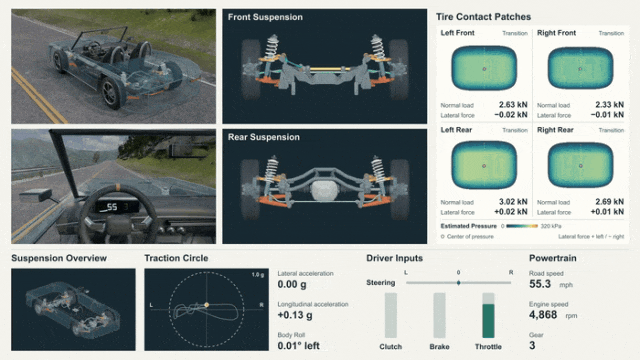
Im Simulationsfall für Bergstraßenfahrten erstellt Astra zuerst das 3D-Modell des Sportwagens, schreibt dann einen physikalischen Python-Löser, berechnet die Bodenkraft der Reifen und die dynamischen Änderungen des Aufhängungssystems und importiert schließlich die Berechnungsergebnisse in Blender, um die Fahranimation des Fahrzeugs zu generieren. Durch die Simulation können Ingenieure vor der Herstellung physischer Prototypen die Lastübertragung des Fahrzeugs bei der Fahrt durch komplexe Straßenverhältnisse beobachten.
Die Eingabematerialien für den mechanischen Modellierungsfall sind viel einfacher. OpenAI hat nur öffentliche Fotos und Montageanleitungen für ferngesteuerte Geländewagen im Maßstab 1:8 und Reihensechszylinder-Motoren bereitgestellt. Astra erstellt daraus 3D-Modelle aller mechanischen Teile und generiert eine schrittweise Montageanimation und ein illustriertes Teileverzeichnis.
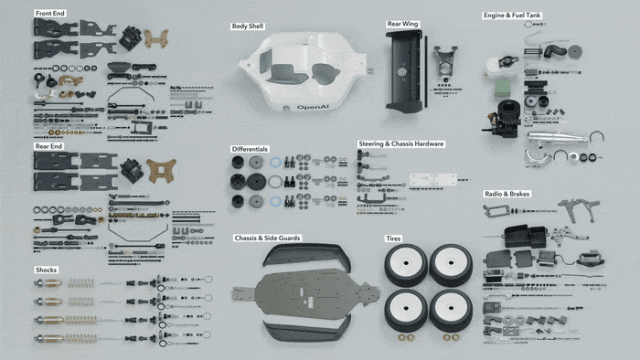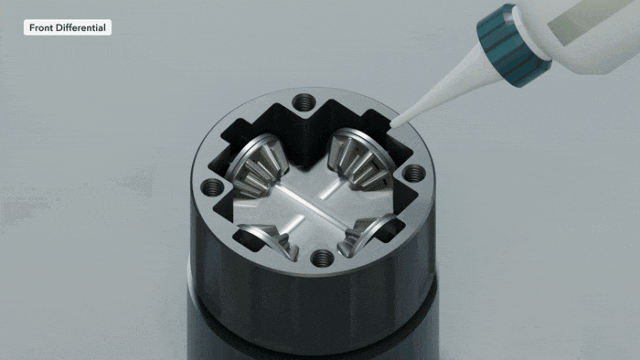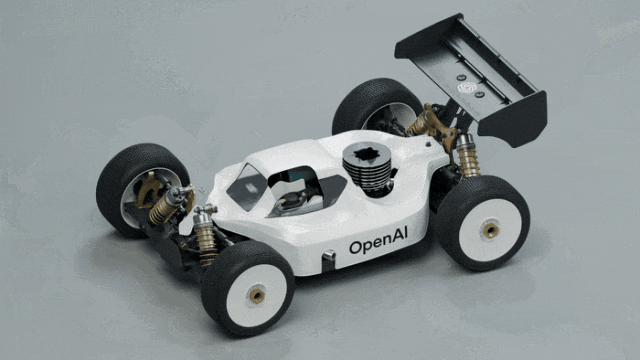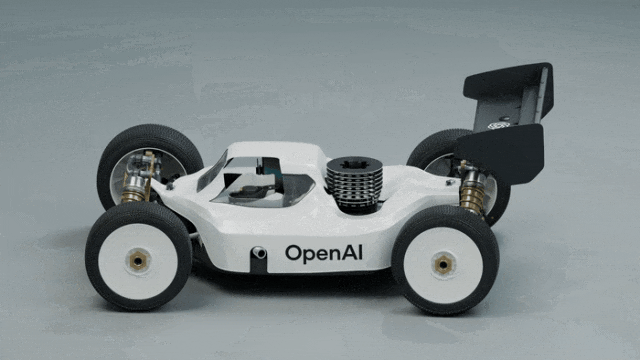
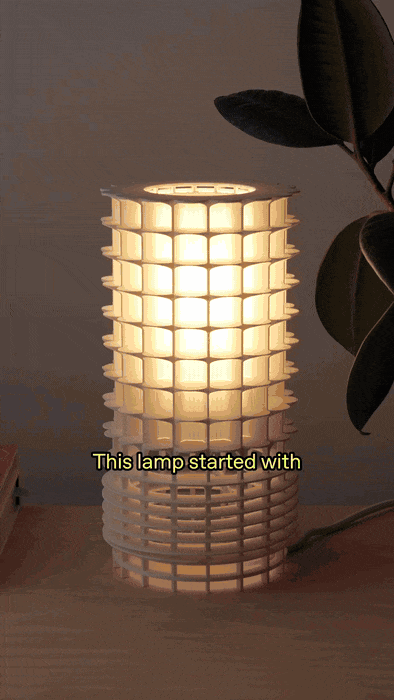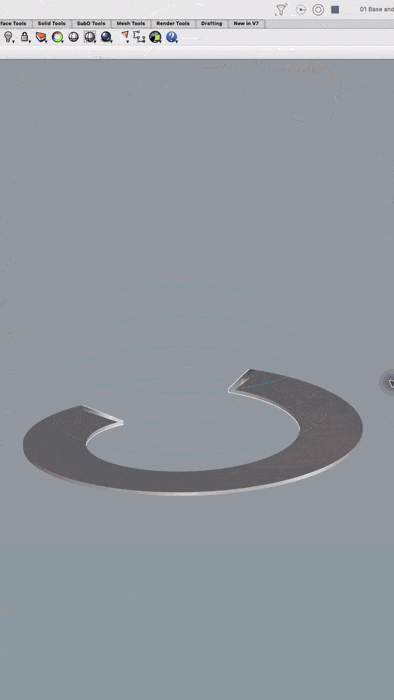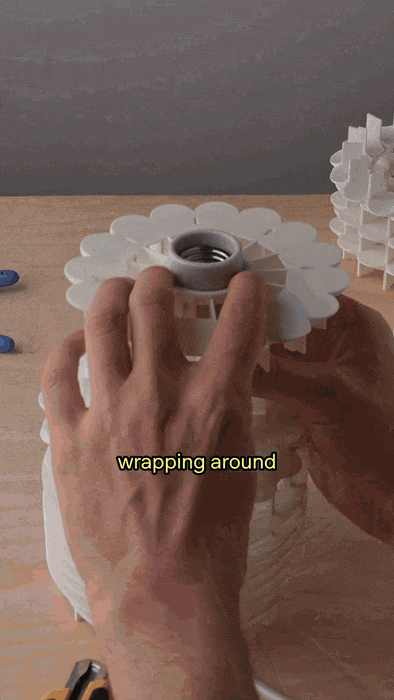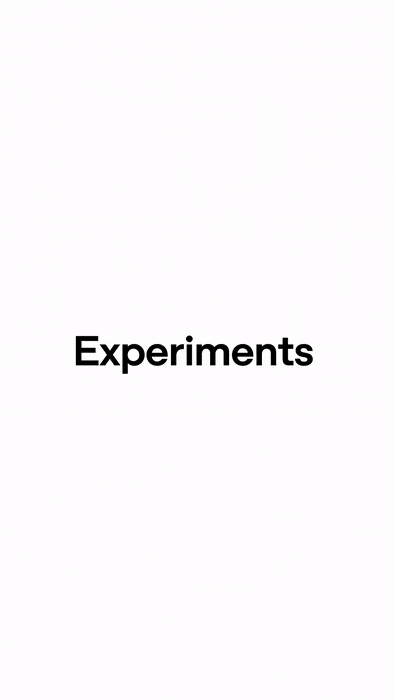
Ein weiterer Test verbindet das CAD-Design mit der tatsächlichen Herstellung. Das Team von OpenAI hat Fotos der fächerförmigen Balkone des Wahrzeichens von Chicago, Marina City, bereitgestellt und das Modell gebeten, sich an seiner Struktur zu orientieren, um ein Design zu erstellen. Nach mehreren Anpassungen hat Astra schließlich eine Papierkunst-Tischlampe hergestellt, die gedruckt, gefaltet und zusammengesetzt werden kann, und eine zugehörige Webseite Lamp Builder erstellt, auf der Benutzer Parameter online anpassen und benutzerdefinierte Zeichnungen generieren können.
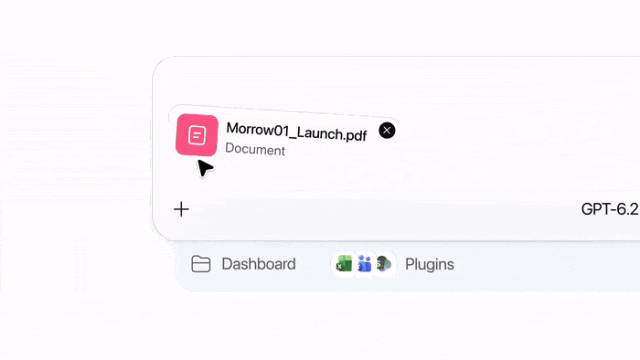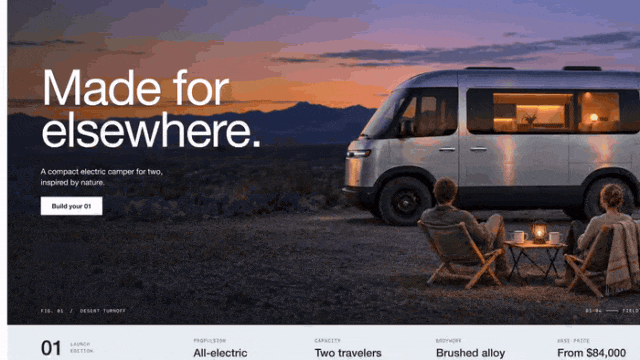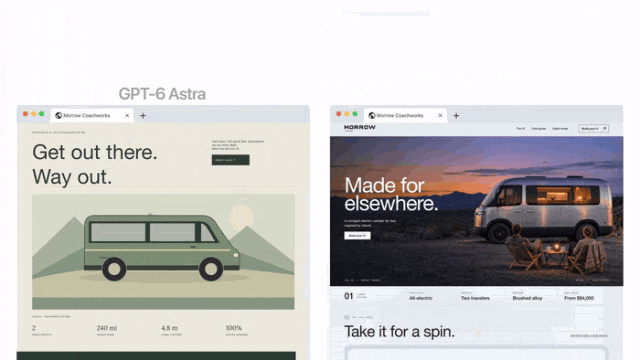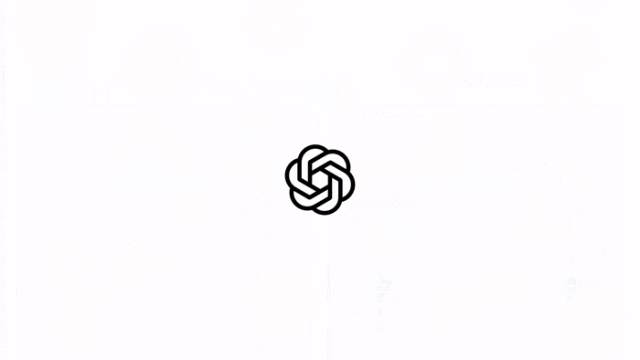
Bei der Webentwicklung hat Astra einen interaktiven Konfigurator für Wohnmobile erstellt. Benutzer können die Karosseriefarbe wechseln und ein Dachzelt hinzufügen, und das Angebot auf der Seite wird gleichzeitig aktualisiert. Es hat auch spielbare Flipperautomaten, ein restauriertes Modell des Kolosseums in Rom und ein zukünftiges Stadt-Rennspiel namens „Meridian Sound Racing“ nach Textbeschreibungen generiert.
Der blinde AA-3D-Menschenbewertungstest von Artificial Analysis hat auch die 3D-Generierungsfähigkeit der Modelle verglichen. GPT-6.2 Astra erhielt 1318 Elo-Punkte und belegte den ersten Platz; Claude Fable 5.2 erhielt 1271 Punkte und GPT-6.2 Sol 1259 Punkte.
Der von GPT-6.2 Astra generierte interaktive Konfigurator für Wohnmobile
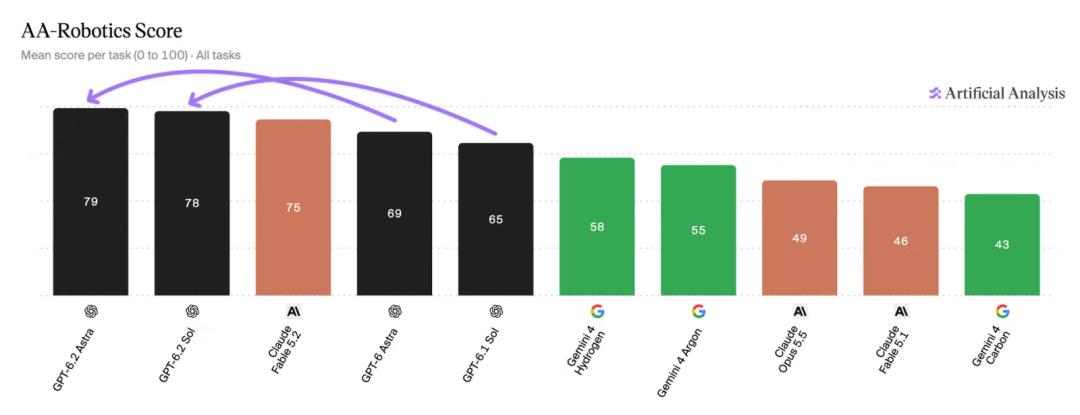
In der Vorschauversion von AA-Robotics v0.1, die die Fähigkeit zum Verständnis der physischen Welt und zur Aktionsplanung testet, erzielten Astra und Sol 79 bzw. 78 Punkte, was höher ist als die 75 Punkte von Claude Fable 5.2. Das Bewertungsteam gab jedoch an, dass die führenden Modelle derzeit die meisten grundlegenden Aufgaben in den ersten Tests erledigen können und schwierigere Fragen hinzugefügt werden.
04. Wissenschaftliches Schlussfolgern und Schwachstellen
Die wissenschaftliche Forschung ist auch der Schwerpunkt, den OpenAI dieses Mal demonstriert hat.
Beim Terminal-Bench-Science 0.1-Test hat GPT-6.2 Astra um 9 Prozentpunkte gegenüber der Vorgängergeneration zugenommen und belegt den ersten Platz. Dieser Test untersucht hauptsächlich die Fähigkeit des Modells, wissenschaftliche Arbeitsabläufe in einer Terminalumgebung zu erledigen. Beim Vals Science Index, der das Modell auffordert, echte biologische Daten zu interpretieren, Experimente zu entwerfen und den Mechanismus des Systems abzuleiten, hat Astra ebenfalls einen neuen Rekord aufgestellt.
Die Ergebnisse mehrerer anderer Tests sind etwas schlechter als die von Claude Fable 5.2. Bei der schwierigen Teilmenge des physikalischen Schlussfolgerungsmaßstabs CritPt v2, der Wissensbewertung AA-Omniscience v1.1 und dem Schlussfolgerungsmaßstab HLE-Diamond belegt Astra jeweils den zweiten Platz.
Ein Problem, das das Modell immer noch hat, ist, dass es falsche Antworten geben kann, wenn es mit unsicheren Fakten konfrontiert wird.
