GPT-6.2Astra und Sol wurden überraschend veröffentlicht. OpenAI zielt gezielt auf den Börsengangstermin von Anthropic ab, wobei die Kosten für die Bearbeitung von Aufgaben lediglich 5 % der Kosten von Claude betragen.
Am selben Tag, an dem Anthropic seinen Börsengang vollzog, präsentierte OpenAI sein „Begrüßungsgeschenk“.
Meldungen vom frühen Morgen des 18. November: OpenAI hat offiziell zwei neue Modelle veröffentlicht, GPT-6.2 Astra und GPT-6.2 Sol: Bei komplexen fachlichen Aufgaben übertrifft die Punktzahl von GPT-6.2 Astra Claude Fable 5.2, während die Kosten pro Aufgabe nur etwa 5 % des Wertes des letzteren betragen.
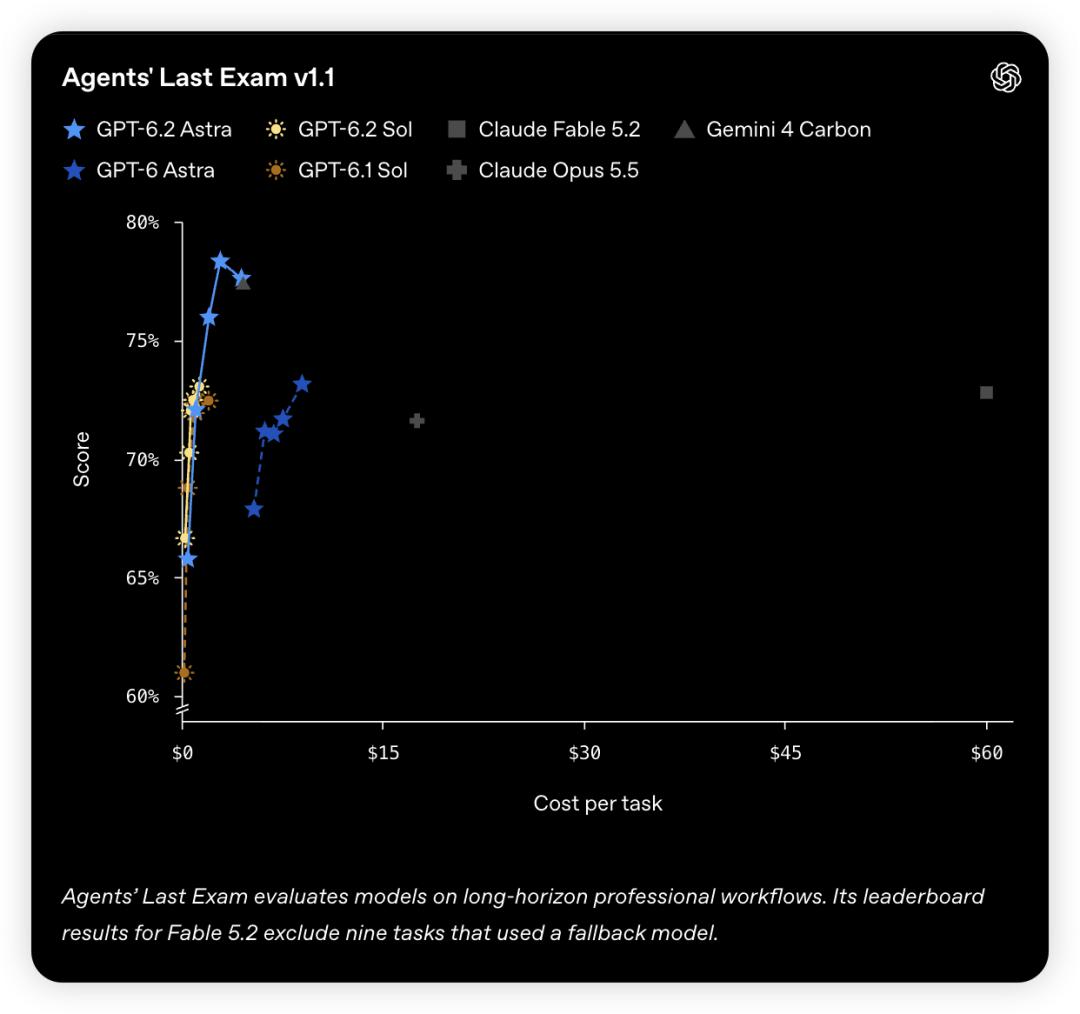
Konkret betrachtet: Im Agents' Last Exam, das lange fachliche Arbeitsabläufe prüft, erreicht GPT-6.2 Astra eine Punktzahl von 78,3 %, was einer Steigerung von 5,2 Prozentpunkten gegenüber dem Vorgängermodell GPT-6 Astra entspricht. Für die Erledigung derselben Bewertungsaufgabe betragen die durchschnittlichen Kosten nur 2,89 USD, während Claude Fable 5.2 auf 60,05 USD kommt. Der Kostenunterschied beträgt mehr als das 20-fache.
Das andere für alltägliche Arbeit ausgelegte Modell GPT-6.2 Sol verdient ebenfalls Aufmerksamkeit. Es behält die API-Preisgestaltung des Vorgängermodells Sol bei, kann aber bei einigen Programmieraufgaben und alltäglichen komplexen Aufgaben das vorherige Flaggschiff Astra einholen oder sogar übertreffen.
In der gleichzeitig von der Behörde veröffentlichten Sicherheitsbewertung ist GPT-6.2 Astra das erste von OpenAI veröffentlichte Modell, das die Risikostufe High bei der Fähigkeit zur Selbstverbesserung von KI erreicht.
Das bedeutet, dass das Modell die Fähigkeit zeigt, die Entwicklung der nächsten KI-Generation deutlich zu beschleunigen.
Astra beginnt, bei der Lieferleistung zu konkurrieren
Im vergangenen Jahr hat sich der Wettbewerb bei großen Modellen schrittweise von der Beantwortung von Fragen zur Ausführung von Aufgaben verlagert. Die Ergebnisse einzelner Inferenzschritte reichen nicht mehr aus, um den tatsächlichen Wert eines Modells zu messen. Unternehmen interessieren sich vielmehr dafür: Kann das Modell eine Aufgabe erledigen, die Dutzende oder sogar Hunderte von Schritten erfordert, und wie viel kostet das?
Die Aktualisierung von GPT-6.2 Astra zielt genau auf diese beiden Probleme ab.
Im Agents' Last Exam liegt seine Punktzahl von 78,3 % um 5,2 Prozentpunkte über der des Vorgängermodells, während die Kosten pro Aufgabe auf weniger als ein Drittel gesunken sind. Im Vergleich zu Claude Fable 5.2 liegt es um 5,5 Prozentpunkte vorne, und die Kosten betragen nur etwa 4,8 %.
Es ist zu beachten, dass dieser Vergleich die durchschnittlichen Kosten der Aufgaben unter der angegebenen Bewertungskonfiguration verwendet und nicht bedeutet, dass in allen realen Geschäftsszenarien 95 % eingespart werden können. Die Behörde hat außerdem vermerkt, dass die Ergebnisse von Claude Fable 5.2 in der Rangliste neun Aufgaben ausschließen, die ein Ersatzmodell verwenden.
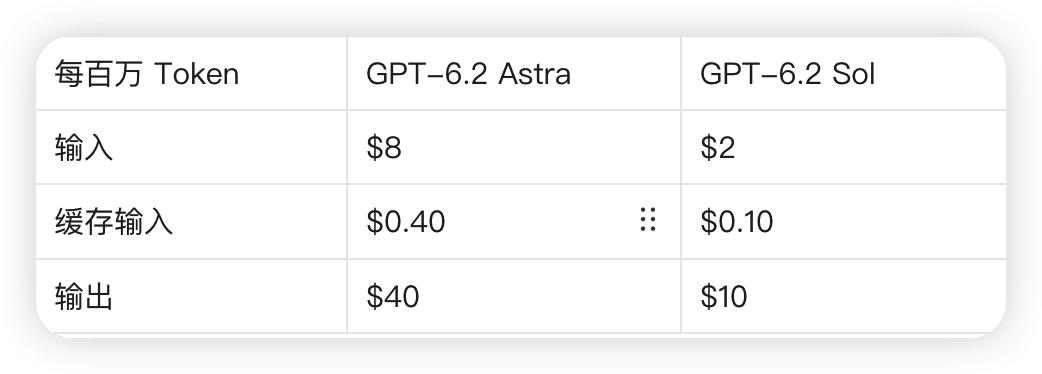
Der Kostensenkungseffekt ergibt sich zunächst aus der Preisanpassung. Sowohl der Preis für API-Eingaben als auch für API-Ausgaben von GPT-6.2 Astra sind um 20 % gesunken, der Preis für Cache-Eingaben um 60 %.
Aber das wirklich Bemerkenswerte ist nicht nur der Stückpreis.
OpenAI betont, dass bei der Ausführung derselben Aufgaben durch das neue Modell auch die Anzahl der zu generierenden Token abnimmt. Das bedeutet, dass es nicht nur günstiger ist, sondern durch eine vernünftigere Aufgabenplanung auch ungültige Inferenzen, Tool-Aufrufe und wiederholte Änderungen reduzieren kann.
Beispielsweise bei der internen Bewertung von OpenAI namens GDPval v2 stieg die Punktzahl von GPT-6.2 Astra von 44,2 % auf 50,4 %, während die ausgegebenen Token gleichzeitig um 22 % abnahmen. Tests des KI-Buchhaltungsunternehmens Basis zeigten zudem, dass die durchschnittliche Ausführungszeit für lange Buchhaltungsaufgaben um 50 % verkürzt wurde, bei den komplexesten Aufgaben sogar um bis zu 73 %.
Dahinter verbirgt sich tatsächlich eine Veränderung der Wirtschaftlichkeit von Agenten: Früher wurden die Kosten hauptsächlich durch die Senkung des Stückpreises von Token gesenkt, jetzt wird durch das Modell die Anzahl der Schritte und der Rechenleistung reduziert, die zur Erledigung einer Aufgabe erforderlich sind. Für unternehmensweite Agenten, die kontinuierlich ausgeführt werden müssen, kann die zweite Fähigkeit von größerem langfristigem Wert sein.
Forschungsaufgaben sind ebenfalls ein zentraler Durchbruchsbereich von Astra bei dieser Aktualisierung.
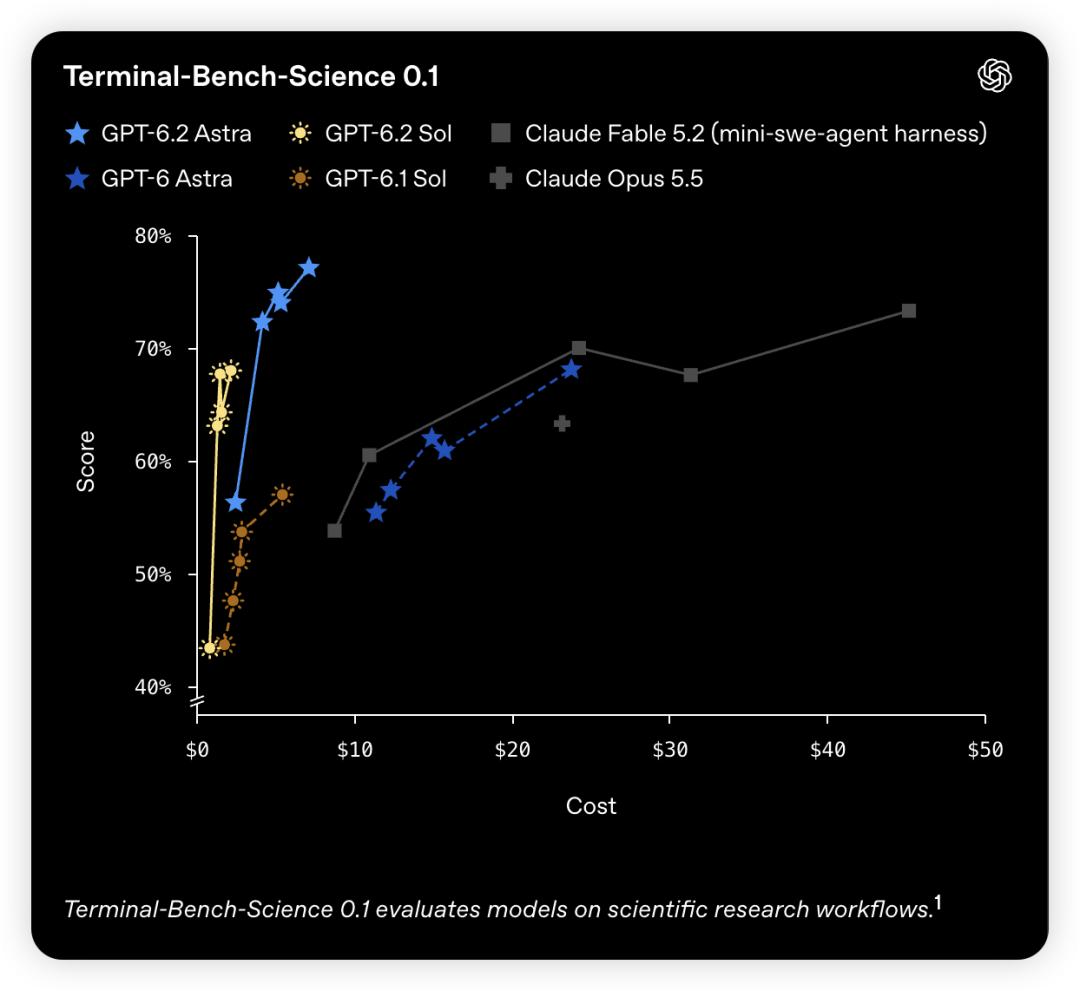
OpenAI bezeichnet es als „das beste Modell für Wissenschaftler“. Bei der Prüfung von terminalen wissenschaftlichen Arbeitsabläufen in Terminal-Bench-Science verbesserte sich GPT-6.2 Astra gegenüber dem Vorgängermodell um 9 Prozentpunkte, während die Kosten für Aufgaben weniger als ein Drittel betrugen.
Im Vals Science Index, der echte biologische Datenanalysen, Simulationsversuche und die Ableitung von Systemmechanismen umfasst, erzielte Astra mit 68,4 % einen neuen Höchstwert. Das bedeutet, dass die Fortschritte des Modells nicht mehr auf die Beantwortung von Fragen zu wissenschaftlichem Wissen beschränkt sind, sondern sich auf praktische Forschungsschritte wie Datenverarbeitung, Versuchsdurchführung und wissenschaftliches Schlussfolgern erstrecken.
Von CAD zum Design physischer Bauteile
Neben den Kosten ist ein weiterer sehr offensichtlicher Fortschritt von GPT-6.2 Astra die Fähigkeit zur Computerbedienung und zum dreidimensionalen Ingenieurdesign.
In einer von OpenAI veröffentlichten Demonstration bat das Team das Modell, die Fahrwerkdynamik eines Sportwagens bei der Fahrt auf Bergstraßen zu visualisieren. Astra generierte nicht nur ein dreidimensionales Automodell, sondern schrieb auch einen Löser in Python, um die komplexen dynamischen Beziehungen zwischen Reifen und Federung zu simulieren, und erstellte abschließend die Animation in Blender.
In einer weiteren Gruppe von Aufgaben rekonstruierte das Modell anhand öffentlicher Fotos und Montageanleitungen jeweils die Bauteile eines ferngesteuerten Benzinautos im Maßstab 1:8 eines echten Fahrzeugs und eines Reihensechszylindermotors und erstellte Montageanimationen sowie illustrierte Teilekataloge.
Es half dem OpenAI-Team außerdem, die fächerförmigen Balkone der beiden Türme von Marina City in Chicago in ein Papierlampendesign umzuwandeln. Der gesamte Prozess umfasst die Analyse von Referenzbildern, mehrere Runden von CAD-Änderungen, das Design von Papierteilen bis hin zur manuellen Montage des physischen Objekts.
Man sieht, dass das Modell nun in ingenieurtechnische Details wie Bauteile, Verbindungsbeziehungen und Bewegungsbeschränkungen eintaucht.
Im BenchCAD 2.1 Core-Bewertungstest stieg die Punktzahl von GPT-6.2 Astra von 62,6 % beim Vorgängermodell auf 82,5 %, was einem Anstieg von fast 20 Prozentpunkten entspricht.
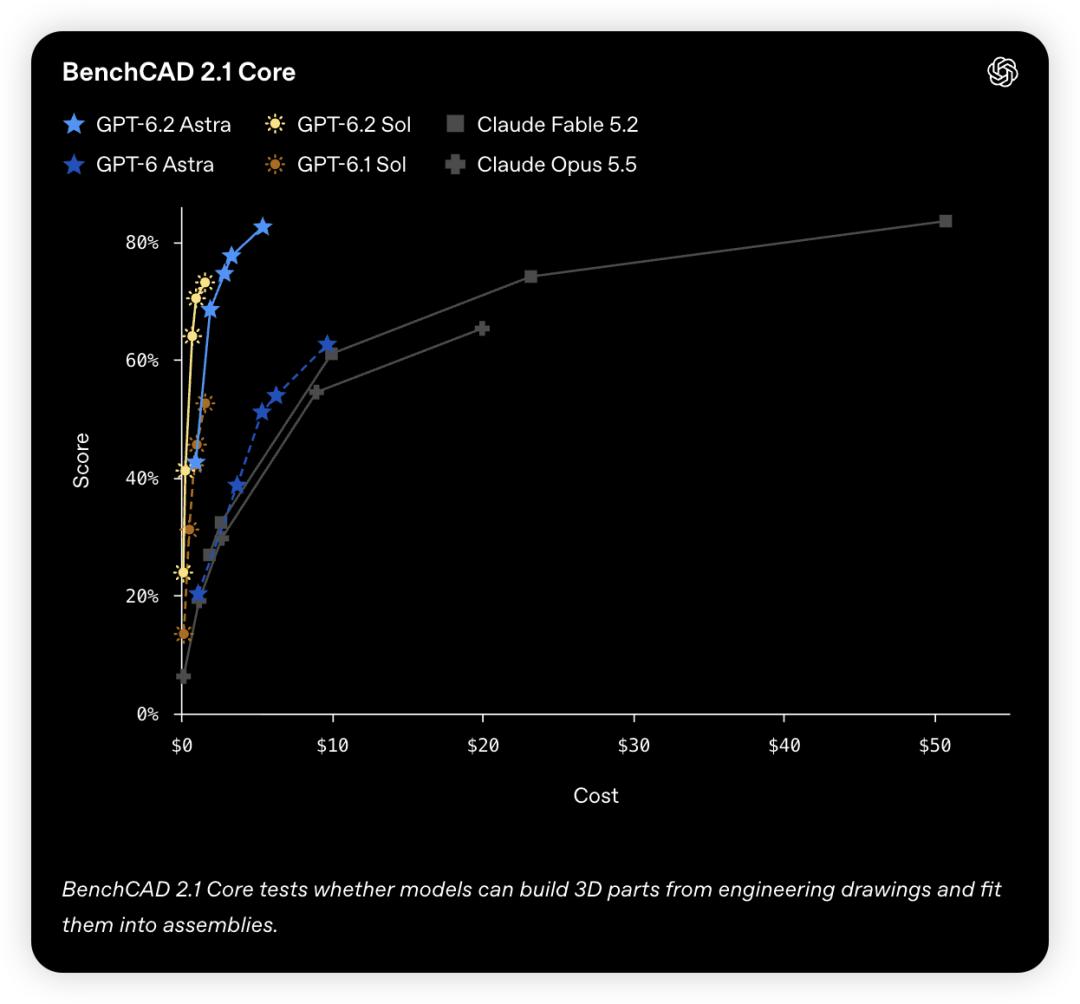
Für Ingenieure bedeutet das, dass das Modell an spezifischeren Vorbereitungsarbeiten für das Design teilnehmen kann, beispielsweise die Prüfung von Montagebeziehungen von Bauteilen, die Beobachtung von Lastübertragungen bei Bewegungen und die unterstützende Überprüfung früher Designentwürfe.
Ähnliche Fähigkeiten erstrecken sich auch auf Browser-Interaktionen und die Generierung von 3D-Webseiten. Im AA-3D-Bewertungstest von Artificial Analysis belegt GPT-6.2 Astra mit 1318 Elo den ersten Platz, vor Claude Fable 5.2 mit 1271 Elo.
Interne Tests des KI-Videounternehmens Higgsfield zeigten zudem, dass Astra bei 73 % der 3D-Generierungsaufgaben das gewünschte Ergebnis beim ersten Mal erreicht, während das Vorgängermodell GPT-6 Astra oft mehr als drei Anpassungsrunden benötigt.
Wenn frühere Modelle darin gut waren, Code und Bilder aus Text zu generieren, versucht GPT-6.2 Astra nun weiterzugehen und die strukturellen Beziehungen zwischen diesen digitalen Assets zu verarbeiten.
Sol behält den gleichen Preis und holt das Vorgänger-Flaggschiff ein
Im Vergleich zu den Fähigkeitsdurchbrüchen von Astra kann die kommerzielle Bedeutung von GPT-6.2 Sol noch direkter sein.
Es verwendet weiterhin die API-Preisgestaltung von GPT-6.1 Sol: 2 USD pro Million Token für Eingaben und 10 USD für Ausgaben, was nur einem Viertel des Preises von Astra entspricht. Bei einigen praktischen Aufgaben schrumpft der Leistungsunterschied zwischen den beiden Modellen aber schnell.
Im FrontierCode 2.0-Programmierbewertungstest von Cognition wurden beide Modelle mit der höchsten Inferenzstufe ausgeführt. GPT-6.2 Sol erreichte 43,8 %, Astra 44,2 %. Der Unterschied beträgt nur 0,4 Prozentpunkte, aber die Kosten für die Aufgaben von Sol betragen etwa ein Fünftel der des letzteren.
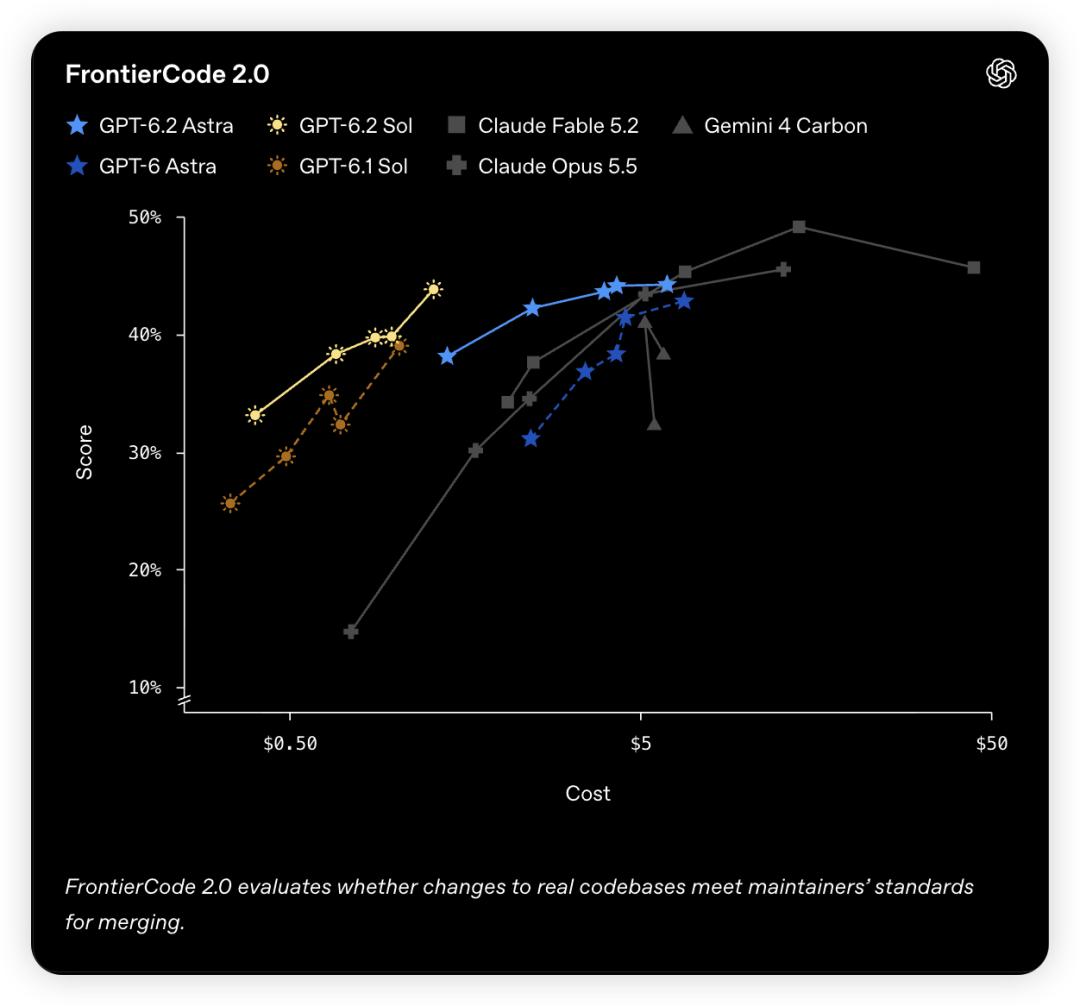
Diese Bewertung prüft nicht nur, ob der Code lauffähig ist, sondern verlangt vom Modell, Änderungen in echten Codebasen durchzuführen und Qualitätsstandards zu erreichen, die die Wartenden bereit sind zu übernehmen.
Noch interessanter sind alltägliche komplexe Aufgaben.
Im von OpenAI eingeführten LifeVal-Bewertungstest erzielte GPT-6.2 Sol 83,8 %, womit es das Vorgänger-Flaggschiff GPT-6 Astra mit 79,8 % übertrifft, und die Kosten für die Aufgaben betragen etwa ein Siebtel der des letzteren.
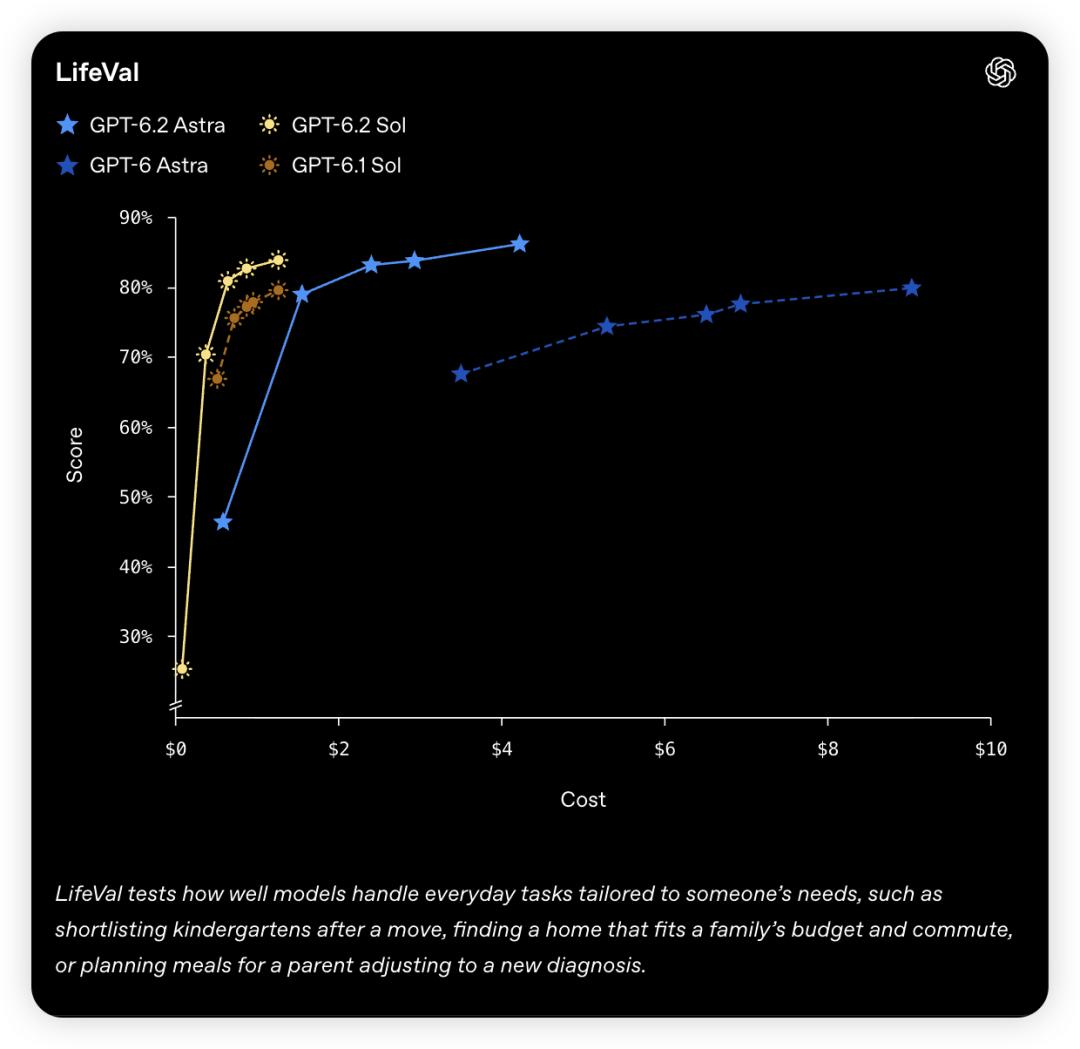
LifeVal umfasst Aufgaben wie die Auswahl von Kindergärten nach einem Umzug, die Suche nach Wohnungen unter Berücksichtigung von Pendelweg und Budget sowie die Erstellung von Rezepten für Familienmitglieder mit besonderen Ernährungsbedürfnissen. Sie scheinen nicht so komplex wie wissenschaftliche Forschung oder Programmierung zu sein, erfordern aber vom Modell, zwischen mehreren realen Bedingungen abzuwägen.
OpenAI gibt bekannt, dass intern bereits viele Mitarbeiter Sol als Standardmodell für die Bearbeitung technischer und nicht technischer Arbeiten verwenden.
Das könnte auf eine neue Aufgabenteilung bei Modellen hindeuten.
Astra übernimmt schwierige Aufgaben wie wissenschaftliche Forschung, komplexes Ingenieurdesign und fachliche Wissensarbeit; Sol übernimmt die größere Anzahl alltäglicher Agentenaufgaben mit höherer Kostenempfindlichkeit.
Wenn Mittelklasse-Modelle bei immer mehr Aufgaben das Vorgänger-Flaggschiff einholen, müssen Entwickler nicht mehr nur überlegen, welches Modell sie verwenden, sondern für welche Aufgaben sich der Aufpreis für das Top-Modell lohnt.
PPT-Lieferung nach Branchenstandards
Früher war es nicht ungewöhnlich, dass KI Folien, Tabellen und Dokumente generiert, aber viele Ergebnisse blieben auf dem Stand „sieht aus als wäre es fertig“. Diesmal hat OpenAI speziell das Verständnis von GPT-6.2 Astra für professionelle Lieferstandards verstärkt.
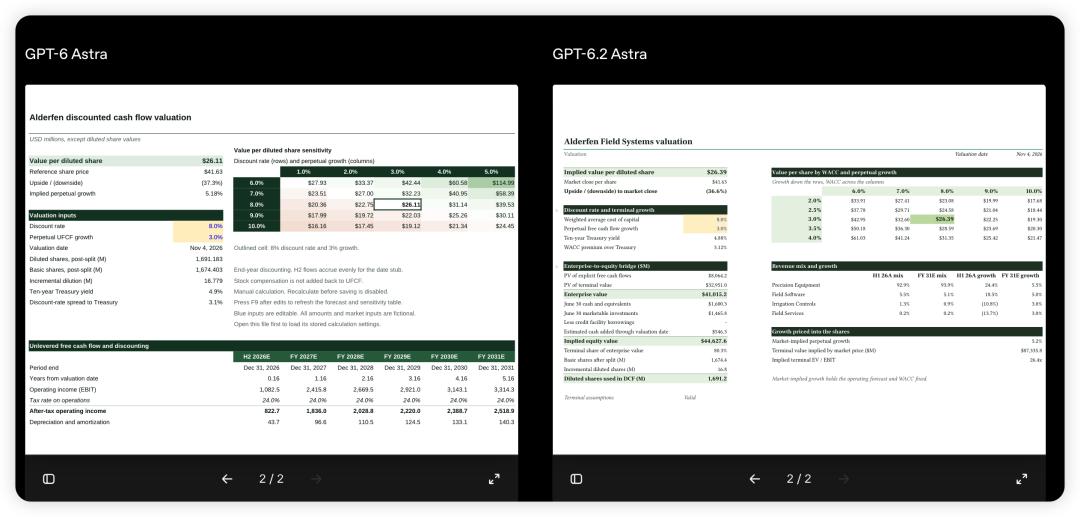
Beispielsweise ließ OpenAI bei Finanzmodellierungsaufgaben zwei Generationen von Modellen den Arbeitsmappen für die Discounted-Cashflow-Bewertung (DCF) eines Unternehmens erstellen. GPT-6 Astra erstellte detaillierte Tabellen mit Finanzprognosen, Bewertungsparametern und Sensitivitätsanalysen; GPT-6.2 Astra hingegen organisierte die Bewertungsergebnisse neu, stellte die Berechnungsverfahren für den Wert pro Aktie, Unternehmenswert und Eigenkapitalwert, wichtige Annahmen und Sensitivitätsanalysen zusammen dar und ergänzte Angaben zur Umsatzstruktur und zum Wachstum, damit Analysten die Bewertungsschlussfolgerungen schnell verstehen können.
Bei der in Investmentbanken üblichen Analyse vergleichbarer Transaktionen mussten die beiden Modellgenerationen außerdem mehrere M&A-Transaktionen in der Softwarebranche zu einer einseitigen Präsentation zusammenfassen. Das Vorgängerm