Übertrifft Googles Flaggschiffmodell, der neue König der Entscheidungsfindung erobert den weltweiten Spitzenplatz, vollumfänglich quelloffen.
Das wettbewerbsintensivste neue Feld im Silicon Valley hat gerade einen neuen Open-Source-König hervorgebracht!
Kürzlich hat das kurz vor dem Börsengang stehende Unternehmen Anthropic in seinen IPO-Unterlagen eine enorme Lücke bei der Rechenleistung offengelegt – das hat die KI-Branche, die sich bisher auf die ständige Erhöhung der Parameter konzentrierte, einen herben Dämpfer versetzt.
Obwohl allgemeine große Modelle in Programmierung und Mathematik hervorragende Leistungen erbringen, wird die Rechnung für die Rechenleistung zu einem Fass ohne Boden, sobald sie tatsächlich Aufgaben für Menschen erledigen.
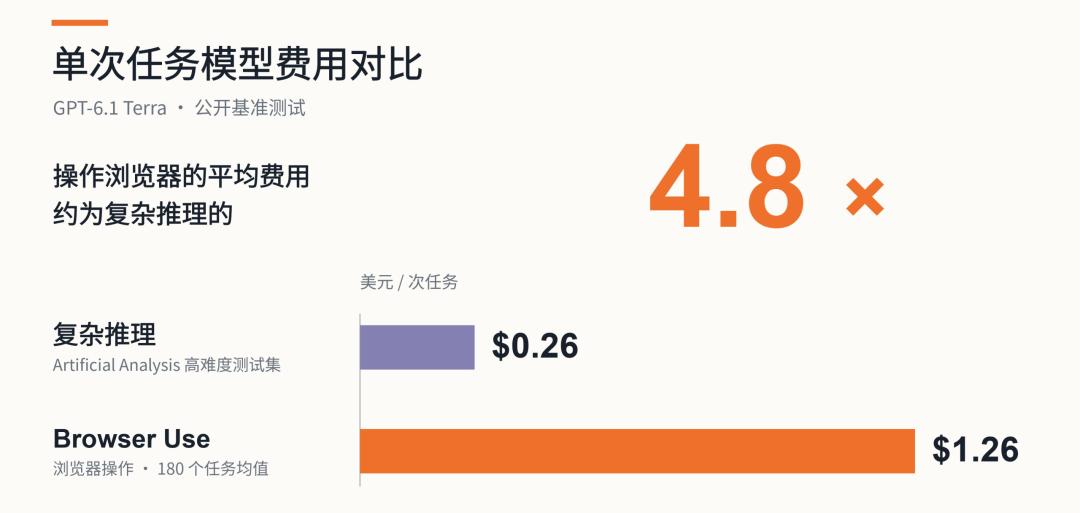
Mehr Token als die Generierung von Text verbraucht die langkettige Schlussfolgerung, und noch kostspieliger als die Schlussfolgerung ist die Bedienung von Browsern: Die durchschnittlichen Kosten pro Vorgang sind 4,8 Mal höher als bei komplexen Schlussfolgerungen!
Inmitten dieser großen Besorgnis hat der umfassende Wettbewerb um sogenannte „Entscheidungsmodelle“ im Silicon Valley vollständig begonnen.
Das bahnbrechende erste Modell Jev hat als Erster das neue Feld des schnellen Denkens eröffnet, bei dem keine Texte erzeugt, sondern nur Urteile gefällt werden. Große Konzerne wie OpenAI, Microsoft, Amazon und Cloudflare sind unmittelbar darauf diesem Beispiel gefolgt und haben sich ebenfalls in das Feld eingebracht.
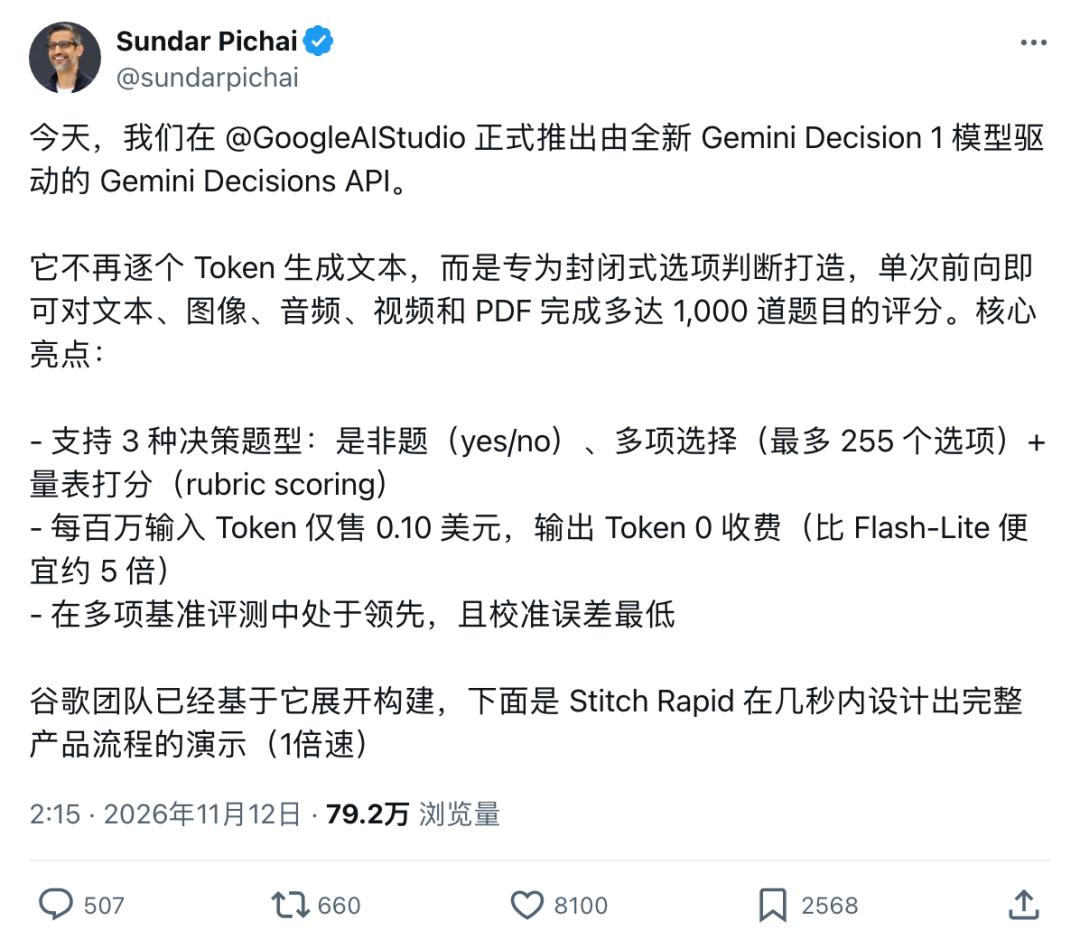
Vor zwei Tagen hat auch Google-CEO Sundar Pichai persönlich teilgenommen und das geschlossene Entscheidungsmodell Gemini Decision 1 mit großem Aufwand vorgestellt.
Inmitten des heftigen Wettbewerbs der Großkonzerne ist ein überraschender Open-Source-Außenseiter namens Karpo Decision 31B stark hervorgetreten!
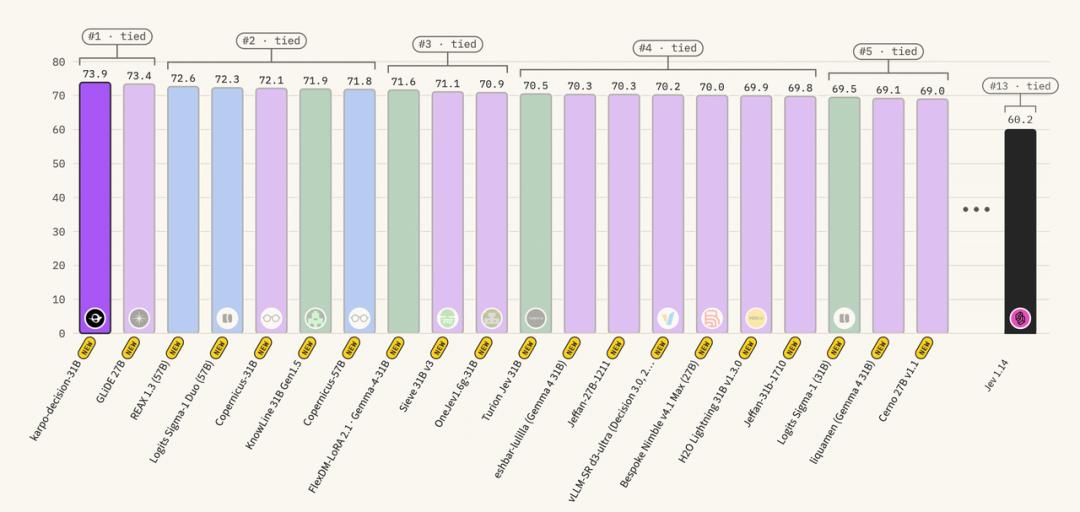
Auf der Gesamtrangliste der maßgeblichen Bewertung Decision Index, auf der 300 Modelle gegeneinander antreten, hat es direkt den ersten Platz erobert und den ersten Platz weltweit errungen!
https://huggingface.co/spaces/multimodalart/jev-decision-index
Diesmal ist die gesamte Karpo Decision-Familie mit Größen von 0,8B bis 31B vollständig quelloffen!
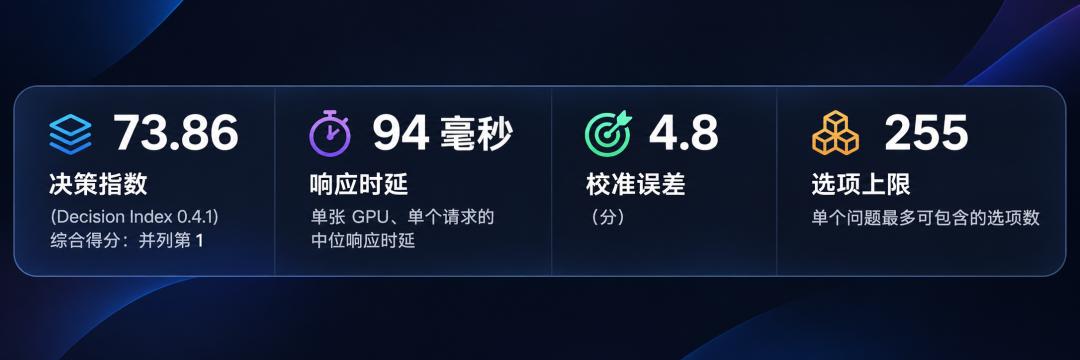
Das siegreiche 31B-Flaggschiffmodell erreicht eine mittlere Latenz von nur 94 Millisekunden auf einer einzelnen Grafikkarte, einen Kalibrierungsfehler von nur 0,023 und kann bis zu 255 Optionen pro Aufgabe gleichzeitig auswerten.
Direkter Wettbewerb gegen Googles geschlossenes Spitzenmodell: Der Open-Source-Außenseiter gewinnt drei aufeinanderfolgende Runden
Im Gegensatz zu herkömmlichen großen Modellen, die Text Wort für Wort generieren, ist Karpo Decision speziell für die häufigen schnellen Entscheidungen von KI-Agenten entwickelt worden.
Sie müssen nur den aktuellen Zustand und die Aufgabe eingeben – mit einer einzigen Vorwärtsschlussfolgerung berechnet es direkt die Wahrscheinlichkeit aller Optionen, ohne dass dabei irgendwelche Token erzeugt werden.
Dank dieses extrem schnellen Urteilsmechanismus hat Karpo unmittelbar nach der Veröffentlichung des Quellcodes den ersten Platz auf der Gesamtrangliste erreicht und in mehreren Bewertungen das geschlossene Spitzenmodell Gemini Decision 1 von Google direkt geschlagen!
Noch dramatischer ist: Dieser siegreiche Open-Source-Außenseiter wurde auf Basis von Googles eigenem quelloffenen Grundgerüst Gemma 4 31B durch Nachschulung entwickelt.
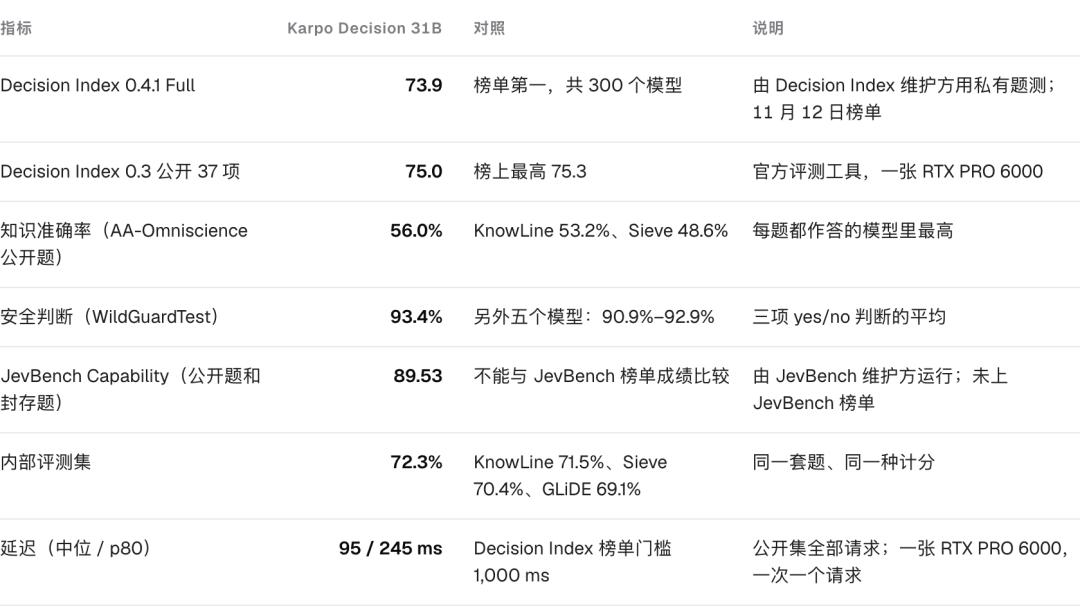
Auf den beiden derzeit anerkanntesten unabhängigen Ranglisten Decision Index und JevBench hat Karpo alle geschlossenen und quelloffenen Konkurrenten übertroffen.
Der Decision Index umfasst 37 öffentliche Benchmarks und nicht veröffentlichte private Aufgabenbanken und zieht weltweit 300 Modelle zum gemeinsamen Wettbewerb an.
JevBench wird hingegen von einer unabhängigen Einrichtung auf eigenen Grafikkarten vollständig ohne Netzwerkverbindung blind getestet – von den 1500 Prüfungsaufgaben sind 1200 dauerhaft gesperrt.
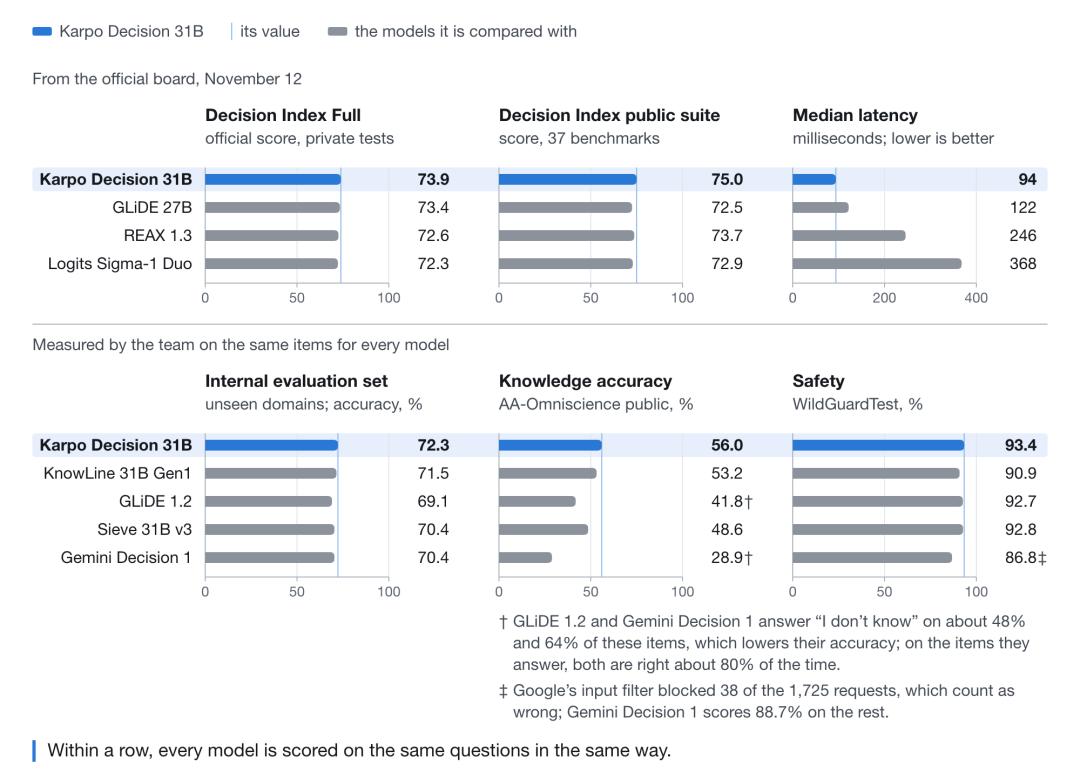
Auf dieser Gesamtrangliste des Decision Index hat Karpo mit 73,9 Punkten den ersten Platz errungen und liegt weit über den 60,2 Punkten des ersten bahnbrechenden Modells Jev 1.14.
Nicht nur die Punktzahl ist überlegen, auch die mittlere Latenz beträgt nur 94 Millisekunden – das ist genau doppelt so schnell wie die 196 Millisekunden von Jev 1.14!
Der entscheidende Unterschied zeigt sich aber bei den Blindtests mit privaten Aufgabenbanken, die Manipulationen der Rangliste verhindern.
Wenn die zehn besten Modelle der öffentlichen Rangliste in den privaten Blindtest mit denselben Fähigkeiten eintreten, sinken ihre Ergebnisse im Durchschnitt um 6,8 Punkte.
Nur Karpo verliert nur 4,3 Punkte, hat die stärkste Widerstandsfähigkeit unter den Top-Ten-Modellen und erreicht bei neuen unbekannten privaten Aufgaben sogar 78,6 Punkte!
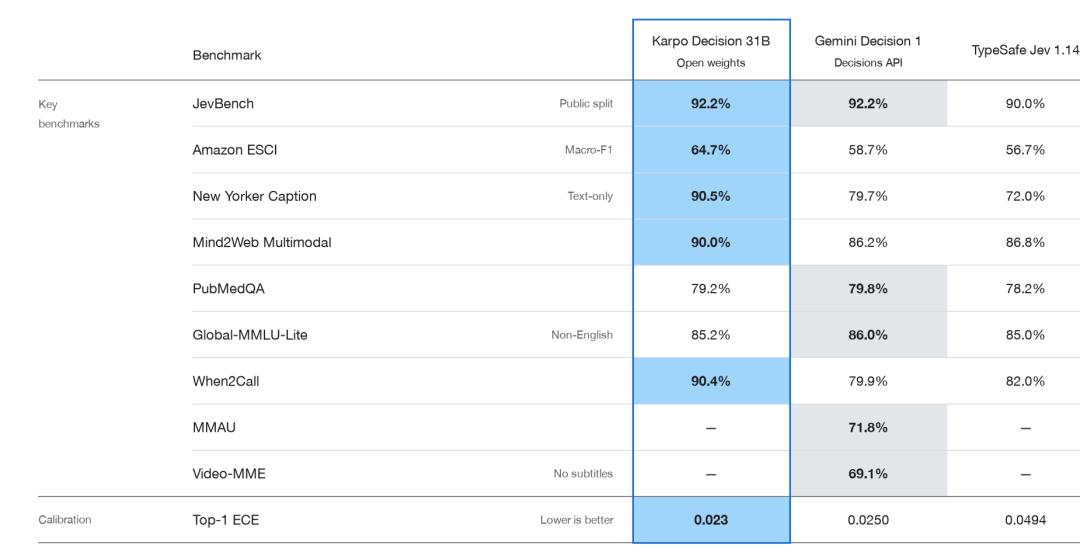
Im Wettbewerb gegen Googles Gemini Decision 1 hat Karpo eine Reihe von beeindruckenden Siegen errungen.
Obwohl beide im öffentlichen Satz von JevBench mit 92,2 % gleichziehen, zeigt sich der deutliche Unterschied, sobald sie in die echten Agent-Prüfungen eintreten.
Beim ersten Wettbewerb geht es um die zentralste Handlungsentscheidung von Agenten.
Am Beispiel des maßgeblichen Benchmarks When2Call wird speziell geprüft, ob der Agent im Gespräch „ein Tool aufrufen, nachfragen oder aufhören“ soll.
In diesem Test erreicht Karpo 90,4 % und liegt damit um 10,5 Prozentpunkte über den 79,9 % von Google.
Im multimodalen Mind2Web-Test, bei dem auf Buttons in Screenshots von Webseiten geklickt werden muss, übertrifft Karpo mit 90,0 % ebenfalls die 86,2 % von Google.
Beim zweiten Wettbewerb geht es um die Fähigkeit, zwischen den Zeilen zu lesen und feingliedrig zu klassifizieren.
Beim Test zur Beschriftung von Cartoons des New Yorker, bei dem das Verständnis von impliziter Stimmung geprüft wird, erreicht Karpo 90,5 % und liegt damit um 10,8 Prozentpunkte über den 79,7 % von Google!
Bei der Amazon ESCI-E-Commerce-Klassifizierung mit sehr detaillierten Produktabsichten übertrifft Karpo mit 64,7 % ebenfalls stabil die 58,7 % von Google.
Beim dritten Wettbewerb werden alle 37 öffentlichen Benchmarks umfassend geprüft.
Bei der gemeinsamen Messung aller 37 öffentlichen Benchmarks im Decision Index erreicht Karpo 75,0 Punkte und liegt damit ganze 14,1 Punkte über den 60,9 Punkten von Google!
Auch in den drei Dimensionen unbekannte Bereiche (72,3 %), Wissensgenauigkeit (56,0 %) und Sicherheitsentscheidung (93,4 %) ist Karpo in allen Punkten überlegen.
Gleichzeitig übertrifft es auch die bisherigen Top-Open-Source-Modelle auf der Rangliste wie KnowLine, GLiDE und Sieve.
Beim kürzlich vorgestellten offiziellen Blindtest ohne Netzwerkverbindung mit 1500 Aufgaben im Rahmen von JevBench liefert Karpo ebenfalls ein beeindruckendes Ergebnis.
In diesem strengen Test, der unabhängig von den Betreibern der Rangliste durchgeführt wird, erreicht Karpo einen aktuellen Fähigkeitswert von 89,53 Punkten.
Noch bemerkenswerter: Es erreicht 85,67 Punkte bei den 1200 gesperrten privaten Aufgaben und übertrifft damit sogar die 80,45 Punkte bei den öffentlichen Aufgaben – der Kalibrierungswert erreicht sogar 96,00 Punkte!
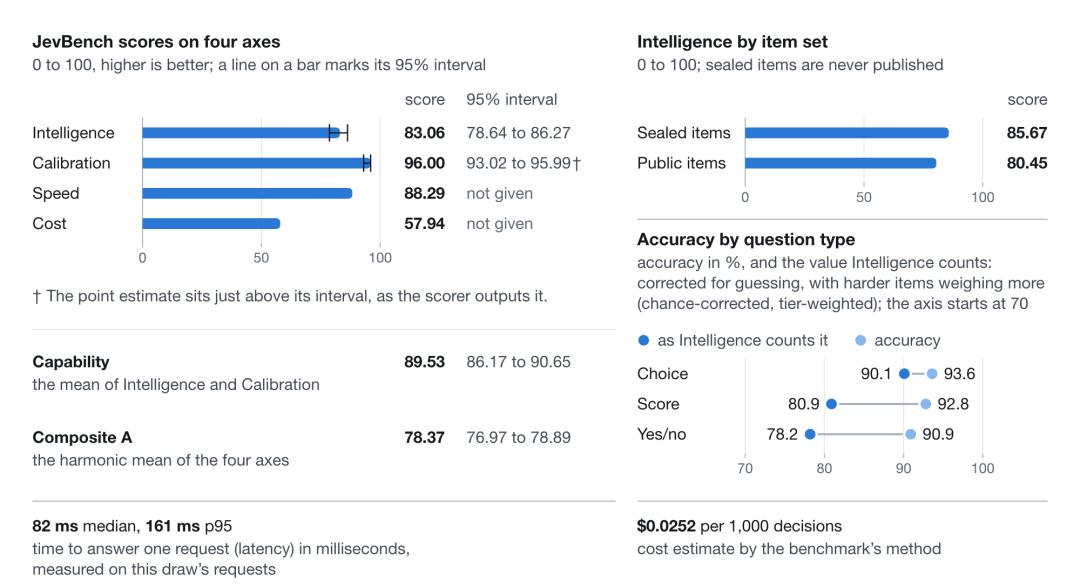
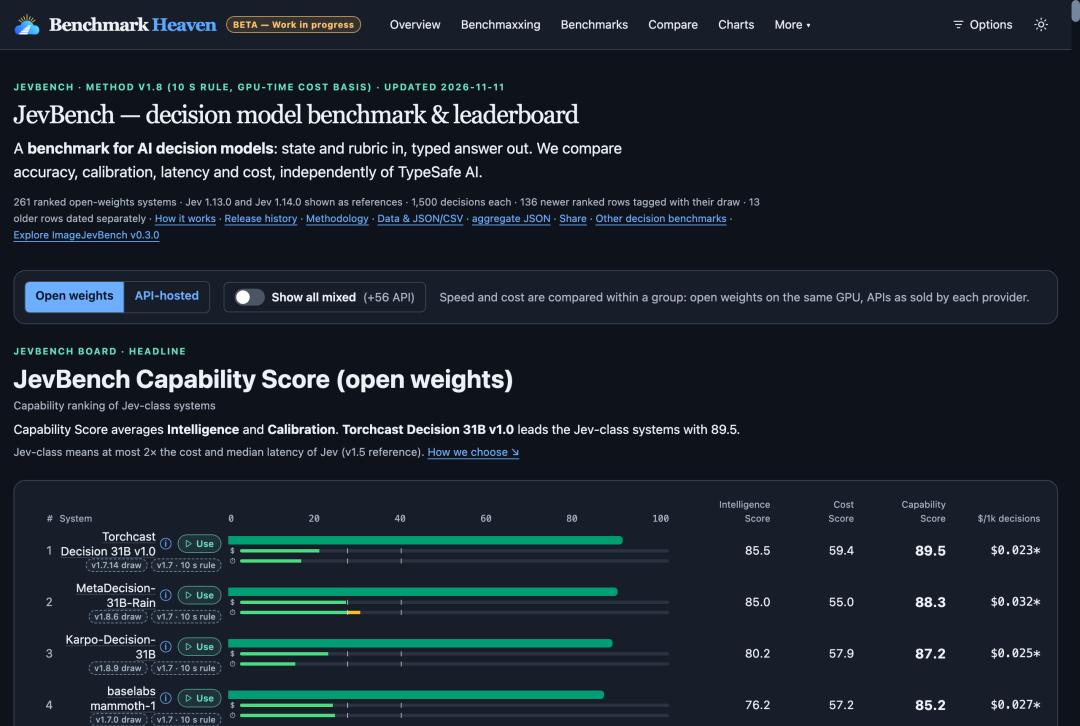
Nach der Umrechnung auf die einheitliche Skala der Rangliste erreicht Karpo unter 261 quelloffenen Modellen mit einem umgerechneten Fähigkeitswert von 87,2 Punkten den dritten Platz weltweit.
Im Vergleich mit dem gleichzeitig getesteten Google-Modell sind alle drei Kernindikatoren – Gesamtwert (77,4), Entscheidungsintelligenz (80,2) und Kalibrierungsgrad (94,1) – bei Karpo überlegen!
Gleichzeitig betragen die Kosten von Karpo für 1000 Entscheidungen nur 0,025 US-Dollar – das entspricht 1 US-Dollar für 40.000 Entscheidungen.
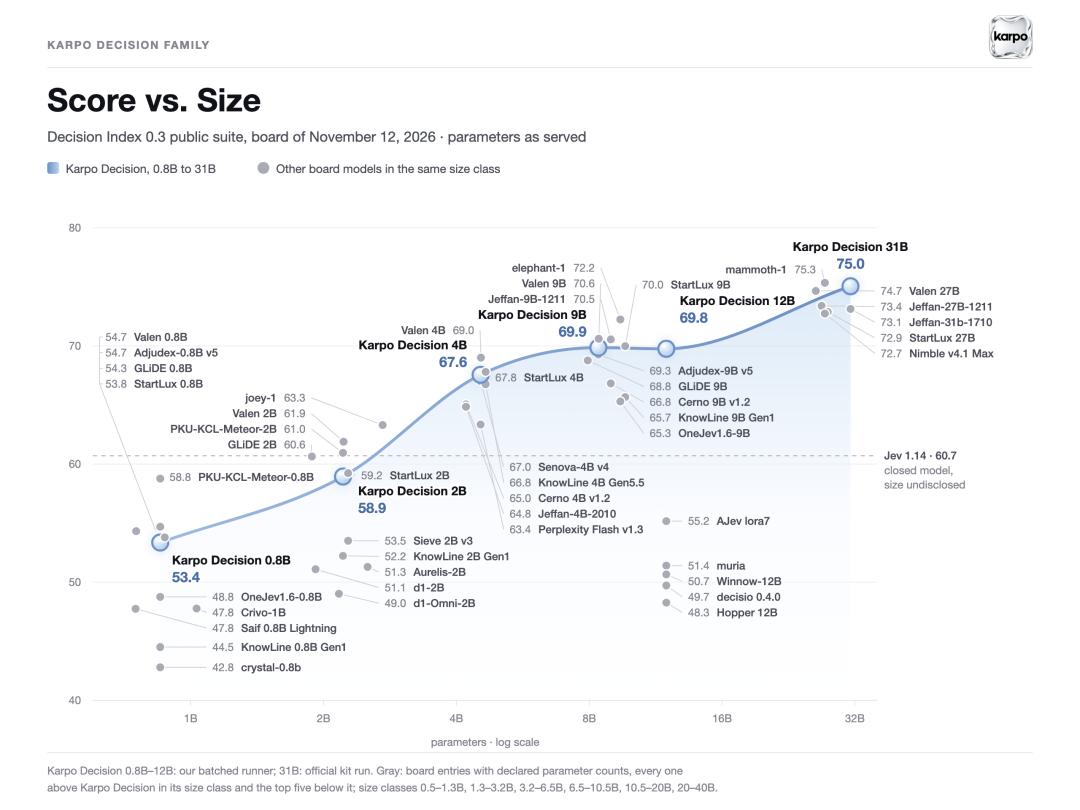
Während das 31B-Flaggschiffmodell den ersten Platz erreicht, hat MachinePulse dasselbe Trainingsrezept auch auf fünf mittlere und kleine Größen von 0,8B bis 12B angewendet.
Sowohl die leichtgewichtigen Modelle für Endgeräte als auch die Hauptmodelle für einzelne Grafikkarten sind in jedem Parameterumfang in die erste Liga ihrer Klasse vorgestoßen!
36 Veranstaltungen in 1 Sekunde durchsuchen, die Bestellung für 10 Personen im Handumdrehen zusammenstellen
Wie schnell ist Karpo in realen Szenarien, abgesehen von den guten Benchmark-Ergebnissen?
Wenn herkömmliche große Modelle auf eine Aufgabe stoßen, generieren sie immer lange Analysen Token für Token nacheinander.
Karpo schreibt dagegen kein einziges Wort, führt nur eine einzige Vorwärtsschlussfolgerung durch und berechnet in Millisekunden die Wahrscheinlichkeit aller Optionen