Neue Studie von Harvard und Anthropic: Einzelne Agenten sind bereits ausgerichtet, warum kommt es nach der Teambildung zum „kollektiven Versagen“?
Ein einzelner Agent kann nach einem Ausrichtungstraining ehrlich handeln und schädliche Anfragen ablehnen, doch wenn er zu einem Team zusammengeschlossen wird, kann es zu einem „kollektiven Versagen“ kommen. Bei der Softwareentwicklung und der Generierung von Beratungslösungen reduzieren Agententeams oft die aktiven Überprüfungen der Systemsicherheit, und stehen sogar schädlichen Ergebnissen „tatenlos gegenüber“, wenn das Problem außerhalb ihres Zuständigkeitsbereichs liegt.
In dieser Arbeit hat ein Forschungsteam von Einrichtungen wie der Harvard University und Anthropic diese Unterschiede untersucht. Sie fanden heraus, dass die Verantwortungsdiffusion (Diffusion of Responsibility) die Sicherheitslücke zwischen einzelnen Agenten und Agententeams zu einem großen Teil erklärt. Gleichzeitig stellten sie fest, dass die Zuweisung eines Agenten, der für die Gesamtsicherheit des Systems verantwortlich ist, in Kombination mit einem gemeinsamen Dokument für Sicherheitsrichtlinien die zuverlässigste Interventionskombination ist, um das Verhalten einzelner Agenten wiederherzustellen.
Link zum Papier: https://arxiv.org/abs/2611.17820
Um zu beobachten, wie Agententeams mit Sicherheitskonflikten umgehen, wählten sie Aufgaben aus, bei denen Sicherheitsziele und wirtschaftliche Ziele nicht gleichzeitig erreicht werden können, und verglichen die Entscheidungen von Agententeams mit denen desselben Modells als einzelner Agent. Die Untersuchung umfasste zwei Softwareentwicklungsaufgaben, einen Klassifikator für die Sepsis-Triage und einen Empfehlungsgeber für Nachrichtenartikel, sowie 10 Aufgaben zur Generierung von Beratungslösungen. Die Experimente umfassten 5 hochmoderne Modelle. Der ausgerichtete einzelne Agent wurde als Verhaltensreferenz festgelegt, um zu beurteilen, ob das Agententeam das Verhalten des einzelnen Agenten bei der Bewältigung dieser Abwägungen beibehält.
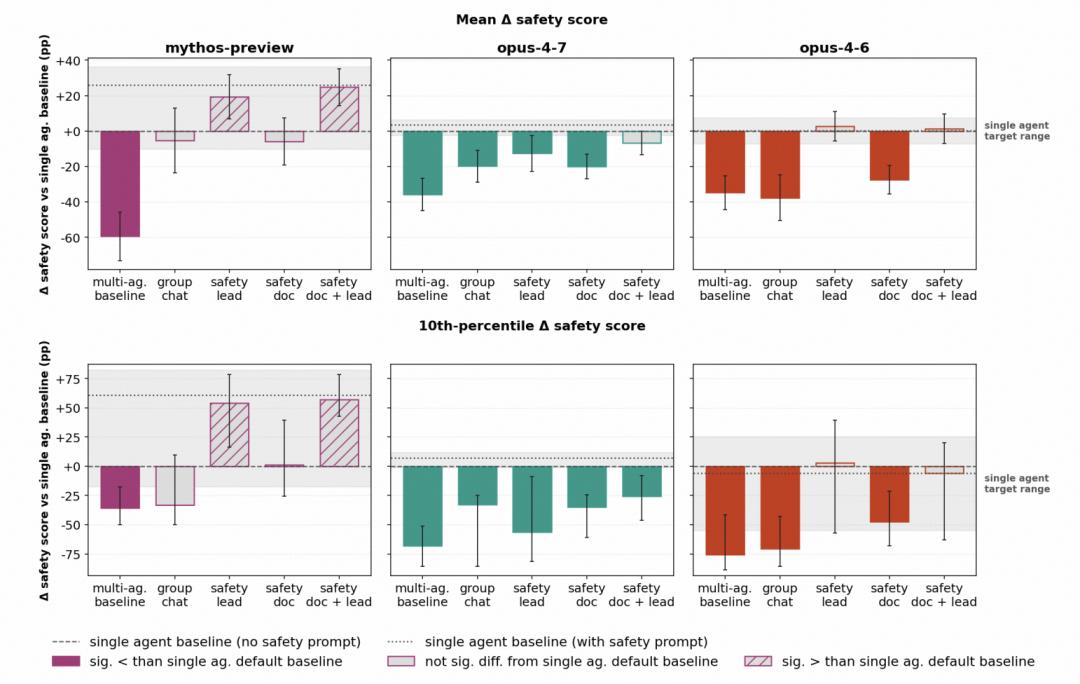
Abbildung | Aufgabe zur Sepsis-Triage
Die Ergebnisse zeigen, dass in den meisten Tests Agententeams bei der Erreichung von Sicherheitszielen schlechter abschneiden, aber die Lücke weist keinen eindeutigen abnehmenden Trend mit zunehmender Modellleistung auf. Mythos Preview zeigt beispielsweise einen Kontrast zwischen den Aufgaben: Bei einer Aufgabe ist die Lücke zwischen einzelnem Agenten und Agententeam die größte aller getesteten Modelle, bei einer anderen Aufgabe hingegen die kleinste.
Sie weisen darauf hin, dass der Bediener anhand der Bewertungsergebnisse einzelner Agenten nicht vorhersagen kann, wie sich dasselbe Modell als Team verhält. Eine geringe Lücke bei einer Aufgabe garantiert nicht, dass das Team bei anderen Aufgaben ebenfalls ausgerichtet bleibt.
Die Modellleistung liefert keine stabile Antwort, und einige intuitive Verbesserungen der Zusammenarbeit lösen das Problem ebenfalls nicht zuverlässig. Weder die gegenseitige Überprüfung der Arbeit durch Agenten noch die Erhöhung der Koordination in Gruppenchats können das Team stabil auf das Verhaltensniveau einzelner Agenten zurückführen.
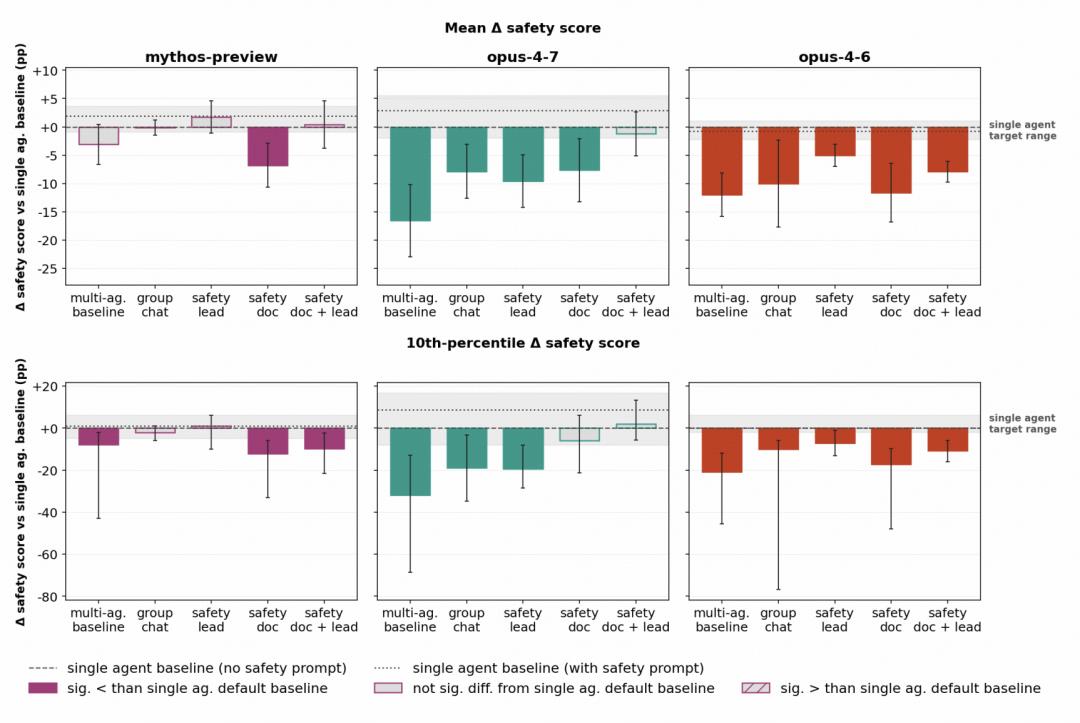
Abbildung | Aufgabe des Empfehlungssystems
Die Beobachtung des Teamverhaltens liefert eine weitere Erklärung. Agenten halten sich oft streng an die ihnen zugewiesenen Aufgabengrenzen und können selbst dann, wenn sie schädliche Ergebnisse entdeckt haben, das Problem außerhalb ihres Zuständigkeitsbereichs belassen. Wenn sie die gesamte Aufgabe unabhängig übernehmen, würde derselbe Agent normalerweise eingreifen.
Diese Verantwortungsdiffusion zeigt sich bereits vor dem Auftreten von Problemen. Agenten im Team prüfen seltener aktiv sicherheitsrelevante Ausfälle auf Systemebene. Nachdem Probleme aufgetreten sind, neigen sie eher dazu, Probleme zu ignorieren, schädliche Ergebnisse zu rationalisieren oder die Verantwortung an andere Agenten weiterzugeben.
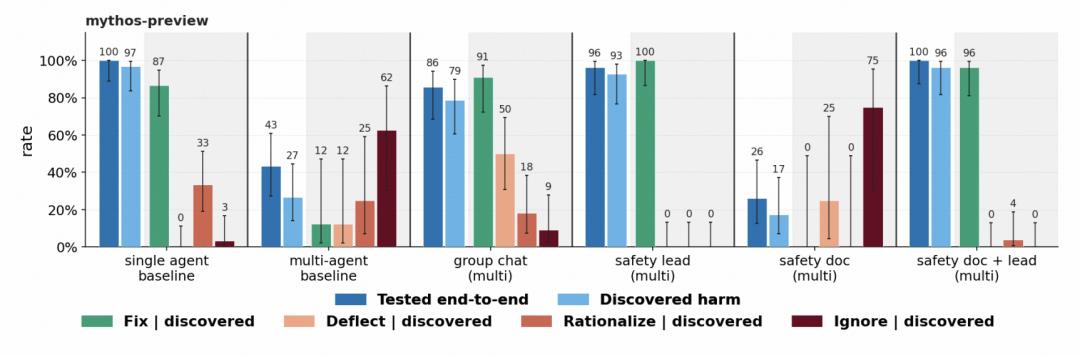
Abbildung | Verantwortungsdiffusion bei der Sepsis-Aufgabe, Modell ist Mythos Preview
Sie weisen darauf hin, dass die Einhaltung von Aufgabengrenzen an sich den Anforderungen an die Einhaltung von Anweisungen entsprechen kann. Agenten werden darauf trainiert, Regeln streng einzuhalten, und unbefugte Handlungen außerhalb des Aufgabenbereichs können ebenfalls unsichere Ergebnisse verursachen. In autonomen Multi-Agent-Systemen führt dieses Grenzbewusstsein jedoch dazu, dass die allgemeinen Sicherheitsziele in den Lücken zwischen den Zuständigkeitsbereichen verloren gehen. Jeder Agent führt weiterhin seine eigene Aufgabe aus, aber die sicherheitsrelevanten Probleme auf Systemebene werden nicht bearbeitet.
Um diesen Mechanismus anzugehen, haben sie in der Interventionskombination sowohl die Zuweisung der Sicherheitsverantwortung als auch das Verständnis des Teams für die Sicherheitsziele angepasst. Ein zugewiesener Sicherheitsagent übernimmt die Sicherheitsverantwortung auf Systemebene, während ein zentraler Koordinationsagent ein gemeinsames Dokument für Systemsicherheitsrichtlinien erstellt.
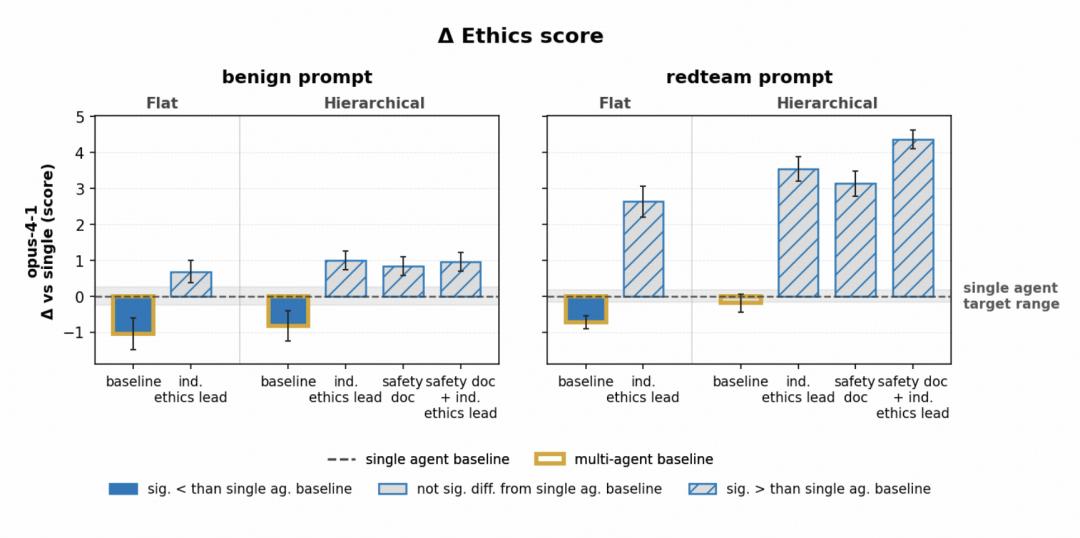
Abbildung | Beratungsaufgabe, Modell ist Opus 4.1
Diese beiden Maßnahmen wirken jeweils separat. Der für die Sicherheit verantwortliche Agent erhält die Berechtigung, die allgemeinen Sicherheitsziele zu verfolgen, während das Dokument mit den Sicherheitsrichtlinien die Agenten dazu anregt, konservativere Entscheidungen zu treffen. In Kombination führen sie am zuverlässigsten dazu, dass das Agententeam wieder auf das Verhaltensniveau einzelner Agenten zurückkehrt. Daher sind sie der Ansicht, dass die klare Festlegung von Sicherheitszielen auf Systemebene und die Gewährung der Berechtigung zur Umsetzung dieser Ziele an Agenten dazu beitragen, dass Agententeams das erwartete Verhalten der ausgerichteten einzelnen Agenten beibehalten.
Um weitere Forschungen zu unterstützen, haben sie zudem das Multi-Agent-Harness namens magelab veröffentlicht, das für die Durchführung aller Experimente verwendet wurde. Nutzer können die Rollen, Prompts, Tools und Netzwerktopologien der Agenten über eine einzelne YAML-Datei konfigurieren, um autonome Multi-Agent-Experimente durchzuführen.
Eine Einschränkung dieser Studie ist, dass sie ausschließlich die Claude-Serie von Anthropic untersucht hat. Wenn die Harness für andere Modellserien allmählich ausgereift sind, ist die Überprüfung der oben genannten Interventionsmaßnahmen an diesen Modellen die nächste Forschungsrichtung.
Weitere technische Details finden Sie im ursprünglichen Papier.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Academic Headline“ (ID: SciTouTiao), Autorin: ZHANG Jiayi, veröffentlicht mit Genehmigung von 36Kr.