Bei 10 Millionen Tokens ist es 22-fach schneller als die Sparse-Aufmerksamkeit im DeepSeek-Stil.
Heutzutage sind Kontexte mit Millionen von Tokens nicht mehr ein Verkaufsargument, sondern ein Standardmerkmal geworden. Im April legte DeepSeek-V4 den 1M-Kontext als Standardspezifikation für alle offiziellen Dienste fest; im August unterstützte das von Zhipu veröffentlichte GLM-5.3-Flash ebenfalls den 1M-Kontext und führte erstmals eine hybride Architektur aus spärlicher Aufmerksamkeit und linearer Aufmerksamkeit in die GLM-Serie ein. Hinter diesen Modellen steht eine gemeinsame Entscheidung: Jede Abfrage muss nicht mehr alle historischen Tokens durchsehen, sondern wählt nur wenige der relevantesten aus, um sie zu „betrachten“.
Dieser Ansatz wurde im Bereich von 1M wiederholt validiert. Wenn der Kontext jedoch weiter auf 10 Millionen Tokens ansteigt, gerät eine zuvor unbedeutende Kostenstelle außer Kontrolle. Nehmen wir eine globale Aufmerksamkeitsschicht von GLM-5.3-Flash als Beispiel: Bei der Prefill-Operation mit 10M-Tokens werden 98 % der Zeit nicht für die Berechnung der Aufmerksamkeit aufgewendet, sondern für den Indexierer, der entscheidet, welche Tokens „angesehen“ werden sollen.
Die Natur des Problems ändert sich dadurch. Die spärliche Aufmerksamkeit hat längst bewiesen, dass es ausreicht, „nur einen kleinen Teil zu betrachten“, um die Genauigkeit zu wahren. Was die extrem langen Kontexte tatsächlich behindert, ist, dass das „Finden dieses kleinen Teils“ immer noch mit der Länge des Kontexts im quadratischen Verhältnis ansteigt.
Jetzt hat das Londoner Startup Prefrontal AI in Zusammenarbeit mit der Eidgenössischen Technischen Hochschule Zürich (ETH Zürich) ein Papier veröffentlicht, das eine neue Methode namens Latent Sparse Attention (LSA, latente spärliche Aufmerksamkeit) vorschlägt.
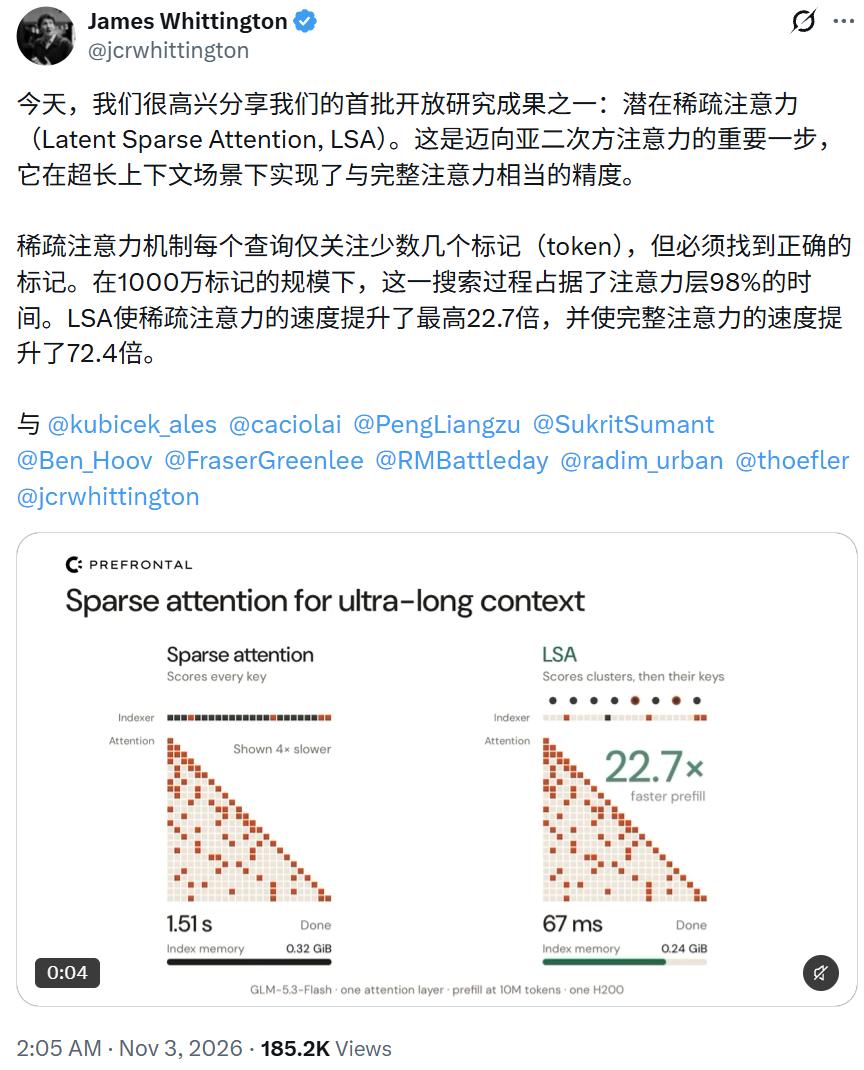
Es beschleunigt die Prefill-Operation einer einzelnen Aufmerksamkeitsschicht von GLM-5.3-Flash bei 10M-Tokens um das 22,7-fache und die von Qwen3.8-27B um das 72,4-fache, während es bei einer Reihe von Aufgaben eine ähnliche Genauigkeit wie das ursprüngliche Modell beibehält.
- Papiertitel: Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention
- Adresse des Papiers: https://arxiv.org/abs/2610.42147
- Code-Adresse: https://github.com/Prefrontal-AI/latent-sparse-attention
Die „versteckte Rechnung“ der spärlichen Aufmerksamkeit
Lassen Sie uns zuerst die Kostenstruktur der Aufmerksamkeit durchgehen. Bei der standardisierten vollständigen Aufmerksamkeit berechnet jede Abfrage die Korrelation mit allen vorherigen Schlüsseln. Bei einer Kontextlänge von T beträgt der Berechnungsaufwand für die Prefill-Operation O(T²) und für die Dekodierung jedes Tokens O(T). Wenn der Kontext von 1 Million auf 10 Millionen ansteigt, steigt der Berechnungsaufwand für die Aufmerksamkeit bei der Prefill-Operation um das 100-fache.
Die Idee der spärlichen Aufmerksamkeit ist die Aufgabenteilung: Zuerst wählt ein leichter „Indexierer“ für jede Abfrage k der relevantesten Schlüssel aus, dann berechnet die eigentliche Aufmerksamkeit nur auf diesen k Schlüsseln. Dadurch wird der Aufwand der Aufmerksamkeit selbst auf O(Tk) gedrückt.
Dieser Ansatz funktioniert nur unter einer Voraussetzung: Das Modell benötigt tatsächlich nur sehr wenige Schlüssel. Der Anhang des Papiers hat dies speziell validiert: Bei 128k-Tokens darf jede Abfrage von Qwen3.8-27B nur die 512 „wirklich“ relevantesten Schlüssel betrachten (etwa 0,8 % aller Schlüssel), und das Modell behält auf dem RULER-Langkontext-Benchmark immer noch 98 % der Genauigkeit der vollständigen Aufmerksamkeit.
Aber hier steckt ein Paradoxon. Damit der Indexierer weiß, welche 512 Schlüssel am relevantesten sind, muss er zuerst jedem einzelnen Schlüssel eine Bewertung zuweisen. DSA von DeepSeek, die spärliche Aufmerksamkeit von MiniMax sowie die blockspärlichen Schemata von Modellen wie GLM-5.3-Flash und Qwen verwenden jeweils Methoden wie die Verringerung der Genauigkeit, die Reduzierung der Dimensionen oder das Komprimieren von 4 Schlüsseln zu einem, um den Indexierer zu „entlasten“. Aber diese Verbesserungen teilen nur den Konstantenfaktor um ein Mehrfaches, der Arbeitsaufwand des Indexierers steigt immer noch linear mit dem Kontext an, und die Prefill-Operation bleibt quadratisch.
Ein Vergleich: Sie möchten 4096 Bücher aus einer Bibliothek mit zehn Millionen Büchern ausleihen. Das Ausleihen selbst geht schnell, das Problem ist, dass Sie, um zu bestimmen, welche 4096 Bücher Sie ausleihen möchten, den Buchrücken jedes einzelnen Buches durchsehen müssen. Je mehr Bücher es gibt, desto mehr Zeit nimmt das Betrachten der Buchrücken in Anspruch. Laut Berechnungen des Papiers könnte die Prefill-Geschwindigkeit der spärlichen Aufmerksamkeit bei 10M-Tokens noch um das 58-fache gesteigert werden, wenn der Aufwand des Indexierers auf Null gesenkt werden könnte.
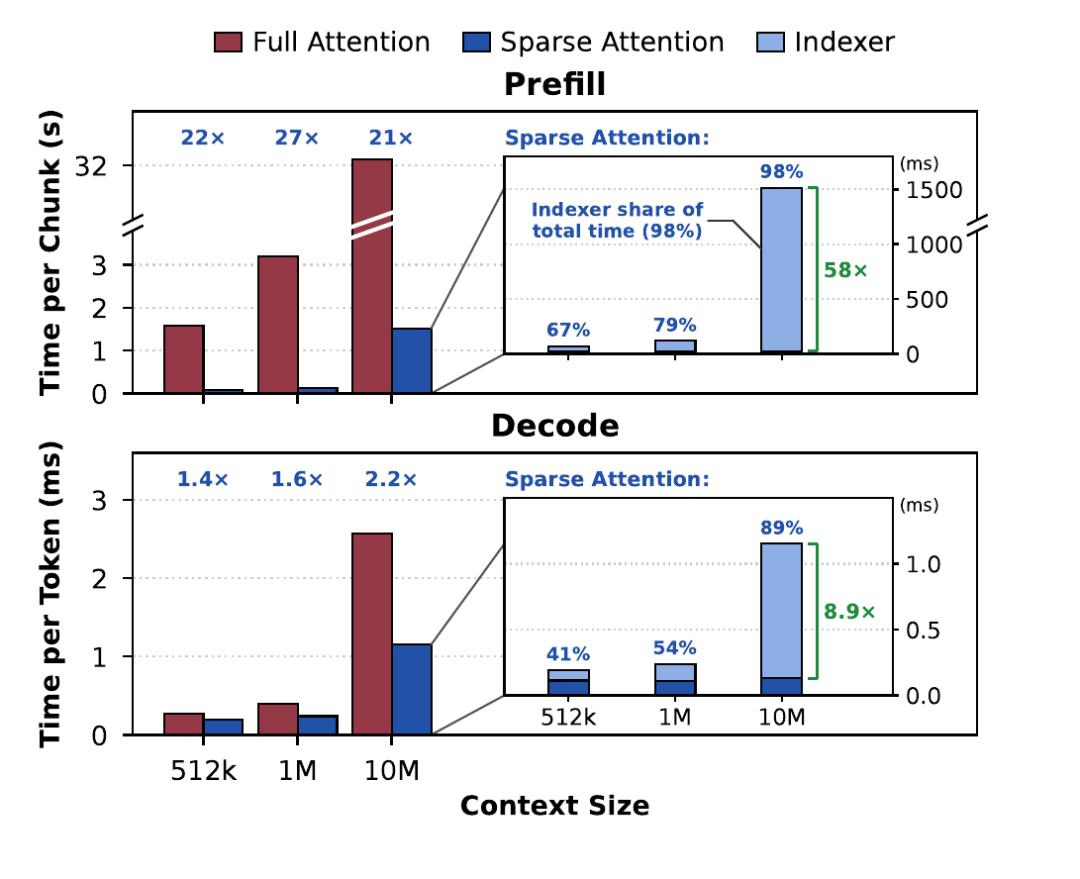
Zeitaufteilung der herkömmlichen spärlichen Aufmerksamkeit bei extrem langen Kontexten (eine einzelne globale Aufmerksamkeitsschicht von GLM-5.3-Flash, eine einzelne H200-GPU). Bei 10M-Tokens macht der Indexierer 98 % der gesamten Prefill-Zeit aus.
Nicht nach Zeit, sondern nach Semantik sortieren
Die Lösung von LSA besteht darin, dass der Indexierer nicht mehr jeden Schlüssel einzeln prüft, sondern „Gruppen von Schlüsseln“ prüft.
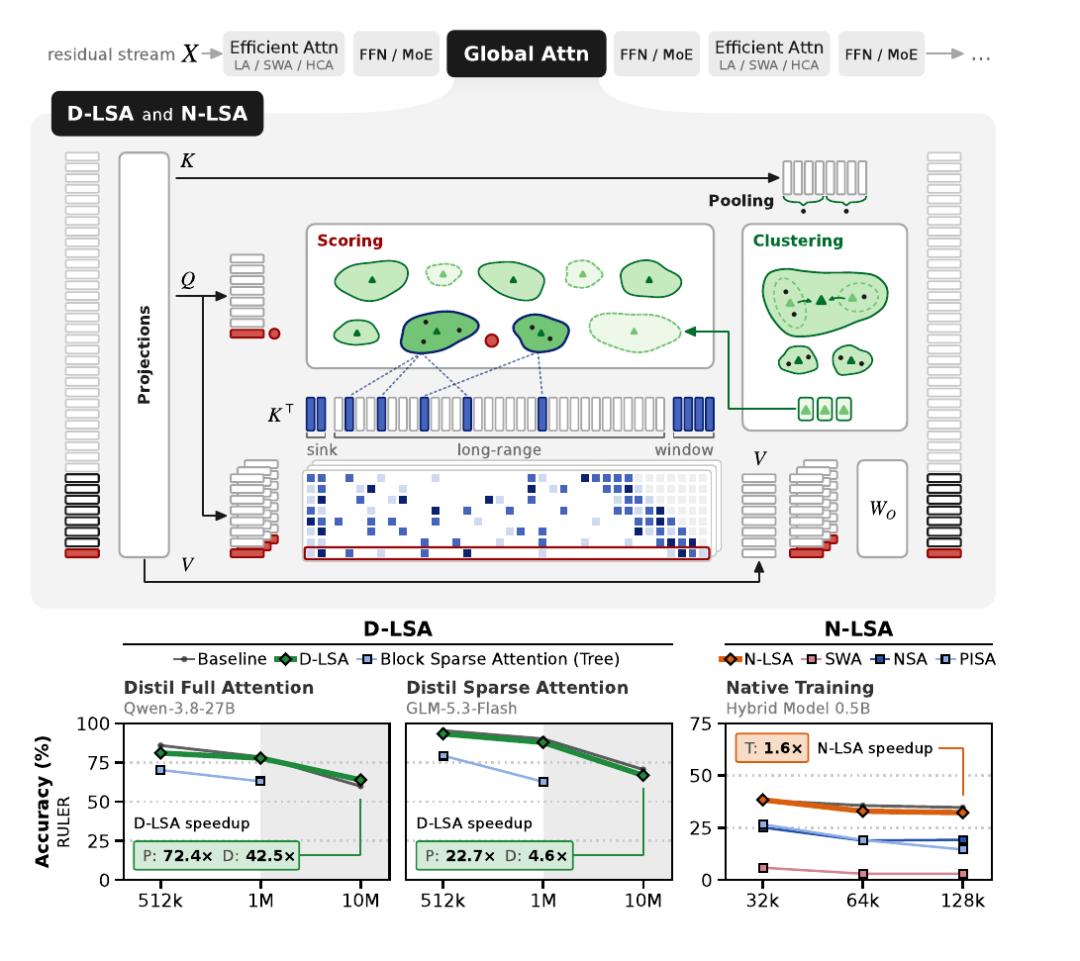
Überblick über D-LSA und N-LSA. Oben: In einer Aufmerksamkeitsschicht werden Schlüssel zuerst gepoolt und in Eimer gruppiert, die Abfrage bewertet nur die Eimerzentren und betrachtet dann nur die ausgewählten entfernten Schlüssel (zuzüglich Sink- und Gleitfenster); unten: Genauigkeit und Beschleunigung der beiden Varianten.
Der Schlüssel liegt in der Art der Gruppierung. Die meisten vorhandenen blockspärlichen Methoden gruppieren nach Position und fassen mehrere benachbarte Schlüssel zu einem Block zusammen. Das entspricht dem Verpacken von Büchern in Kisten nach dem Einlagerungsdatum in der Bibliothek, wobei jede Kiste eine Zusammenfassung erhält. Das Problem ist, dass wenn ein einziges wichtiges Buch in einer Kiste enthalten ist, es durch die Zusammenfassungen mehrerer anderer irrelevanter Bände „überdeckt“ werden kann.
LSA wählt die Gruppierung nach Inhalt. Es projiziert die Schlüssel zuerst in einen erlernten niedrigdimensionalen latenten Raum, dann werden semantisch ähnliche Schlüssel in diesem Raum durch hierarchisches Clustering (Ward-Methode) in denselben „Eimer“ eingeordnet. Jeder Eimer behält nur einen Zentralvektor und eine Indextabelle, die die Positionen der Schlüssel im Eimer aufzeichnet. Bei der Abfrage muss die Abfrage nur die Zentralvektoren der Eimer bewerten, mehrere der relevantesten Eimer auswählen und dann die Eimer zu konkreten Schlüsseln „entfalten“, um k Stück für die Aufmerksamkeit zusammenzustellen.
Zurück zum Bibliotheksvergleich: Die Bücher werden nicht mehr nach Einlagerungsdatum in Kisten verpackt, sondern nach Themen sortiert aufgestellt. Wenn Sie Bücher über Quantenfehlerkorrektur suchen, gehen Sie direkt zu der entsprechenden Regalreihe. Bücher zum selben Thema wurden möglicherweise über zehn Jahre lang nacheinander eingelagert, stehen aber jetzt nebeneinander.
Der Nutzen dieses Schritts ist konstant, das Papier nennt dies die Flat-Suche. Was die Komplexität wirklich verändert, ist die Tree-Variante: Über den Eimern werden größere „Knoteneimer“ gebildet, die sich schichtweise nach oben zu einem hierarchischen Baum formen. Die Abfrage beginnt an der Spitze des Baums und behält auf jeder Ebene nur die Zweige mit den höchsten Bewertungen bei, um weiter nach unten zu gelangen (Strahlsuche). Genau wie zuerst die Etage, dann der Bereich und dann das Regal ausgewählt wird, muss jede Abfrage nur O(log T) Zentralvektoren prüfen. Die Prefill-Operation des Indexierers sinkt von quadratisch auf O(T log T), was der Ursprung des Begriffs „subquadratisch“ im Titel des Papiers ist.
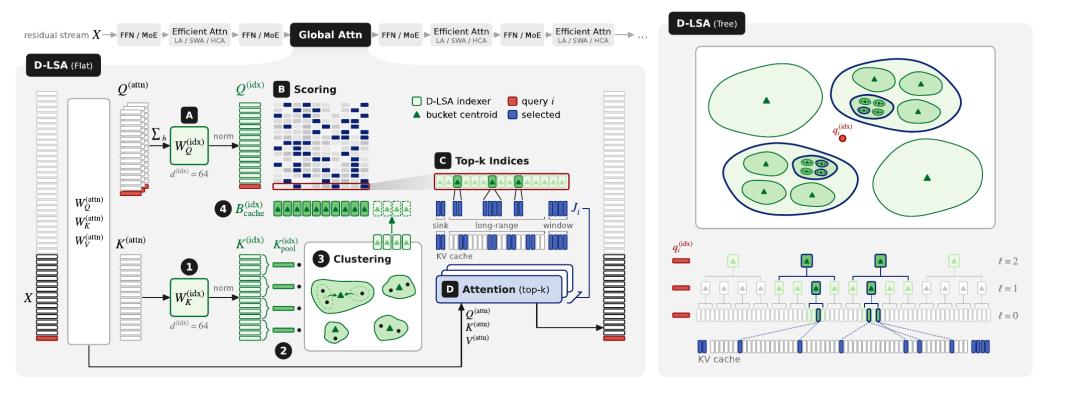
D-LSA-Design. Links: Flat-Suche: Schlüssel werden nach Projektion, Pooling und Clustering im Eimer-Cache gespeichert, die Abfrage bewertet die Eimerzentren und entfaltet sie zu Top-k-Indizes; rechts: Tree-Suche: Eimer werden in einer mehrschichtigen Hierarchie organisiert, die Abfrage durchsucht sie schichtweise mit Strahlsuche.
Zwei Anwendungsfälle: Einpflanzen in vorhandene Modelle oder von Grund auf neu trainieren
LSA bietet zwei Implementierungsmöglichkeiten.
Die erste ist D-LSA (Distilled-LSA), die für bereits trainierte Modelle ausgelegt ist. Es friert alle Parameter des ursprünglichen Modells ein und fügt nur zwei kleine Projektionsmatrizen pro Schicht hinzu, um Schlüssel und Abfragen in einen 64-dimensionalen Indexraum zu projizieren. Durch Destillation wird die Bewertung von LSA dazu gebracht, die Verteilung der Aufmerksamkeit des ursprünglichen Modells anzunähern. Die gesamte Destillation verwendet nur 352 Millionen Tokens, zum Vergleich: Die dichte Vorwärmphase des Indexierers von DeepSeek DSA verwendet allein 2,1 Milliarden Tokens. Das Papier bietet auch eine vollständig trainingsfreie Version an, die direkt die Hauptkomponentenrichtung der Schlüssel als Projektion verwendet und auf Qwen3.8-27B eine Genauigkeit nahe der trainierten Version erreicht.
Die zweite ist N-LSA (Native-LSA), bei der LSA bereits beim Vortraining nativ verwendet wird und nur durch den standardisierten Vorhersageverlust für das nächste Token trainiert wird. Es clustert direkt die eigenen Schlüssel der Aufmerksamkeit, benötigt keine zusätzliche Indexprojektion, kein Lehrermodell und keinen Hilfsverlust, die Anzahl der Modellparameter erhöht sich überhaupt nicht.
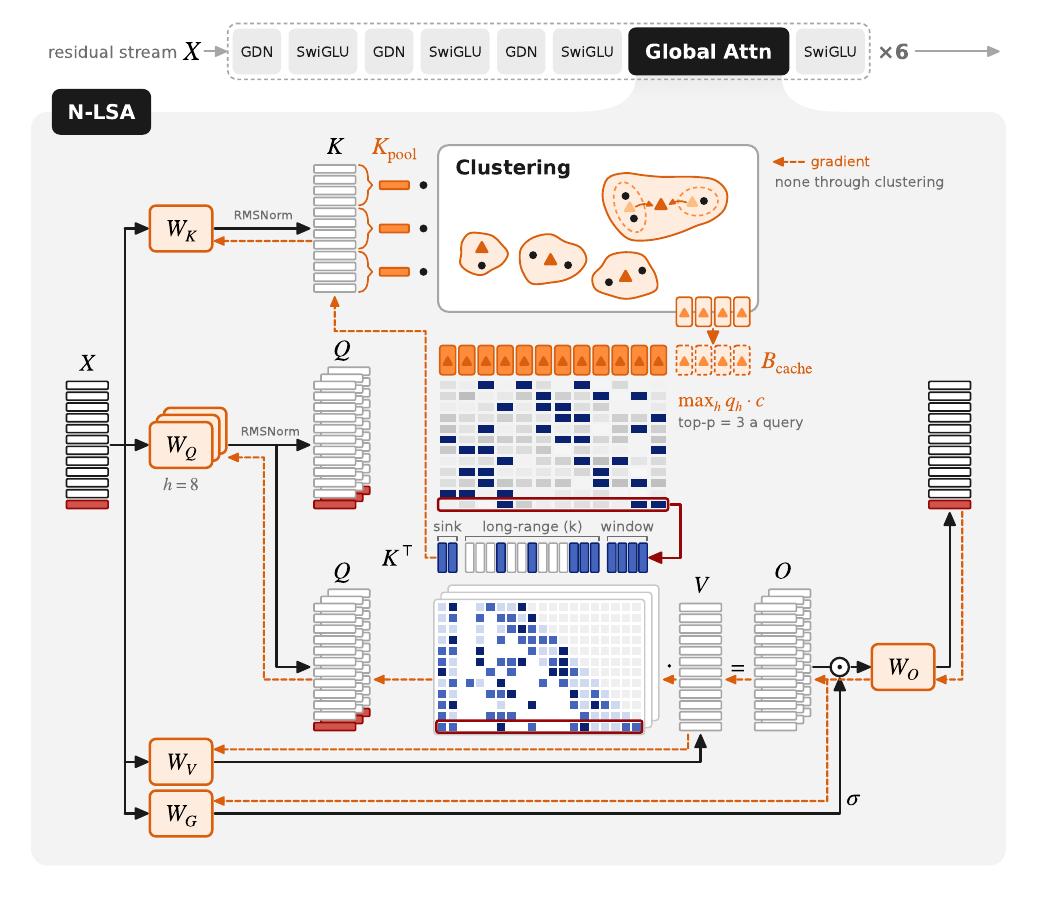
N-LSA-Design. Die Aufmerksamkeitsschicht clustert direkt ihre eigenen Schlüssel und kann nur mit dem Vorhersageverlust für das nächste Token von Grund auf trainiert werden.
Auf technischer Ebene hat das Team GPU-Kernel für H200 und B300 für Clustering, Bewertung, Auswahl und Entfaltung geschrieben (es gibt auch eine Triton-Version, die auf beliebigen GPUs ausgeführt werden kann) und LSA in SGLang integriert, was Tensorparallelismus, Expertenparallelismus, Pipelineparallelismus sowie Kontextparallelismus in der Prefill- und Dekodierungsphase unterstützt.
Ergebnisse bei 10 Millionen Tokens
Sehen wir uns zuerst die Genauigkeit an. Das Team hat D-LSA auf zwei Modellen getestet: Qwen3.8-27B (mit vollständiger Aufmerksamkeit als Aufmerksamkeitsschicht) und GLM-5.3-Flash (mit integrierter spärlicher Aufmerksamkeit) und den Kontext auf 10M-Tokens ausgedehnt, weit über die offizielle Obergrenze von 1M hinaus. Bei Wissens-, Inferenz- und Langkontextaufgaben wie MMLU-Pro, GPQA-Diamond, AIME25, MATH500 und LongBench v2 liegt D-LSA innerhalb des 95%-Konfidenzintervalls der Baseline und ändert die Inferenzlänge des Modells nicht merklich.
Auf RULER mit 4k bis 10M-Tokens beträgt der Unterschied zwischen Qwen3.8-27B mit D-LSA und der vollständigen Aufmerksamkeit bei unter 1M nicht mehr als 5 Punkte, bei 10M übertrifft es sogar mit 63,9 gegenüber 59,9. Bei GLM-5.3-Flash mit D-LSA beträgt der Unterschied zur nativen spärlichen Aufmerksamkeit bei unter 1M nicht mehr als 3 Punkte, im Bereich von 2M bis 5M liegt es maximal um 8 Punkte zurück, bei 10M sinkt der Unterschied wieder auf unter 4 Punkte. Es ist zu beachten, dass die spärliche Baseline-Aufmerksamkeit von GLM zusammen mit dem Modell trainiert wurde, während D-LSA nur auf dem eingefrorenen Modell destilliert wurde – dieser Vergleich ist also von vornherein für die Baseline vorteilhaft.
Um die Fähigkeit für extrem lange Kontexte in realistischeren Szenarien zu prüfen, hat das Team auch einen neuen Benchmark namens PaperTrail erstellt.
Dabei werden fiktive „Forschungsspuren“ in eine große Anzahl echter arXiv-Papiere aus dem Jahr