Lassen Sie uns die KI-Speicherprodukte von Tencent Cloud gründlich durchleuchten.
Im vergangenen Jahr hat die gesamte Gesellschaft mehr Aufmerksamkeit auf die Speicherung gelegt als je zuvor.
Unter dem Einfluss der KI-Welle ist die Nachfrage nach Speicherplatz sprunghaft angestiegen, und die Preise sind ebenfalls stetig gestiegen.
Bisher konzentrierte sich die Entwicklung von KI hauptsächlich auf Rechenleistung und Algorithmen, auf Chips und große Modelle. Heutzutage, mit der fortschreitenden praktischen Umsetzung von KI, gewinnen Daten und die darunter liegende Speicherbasis stetig an Wert.
Vor kurzem fand die globale digitale Ökosystemkonferenz von Tencent in Shenzhen statt. Auf der Konferenz wiesen Branchenkenner darauf hin, dass die Entwicklung von KI in eine völlig neue Phase eingetreten ist, deren wichtiges Kennzeichen darin besteht, dass Agenten zu einer neuen Form der Produktivität werden.
Der Aufbau einer Agent-Infrastruktur mit hoher Leistung und extrem hohem Preis-Leistungs-Verhältnis ist eine wichtige Grundlage zur Unterstützung dieses Entwicklungstrends.
Große Modelle und Agenten vollziehen einen beschleunigten Übergang zur Produktivität. Als wichtiger Bestandteil der zugrunde liegenden Infrastruktur muss das gesamte Speichersystem eine systemweite Neugestaltung von Medium, Hierarchie, Architektur bis hin zum Software-Stack durchlaufen.
Die grundlegende Logik der Speichertechnik hat sich vollständig verändert. Es handelt sich nicht mehr nur um einen einfachen Wettbewerb zwischen Kapazität und Geschwindigkeit, sondern hat sich zu einem tiefgreifenden Wettbewerb um den Lebenszyklus von Daten, Zugriffsmuster und die Gesamtbetriebskosten entwickelt.
Im Folgenden werde ich auf der Grundlage der Ansichten der Branchenkenner und unter Einbeziehung meines eigenen Verständnisses über diesen Wandel und diese Neugestaltung sprechen.
Wenn traditionelle Speicherung auf KI trifft, ist eine Revolution unvermeidlich
Die theoretische Grundlage moderner Computer ist die Neumann-Architektur. In dieser Architektur sind Berechnung und Speicherung die zwei zentralsten Komponenten.
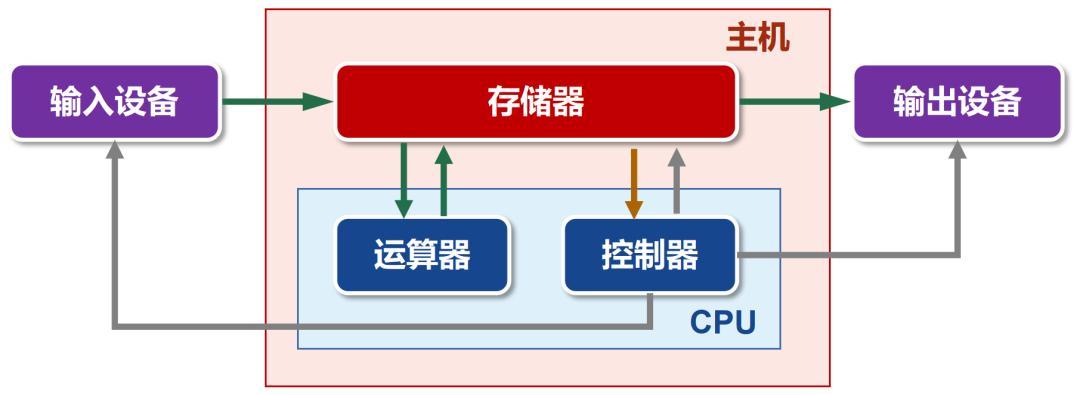
Neumann-Architektur
Die moderne Speichertechnik entstand in den 1950er Jahren und hat sich über mehr als ein halbes Jahrhundert weiterentwickelt: von Magnetbändern zu optischen Discs, von mechanischen Festplatten zu Solid-State-Laufwerken, von Einplatzspeicherung zu verteilter Speicherung. Speichermedien und -formen werden ständig weiterentwickelt.
Hinter dieser Weiterentwicklung ist die zentrale Aufgabe der Speicherung immer unverändert geblieben: Daten zu speichern und bei Bedarf auszulesen.
Um sicherzustellen, dass Daten rechtzeitig gespeichert und ausgelesen werden können, verfolgen Speichersysteme stets zwei zentrale Kennzahlen: Leistung und Kapazität. Die Leistung bezieht sich hauptsächlich auf die Lese- und Schreibgeschwindigkeit von Daten.
Im Wesentlichen ist die Speicherung ein sorgfältig entworfenes „System zur gestuften Datenverteilung“. Von Registern, Caches und Arbeitsspeicher über SSD und HDD bis hin zu Offline-Medien wie Magnetbändern und optischen Discs übernimmt jede Ebene Daten unterschiedlicher Zugriffshäufigkeit mit unterschiedlicher Geschwindigkeit, Kapazität und Kosten. Je höher die Leistung einer Ebene ist, desto höher sind ihre Kosten und desto geringer ist ihre Kapazität.
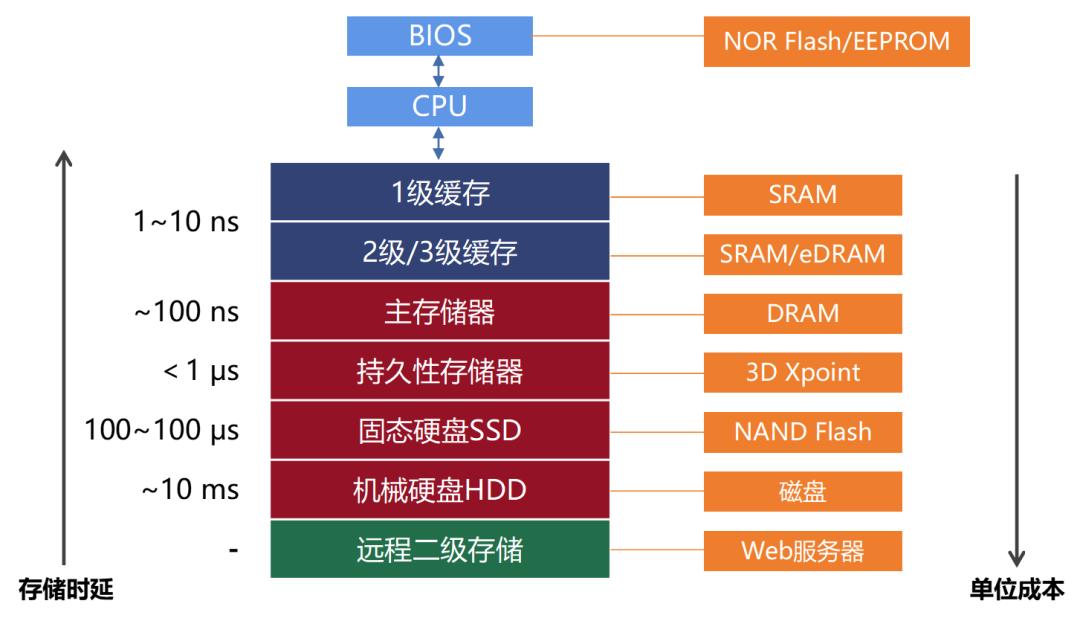
Gestuftes Speichersystem
In der Zeit vor dem Aufkommen von KI lief dieses gestufte System sehr stabil – alle Ebenen konnten die Anforderungen der Anwendungen grundsätzlich erfüllen, das Modell der Datenzugriffshäufigkeit war relativ stabil und die Kosten ließen sich kontrollieren.
Aber das Aufkommen von KI hat dieses Gleichgewicht vollständig zerstört.
Das Training und die Inferenz großer Modelle stellen Anforderungen an die Speicherung, die sich vollständig von denen des traditionellen Internets unterscheiden.
Das Training großer Modelle erfordert das kontinuierliche Auslesen großer Mengen von Stichproben, was höhere Anforderungen an den Speicherdurchsatz und die Effizienz der Datenbereitstellung stellt. Das HBM auf der GPU übernimmt den Hochgeschwindigkeitsdatenzugriff während der Modellberechnung. In Inferenzszenarien wird sowohl Arbeitsspeicher zur Unterstützung von Kontext und Cache benötigt, als auch Speichersysteme zum Speichern von Modelldateien, Wissensdatenbanken und Sitzungsdaten. Die Anforderungen an Kapazität, Bandbreite und Latenzzeit unterscheiden sich in den verschiedenen Phasen.
Die in den letzten zwei Jahren sehr beliebten Agent-Anwendungen stellen auch neue Herausforderungen an die Speicherung. Wenn Agenten Aufgaben ausführen, sammeln sie kontinuierlich Dateien, Erinnerungen und Zwischenergebnisse an. Die Ausführungsumgebung kann bei Bedarf gestartet und freigegeben werden, diese Arbeitsdaten müssen jedoch unabhängig aufbewahrt werden, damit sie für nachfolgende Aufgaben weiterverwendet werden können. Gleichzeitig müssen die Daten verschiedener Benutzer und Agenten isoliert werden können, bei der Zusammenarbeit aber nach Berechtigungen freigegeben werden können, sodass Arbeitsergebnisse sowohl sicher gespeichert als auch kontinuierlich wiederverwendet werden können.
Zusammengefasst erfordert die Aktualisierung von Algorithmen und Rechenleistung im KI-Zeitalter die Zusammenarbeit eines leistungsstärkeren Speichersystems. Die tiefgreifende Entwicklung von KI erfordert den Aufbau einer skalierten, qualitativ hochwertigen Datenbereitstellung.
Die Verteilung der Datenzugriffshäufigkeit folgt nicht mehr dem Muster des langsamen Abfalls wie im Internetzeitalter, sondern weist komplexe Merkmale wie hohe Frequenz, plötzlichen Zugriff und Ebenenübergreifung auf. Die traditionelle Logik der einfachen Trennung von heißen und kalten Daten verliert ihre Gültigkeit, und das Speichersystem muss eine Reihe grundlegender Fragen neu überdenken: Wo sollen Daten abgelegt werden, auf welche Weise und wann sollen sie migriert werden.
Wie man das Verhältnis zwischen Kapazität, Leistung und Kosten ausgleicht und Speicherprodukte entwickelt, die den tatsächlichen Anforderungen entsprechen, ist zu einem Problem geworden, vor dem die gesamte Speicherbranche steht. Die Lösung dieser Probleme wirkt sich direkt auf die Datenvorbereitungszeit von KI-Aufgaben, die Auslastung der Rechenleistung und die Betriebskosten aus und beeinflusst damit die Effizienz der großflächigen Anwendung von KI in Unternehmen.
Wie will Tencent Cloud das Speicherproblem tatsächlich lösen?
Bei der Bewältigung der oben genannten Herausforderungen lautet die Antwort von Tencent Cloud „Neugestaltung + Innovation“ –
Sie verfolgen nicht mehr nur die extreme Leistung einer einzelnen Ebene, sondern entwerfen Form und Anordnung der Speicherprodukte neu, ausgehend von den Flussmustern von Daten im gesamten Lebenszyklus. Für verschiedene KI-Szenarien wie Training, Inferenz, Datenerfassung, Agenten und körperliche Intelligenz gestalten sie einerseits die vorhandenen traditionellen Produkte neu, um deren Leistung weiter zu verbessern, und andererseits führen sie mehr innovative Produkte ein, um die Lücken in der bestehenden Produktmatrix zu schließen.
Durch das verbesserte Produktsystem kann jede Art von Daten auf einem geeigneten Medium zu angemessenen Kosten von der passenden Rechenleistung effizient abgerufen werden. Mit anderen Worten: Es geht nicht nur darum, „genug Speicherplatz zu haben“, sondern auch um „schnelle Bereitstellung“, „genaue Anpassung“ und „erschwingliche Kosten“.
Im Folgenden werfen wir einen detaillierten Blick darauf, welche Verbesserungen Tencent Cloud an traditionellen Produkten vorgenommen hat und welche Innovationen eingeführt wurden.
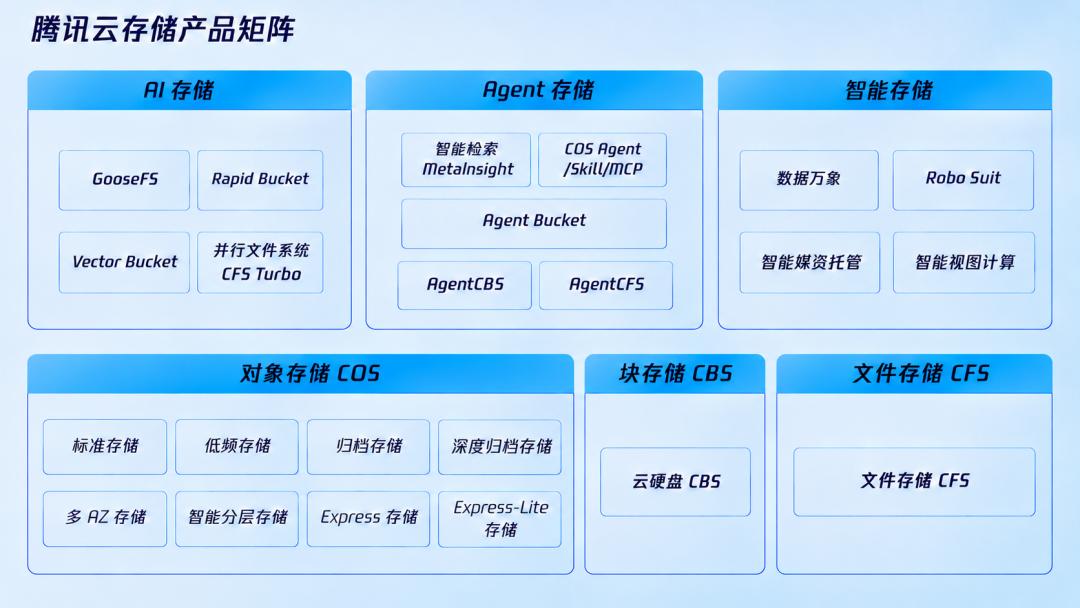
Schichtung des Speicherproduktsystems
Aus Sicht der Schichtung hat Tencent Cloud die traditionelle einfache Schichtung tiefgehend verfeinert und in extrem kalte Ebene, kalte Ebene, online-warme Ebene, online-heiße Ebene und Beschleunigungsebene unterteilt.
● Kalte Ebene, online-warme Ebene, online-heiße Ebene (COS gestufter Speicher)
COS (Cloud Object Storage) ist die Sammelbezeichnung für den Objektspeicherdienst von Tencent Cloud. Es ist die zentralste einheitliche Grundlage für riesige Mengen unstrukturierter Daten, die die selbst entwickelte Yotta-Architektur von Tencent Cloud verwendet. Der Speicherumfang eines einzelnen Clusters kann Hunderten von EB erreichen, die Bandbreite erreicht Tbps-Ebene und die Anzahl der Objekte in einem einzelnen Bucket kann Billionen betragen.
Auf der Grundlage von COS wird es weiter in COS Standard-Speicher, COS Express-Lite, COS Niedrigfrequenz/Archiv/Tieftarchiv unterteilt, die jeweils der online-heißen Ebene, der online-warmen Ebene und der kalten Ebene entsprechen.
Es ist erwähnenswert, dass COS Express-Lite ein kürzlich von Tencent Cloud eingeführtes Produkt ist, das auf riesige Mengen warmer Daten ausgerichtet ist, die langfristig online verfügbar sein müssen.
Es verwendet QLC (eine Art NAND-Flash-Halbleiterspeichertechnik) als zugrunde liegendes Medium, belegt keine knappen HDD-Kapazitäten, der Preis pro GB Speicher beträgt etwa 1/4 des Hochleistungsspeichers, es gibt keine Mindestgebühr für das Abrufen von Daten und es bietet ausreichende Leistung und kontrollierbare Kosten für Online-Kapazität.
In Bezug auf die Kompatibilität unterstützt COS Express-Lite den S3-kompatiblen Zugriff, sodass vorhandene Datenpipelines und Werkzeugketten weiterverwendet werden können, was die Kosten für die Anpassung der Integration senkt.
● Extrem kalte Ebene (Magnetspeicher)
Auf der extrem kalten Ebene verwendet Tencent Cloud Magnetspeicher. Obwohl diese Speicherform sehr alt erscheint, ist sie für extrem kalte Daten (z. B. Protokolle, historische Kameradaten) eine sehr kostengünstige und zuverlässige Methode.
Der Magnetspeicher von Tencent Cloud verwendet die neueste selbst entwickelte Magnetband-Engine-Technologie, deren Schreibgeschwindigkeit branchenführend ist, und hat insgesamt über 2000 PB an Daten gespeichert.
Vor dem Hintergrund steigender Speicherpreise und knapperer Medienversorgung kann der Magnetspeicher einen Teil des von HDD und SSD freigegebenen Speicherplatzes übernehmen und die gesamten TCO (Gesamtbetriebskosten) effektiv senken.
● Beschleunigungsebene (GooseFS)
Schauen wir uns die sehr wichtige Beschleunigungsebene an. Auf dieser Ebene ist die entsprechende Lösung von Tencent Cloud GooseFS (Datenbeschleuniger Goose File System).
GooseFS befindet sich zwischen dem Berechnungsframework und dem zugrunde liegenden persistenten Speicher (COS/CHDFS/HDFS usw.). Durch Caching und Beschleunigung von Lese- und Schreibvorgängen arbeitet es mit dem zugrunde liegenden persistenten Speicher zusammen, um die Effizienz des Datenzugriffs zu verbessern und die Probleme von langsamen Metadaten, kleinen Dateien, zufälligen IO und wiederholtem Abrufen von COS in Big Data- und KI-Trainingsszenarien zu lösen.
Beispielsweise werden während des Trainings und der Inferenz großer Modelle Datensätze, Prüfsätze, vortrainierte Gewichtungen und Vektorbibliotheken wiederholt von mehreren GPUs ausgelesen. Es gibt viele kleine Dateien und sehr dichte zufällige IO (Eingabe/Ausgabe)-Vorgänge. Mit GooseFS kann die Cache-Trefferquote verbessert werden, die Wartezeit der GPU wird reduziert und der Bandbreitendruck auf der COS-Ebene wird verringert.
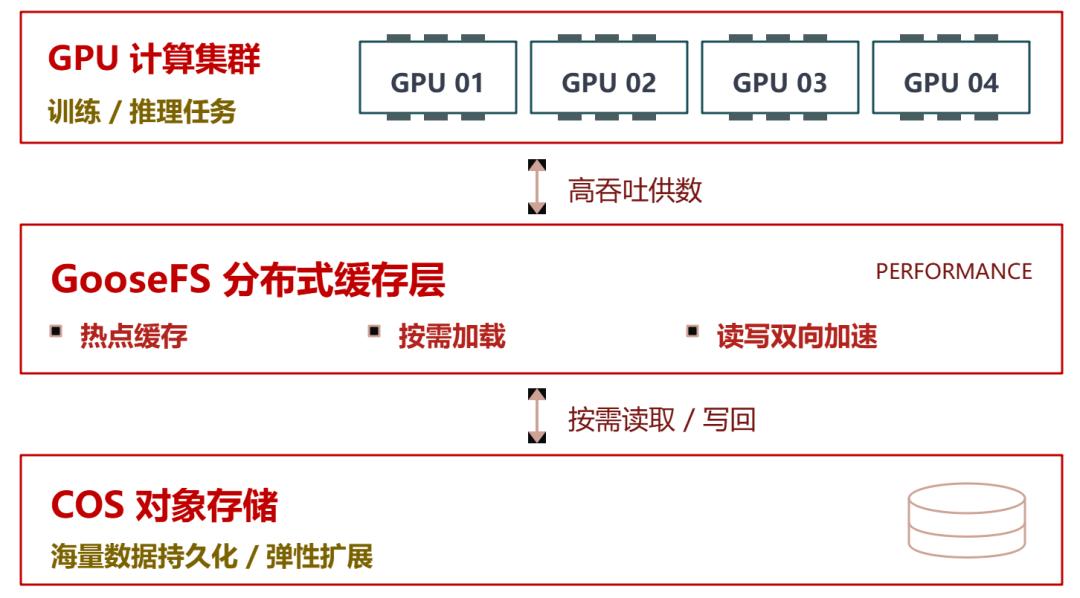
GooseFS hat auch einige „Varianten“. Zum Beispiel kann GooseFS-Cache den lokalen NVMe der GPU wiederverwenden, um einen globalen Cache zu erstellen. Ein weiteres Beispiel ist GooseFS-X (vollständig verwaltetes Hochleistungs-Paralleldateisystem), das verteilte Metadatenbeschleunigung bietet, einen Durchsatz von Hunderten von GB pro Sekunde, Millionen von IOPS und eine Latenzzeit im Submillisekundenbereich erreicht.
GooseFS sorgt für hohen Durchsatz bei der Datenbereitstellung und bedarfsgerechtes Lesen und Schreiben, während COS für riesige Mengen an persistenter Speicherung und elastische Erweiterung sorgt. Die Zusammenarbeit beider kann die Herausforderungen des Datenzugriffs in KI-Trainings- und Inferenzszenarien gut bewältigen und ein Gleichgewicht zwischen Leistung und Kosten erreichen. Das bedeutet, dass verschiedene Arten von Daten einen geeigneten Speicherort finden.
● COS Rapid Bucket
Für den parallelen Datenabruf durch eine große Anzahl von GPUs plant Tencent Cloud die Einführung eines neuen Produkts – COS Rapid Bucket (Hochleistungs-Speicherbucket, in der Beta-Phase).
COS ist das gesamte Objektspeicherdienst, während Bucket (Speicherbucket) der Container unter COS ist, der Objekte speichert.
COS Rapid Bucket ist auf KI-Training, Inferenz und Hochleistungs-Computing-Szenarien ausgerichtet und bietet hohe Parallelität und geringe Latenz für Lese- und Schreibvorgänge von Daten. Mit anderen Worten: Seine Aufgabe ist es sicherzustellen, dass Daten rechtzeitig an die Berechnungsseite übermittelt werden.
COS Rapid Bucket verwendet ausschließlich SSD-Medien und wird durch die nahegelegene Bereitstellung von Berechnung und Speicher in derselben Verfügbarkeitszone bereitgestellt, um den Pfad des Datenzugriffs zu verkürzen. Nach den öffentlichen Produktinformationen von Tencent Cloud verfügt COS Rapid Bucket über Millionen von IOPS, Latenzzeiten im Millisekundenbereich und Durchsatzkapazitäten auf TB/s-Ebene, die für das Auslesen von Trainingsstichproben, das Schreiben von Modell-Checkpunkten und das Laden von Modellgewichtungen