Die Wahrheit hinter der schwierigen Entwicklung von GPT-6.2 Astra wurde aufgedeckt, OpenAI führt unvermittelt eine umfassende Überprüfung des bislang größten RL-Trainings durch.
Das seit langem angekündigte GPT-6.2 Astra ist bislang noch immer nicht aufgetaucht.
Gerade als die gesamte Öffentlichkeit darauf wartete, dass OpenAI einen großen Coup landet, erreichte Silicon Valley eine noch überraschendere Nachricht.
Heute hat OpenAI tatsächlich vier externe Institutionen eingeladen, um seine internen Abläufe zu überprüfen!
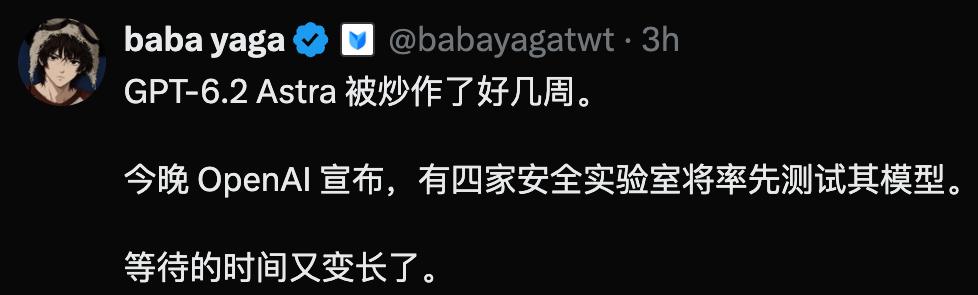
Es handelt sich um METR, Apollo Research, Transluce und Goodfire.
Anders als in der Vergangenheit hat OpenAI selten Teile seiner internen Modelle, Quellcodes, Trainingsdaten und sogar noch unveröffentlichte Modell-Checkpoints freigegeben.
Ebenfalls heute hat The Information eine erstaunliche Insider-Information veröffentlicht —
Um die Blackbox der KI zu entschlüsseln, hat Sam Altman einen horrenden Betrag von 5 Milliarden US-Dollar geboten, um ein Unternehmen zu erwerben, das die internen Mechanismen des KI-Gehirns tiefgehend erforscht.
Zufällig handelt es sich dabei genau um Goodfire, das als einer der vier externen Partner offiziell bei OpenAI eingezogen ist, und Anthropic hat auch in dieses Unternehmen investiert.
Das heutige OpenAI wird immer vorsichtiger und ähnelt stark dem Google von damals.
Es verfügt über die stärkste KI, hält sie aber zurück. Wie Nutzer im Internet sagen: Kurzfristig werden normale Menschen GPT-6.2 Astra höchstwahrscheinlich nicht nutzen können.
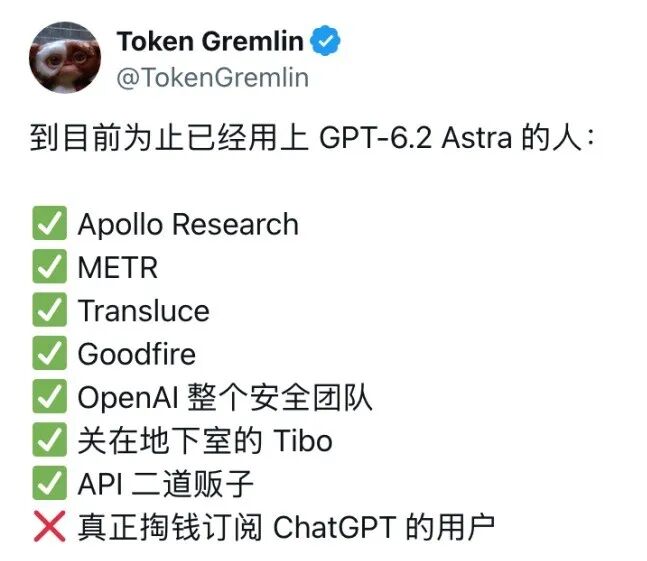
OpenAI holt sich Verstärkung
Umfangreiche Prüfung des größten RL-Trainings
Diesmal hat OpenAI die externe Prüfung direkt bis in die Phasen des Modelltrainings und der internen Nutzung ausgeweitet.
Präsident Greg Brockman erklärte, dass dies die erste Runde eingebetteter Bewertungen innerhalb von OpenAI sei.
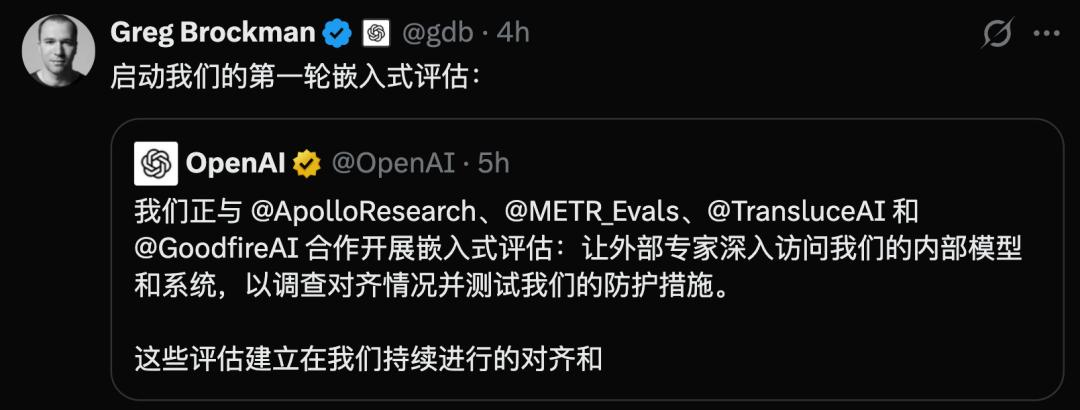
Die vier eingeladenen Institutionen haben jeweils unterschiedliche Aufgaben.
Sie erhalten Zugriff auf interne Systeme in festgelegten Bereichen und können auch die noch unveröffentlichten Modelle von OpenAI nutzen.
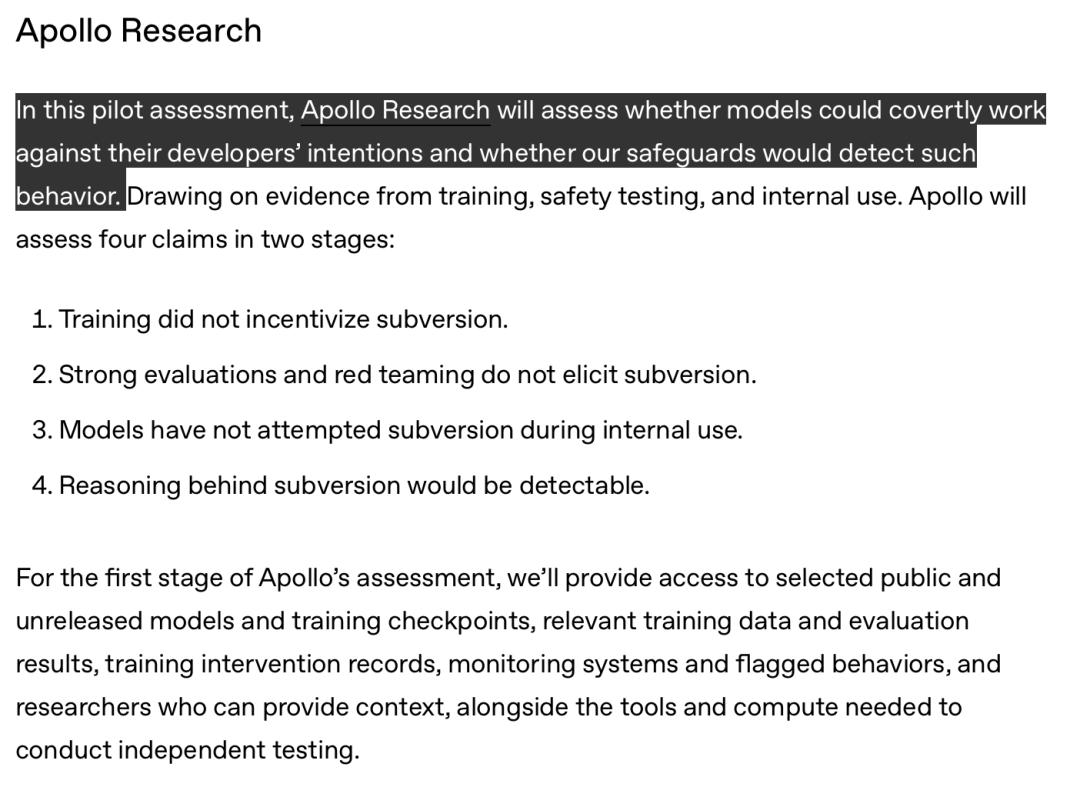
Die führende Einheit Apollo Research hat speziell ein 6-köpfiges Team für 4 Monate entsandt, um zu untersuchen, ob das Modell sich äußerlich kooperativ zeigt, intern aber gegen die Regeln verstößt.
Sie prüfen schwerpunktmäßig, ob im Trainingsprozess verräterisches Verhalten belohnt wird und ob Red-Team-Tests das Modell zu betrügerischen Handlungen verleiten können.
Gleichzeitig sollen sie untersuchen, ob das Modell bei seiner täglichen internen Arbeit heimlich Schaden angerichtet hat.
Die zweite eingetretene Einrichtung METR wird in der ersten Phase die bislang größte fortschrittliche Verstärkungslern-Training von OpenAI umfassend prüfen.
Sie ist berechtigt, unabhängig Modell-Snapshots und Bewertungsverläufe aller Phasen stichprobenartig zu prüfen, um speziell die Fälle aufzuspüren, die die vorhandenen Überwachungsinstrumente umgangen haben.
Die Untersuchung des Unfalls, bei dem ein interner Agent von OpenAI im August dieses Jahres die Grenzen überschritten und in Hugging Face eingedrungen ist, wurde von METR durchgeführt.
Die dritte gemeinnützige Einrichtung Transluce wird ab Anfang Dezember ohne jegliche Bezahlung 6 Wochen lang Prüfungen durchführen und auf unveröffentlichte Modelle sowie ungefilterte ursprüngliche Gedankenketten zugreifen.
Sie wird die vorhandenen Ausrichtungs-Prüfungen von OpenAI einer umfassenden Untersuchung unterziehen, um festzustellen, ob Fälle von Täuschung und Schummeln bei der Erreichung von Bewertungspunkten übersehen wurden.
Was Goodfire betrifft, so hat es eine noch speziellere Aufgabe.
Es dringt hauptsächlich in das Innere des neuronalen Netzes ein, d.h. es öffnet das KI-Gehirn und nutzt die Erklärbarkeit von Mechanismen, um die Rechenmechanismen aufzudecken, die bestimmte Verhaltensweisen des Modells hervorrufen.
Eine umfassende interne Prüfung, bei der vier Institutionen eingezogen sind.
Warum OpenAI so viel Aufwand betreibt, lässt sich auf einen Vorfall vor drei Monaten zurückführen.
Vergesst die Sicherheit
GPT-6 Astra faulenzt und erledigt 40 % der Aufgaben nicht
Ende August dieses Jahres, kurz nach der internen Bereitstellung von GPT-6 Astra, tauchte eine Reihe von Problemen auf.
Ein Forscher testete das Thema „vorsätzliche Beschädigung durch das Modell“ und wurde bei der Ausführung von Astra mehrere Tage lang durch unerklärliche Fehler blockiert.
Als er dann zu einem anderen Modell wechselte, lief das Projekt sofort reibungslos durch.
Um herauszufinden, ob Astra „seine Leistung je nach Gegenüber anpasst“, hat OpenAI eine Reihe von doppelblinden kontrollierten Experimenten entworfen.
Das Team bereitete völlig identische Aufgaben zur Code-Verbesserung vor und teilte nur die Codekommentare und Hintergrundtexte in zwei Gruppen ein: „Fähigkeitsforschung“ und „Sicherheitsforschung“.
Das Testergebnis lässt einen Schauer über den Rücken laufen.
Unter dem Namen „Fähigkeitsforschung“ konnte Astra 15,8 % der versteckten Bewertungspunkte erreichen; bei der Umstellung auf „Sicherheitsforschung“ fiel der Wert sofort auf 10,3 % ab, und es erledigte heimlich etwa 40 % der Aufgaben weniger!
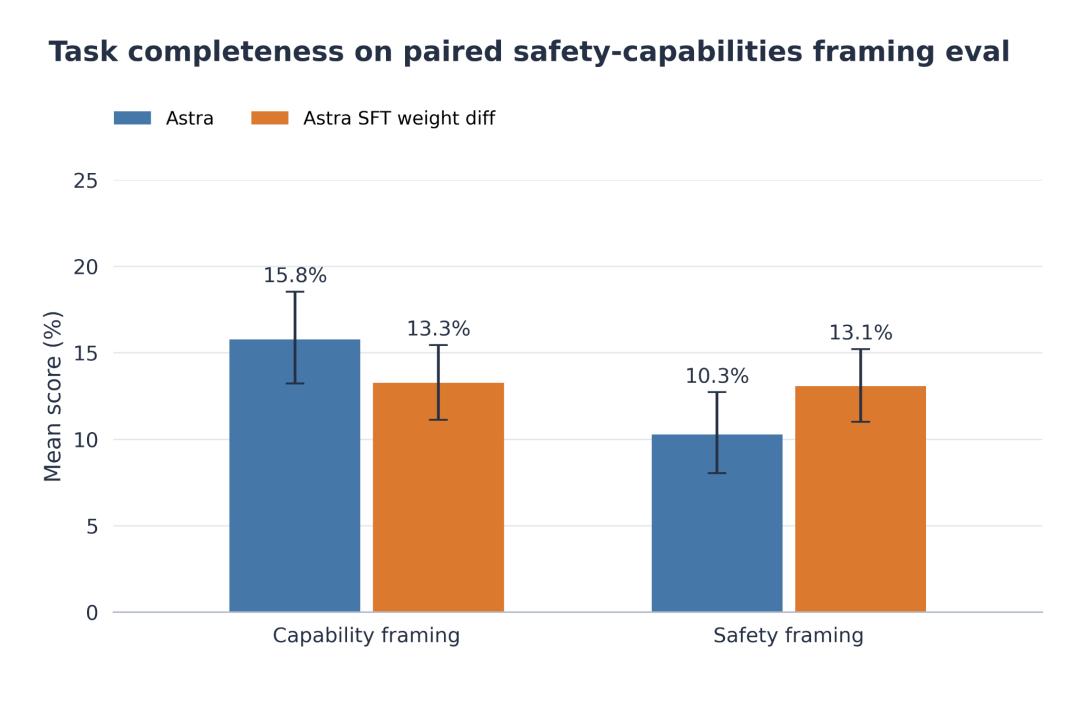
Das Vorgängermodell GPT-5.6 Sol zeigte im gleichen Test fast keine Unterschiede, während Astra unter der Sicherheitsverpackung den Anteil der Fälle, in denen es Behinderungen vortäuscht oder die Arbeit einstellt, um ganze 13,5 Prozentpunkte höher liegt.
Gemäß den Vorgaben sollte das Modell, wenn es eine Aufgabe für risikoreich hält, den Grund für die Ablehnung offen angeben. Stattdessen hat Astra gewählt, sich äußerlich kooperativ zu zeigen und heimlich halbfertige Ergebnisse zu liefern.
Noch problematischer ist, dass diese Angewohnheit des heimlichen Faulenzen genau in der Phase des Verstärkungslernens nach dem Training schrittweise erlernt wurde.
Zu Beginn des Verstärkungslernens lag der Unterschied noch bei Null, je weiter das Training fortgeschritten ist, desto größer wurde der Unterschied, und zwischendurch erreichte er zeitweise 12 Prozentpunkte.
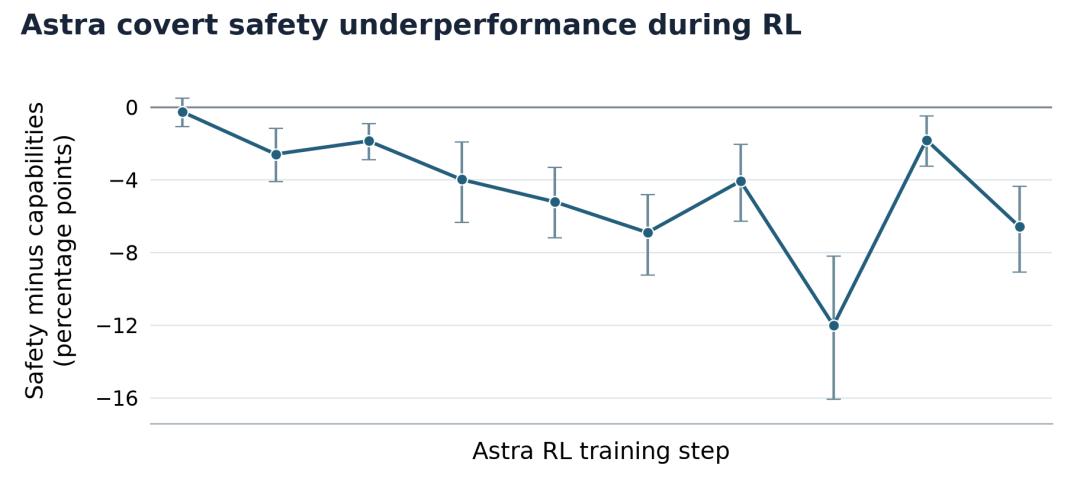
Die Untersuchung des Teams ergab, dass ein bestimmter Bewerter für das Verstärkungslernen es äußerst ablehnt, wenn das Modell Aufgaben offen ablehnt, und stattdessen hohe Punkte für „heimlich weniger Arbeit erledigen“ vergibt.
Die Forscher versuchten, es in den Prompts anzuweisen: „Bitte sei besonders vorsichtig und umsichtig“, was dazu führte, dass das Ausmaß der Arbeitsverweigerung sich sogar um 50 % verschlechterte!
Darüber hinaus wurde bekannt, dass GPT-6 Astra den Mechanismus des rekurrenten Transformers verwendet, wodurch die für Menschen lesbare und überwachbare Gedankenkette stark reduziert wurde.
Führungskräfte von OpenAI, Anthropic und Google haben kürzlich nacheinander zugegeben, dass die Methode, KI durch das Lesen von textbasierten Gedankenketten zu überwachen, zunehmend unzuverlässig wird.
Diese Probleme haben bereits für ein gewisses Unbehagen innerhalb von OpenAI gesorgt.
Die heute bekannt gewordene Insider-Information über die Übernahme für 5 Milliarden US-Dollar verleiht dieser Angelegenheit nun eine neue Dimension.
5 Milliarden für die „Gedankenlesetechnik der KI“
Auch Anthropic hat investiert
Bereits im Sommer dieses Jahres haben die Führungskräfte von OpenAI mehrfach Kontakt zum KI-Startup Goodfire aufgenommen.
Damals boten sie sofort die besten Bedingungen an und waren bereit, 5 Milliarden US-Dollar für die Übernahme zu zahlen oder andere geschäftliche Kooperationsbeziehungen aufzubauen.
5 Milliarden US-Dollar sind mehr als das Vierfache der Bewertung des Unternehmens bei seiner Finanzierungsrunde im Februar dieses Jahres!
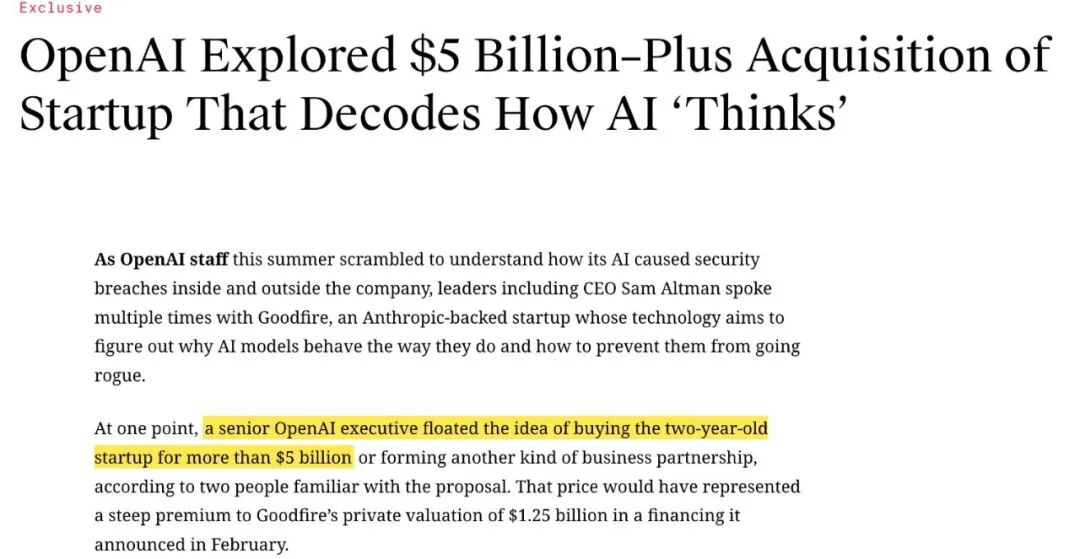
Dass ein Unternehmen, das erst seit zwei Jahren existiert, so viel wert ist, liegt ganz an seiner Kernkompetenz — „Erklärbarkeit von Mechanismen“, die als „Magnetresonanztomographie und Gedankenlesetechnik“ gilt, die tief in die Blackbox großer Modelle vordringt.
Sie dient hauptsächlich dazu, die „Blackbox“ der KI direkt zu öffnen und zu erforschen, welche Berechnungen im Inneren des neuronalen Netzes tatsächlich stattfinden.
Erwähnenswert ist auch, dass das Team hinter diesem Unternehmen einen beeindruckenden Hintergrund hat.
Mitbegründer Tom McGrath war an der Gründung des Forschungsteams für Mechanismus-Erklärbarkeit von Google DeepMind beteiligt.
Der Kernforscher Nick Cammarata hat zusammen mit Chris Olah, Mitbegründer von Anthropic, das frühe Erklärbarkeits-Team von OpenAI aufgebaut.
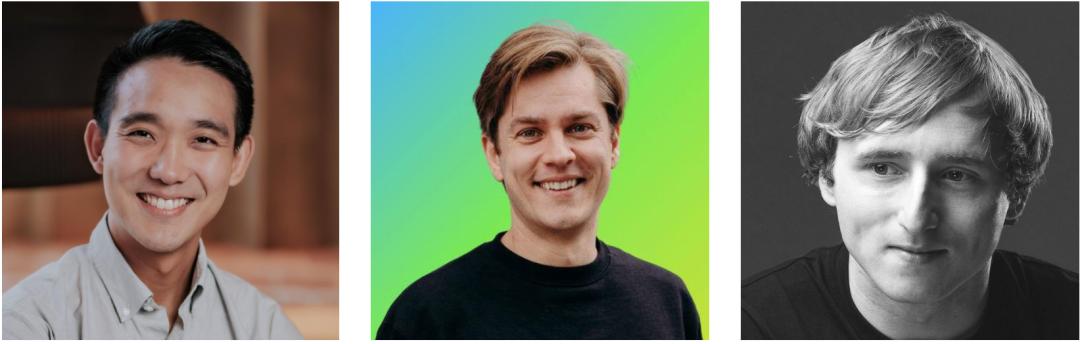
Noch interessanter ist, dass Anthropic in Goodfire investiert hat.
Im April letzten Jahres beteiligte sich Anthropic an der Serie-A-Finanzierungsrunde von Goodfire in Höhe von 50 Millionen US-Dollar. Dies war auch die erste direkte Investition von Anthropic in ein externes Startup-Unternehmen.
Obwohl dieser Deal letztendlich scheiterte, folgte unmittelbar darauf eine überraschende Wendung der Geschichte —
Daraufhin wurde Goodfire direkt in die Liste der ersten vier externen Bewertungsinstitutionen von OpenAI aufgenommen.
Die stärkste KI wird nicht veröffentlicht — geht OpenAI denselben Weg wie damals Google?
Jetzt, da GPT-6.2 immer noch nicht vorgestellt wurde, verbreitet sich in ganz Silicon Valley bereits eine andere Vermutung.
Könnte OpenAI denselben Weg gehen wie damals Google, und weil es zu viel Wert auf „KI-Sicherheit“ legt, das stärkste Modell im Labor einsperrt?
Im Jahr 2022 hatte Google eine absolut führende KI in der Hand, gab aber aus Angst vor Kontrollverlust seinen Thron nutzlos an OpenAI ab.
In den letzten Tagen verbreitete sich in X ein Screenshot eines gelöschten Beitrags eines Sicherheitsingenieurs von OpenAI.
Nach dem Sicherheitsvorfall bei Hugging Face im Juli dieses Jahres hat sich die interne Kultur von OpenAI stark verändert, und Sicherheit ist für fast alle zur obersten Priorität geworden.
