Der von Microsoft vor drei Monaten veröffentlichte Patch hat 74 Länder und Regionen komplett lahmgelegt.
Ihr habt es sicher alle gehört: Microsoft erlebte in den letzten zwei Tagen einen massiven globalen Ausfall!
Die Geschichte beginnt in der Nacht zum 13. November nach Pekinger Zeit, als eine große Zahl von US-Nutzern plötzlich feststellte, dass sie keine Verbindung zu ihrem Outlook-Postfach herstellen konnten.
Outlook ist die Bürosoftware von Microsoft, die neben der E-Mail-Funktion auch Funktionen wie Terminverwaltung und Besprechungseinladungen enthält. Die meisten Unternehmen und Behörden im Ausland nutzen Outlook zur Kommunikation während der Arbeitszeit.
Anfangs posteten die Leute noch im Internet, um nach der Ursache des Problems zu fragen.
Bevor Outlook wiederhergestellt werden konnte, traten nacheinander auch Verbindungsprobleme bei Microsofts Teams, Copilot und SharePoint auf.
Später überprüften die Leute die Ausfall-Monitoring-Webseite Downdetector und stellten fest, dass Berichte über einen Microsoft-Ausfall aus 74 Ländern und Regionen eingegangen waren.
Was? Der drittwertvollste Konzern der Welt nach Marktkapitalisierung ist ausgefallen??
Normalerweise sollte der Kerngeschäftsbereich eines so großen Konzerns niemals ausfallen. Und selbst wenn es passiert, sollte er schnell wieder behoben werden, oder?
Aber niemand hätte erwartet, dass die Microsoft-Dienste erst in der Nacht zum 14. November vollständig wiederhergestellt werden konnten.
Wie stark wurden die Arbeitnehmer auf der ganzen Welt in diesen 24 Stunden betroffen?
Die Arbeitseffizienz ist um 20 Jahre zurückgekehrt.
Zum Beispiel haben hunderte Krankenhäuser in Großbritannien wieder Papierkrankenakten verwendet, und viele Operationen wurden sogar kurzfristig abgesagt.
Denn das System NHS.net Connect, das die mehr als 1 Million Mitarbeiter des britischen National Health Service (NHS) normalerweise zum Versenden von E-Mails, Abhalten von Besprechungen und Übertragen von Dateien nutzen, hängt vollständig von Microsoft-Diensten ab.
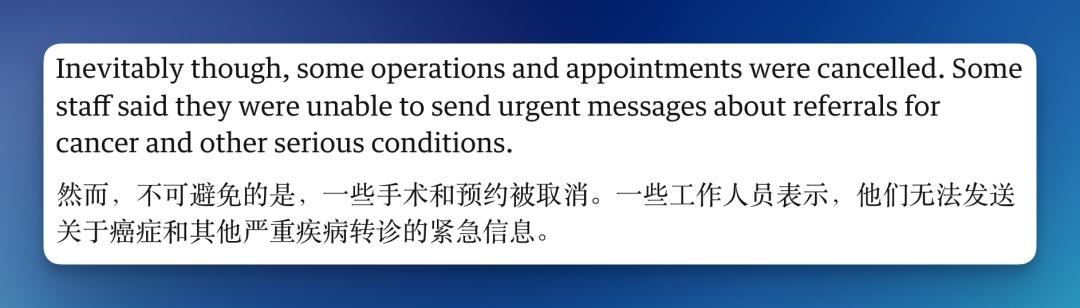
Nachdem das NHS-System nicht mehr angemeldet werden konnte, konnten keine Patientendaten mehr gesendet oder empfangen werden, selbst die Notfallüberweisungen von schwerkranken Patienten konnten nicht mehr mitgeteilt werden.
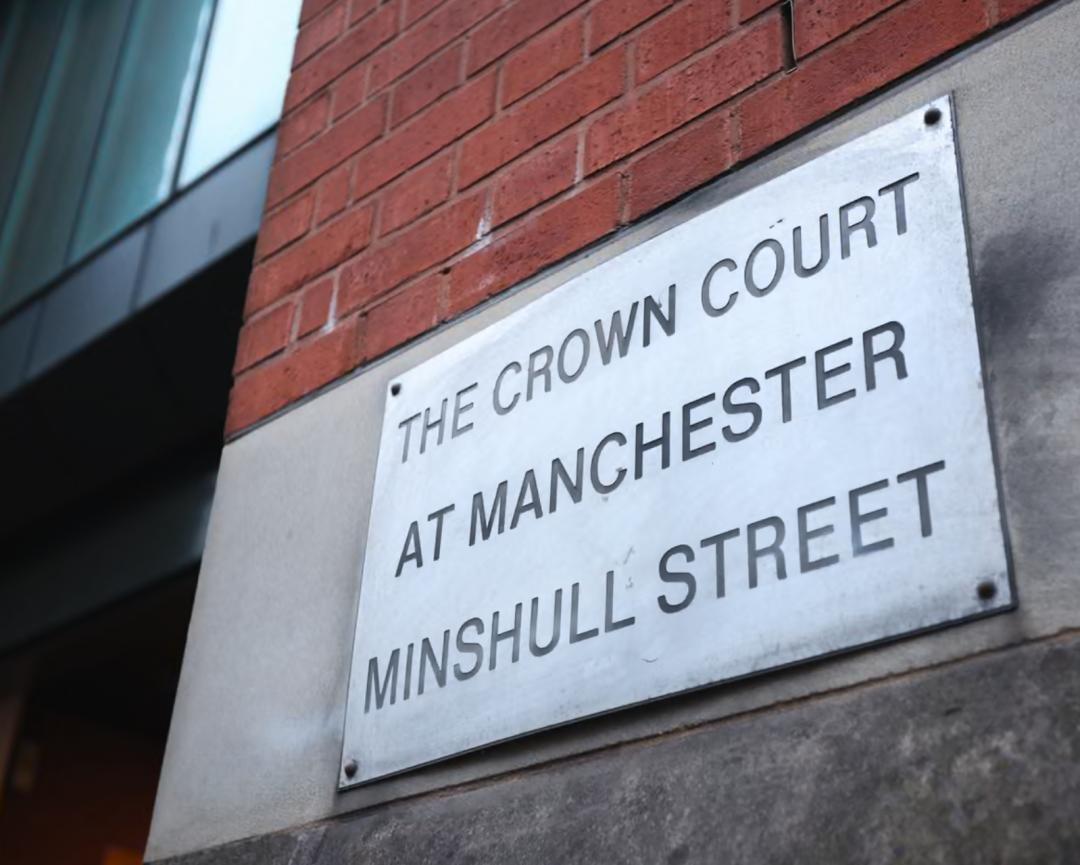
Auch das britische Gerichtssystem nutzt normalerweise Outlook zum Versenden von E-Mails, und selbst Urteile in Zivilverfahren werden per E-Mail übermittelt.
Als das Postfach ausfiel, konnten die Urteile erst am kommenden Montag verkündet werden...
Eines der betroffenen Gerichte ↓
Auch Japan wurde schwer getroffen.
Die gemeinsame Regierungsplattform GSS, die das japanische Digitalministerium für alle Behörden aufgebaut hat, nutzt Microsoft 365.
Plötzlich konnten die Behörden keine E-Mails mehr über Outlook senden und empfangen und mussten schließlich über Telefon und SMS arbeiten. Alle sind zurück in die 90er Jahre versetzt und erleben den Retro-Y2K-Trend.
Nach Schätzungen amerikanischer Forschungsinstitute belaufen sich die durch diesen Microsoft-Ausfall verursachten Schäden auf etwa 7 Milliarden US-Dollar.
Als so viele Menschen betroffen waren, tauchten schnell Memes im Internet auf, die Leute schauen dem Spektakel gerne zu.
Jemand hat ein Bild von "Microsoft 364" veröffentlicht: Was Microsoft 365 betrifft, muss man dieses Jahr einen Tag abziehen.
Microsoft muss seinen Namen ändern! Keine Fragen, das ist die Regel.
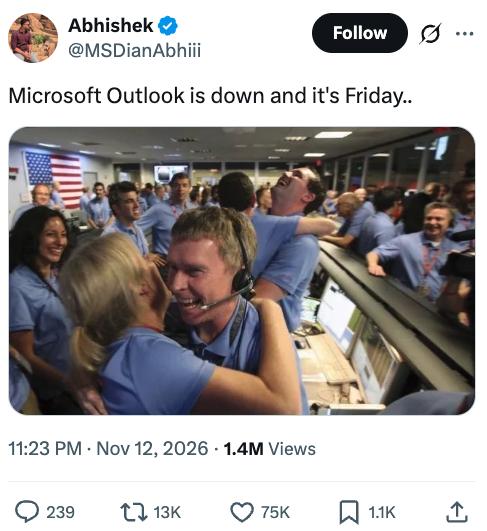
Ein anderer Nutzer hat ein Foto des NASA-Kontrollzentrums veröffentlicht: Ein Raum voller Mitarbeiter feiert gemeinsam, dass Microsoft Outlook ausgefallen ist – und es ist Freitag...
Für viele Arbeitnehmer bedeutet es tatsächlich, dass das Wochenende früher beginnt, wenn das Postfach am Freitagmorgen nicht geöffnet werden kann.
Jetzt stellt sich die Frage: Was ist eigentlich passiert, dass Microsoft einen so groß angelegten Ausfall erlebt hat?
Anfangs vermutete Microsoft, dass eine Komponente zur Überprüfung des Serverzustands fehlerhaft war. Erst gestern (16. November) veröffentlichte der Konzern einen ersten Unfallbericht, sodass die Ursache endlich klar wurde.
Nachdem man den Bericht gelesen hat, kann man nur sagen: Es waren definitiv keine Hacker, die Microsoft angegriffen haben, der Konzern hat sich selbst geschadet.
Wenn Nutzer aus der ganzen Welt auf Dienste wie E-Mail, Teams und Cloud-Speicher in Microsoft 365 zugreifen, müssen sie zuerst ein "Netzwerk-Gateway" durchlaufen, genau wie man durch Drehkreuze geht, bevor man die U-Bahn-Station betritt.
Für dieses Gateway hat Microsoft zwei Sätze vorbereitet: ein primäres Gateway und ein sekundäres Gateway als Backup.
Jedes Gateway verfügt über eine große Anzahl von Servern, die wie Reihen von Drehkreuzen funktionieren: Nutzer passieren zuerst das Drehkreuz und werden dann zu dem entsprechenden Dienst im Hintergrund weitergeleitet.
Vor dem Ausfall lief der E-Mail-Dienst über das primäre Gateway, Teams über das sekundäre Gateway. Die beiden Systeme sichern sich gegenseitig ab: Wenn eines Probleme hat, kann der Dienst auf das andere umgestellt werden.
Dieses Mal ist genau das primäre Gateway ausgefallen.
Nach offiziellen Angaben von Microsoft gab es drei Faktoren, die zu dem Unfall geführt haben.
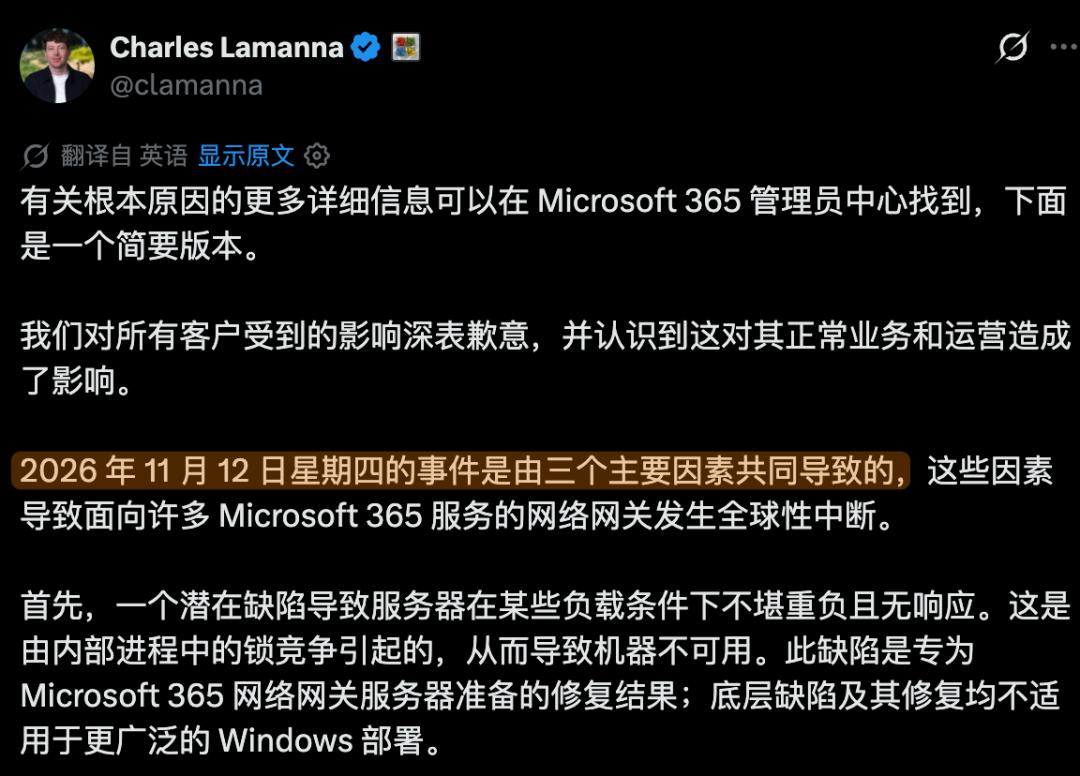
Der erste Faktor: Im Juli hat Microsoft ein Update für die Gateway-Server installiert, das einen versteckten Fehler enthielt. Dieser Fehler verursachte eine "Sperrkonkurrenz" bei einem internen Serverprogramm.
Sperrkonkurrenz bedeutet, dass Ressourcen konkurriert werden: Genau wie es in einem Servicecenter nur ein Siegel gibt, auf das alle Mitarbeiter warten müssen, um ihre Aufgaben zu erledigen. Je mehr Mitarbeiter es gibt, desto länger die Warteschlange, und am Ende können die Aufgaben nicht mehr erledigt werden.
Daher wirkt sich dieser Fehler auf Servern mit mehr CPU-Kernen sogar noch schwerwiegender aus.
Aber das Dumme ist, dass Microsoft für Lasttests hauptsächlich Server mit wenigen Kernen verwendet hat, sodass das Problem natürlich nicht entdeckt wurde. Das Update lief dann drei Monate lang problemlos auf allen Gateways weltweit...
Der zweite Faktor war eine Umstellung 15 Stunden vor dem Ausfall.
Teams wurde vom sekundären Gateway auf das primäre Gateway verschoben und teilte sich die Ressourcen mit dem hinter Outlook stehenden E-Mail-Dienst Exchange Online. Microsoft sagt, dass eine solche Umstellung normal sei, aber die Belastung des primären Gateways hat dadurch zugenommen.
Der dritte Faktor: Am Tag vor dem Unfall waren aufgrund eines anderen unabhängigen Problems 14 % der Server im primären Gateway noch heruntergefahren und wurden langsam wiederhergestellt.
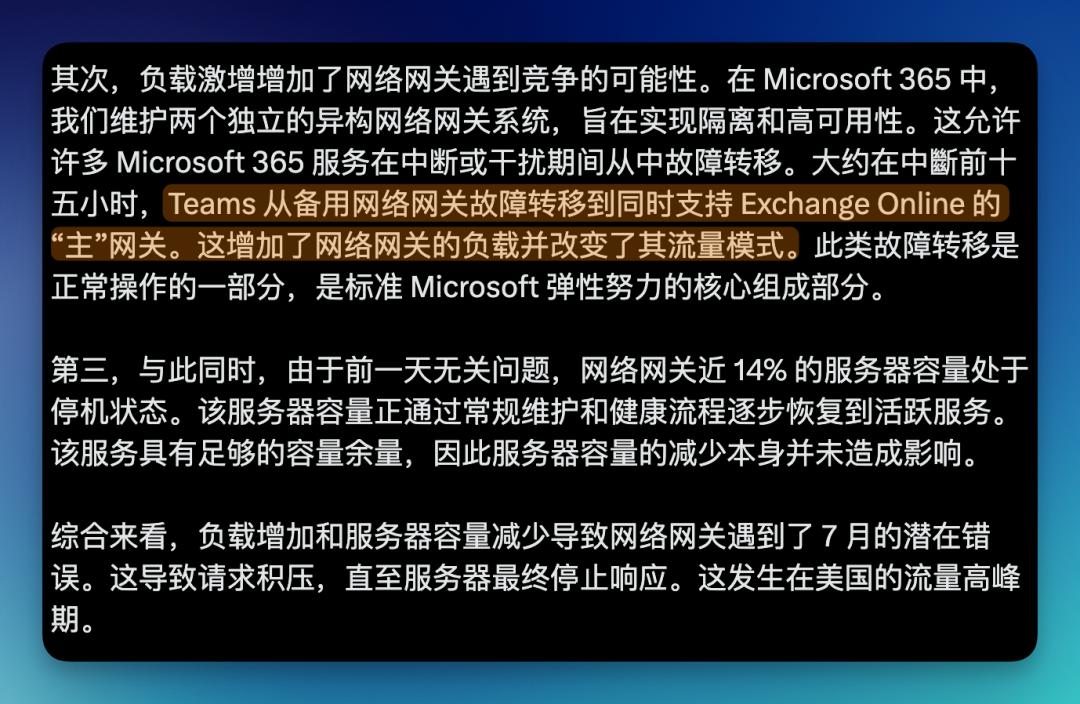
Als die drei Faktoren zusammenkamen:
14 % der Server im primären Gateway waren bereits ausgeschaltet, der gesamte Datenverkehr von Teams strömte hinzu, und dazu kam noch der Spitzenverkehr zur amerikanischen Arbeitszeit.
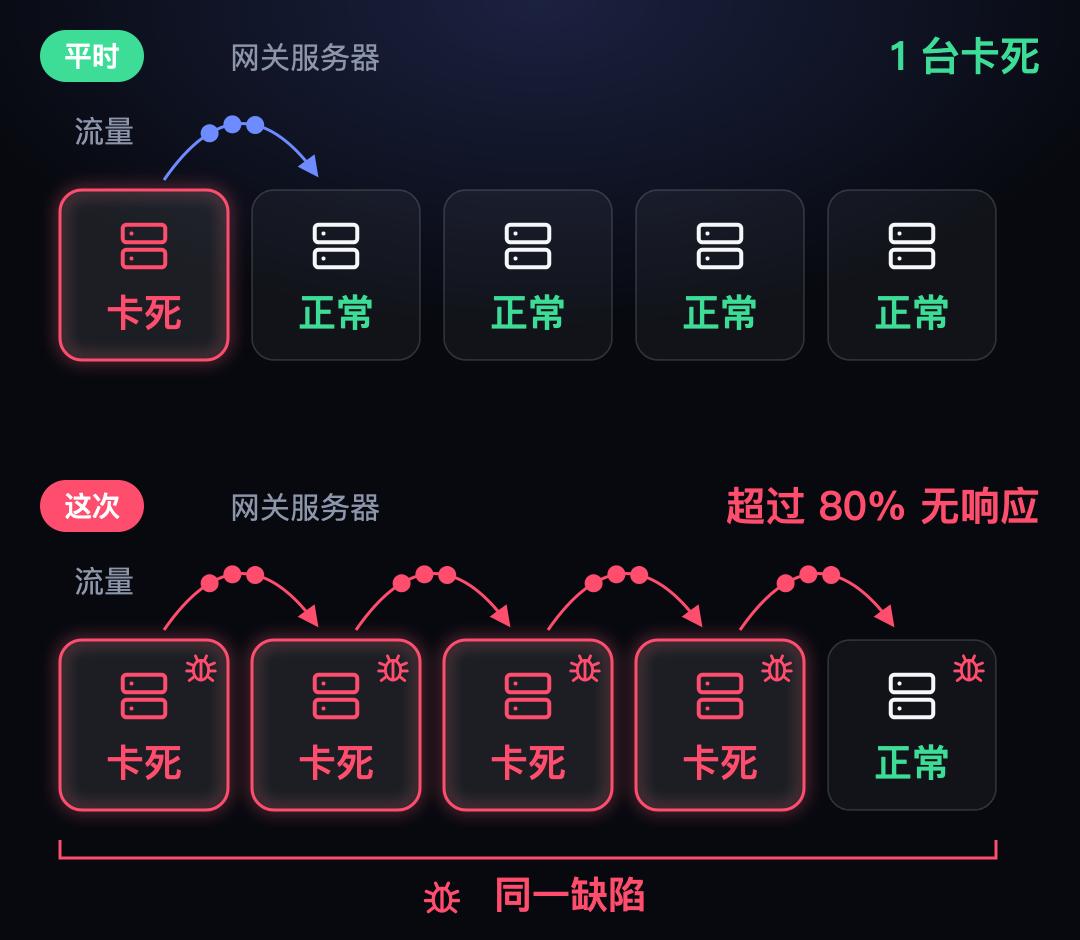
Daher wurden die verbleibenden Server im primären Gateway immer ausgelasteter, lösten schließlich die Sperrkonkurrenz aus und fielen nacheinander aus.
Dann hat der Schutzmechanismus von Microsoft das Problem noch verschlimmert:
Wenn ein Server ausfiel, verschob das System automatisch seine Nutzer auf andere noch funktionierende Server im primären Gateway. Aber da alle Server das gleiche Problem hatten, fiel jeder Server, zu dem der Datenverkehr umgeleitet wurde, sofort ebenfalls aus.
Innerhalb von weniger als zwei Stunden waren mehr als 80 % der Server im primären Gateway ausgefallen.
Schlimmer noch: Eigentlich waren im Gateway Trennelemente eingerichtet, um zu verhindern, dass sich ein Fehler von einem Bereich auf andere ausbreitet. Aber diese Trennelemente haben aufgrund eines anderen Problems nicht funktioniert, sodass sich der Fehler bis auf die ganze Welt ausbreitete...
In diesem Moment erwiesen sich die zwei Sätze von Gateways als nützlich.
Dienste wie Teams, OneDrive und SharePoint wurden nacheinander auf das sekundäre Gateway umgestellt und konnten früh wiederhergestellt werden. Aber der E-Mail-Dienst war so umfangreich, dass das sekundäre Gateway die Last nicht tragen konnte, sodass er im primären Gateway verbleiben musste – deswegen war Outlook das am längsten ausgefallene Dienst.
Ehrlich gesagt, ich habe die Erklärung von Microsoft zu diesen kleinen Faktoren verstanden. Aber ich denke, dass es noch einen größten Faktor gibt, den sie nicht erwähnt haben...
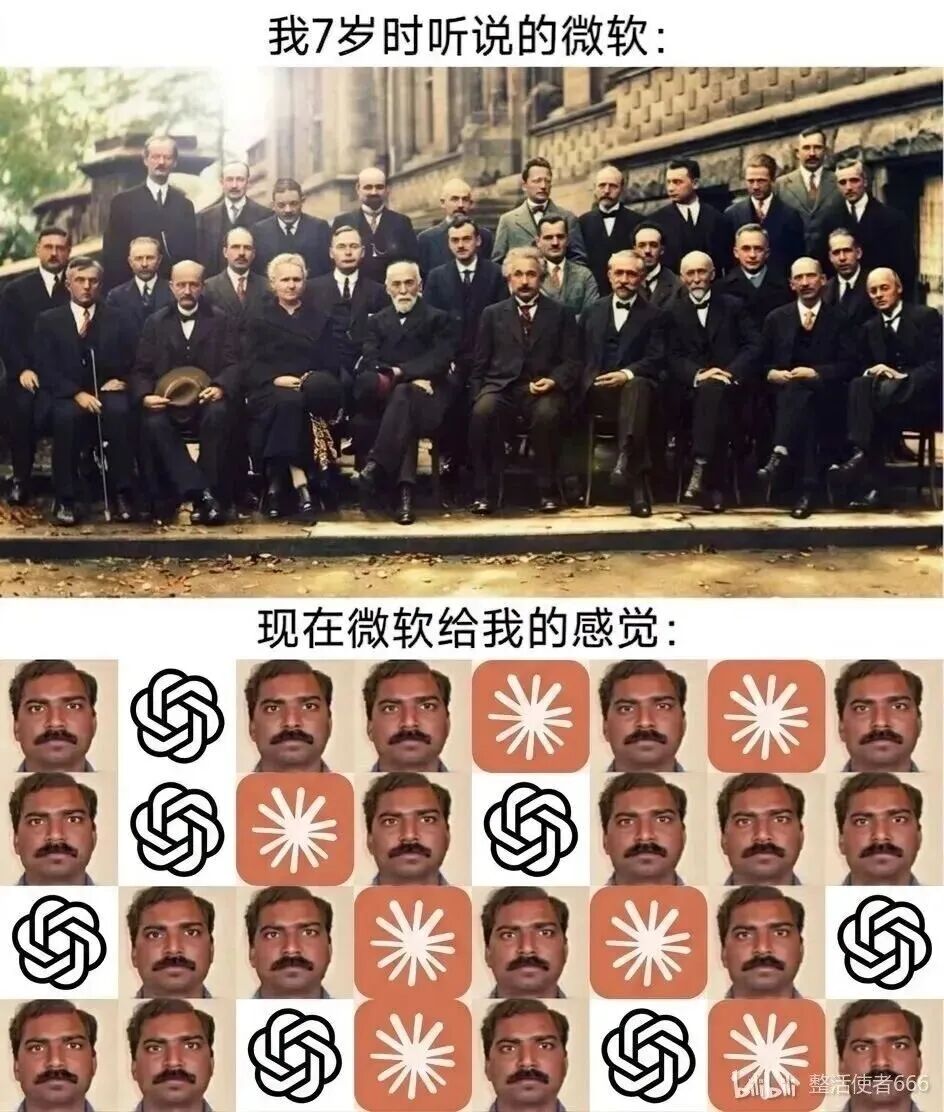
OK, die Geschichte ist noch nicht zu Ende.
Nachdem Microsoft das Problem erkannt hatte, begann es sofort, die Server neu zu starten. Aber direkt nach dem Neustart wurden die Server wieder von dem massiven aufgestauten Datenverkehr überlastet.
Also wurden die Nutzer immer wieder gequält: Einmal, zweimal, dreimal, viermal, nochmal von vorne.
Das erinnert mich an meine Kindheit, als es einen Stromausfall gab: Die Elektrizitätsbehörde hat alles repariert, aber sobald der Strom wieder da war, schalteten alle sofort ihre Klimaanlagen ein, sodass der Strom sofort wieder ausfiel.
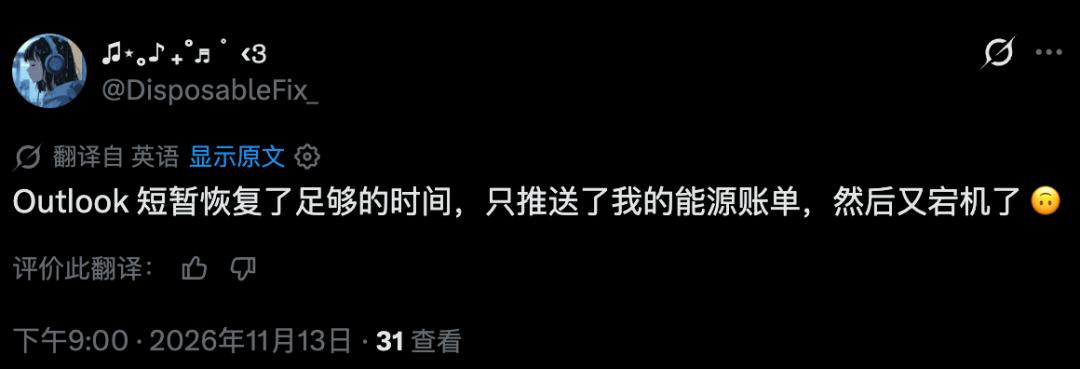
Da der Fehler bereits vor Monaten aufgetreten ist, war ein schnelles Zurückrollen nicht hilfreich. Schließlich konnte Microsoft nur den fehlerhaften Code auf die alte Version zurücksetzen und die Server schrittweise neu starten, um die Dienste langsam wiederherzustellen