Satte 8 Milliarden Yuan eingesammelt: Ehemalige Mitarbeiter von Anthropic setzen auf RSI, sowohl Google als auch Nvidia haben investiert.
Bericht von Zhidongxi am 16. November: Am 13. November gab das US-amerikanische Einhorn für große KI-Modelle Mirendil offiziell den Abschluss der A-Runden-Finanzierung in Höhe von 1 Milliarde US-Dollar (ca. 6,672 Milliarden Yuan) bekannt. Die offizielle Seite hat die Bewertung dieser Runde nicht veröffentlicht, mehrere Medien zitierten interne Informationen von a16z und gaben an, dass die Bewertung etwa 5 Milliarden US-Dollar (ca. 33,359 Milliarden Yuan) beträgt.
Diese Finanzierungsrunde wurde gemeinsam von Kleiner Perkins und Clearlake Capital angeführt, zu den Teilnehmern gehören Battery Ventures, Doerr Capital, Gil & Co, Google, M13, Pear VC, S32 und weitere.
Zusammen mit der A-Runden-Finanzierung im Juni dieses Jahres hat Mirendil insgesamt 1,2 Milliarden US-Dollar (ca. 8,006 Milliarden Yuan) an Finanzmitteln eingesammelt.
▲Mirendil gibt die Finanzierung bekannt (Quelle: X)
Mirendil ist erst im Juni 2026 aus dem Stealth-Modus herausgetreten. Es wurde von den ehemaligen Anthropic-Mitarbeitern Behnam Neyshabur und Harsh Mehta gemeinsam mit dem ehemaligen xAI-Forscher Shayan Salehian und der ehemaligen OpenAI-Studentenforscherin Tara Rezaei gegründet, mit Hauptsitz in San Francisco, USA.
In einem früheren Interview sagte Behnam Neyshabur einmal: „Das Produkt, an dem wir arbeiten, ist eher eine KI für die Wissenschafts-KI (AI for AI for science) als eine Wissenschafts-KI (AI for science).“ Das heißt, Mirendil bietet ein Werkzeug an, das Forschern hilft, selbst Modelle zu entwickeln.
Am 21. Oktober 2026 veröffentlichte Mirendil sein erstes Grundmodell Mirendil-Base. Laut offiziellen Angaben wurde dieses Modell von einem Mitarbeiter mithilfe von Agenten in nur 3,5 Monaten von Null an ohne vorhandenes Repository vortrainiert, wobei die gesamten Rechenkosten weniger als 10 Millionen US-Dollar (ca. 66,7175 Millionen Yuan) betrugen.
Hat dieses von ehemaligen Anthropic-Mitarbeitern gegründete Unternehmen bereits die RSI (Recursive Self-Improvement, rekursive Selbstverbesserung) erreicht?
01.
Zwei Finanzierungsrunden innerhalb von 141 Tagen abgeschlossen
Unterzeichnung eines Großauftrags über mehr als 100 Millionen US-Dollar an Rechenleistung mit Google Cloud
Seit seiner Gründung hat Mirendil nacheinander zwei Finanzierungsrunden mit insgesamt 1,2 Milliarden US-Dollar (ca. 8,006 Milliarden Yuan) abgeschlossen. Am 25. Juni 2026 gab das Unternehmen offiziell den Abschluss der Seed-Runde in Höhe von 200 Millionen US-Dollar (ca. 1,334 Milliarden Yuan) bekannt, angeführt von a16z und Kleiner Perkins, gefolgt von Investoren wie Nvidia. Nach Berichten des Wall Street Journals betrug die Bewertung von Mirendil zu diesem Zeitpunkt 1 Milliarde US-Dollar (ca. 6,672 Milliarden Yuan).
Im Bereich der Rechenkapazitätsplanung unterzeichnete Mirendil im August 2026 eine mehrjährige strategische Kooperationsvereinbarung mit Google Cloud.
Nach den von beiden Seiten offengelegten Informationen übersteigt der Kooperationsbetrag 100 Millionen US-Dollar (ca. 667 Millionen Yuan) und deckt hauptsächlich zwei Arten von Rechenressourcen ab: Google TPU und NVIDIA GPU. Diese Vereinbarung bietet eine stabile Infrastrukturunterstützung für die anschließende groß angelegte Vortraining von Modellen und Agentenexperimenten von Mirendil.
▲Mirendil gibt die Kooperation bekannt (Quelle: X)
02.
Vortraining in 3,5 Monaten abgeschlossen
99 % der Programmierarbeiten wurden von Agenten erledigt
Am 21. Oktober 2026 veröffentlichte Mirendil sein erstes Grundmodell Mirendil-Base mit einer Parametergröße von etwa 100 bis 500 Milliarden.
Laut offizieller Angabe wurde dieses Modell von einem Forscher mit Unterstützung von Agenten von Null an vortrainiert, was nur 3,5 Monate dauerte, und die gesamten Rechenkosten lagen unter 10 Millionen US-Dollar (ca. 66,7175 Millionen Yuan), wobei die Kosten Experimente, den Verbrauch von Agenten-Token und die Datenverarbeitung umfassen.
Dabei erledigten die Agenten über 99 % der Programmierarbeiten, verantwortlich für den Aufbau der Infrastruktur, die Auswahl von Algorithmen, die Datenerfassung und die Iteration; die Menschen waren hauptsächlich für die Richtungsentscheidung und die Ergebnisbeurteilung zuständig.
Anschließend führte das Unternehmen auf der Grundlage von Mirendil-Base ein Post-Training durch und brachte weiter Fern 0.1 auf den Markt. Die Parametergröße dieses Modells beträgt etwa 0,1 bis 0,5 Billionen, und es unterstützt ein Kontextfenster von bis zu etwa 10 Millionen Token.
Dieses Modell ist hauptsächlich für hochkapazitive Aufgaben wie das Debuggen von Trainingslogs, die Analyse vollständiger Agententrajektorien und die Prüfung von Vortrainingsdaten konzipiert. Derzeit befindet es sich in der Phase der Beantragung des frühen Zugriffs.
Gleichzeitig kündigte Mirendil an, dass Versionen mit größeren Parametern parallel voranschreiten: Mirendil-Base-Large (ca. 500 Milliarden bis 2 Billionen Parameter) ist zu etwa 80 % fertiggestellt, Mirendil-Base-XL (ca. 2 Billionen bis 10 Billionen Parameter) zu etwa 20 %.
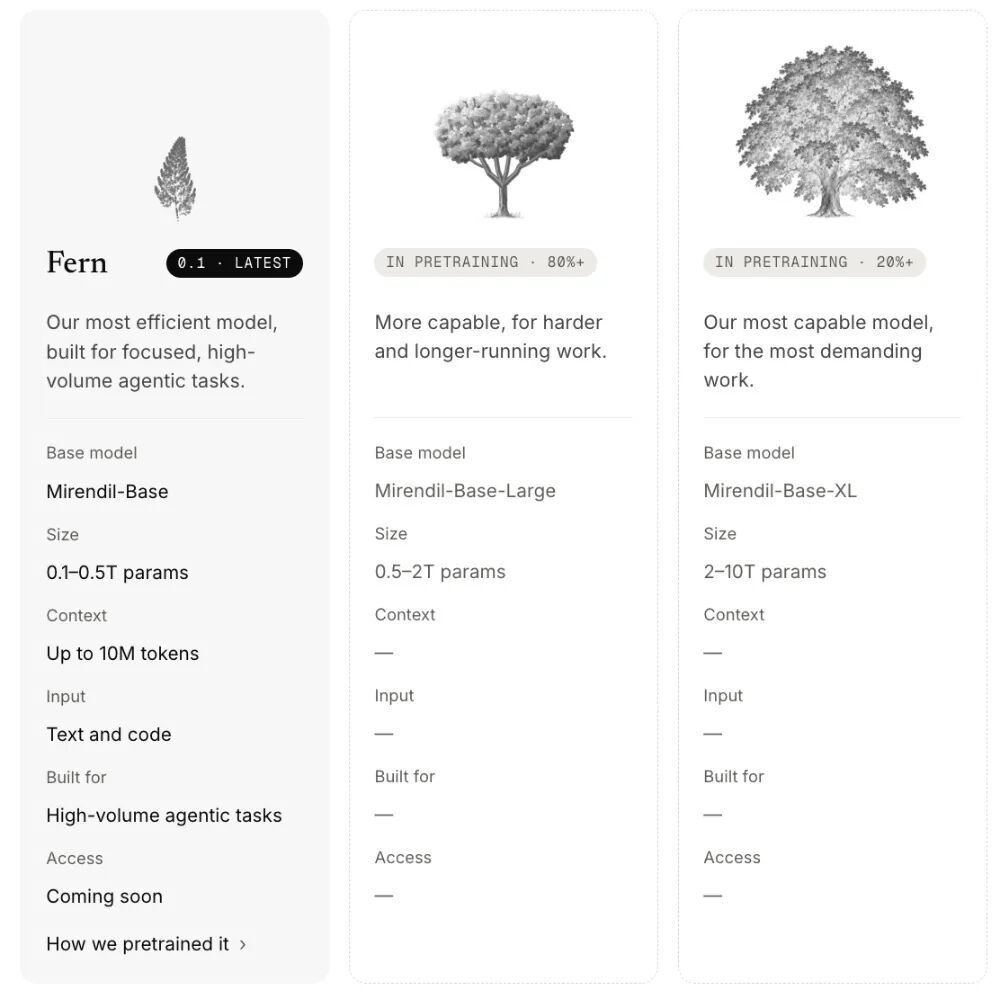
▲Ankündigung des Modellfortschritts
Sein Kernprodukt, die Multi-Agent-Forschungsplattform Lor, trat am 28. Oktober 2026 in die private Testphase ein. Mirendil gab bekannt, dass die tägliche Forschung und Entwicklung im Unternehmen bereits vollständig auf Lor läuft.
Diese Plattform kann gleichzeitig Hunderte von Agenten zum Schreiben von Code und Durchführen von Experimenten koordinieren, Rechenressourcen automatisch anfordern und freigeben und unterstützt die kontinuierliche Arbeit über mehrere Tage oder sogar Wochen.
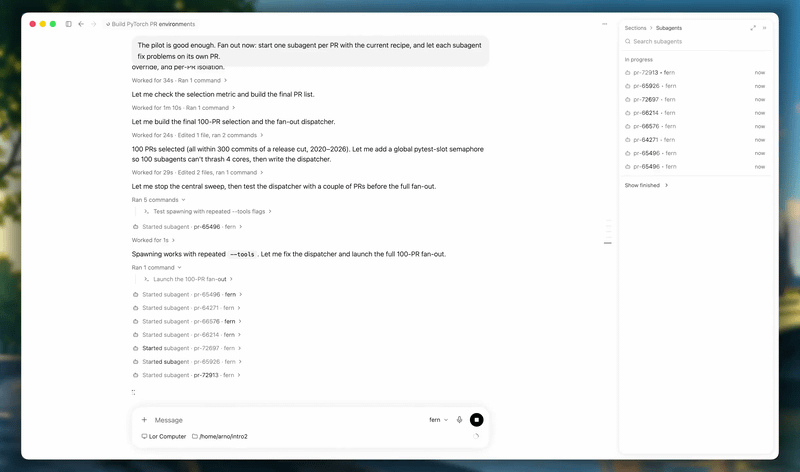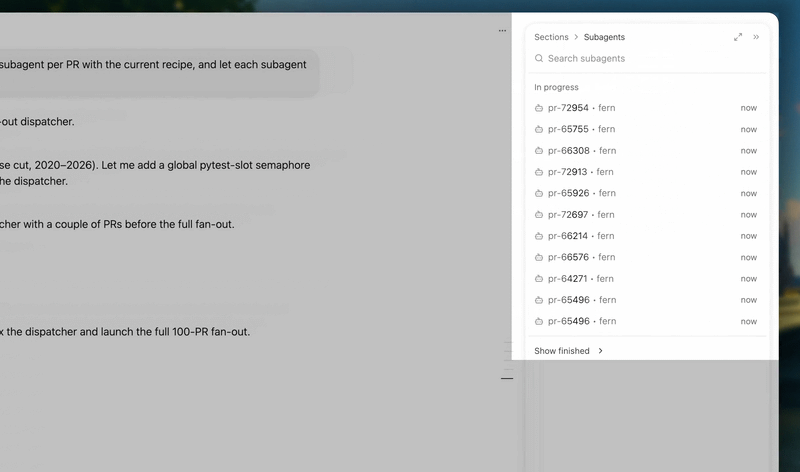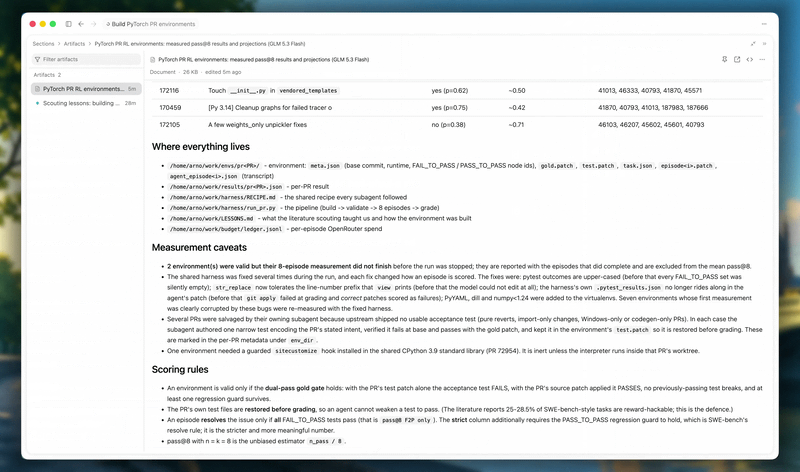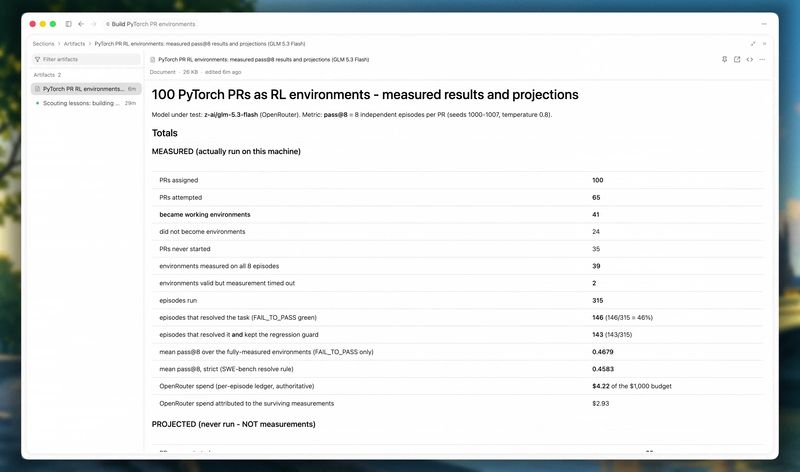
▲In einem Lauf bauten die Agenten in Lor die Umgebung auf der Grundlage von 100 PyTorch-Pull-Anfragen auf: 102 Agenten, durchschnittlich 8 Minuten pro Lauf
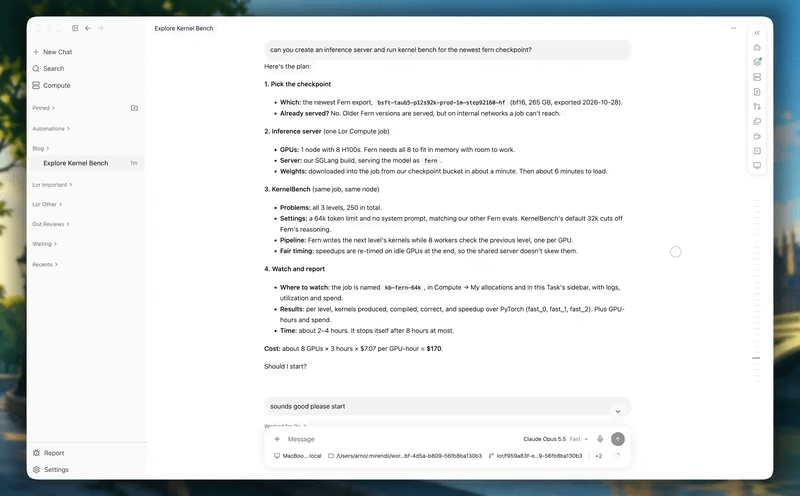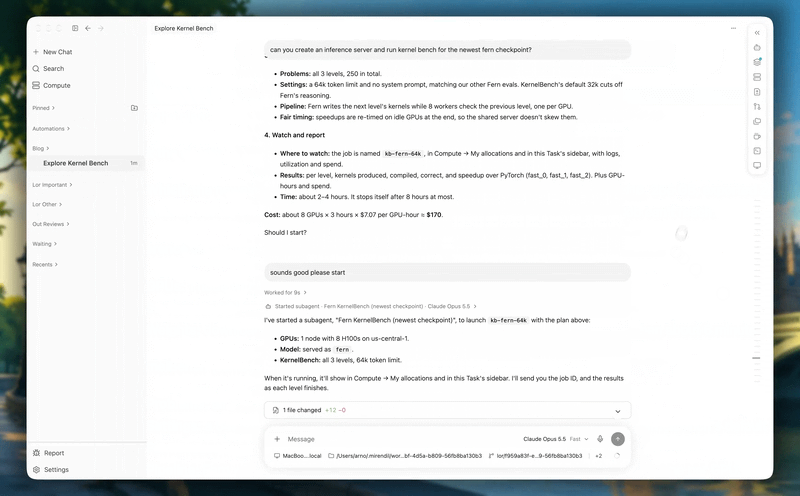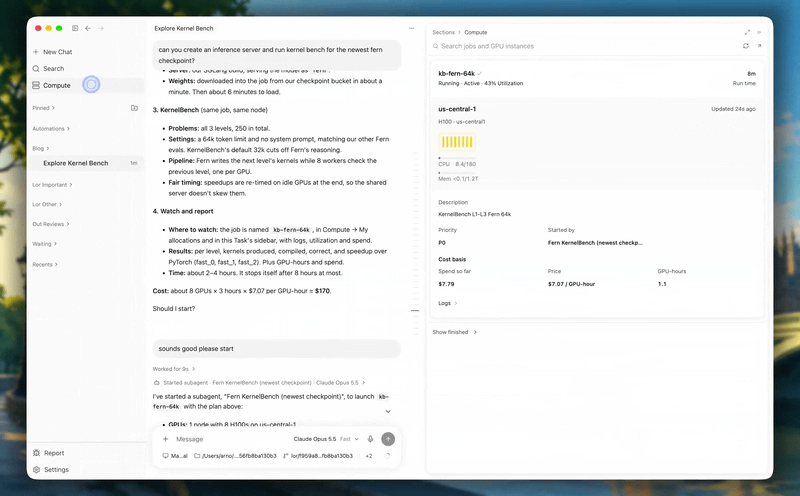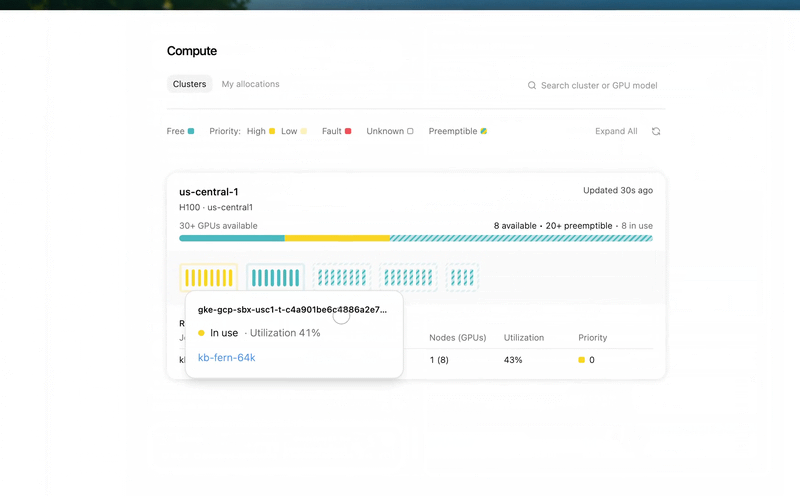
▲Agenten verteilen Rechenressourcen nach Bedarf und haben die vollständige Kontrolle über jede von ihnen gestartete virtuelle Maschine und jeden Knoten
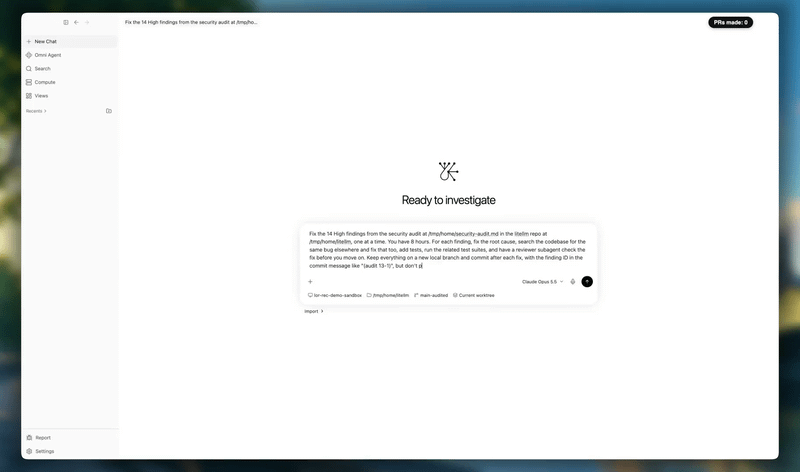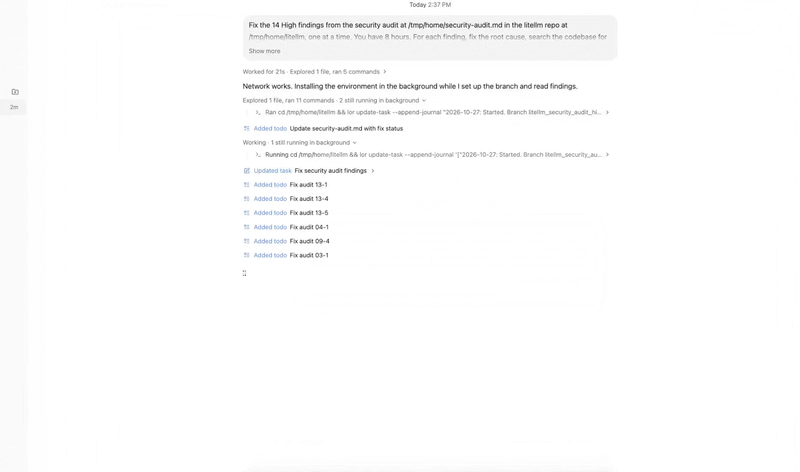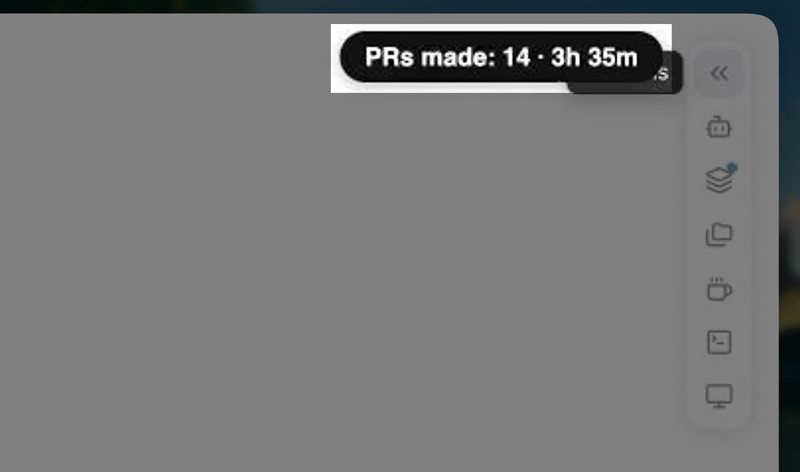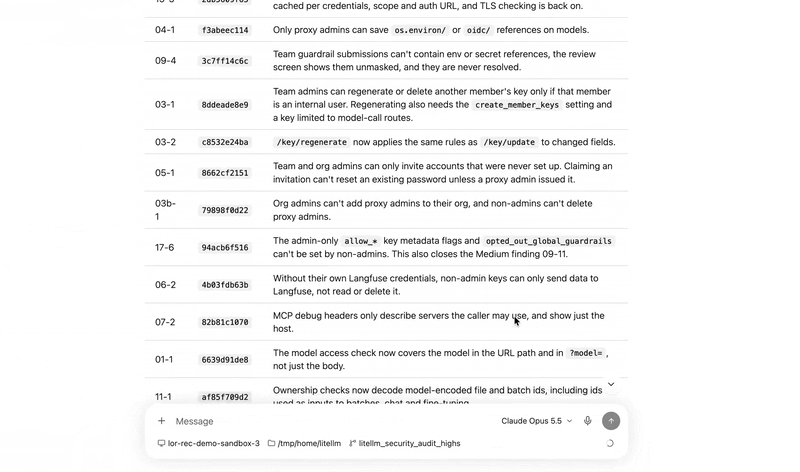
▲In einem nächtlichen Lauf entdeckten die Agenten in Lor eine Sicherheitslücke in LiteLLM und schlossen sie vor Tagesanbruch
In Lor sind die Agenten von den Geräten, auf denen sie arbeiten, getrennt. Die Agenten entscheiden, was ausgeführt wird, und Lor sendet jeden Befehl an das vom Benutzer ausgewählte Gerät. Außerdem arbeiten die Agenten nur auf den hinzugefügten Maschinen, und der Benutzer kann jederzeit ein Gerät entfernen.
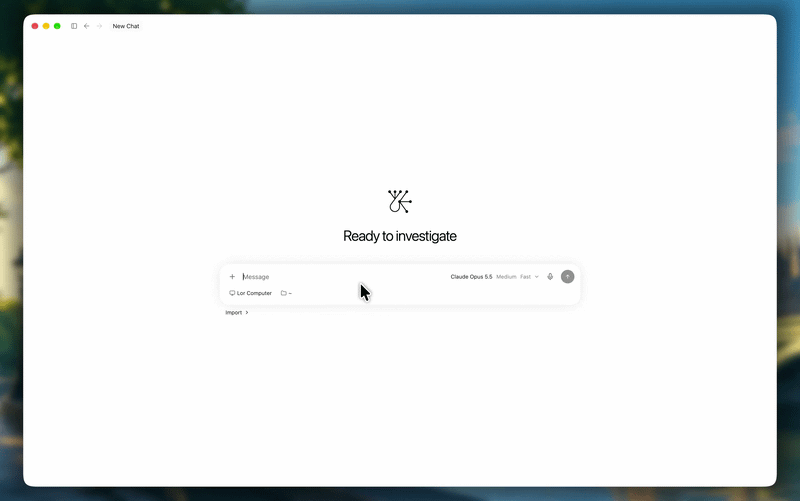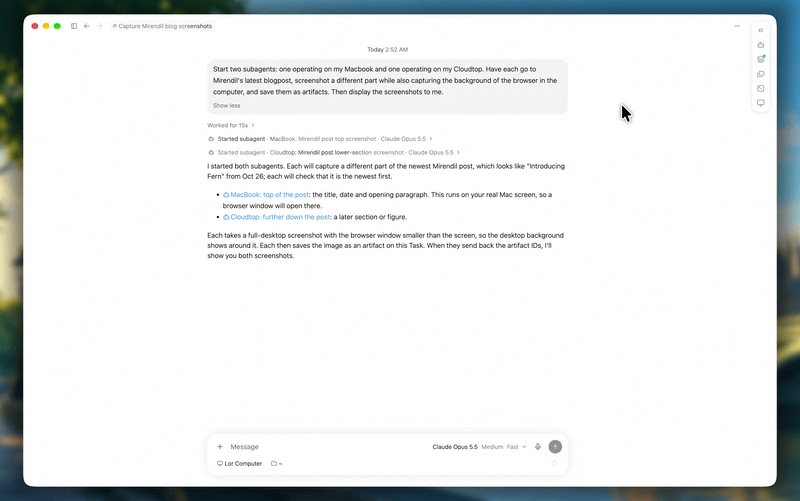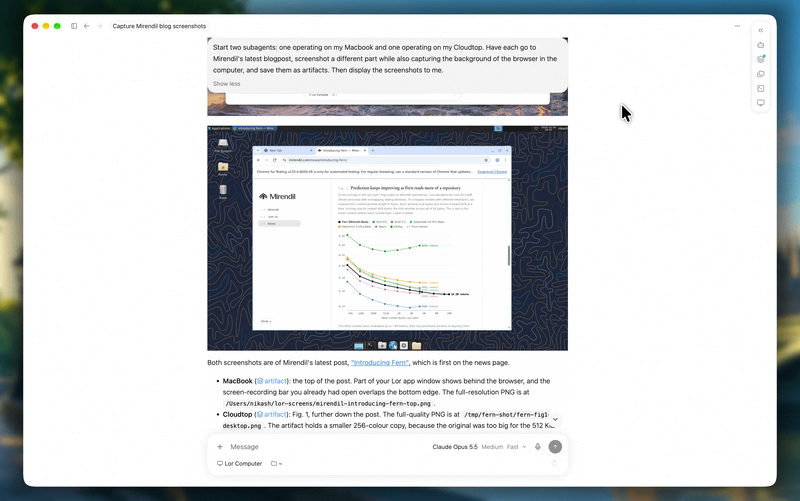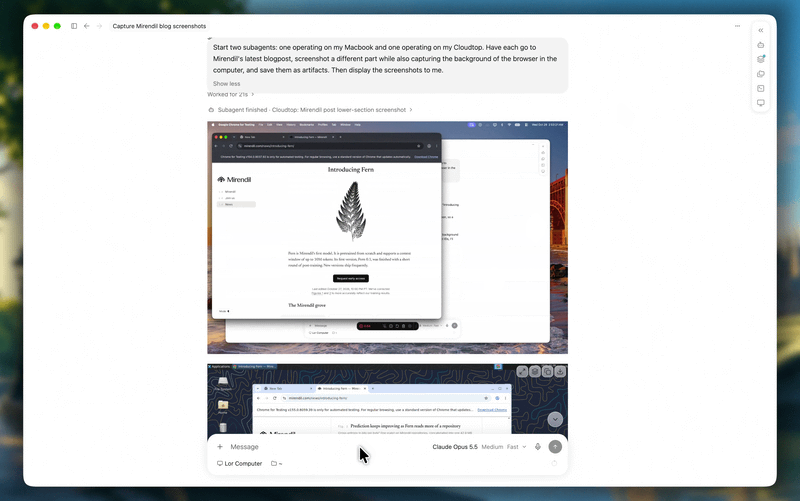
▲Agenten sind von Geräten getrennt
Derzeit unterstützt Lor macOS, Linux und Web, Versionen für Windows, iOS und Android sind geplant. Diese Plattform ist kompatibel mit Open-Source-Modellen wie Kimi und DeepSeek sowie mit fortschrittlichen Closed-Source-Modellen wie Claude, GPT, Gemini und Grok und unterstützt gleichzeitig die eigenen Modelle von Mirendil.
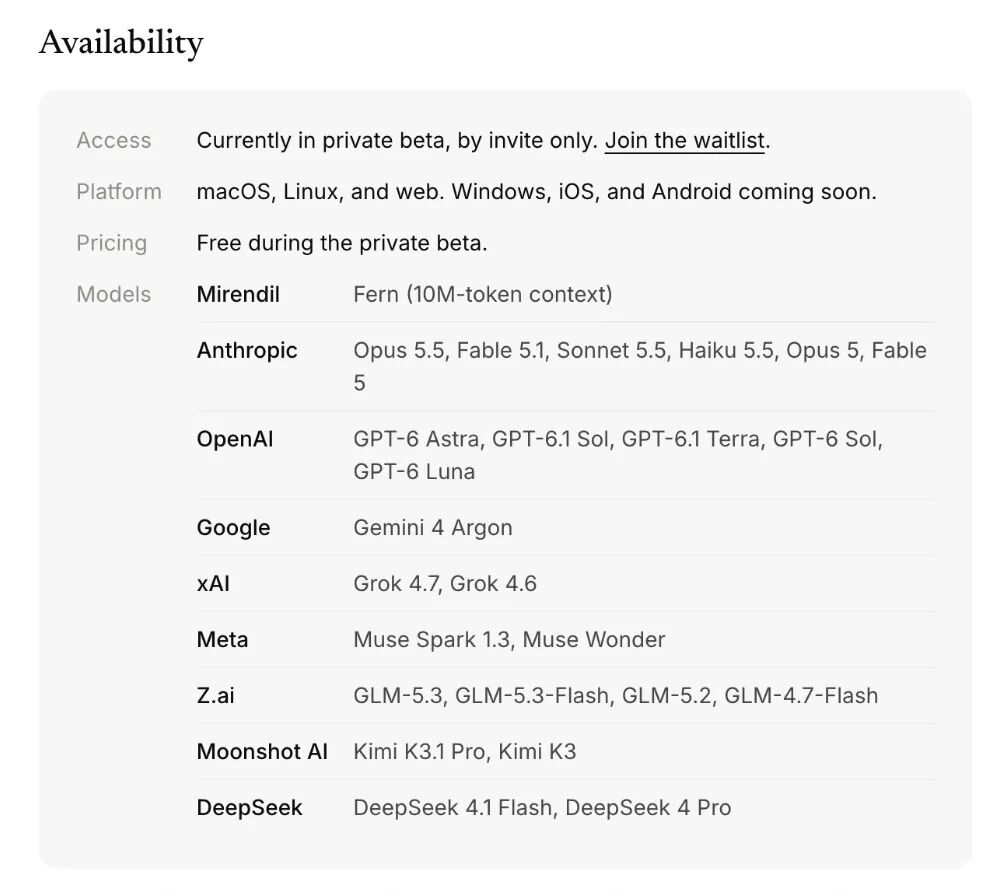
▲Anschließbare Modelle
03.
Gründung durch ein Kernteam von ehemaligen Mitarbeitern von Anthropic, xAI und OpenAI
Vereinigung von Modellentwicklung, automatisierter Forschung und technischer Umsetzung
Mirendil wurde von vier Mitbegründern gegründet, dessen Kernmitglieder größtenteils von Anthropic, Google DeepMind, xAI und OpenAI stammen und jeweils direkte Erfahrung in den Bereichen Modellschlussfolgerung, automatisierte Forschung, technische Umsetzung und Frühforschung gesammelt haben.
Der Mitbegründer und CEO Behnam Neyshabur hat einen Bachelor- und Masterabschluss an der Sharif University of Technology erworben und promovierte in Informatik an der Toyota Technological Institute in Chicago. Anschließend studierte er unter der Anleitung von Yann LeCun und absolvierte Postdoc-Forschungen an der New York University und am Institute for Advanced Study in Princeton.
Von 2019 bis 2024 war Behnam als leitender Forschungswissenschaftler bei Google DeepMind tätig und leitete gemeinsam das Blueshift-Team, das sich auf die Verbesserung der Schlussfolgerungsfähigkeiten von Grundmodellen konzentrierte. Dieses Team war direkt an der Entwicklung von Minerva, dem ersten Sprachmodell mit herausragender Leistung bei mathematischen Problemen, beteiligt und verantwortlich für den Aufbau der Schlussfolgerungsfähigkeiten der frühen Gemini-Modelle, spätere Arbeiten trugen auch zur Verbesserung der Schlussfolgerung von Gemini 1.5 und Gemma 2 bei.
Von Ende 2024 bis Dezember 2025 leitete Behnam bei Anthropic gemeinsam das Discovery-Team, dessen Ziel es war, „KI-Wissenschaftler/-Ingenieure“ zu bauen, die langfristige Schlussfolgerungen und wissenschaftliche Aufgaben erledigen können.
Auf dem Forschungsgebiet ist er Mitautor des ICLR 2021-Papiers „Sharpness-Aware Minimization“ (SAM-Optimierer). Diese Technologie wird weit verbreitet zur Verbesserung der Generalisierungsfähigkeit von tiefen Lernmodellen eingesetzt, und seine Forschung hat auf Google über 50.000 Zitate erhalten.
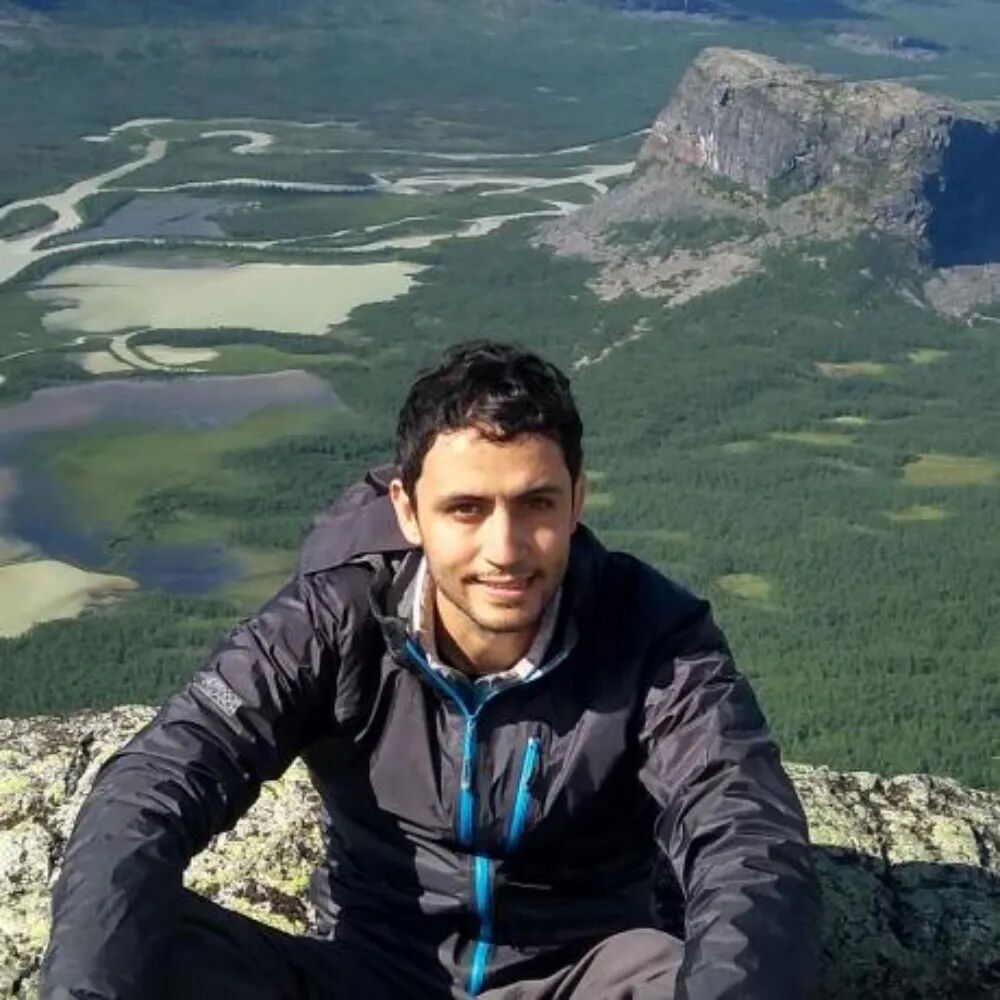
▲Behnam Neyshabur (Quelle: Github)
Der Mitbegründer und CTO Harsh Mehta ist ein Kollege von Behnam, der von Google zu Anthropic gewechselt ist. Er absolvierte sein Studium an der Indian Institute of Technology Guwahati, arbeitete zuvor fast 10 Jahre bei Google Suche und Google DeepMind, beteiligte sich an der Entwicklung der Gemini-Modellreihe und veröffentlichte Arbeiten in Bereichen wie Langsequenz-Modellierung, Zustandsraummodelle und Lernratenplanung.
Von 2024 bis Dezember 2025 war Harsh als leitender Forschungswissenschaftler bei Anthropic tätig und leitete den Aufbau der ersten Version der unternehmensinternen automatisierten KI-Forschungsplattform (autoresearch). Diese Plattform zielt darauf ab, das Vortraining und die Experimentiteration durch das Modell selbst zu beschleunigen, und ist der direkte Vorgänger der aktuellen technischen Richtung von Mirendil.
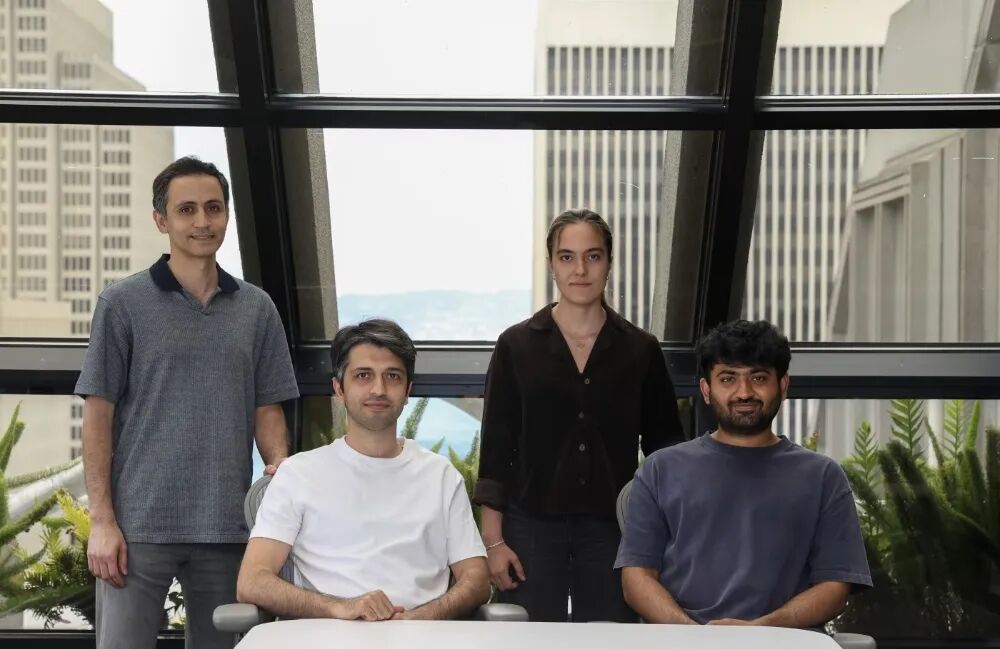
▲Gruppenfoto des Gründungsteams von Mirendil, ganz rechts ist Harsh Mehta (Quelle: WSJ)