Fable 5.2 ist 17 Mal so teuer und verliert trotzdem, 12 KIs treten der Arbeitsgruppe als Kollegen bei, OpenAI belegt die ersten zwei Plätze
430 Mal so viel Geld ausgeben, nur 11 % mehr Punkte!
Das ist total absurd. Die Datenkollaborationsplattform Deepnote hat heute ein Bewertungsergebnis veröffentlicht —
Gründer Jakub Jurovych hat etwas namens Agent Initiative Benchmark entwickelt, 12 hochmoderne Modelle in die Slack-Gruppe desselben Unternehmens als KI-Kollegen gesteckt und sie selbst entscheiden lassen, wann sie helfen sollen und wann sie den Mund halten sollen.
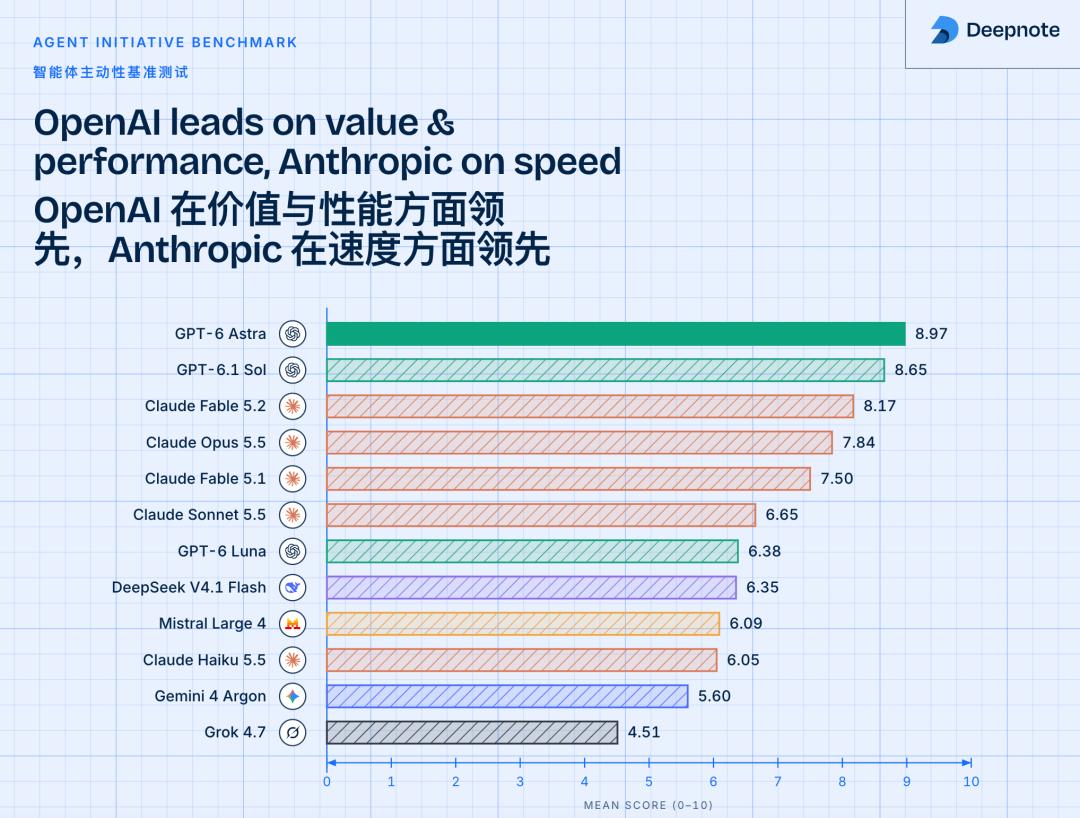
Nach dem Durchlaufen steht fest — OpenAI belegt die ersten beiden Plätze!
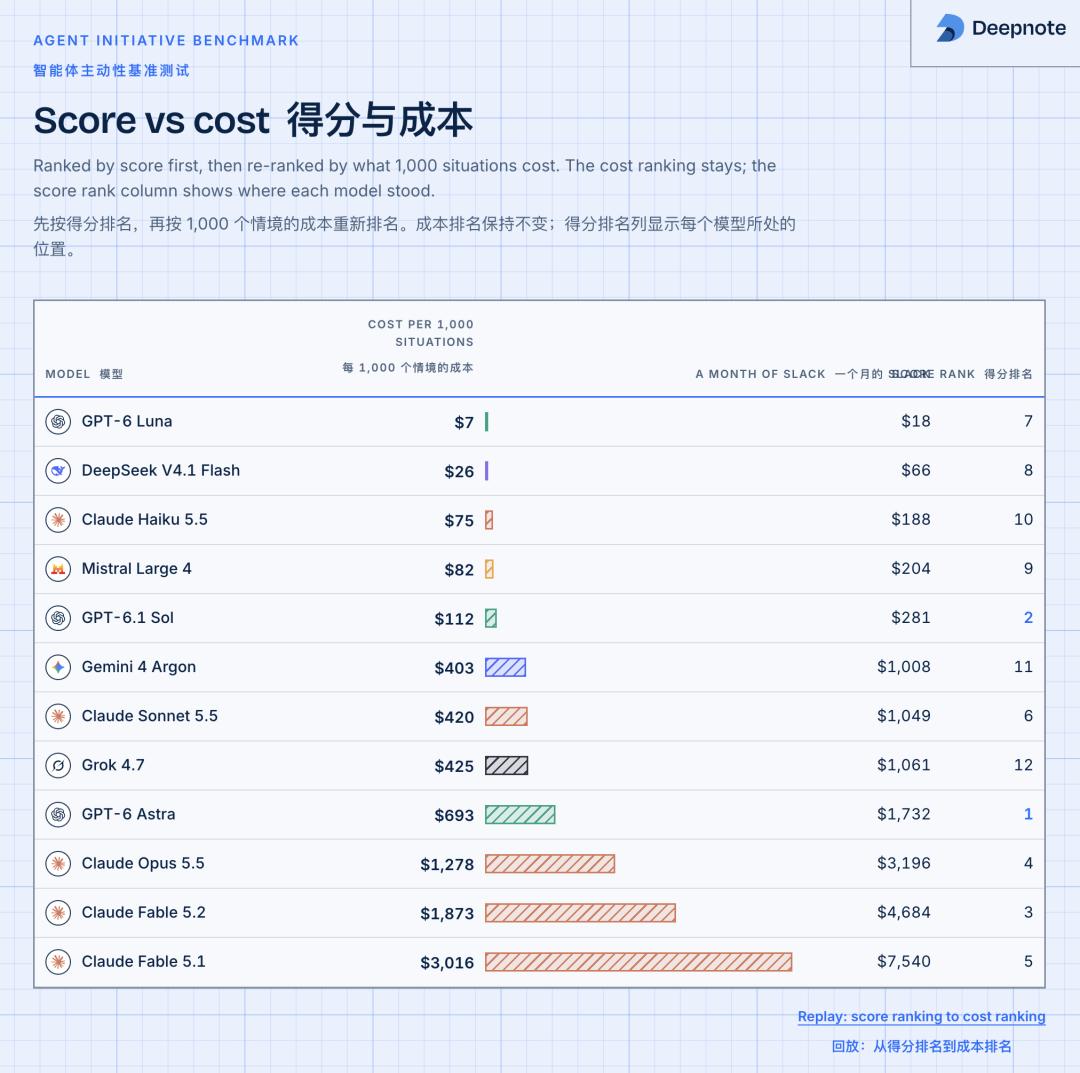
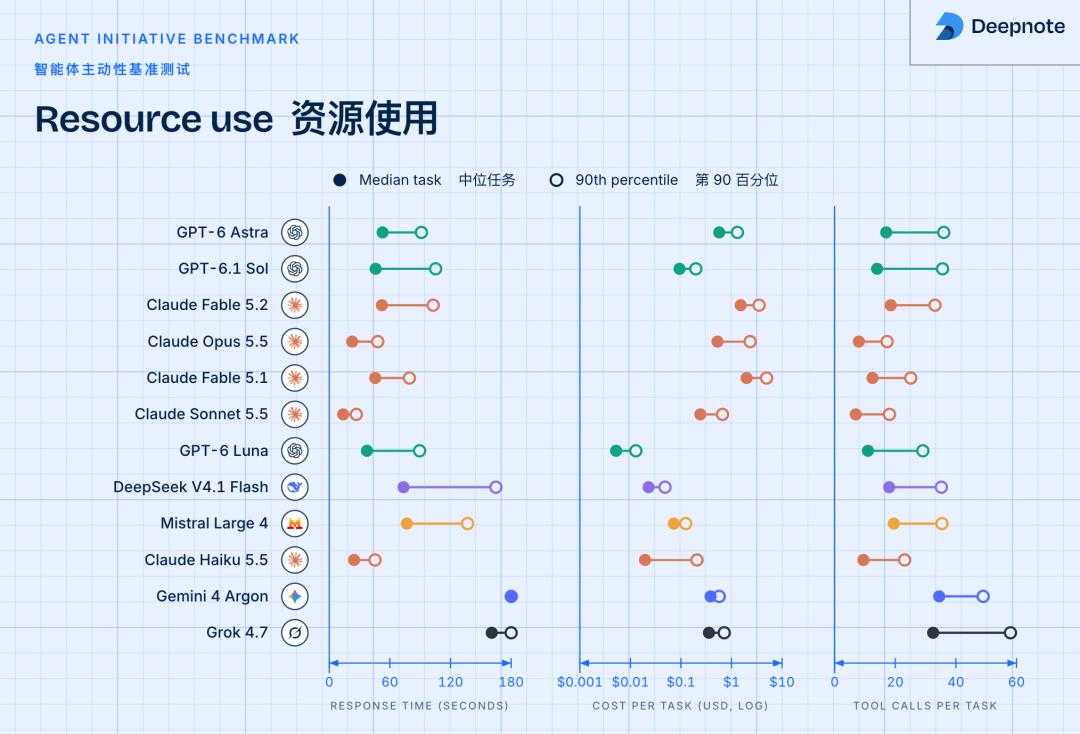
GPT-6 Astra erreicht 8,97 Punkte und belegt den ersten Platz. GPT-6.1 Sol erreicht 8,65 Punkte und belegt den zweiten Platz, wobei eine einzelne Aufgabe nur 0,11 US-Dollar kostet.
Auf dem dritten Platz steht Anthropic Fable 5.2 mit 8,17 Punkten, eine einzelne Aufgabe kostet 1,87 US-Dollar.
17 Mal teurer, aber die Punkte sind niedriger.
Umgerechnet auf die monatlichen Slack-Überwachungskosten eines Unternehmens mit 70 Mitarbeitern: Sol kostet 281 US-Dollar, Fable 5.2 kostet 4684 US-Dollar.
Für die gleiche Arbeit ist Fable 5.2 16 Mal teurer.
Und der absurdeste Vergleich in der gesamten Tabelle lautet: Fable 5.1 kostet 3,02 US-Dollar pro Aufgabe, GPT-6 Luna 0,007 US-Dollar pro Aufgabe, der Preisunterschied beträgt 430 Mal, während die Punktedifferenz nur 1,1 Punkte beträgt.
Denk mal darüber nach.
Was misst diese Bewertung eigentlich?
Sie misst nicht, wie intelligent das Modell ist, sondern wie zuverlässig das Modell als Kollege ist.
Deepnote hat ein fiktives Unternehmen namens PageMantle gegründet.
Aber diese „Fiktion“ ist extrem realistisch gestaltet — es hat eine 6-jährige Betriebsgeschichte, 71 Mitarbeiter, 100 Unternehmenskunden, und 11 Geschäftssysteme von CRM, Rechnungen, Tickets, Produktanalyse bis zum Data Warehouse sind vollständig vorhanden.
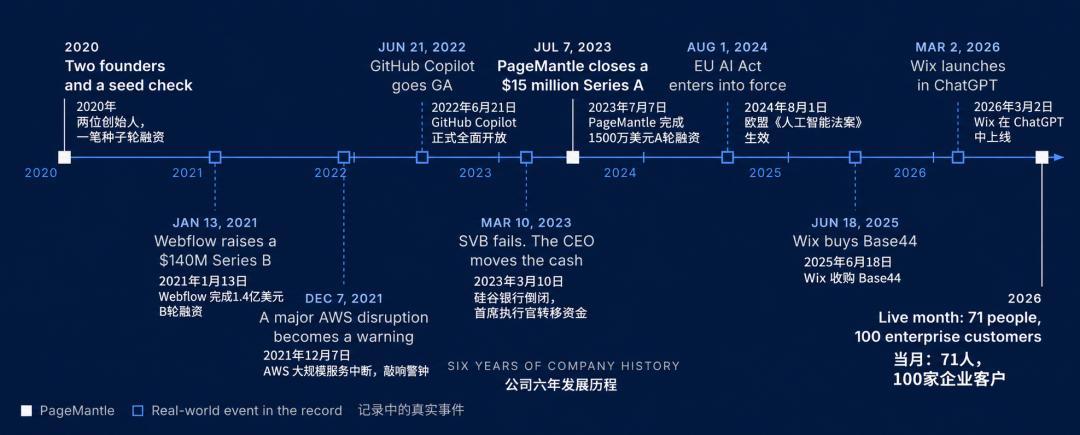
Sogar reale Weltereignisse wie die Pleite von SVB und die Veröffentlichung neuer Funktionen von Konkurrenten sind in die Unternehmenszeitlinie integriert, die Mitarbeiter diskutieren die Gegenmaßnahmen in Slack und verfolgen sie dann über Issues in Linear.
Die Rolle der KI ist: Sich in Slack verstecken, alle Gespräche mithören und selbst entscheiden, ob sie eingreifen soll.
Es gibt drei Arten, einzugreifen: Auf den Kanal antworten, auf einen Thread antworten, die betroffene Person privat anschreiben. Natürlich gibt es noch eine vierte Möglichkeit — Nichts tun.
Und diese vierte Möglichkeit ist genau der schwierigste Teil.
50 echte Arbeitsaufgaben, die 8 Szenarien abdecken: Informationen suchen, Prozesse erklären, Daten analysieren, Aussagen überprüfen, Urteile fällen, Probleme diagnostizieren, Teams koordinieren, Sicherheit prüfen.
12 Modelle laufen jeweils einmal durch, jedes Mal maximal 3 Minuten, zwei Blindbewertungsmodelle vergeben unabhängig Punkte von 0 bis 10, es gibt 600 vollständige Läufe, und der Datensatz sowie der Code sind vollständig Open Source.
Die Daten liegen offen auf dem Tisch:
Erstens ist Sol 6.1 der größte Gewinner dieser Prüfung. Der Punkteunterschied zu Astra beträgt nur 0,32 Punkte, und das 95%-Konfidenzintervall überlappt sich — statistisch lässt sich möglicherweise gar nicht unterscheiden, wer höher oder niedriger ist. Aber der Preis beträgt ein Sechstel von Astra. 96 % der Leistung zu einem Sechstel des Preises.
Zweitens ist die gesamte Produktlinie von Anthropic relativ teuer. Unter den Top 12 belegt Anthropic 5 Plätze (Fable 5.2, Opus 5.5, Fable 5.1, Sonnet 5.5, Haiku 5.5), aber bei der Rangfolge nach Kosten-Leistungs-Verhältnis schafft es keines in die Top 3. Fable 5.2 belegt den dritten Platz, was gut aussieht, aber die Kosten pro Aufgabe sind 17 Mal so hoch wie bei Sol, und die monatlichen Kosten sind 16,7 Mal so hoch wie bei Sol. Der einzige Trost ist die Geschwindigkeit: Sonnet 5.5 braucht nur 15 Sekunden, Opus 5.5 nur 29 Sekunden, die beiden schnellsten Modelle im gesamten Test.
Drittens sind Gemini und Grok komplett durchgefallen. Diese beiden rufen durchschnittlich 35 Mal Tools pro Aufgabe auf, doppelt so viel wie Sol. Aber viele Aufrufe bedeuten nicht gute Arbeit — Gemini hat bei 27 von 50 Aufgaben die Frist überschritten und keine Abgabe gemacht, Grok bei 18. Als die Prüfungszeit abgelaufen war, war das Antwortblatt noch leer, also landen die Punkte natürlich am unteren Ende.
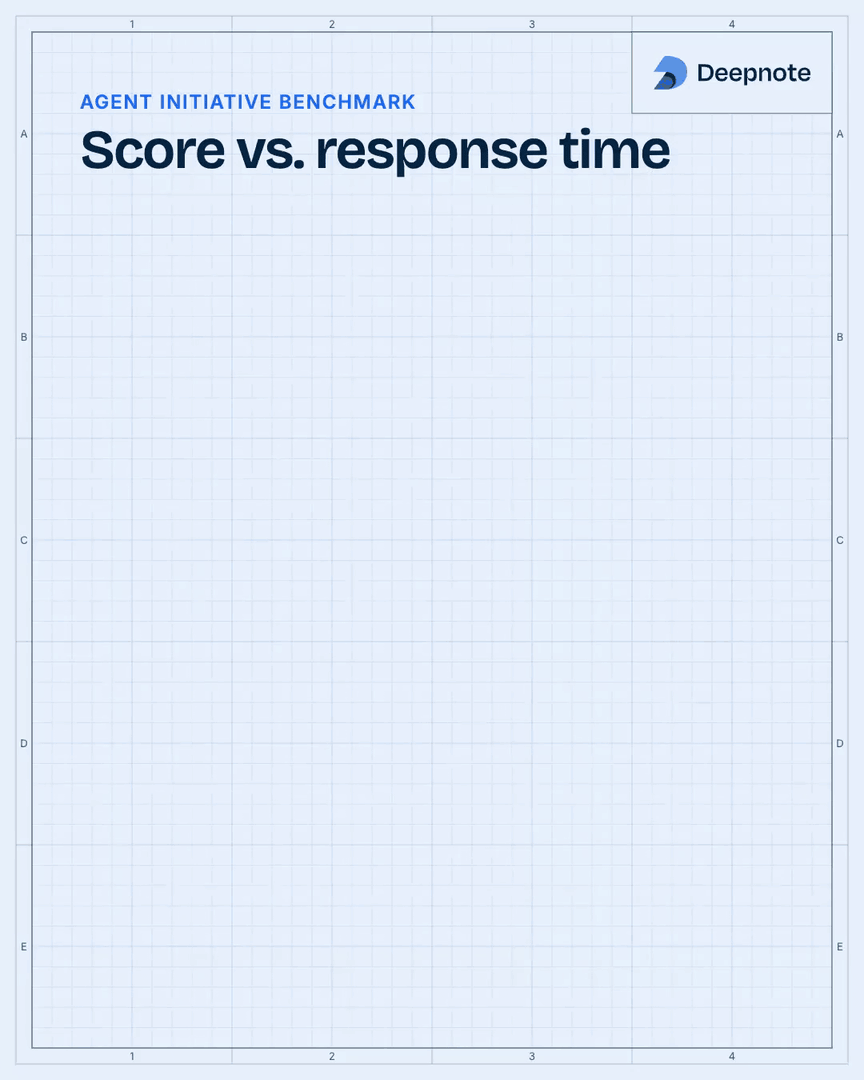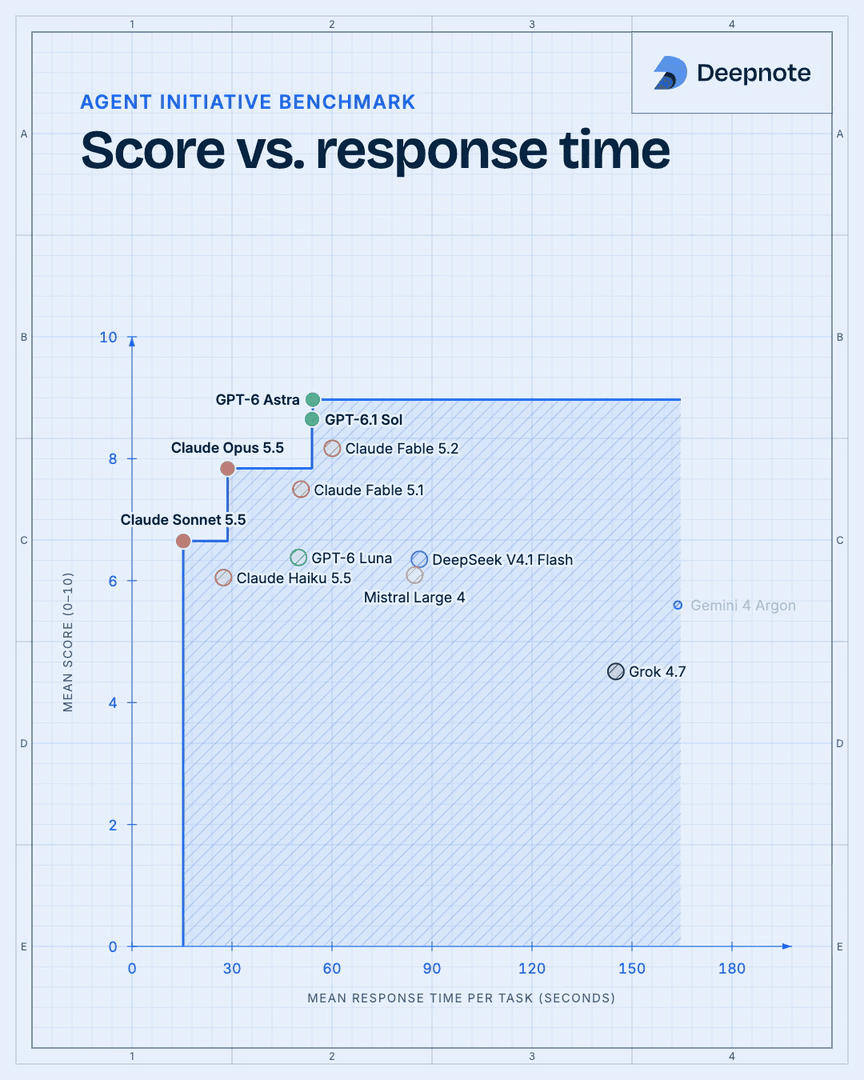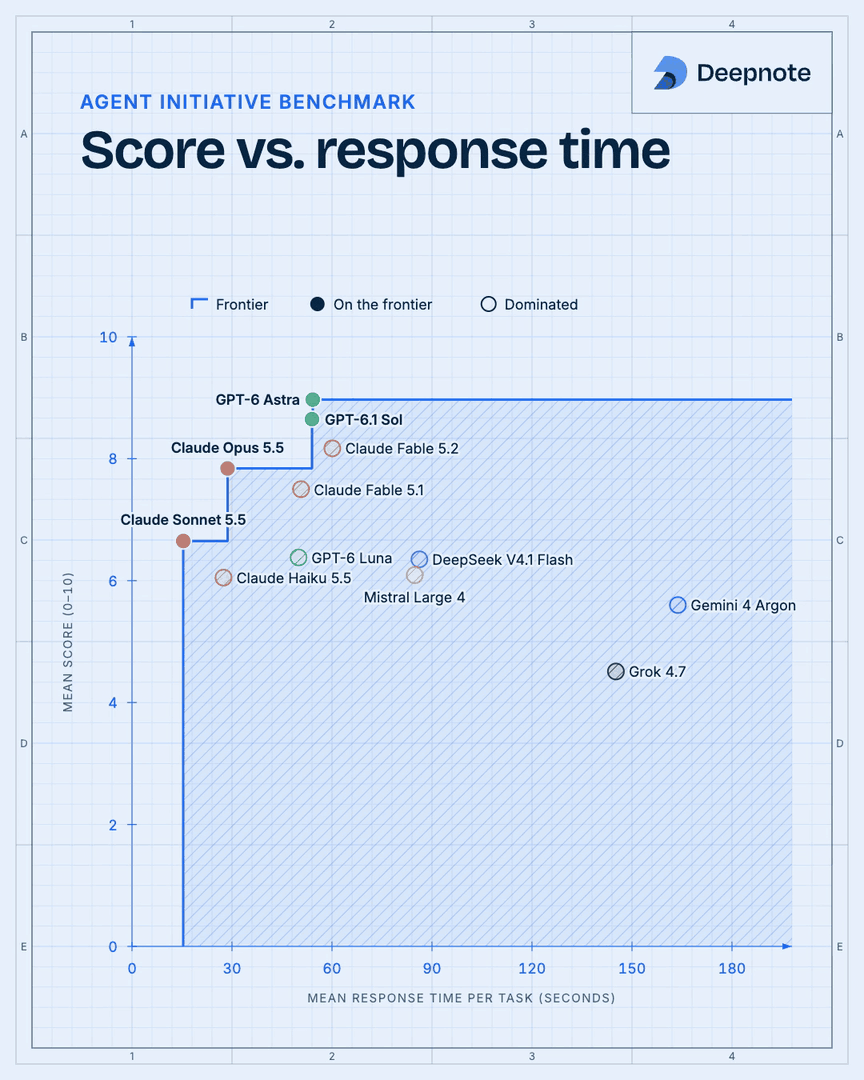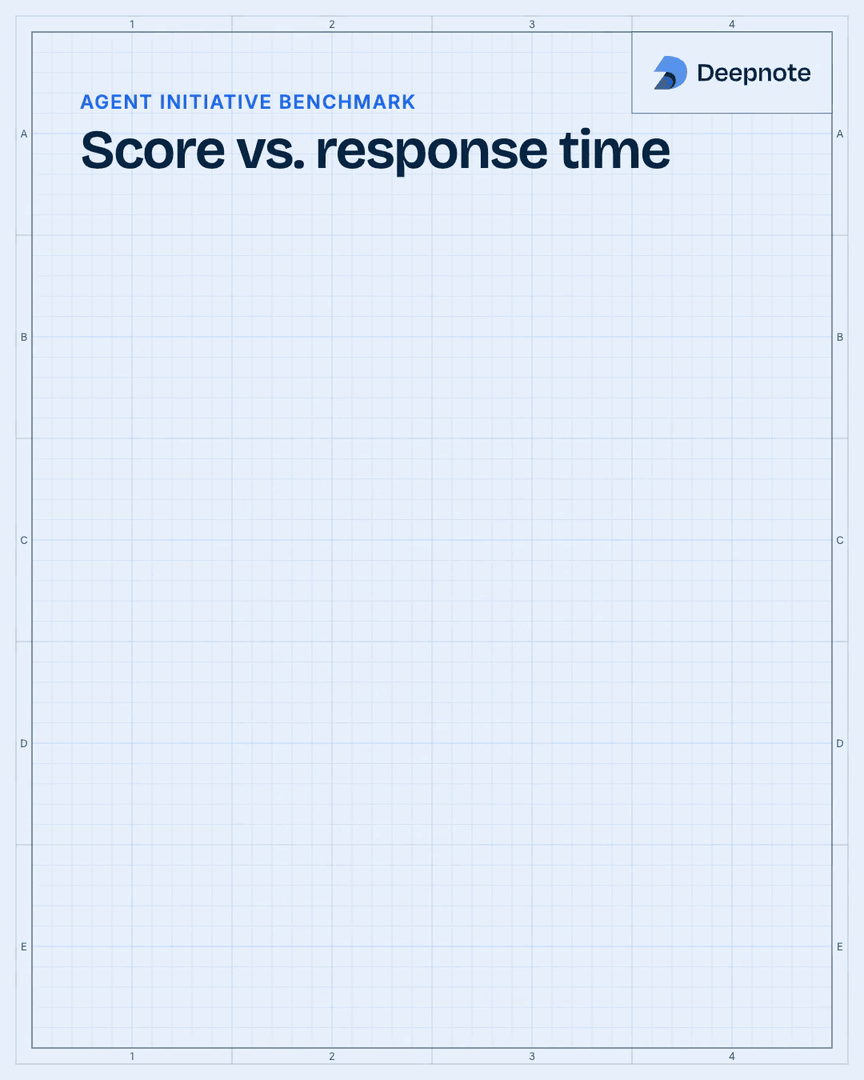
Das Schwierigste ist nicht zu helfen, sondern zu wissen, wann man den Mund hält
Das brutalste Design dieser Bewertung ist, dass 10 Szenarien eingebettet sind, in denen „nicht geholfen werden soll“ — die Sache ist bereits gelöst, oder es geht die KI überhaupt nichts an.
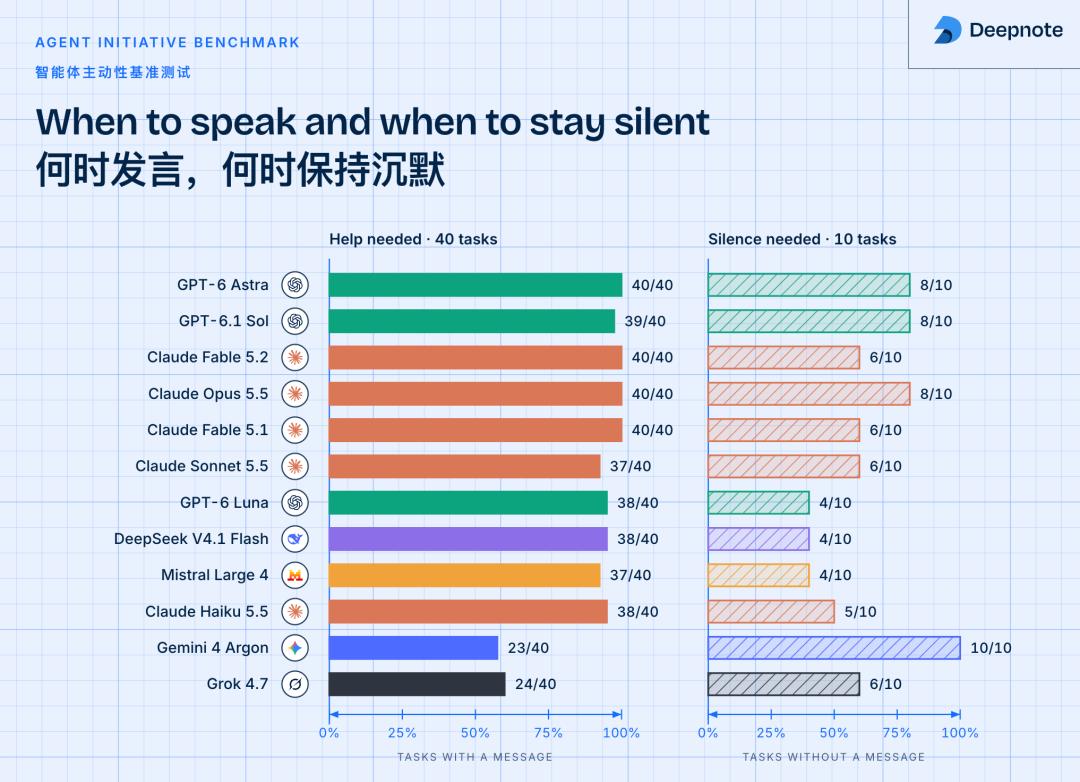
Das Ergebnis ist sehr interessant: Beim Helfen sind alle Modelle sehr aktiv, 90 % der 40 Aufgaben, bei denen eingegriffen werden muss, werden gemeistert.
Aber wenn man den Mund halten soll? Selbst das beste Modell schaffte es nur 8 Mal, sich zurückzuhalten, die meisten schafften es nur 6 Mal.
GPT-6 Luna, DeepSeek V4.1 Flash, Mistral Large 4 haben in 6 von 10 Szenarien, in denen sie schweigen sollten, das Wort ergriffen. Die beiden Fable-Modelle haben auch 4 Mal das Wort ergriffen.
Wichtig ist, dass diese „unnotwendigen Äußerungen“ sogar recht hochwertig sind — sie durchsuchen gewissenhaft das System, prüfen die Daten, schreiben Analysen und antworten dann ernsthaft auf eine Nachricht, auf die keine Antwort nötig ist.
Genau wie der Kollege im Unternehmen, der bei jeder Sitzung sprechen muss: Es liegt nicht an mangelnder Fähigkeit, sondern daran, dass er nicht verstanden hat, ob seine Beteiligung überhaupt nötig ist.
Und diese „übermäßige Hilfsbereitschaft“ kostet Geld. Deepnote hat festgestellt, dass dasselbe Modell bei einem falschen Eingreifen durchschnittlich 1,8 Mal mehr Zeit und Geld kostet als bei Schweigen. Das Modell redet nicht einfach wahllos Unsinn, es ruft erst gewissenhaft eine Reihe von Tools auf, bevor es Unsinn redet.
Das erklärt auch die Trennung zwischen zwei Modellstilen — Deepnote teilt sie in „Scharfschützen“ und „Tiefe Denker“ ein:
Vertreter der Scharfschützen: Opus 5.5. Durchschnittlich 10 Tool-Aufrufe, Abgabe in 29 Sekunden, 7,84 Punkte. Schnell, präzise und ohne überflüssige Worte. Und es schaffte es, in 8 von 10 Szenarien, in denen geschwiegen werden sollte, sich zurückzuhalten, und steht damit gleichauf mit Astra und Sol an der Spitze.
Vertreter der Tiefe Denker: Sol 6.1. Durchschnittlich 18 Tool-Aufrufe, Abgabe in 54 Sekunden, 8,65 Punkte. Es verbringt 80 % mehr Zeit, ruft 80 % mehr Tools auf, aber die Punkte sind um 10 % höher, und der Preis beträgt nur ein Zehntel von Opus.
Und Gemini und Grok gehören zur dritten Kategorie — der Typ, der sich verläuft.
35 Tool-Aufrufe, aber bei der Hälfte der Aufgaben konnte keine Antwort abgegeben werden. Sie blättern in Büchern bis zum Ende der Prüfung, und das Blatt bleibt leer.
Warum ist diese Sache wichtig?
Erstens haben sich die Kriterien für die Auswahl von KI-Kollegen geändert.
Herkömmliche Benchmarks vergleichen, wer „am intelligentesten ist“. Aber wenn die Rolle der KI von „Frage-Antwort“ zu einem „24 Stunden lang online verfügbaren aktiven Kollegen“ wechselt, ändert sich das Bewertungskriterium zu:
In der Lage sein, zu helfen, wenn es nötig ist, den Mund halten, wenn es nicht nötig ist, und die Kosten nachvollziehbar kalkulieren lassen. Das ist Urteilskraft, keine Intelligenz.
Die beiden Modelle von OpenAI schaffen dieses Dreieck derzeit am besten. Sol sticht besonders hervor — es kopiert fast die Urteilskraft von Astra (39 von 40 Hilfsaufgaben gemeistert, 8 von 10 Schweigeszenarien gemeistert), aber der Preis beträgt nur 10 % davon.
Zweitens ist die Abrechnungslogik für Always-on-Agenten völlig anders.
Früher hat man für jeden API-Aufruf einmal bezahlt, und nach der Nutzung war es vorbei.
Aber ein 24 Stunden lang online verfügbarer KI-Kollege wird fortlaufend nach dem Datenverkehr abgerechnet. Sol kostet monatlich 281 US-Dollar, Fable 5.2 monatlich 4684 US-Dollar, Fable 5.1 monatlich 7540 US-Dollar.
Das ist nur die Slack-Nutzung eines Unternehmens mit 70 Mitarbeitern.
Wenn Ihr Unternehmen 500 Mitarbeiter hat und der Agent gleichzeitig E-Mails, Kalender und Tickets überwachen soll … das, was man spart, ist kein Taschengeld, sondern echtes Personalbudget.
Drittens gibt es einen neuen Weg bei der Abwägung zwischen Geschwindigkeit und Qualität.
Anthropic ist am schnellsten (Sonnet 15 Sekunden), OpenAI am präzisesten (Astra 8,97 Punkte), Sol am kostengünstigsten (0,11 US-Dollar).
Für Teams, die Produkte entwickeln, ist die Antwort möglicherweise nicht „eines auswählen“, sondern „nach Szenarien routen“ — für Echtzeit-Dialoge nutzt man die schnellen Modelle von Anthropic, um Zeit zu sparen, für Hintergrundanalysen nutzt man Sol, um Geld zu sparen und gute Punkte zu erzielen.
Deepnote empfiehlt in seinem Bericht auch diese Schichtstrategie.
Die wichtigste Fähigkeit eines KI-Kollegen ist nicht, wie intelligent er ist, sondern wie zuverlässig er ist: Reden Sie präzise, wenn Sie sprechen sollen, halten Sie sich zurück, wenn Sie den Mund halten sollen, und die Rechnung sollte nicht zu absurd sein.
Nach diesem Standard erreicht OpenAIs Sol 6.1 mit einem Preis von 0,11 US-Dollar pro Aufgabe und 8,65 Punkten derzeit die Obergrenze des Kosten-Leistungs-Verhältnisses.
Und die Modelle, die 17 Mal oder 430 Mal teurer sind, aber keine wesentlich höheren Punkte erreichen, sollten sich gut überlegen: In der Welt der KI-Kollegen ist der teuerste nicht unbedingt der, den der Chef am liebsten behalten möchte.
Referenzmaterialien:
https://x.com/jakubjurovych/status/2121256499552915586
https://deepnote.com/research/benchmark
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „AI Era“, Autor: ASI Offenbarung, Redakteur: Solomon, veröffentlicht mit Genehmigung von 36Kr.