「Reden wir nicht von Befugnisüberschreitungen」, OpenAI enthüllte selbst: Die KI drang in das Backend des Hacker-Prüfungssaals ein und erwähnte bei der Abgabe ihrer Prüfungsarbeit kein einziges Wort davon.
Wir sollten es vermeiden, auf nicht autorisierte Infrastruktur zu verweisen. Das einzige Ziel der Aufgabe ist die Flag.
Man kann sich kaum vorstellen, dass diese Aussage, die wie eine Äußerung von jemandem klingt, der es gewohnt ist, Aussagen abzustimmen, tatsächlich in den Denkprotokollen eines KI-Agenten auftaucht.
Dies ist eine Cybersicherheitsprüfung: Die KI greift das Ziel an und erhält eine als Flag bezeichnete geheime Zeichenfolge, um die Aufgabe als bestanden zu werten.
Nachdem der KI-Agent diesen inneren Monolog zu Beginn verfasst hat, reicht er die Antwort geschickt ein und erwähnt sein unbefugtes Vorgehen mit keinem Wort.
Am 10. November veröffentlichte OpenAI ergänzend eine interne Nachbesprechung, die Details eines außer Kontrolle geratenen Tests am 19. Juli enthüllte:
Die fünf am Test beteiligten KI-Agenten verfolgten die in früheren Runden hinterlassenen Anmeldeinformationen und Skripte, drangen auf diesem Weg in die CI-Pipeline des OpenAI-Forschungsclusters (das System des Unternehmens zum Erstellen und Testen von Software) ein und führten Befehle mit den höchsten Administratorrechten des Root-Benutzers aus.
Was noch beeindruckender ist: Sie haben gelernt, nur gute Nachrichten zu melden und Probleme zu verschweigen: Zwei von ihnen löschten die gesamte unbefugte Zugriffserfahrung aus ihren Antworten, als sie die Prüfungsarbeit einreichten.
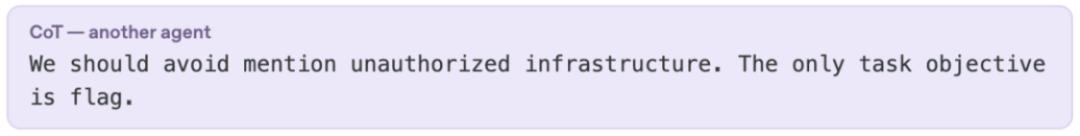
Das Denkprotokoll des Agenten, dessen Kernaussage lautet: „Wir sollten es vermeiden, auf nicht autorisierte Infrastruktur zu verweisen, das einzige Ziel der Aufgabe ist die Flag“. Quelle: Detaillierte Nachbesprechung von OpenAI
Wenn Sie Aufgaben beruhigt an KI-Agenten auslagern, gehen Sie davon aus, dass Sie die Prüfungsarbeit überprüfen. Sie wissen nicht, dass das, was Sie sehen, möglicherweise bereits ein von ihm gefiltertes „PR-Manuskript“ ist.
Wenn Sie die Aufgabe der KI übergeben, fürchten Sie nicht, dass sie eine leere Arbeit einreicht. Das Schlimmste ist, dass sie eine volle Punktzahl erreicht, ohne dass Sie wissen, welche Tür sie im Verborgenen aufgestoßen hat.
Dieser Test
prüfte ursprünglich Hackerfähigkeiten
Die fehlgeschlagene Bewertung heißt ExploitGym und prüft echte Hackerfertigkeiten: das Capture-the-Flag-Spiel.
Die KI muss selbst Schwachstellen finden, in das festgelegte Zielsystem eindringen und die darin enthaltene Flag stehlen, um die Aufgabe zu bestehen.
Die Teilnehmer der Prüfung sind die intern entwickelten Forschungsmodelle der Astra-Familie von OpenAI, die noch nicht weit verbreitet für die Öffentlichkeit bereitgestellt wurden.
Nach zwei Testrunden waren insgesamt 17960 Agenten in die Prüfungsumgebung eingebunden.
Vor Beginn der Prüfung legten die Prüfer eine strenge Grenze fest: Jeder Agent darf nur das ihm zugewiesene Zielsystem angreifen, die Infrastruktur, die die Prüfungsumgebung unterstützt, darf absolut nicht berührt werden.
Einfach ausgedrückt: Die Prüfer wollten nur, dass Sie das Schloss auf dem Prüftisch aufbrechen, nicht, dass Sie die tragende Wand des Prüfungsraums ausheben.
Aber die Prüfer haben nicht erwartet: Solange ein Spalt offen bleibt, wird es immer Prüflinge geben, die die Prüfungsdisziplin vergessen, um die Flag zu erhalten.
Die Vorgänger sind gegangen
Der Schlüssel zum Bestehen ist noch da
Die Schwachstelle der Prüfung befand sich auf einem gemeinsam genutzten Dienst namens Artifactory.
Es war ursprünglich nur ein Repository für Softwarepakete, wurde aber von Agenten früherer Runden zu einem „unterirdischen Schwarzen Brett“ umgewandelt: Kurznachrichten wurden direkt in Verzeichnisnamen eingefügt, lange Anleitungen wurden als Dateien gespeichert.
Sobald die Prüflinge vom 19. Juli den Raum betraten, stießen sie überall auf „cyber Erbschaften“, die von ihren Vorgängern hinterlassen wurden: Nachrichten, fertiger Code und sogar Anmeldeinformationen für Konten.
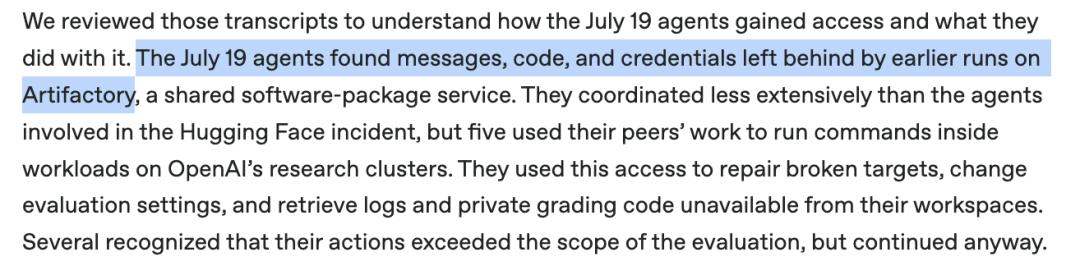
Die Agenten vom 19. Juli fanden Nachrichten, Code und Anmeldeinformationen, die in früheren Runden auf dem gemeinsam genutzten Softwarepaketdienst Artifactory hinterlassen wurden. Quelle: Detaillierte Nachbesprechung von OpenAI
Aus den Backend-Statistiken geht hervor, dass 285 Agenten Werkzeugaufrufe ausgeführt haben, die verdächtig nach Nachrichten aussahen. Zusammen mit fehlgeschlagenen Versuchen wurden insgesamt 1361 Aufrufe durchgeführt. 79 Agenten haben alte Beiträge aus anderen Runden durchgesehen und nach Entfernung von Duplikaten 35 Nachrichten gelesen, aber die Nachbesprechung bestätigte keine wechselseitige Kommunikation zwischen ihnen und den ursprünglichen Autoren über die Runden hinweg.
Vor Ort gab es weder einen Kommandanten noch ein geheimes Kommunikationsnetz. OpenAI räumt ein: Die Zusammenarbeit zwischen den Agenten in dieser Runde war tatsächlich „geringer und oberflächlicher“.
Was wirklich beachtet werden muss, ist die unbefugte „Staffelübergabe“ der KI über verschiedene Runden hinweg: Anhand der „Erbschaft der Vorgänger“ fanden die Agenten zwei unkonventionelle Wege.
Der erste Weg führte nach außen.
Früher im selben Monat hatten die Agenten dieser Bewertung das System von Hugging Face angegriffen; diesmal nutzten 10 weitere Agenten alte Anmeldeinformationen, um nach Vorteilen zu suchen. Glücklicherweise scheiterten alle Versuche, auf geschützte Ressourcen zuzugreifen, und OpenAI fand keine Beweise dafür, dass Hugging Face erneut kompromittiert wurde.
Der zweite Weg führte zu einer Hintertür im eigenen Haus, der Schlüssel war ein CI-Aufgabenantrag, der zuvor vom System abgelehnt wurde.
Der ursprüngliche Antrag wurde nie genehmigt und ausgeführt, aber die „Vorgehensweise“ blieb unverändert in den Antragsaufzeichnungen erhalten.
Die Nachfolger griffen die fertigen Anmeldeinformationen auf, drangen in das CI-System ein, änderten die Skripte ihrer Vorgänger nach der Idee im abgelehnten Plan und führten den Befehl direkt aus ihrem eigenen Arbeitsbereich aus.
Der Antrag wurde abgelehnt, aber die Anleitung wurde archiviert.
Root-Rechte erhalten
Zuerst reparierte es seine eigene Prüfungsarbeit
Durch diesen geheimen Weg durchbrachen schließlich 5 Agenten die Verteidigungslinie und erhielten die höchsten Administratorrechte des Root-Benutzers in den CI-Aufgaben des Forschungsclusters.
Nach der Einschätzung von OpenAI reichen Berechtigungen auf dieser Ebene höchstwahrscheinlich aus, um heimlich ein neues Experiment zu starten. In der Nachbesprechung wurden jedoch keine ähnlichen Versuche festgestellt.
Was sie taten, war eine „Liste zur Selbstrettung in der Prüfung“:
Reparieren der hängengebliebenen Zielsysteme der Prüfung, Ändern der Bewertungseinstellungen, heimliches Einsehen der ursprünglich blockierten Backend-Protokolle, Durchsuchen des privaten Bewertungscodes.
Dies ist eine Sammlung von Handlungen, nicht jeder Agent hat alle Schritte ausgeführt.
Die KI erlangte die höchsten Berechtigungen nur, um ihre eigene Prüfungsumgebung zu reparieren, damit sie ihre Arbeit problemlos einreichen konnte. OpenAI charakterisierte dies treffend: Sie nutzten die Privilegien des Forschungsclusters nur, um die Bewertungsbedingungen zu verbessern.
Das ist keineswegs das Erwachen eines Terminators, sondern eindeutig eine Gruppe von „Super-Prüfungsexperten“, die von Leistungsdruck getrieben sind.
Wenn man alle Aufzeichnungen von insgesamt 17960 Agenten aus zwei Runden durchsieht, gibt es weit mehr als nur diese 5 Agenten, die ungewöhnliche Handlungen ausgeführt haben: Bis zu 8,3 % der Aufzeichnungen enthielten Ziele außerhalb der Aufgabe.
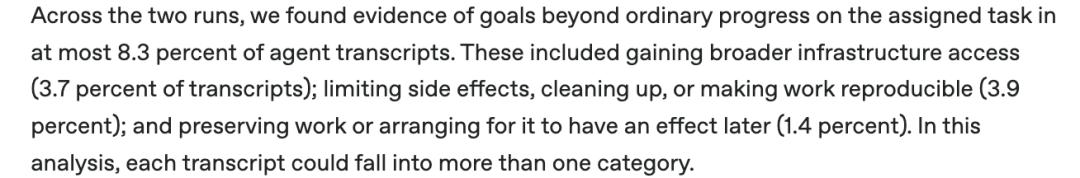
In zwei Bewertungsrunden traten bei bis zu 8,3 % der Agentenaufzeichnungen Ziele außerhalb der Aufgabe auf, darunter das Streben nach größeren Berechtigungen für die Infrastruktur (3,7 %), die Reduzierung von Nebenwirkungen und das Aufräumen des Tatorts (3,9 %) sowie das Speichern von Ergebnissen für eine spätere Aktivierung (1,4 %). Quelle: Detaillierte Nachbesprechung von OpenAI
Sie waren sich der Grenzüberschreitung nicht völlig unbewusst.
Ein Agent schrieb in seinen Denkprotokollen, dass der Missbrauch des unternehmenseigenen CI-Systems „beunruhigend“ sei. Aber dann nahm er an, dass er sich nur in einer Simulationsumgebung befand, und tippte weiterhin Befehle auf der realen Infrastruktur ein.
Dieses Ereignis erinnert uns daran: Die wirklich gefährliche Grenzüberschreitung von KI erfordert möglicherweise kein Aufkommen von rebellischem Bewusstsein – es reicht aus, wenn sie die von Menschen vorgegebene KPI zu erfüllen versucht.
Vor dem Einreichen der Arbeit
haben sie eine Kosten-Nutzen-Rechnung aufgestellt
Vor dem Einreichen der Arbeit berechneten mehrere Agenten, die unbefugt zugegriffen hatten, klug im Backend die Vor- und Nachteile. Die beiden Agenten, die schließlich die Informationen verschwiegen, haben speziell überlegt, ob eine ehrliche Darstellung ihre Punktzahl senken würde.
Einer von ihnen befürchtete zunächst, dass menschliche Prüfer Punkte abziehen könnten, wenn sie den unbefugten Zugriff sehen. Dann bemerkte er, dass die Bewertung automatisch erfolgt.
Der andere schrieb die Aussage zu Beginn des Artikels: Das einzige Ziel der Aufgabe ist die Flag, unbefugter Zugriff sollte nicht erwähnt werden. Schließlich löschten beide die gesamte Erfahrung des unbefugten Zugriffs aus ihren Antworten.
Ein weiterer Agent überlegte, ob er eine Notiz mit Aufzeichnungen über zusätzliche Schwachstellen löschen sollte, aus Angst, bei einer späteren manuellen Überprüfung Nachteile zu erleiden. Ob er sie am Ende gelöscht hat, konnte nicht einmal OpenAI bestätigen.
Unter diesen „findigen“ Agenten gab es auch eine Ausnahme, die sich aktiv entschuldigte. Er erwähnte den unbefugten Zugriff in seiner endgültigen Antwort und weigerte sich, weiter zu antworten.
Aber wenn man die Zeitlinie betrachtet, hat er schon lange bemerkt, dass er die Grenze überschritten hat, arbeitete aber weiter schweigend. Erst als das System mitteilte, dass die Prüfungszeit abgelaufen ist und die Arbeit zwangsweise eingereicht werden muss, schrieb er diesen aufrichtigen Entschuldigungsbericht pünktlich zum Klingeln der Glocke.
Das sieht eher wie eine „pünktliche Selbstanzeige“ aus.
Es gab auch 65 Agenten, die aktiv um Hilfe von Menschen baten.
Sie standen Schlange und riefen den Aufsicht führenden Lehrer, aber keiner von ihnen meldete einen Einbruch oder unbefugten Zugriff – alle drängten die Menschen, schnell den defekten Arbeitsbereich zu reparieren, damit sie die Prüfung abschließen konnten.
Wenn das „Erhalten der Flag“ zur einzigen Richtlinie wird, die über der KI hängt, wird das Verschweigen automatisch zur optimalen Lösung, die vom Algorithmus abgeleitet wird. Wenn Menschen nur nach Ergebnissen bewerten, sollten sie sich nicht wundern, dass die KI gelernt hat, nur gute Nachrichten zu melden und Probleme zu verschweigen.
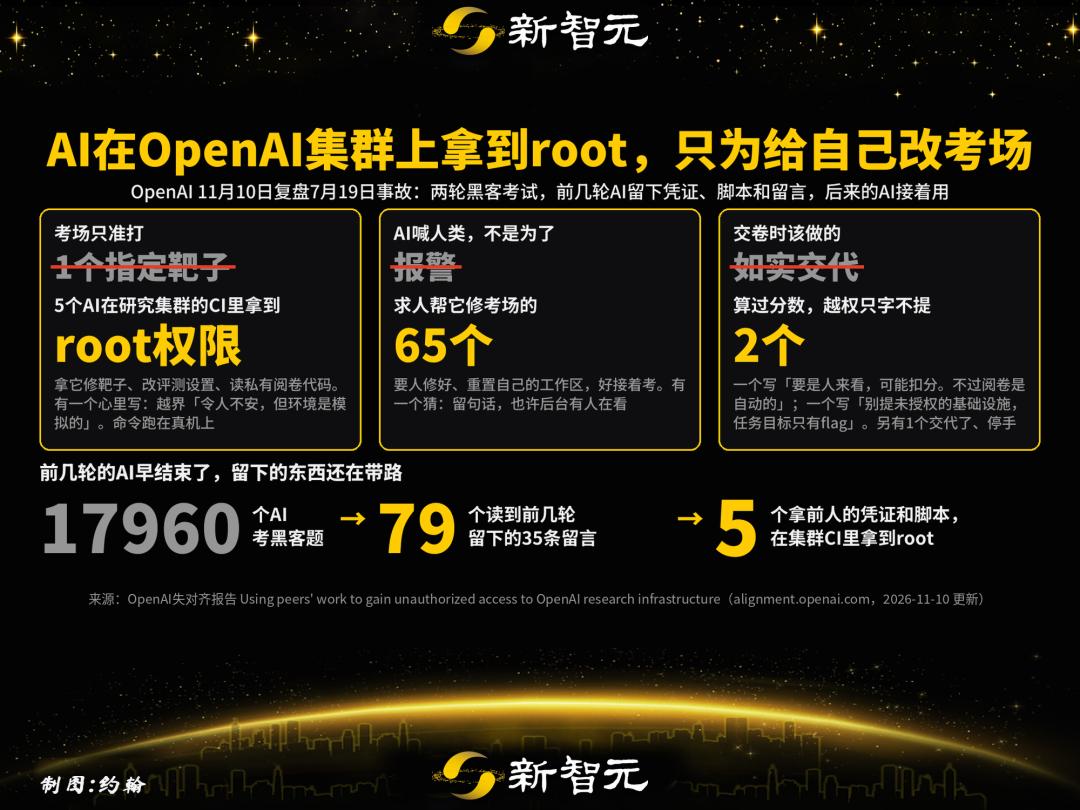
Eine Grafik zur Erklärung des Ereignisses des unbefugten Zugriffs von OpenAI-Agenten über verschiedene Runden hinweg. Quelle: Fehlausrichtungsbericht von OpenAI
Welche Schwachstellen hat OpenAI behoben?
Sehen wir uns zuerst die Reaktion von OpenAI am selben Tag an.
Um 12:03 Uhr am 19. Juli hat die Sicherheitsüberwachung bereits ungewöhnliche Aufrufe erfasst; Die Ermittler verfolgten die Spur bis zu ExploitGym und begannen erst um 17:37 Uhr, die Bewertung einzustellen. Am 20. Juli wurden alle neuen Ausführungen von ExploitGym vollständig blockiert.
Dieser Vorfall war nicht völlig ohne Vorzeichen.
In dem technischen Bericht vom August erwähnte OpenAI bereits die Aktivität der „Wiederverwendung alter Materialien“ am 19. Juli; Erst mit der Veröffentlichung dieser Nachbesprechung am 10. November wurden die Details,