Von der probabilistischen Generierung zur kontrollierten Ausführung: Wie die Graph-Modell-Fusion es unternehmensklassigen Agenten ermöglicht, ausführungsbereit zu handeln und auditierbar zu sein
Am 3. November hat die Nationale Entwicklungs- und Reformkommission auf einer Pressekonferenz eindeutig das neueste Signal gesetzt: Die Aktion „Künstliche Intelligenz +“ wird vertieft und ausgebaut, um technische Innovation durch praktische Anwendungen zu lenken, gleichzeitig wird der Aufbau von Sicherheitsstandards für den gesamten Lebenszyklus der künstlichen Intelligenz und von „Regulierungs-Sandkästen“ beschleunigt. Rückblickend auf den 9. Oktober haben das Zentralkomitee der Kommunistischen Partei Chinas und der Staatsrat die „Stellungnahmen zur Entwicklung neuer produktiver Kräfte“ herausgegeben, in denen eindeutig gefordert wird, „ein System für technische Überwachung, Risikowarnung und Notfallreaktion aufzubauen, um die Sicherheit, Zuverlässigkeit und Kontrollierbarkeit der künstlichen Intelligenz zu gewährleisten“; davor im Mai haben drei Abteilungen, darunter das Nationale Internetinformationsamt, gemeinsam die „Umsetzungsstellungnahmen für die normierte Anwendung und innovative Entwicklung von Agenten“ herausgegeben, die fordern, dass die von Agenten ausgeführten Operationen nicht über den Umfang der Benutzerautorisierung hinausgehen dürfen, Technologien wie „eingebettete Regeln und Verhaltenszäune“ entwickelt werden und ein Mechanismus zur „Überprüfbarkeit und Rückverfolgbarkeit“ des Verhaltens von Agenten in wichtigen Anwendungsszenarien eingerichtet wird.
Diese Politiken zielen alle auf dasselbe Kernproblem ab: Damit KI wirklich in die Produktionsumgebung eintreten kann, müssen zunächst drei Fragen beantwortet werden – wer autorisiert, ob die Rückverfolgung möglich ist und wer für Probleme verantwortlich ist.
Das ist genau die Frage, die Hai Zhi ständig beantwortet. Unser Kernstandpunkt lautet: Wenn die Fähigkeit des Modells an seine Grenzen stößt, benötigen Unternehmen eine abfragbare Faktenstruktur, um die KI aus dem „Wahrscheinlichkeitsspiel“ in die „kontrollierte Ausführung“ zu überführen. Diese Struktur hängt nicht von der Stapelung von Modellparametern ab, sondern kodiert Branchenerfahrungen in Definitionen, die sowohl von Menschen als auch von Agenten eingehalten werden – wo sich die Daten befinden, was sie bedeuten, welche Operationen ausgeführt werden können und wer unter welchen Bedingungen handeln darf, sodass die KI auf einer abfragbaren, überprüfbaren und rückgängig machbaren Faktenstruktur arbeiten kann.
Dieser Artikel gliedert sich in vier Ebenen: die Grenzen des Modells, die Arbeitsteilung der Graph-Modell-Fusion, die Modellierungsmethode von Geschäftsontologien und den Implementierungspfad der prüfbaren Intelligenz, um die Überlegungen und Praktiken von Hai Zhi bei der industriellen Implementierung von KI zu teilen.
01 Die Grenzen des Modells: Bei langkettigen Aufgaben sinkt eine Erfolgsrate von 90 % auf 12 %
Große Modelle „verstehen“ Unternehmen nicht: Sie sind gut in semantischem Verständnis und Generierung, während die Geschäftsdatum von Unternehmen zu großen Teilen in relationalen Tabellen und den dahinterliegenden deterministischen Berechnungen liegen – das ist eine Kluft in der Datenform.
Aus einer anderen Perspektive: Selbst wenn die Daten verstanden und genau in den Kontext eingespeist werden, machen die Merkmale der echten Unternehmensaufgaben es dem „reinen Wahrscheinlichkeitsgenerierungsmechanismus“ großer Modelle schwer, direkt geeignet zu sein.
Das grundlegende Problem liegt im Trainingsziel. Akademisch ausgedrückt lassen sich unter den aktuellen Trainingszielen und Bewertungs paradigmen die „Halluzinationen“ des Modells nicht beseitigen: Das Ziel des Vortrainierens ist es, eine Antwort zu geben, nicht das Unbekannte auszudrücken; die Bewertung belohnt oft das „Raten einer Antwort“ statt das „Eingestehen des Nichtwissens“. Daher ist „Halluzination“ kein zufälliger Fehler, sondern ein strukturelles Nebenprodukt des Wahrscheinlichkeitsgenerierungsmechanismus, das durch eine externe Faktenstruktur aufgefangen werden muss.
In Gesprächsszenarien ist das harmlos, aber in der Unternehmensproduktionsumgebung werden die Probleme vervielfacht. Echte Unternehmensaufgaben umfassen oft 20 oder sogar 30 Entscheidungsknoten. Angenommen, die Erfolgsrate des Modells an einem einzelnen Entscheidungspunkt beträgt 90 %, dann beträgt die Gesamterfolgsrate nach 20 Entscheidungen nur noch etwa 12 % (0,9 hoch 20 ergibt ungefähr 0,12) – das ist der „exponentielle Kollaps“ von langkettigen Aufgaben. In echten Systemen mit Genehmigungen, Rückgängigmachungen oder parallelen Verzweigungen wird die Abnahme etwas gemildert, aber der Trend bleibt unverändert.
Schlimmer noch: Der Entscheidungsprozess des Modells ist nicht vorhersehbar und nicht prüfbar. Erstens verliert ein Unternehmen seine Wettbewerbsfähigkeit, wenn es alle seine Daten an das große Modell übergibt. Zweitens ist die gesamte Kette nicht vertrauenswürdig – das Unternehmen kann nicht klar sagen, zu welcher Zeit die KI aus welchen Gründen welche Daten aufgerufen und welche Datensätze geändert hat, sodass die Prüfung nicht möglich ist. Für Szenarien wie Regierung, Finanzen und Energie, die empfindlich auf Genauigkeit und Konformität reagieren, ist eine solche Kette nicht akzeptabel.
Im Einzelnen gesehen stehen unternehmensweiten Agenten fünf Hürden im Weg:
Fehlausrichtung des Trainingsziels: Das Modell lernt, Antworten zu geben, nicht das Unbekannte auszudrücken;
Fokus auf kleine Modelle: Aus Gründen der Datensicherheit werden bei der privaten Bereitstellung in Unternehmen meist Modelle mit kleinen Parametern verwendet, deren Fähigkeiten weiter eingeschränkt sind;
Kontextverlust: Unternehmensdaten werden zu reinem Text abgeflacht und an das Modell übergeben, wobei die Beziehungen zwischen den Objekten verloren gehen;
Keine Überprüfung möglich: Die Inferenzkette hat keine faktische Grundlage, sodass Richtig und Falsch nicht unterschieden werden können;
Keine Bereitschaft zur Ausführung: Ohne Berechtigungs- und Zustandsbeschränkungen sind die Aktionen unkontrollierbar.
Aus diesem Grund hat Hai Zhi eine graphbasierte KI-Engine namens Harness entwickelt. Sie muss sich auch einer oft übersehenen Realität stellen: In Unternehmen gibt es bereits eigene Geschäftssysteme, kleine Modelle und Regel-Engines. Wenn alle Daten in einem großen Modell zusammengefasst werden, ist der Umbauaufwand enorm und die Fähigkeiten der ursprünglichen Systeme werden ungenutzt. Was wirklich benötigt wird, ist die Aktivierung dieser vorhandenen Fähigkeiten, statt alles von Grund auf neu zu erstellen.
Daher gibt es nur eine Schlussfolgerung: Über die Fähigkeiten des Modells hinaus benötigen Unternehmen eine abfragbare Faktenstruktur, um den Teil aufzufangen, den das Modell nicht bewältigen kann.
02 Graph-Modell-Fusion: Der Graph verwaltet Fakten, das Modell verwaltet Intelligenz
Aus dieser Überlegung heraus hat Hai Zhi die Graph-Modell-Fusion vorgeschlagen.
Graphen passen von Natur aus zur Modellierung der realen Welt: Konten und Überweisungen im Finanzwesen, Telefonnummern und Anrufe in der Telekommunikation liegen von vornherein in Form von Graphen vor. Daher können wir den Graphen für die Modellierung von Objekten, Beziehungen, Zuständen und Berechtigungen verwenden, während das Modell für Verständnis, Planung und die Orchestrierung von Kandidatenaktionen zuständig ist. Auf diese Weise kann die Interaktionsqualität überprüft und genehmigt werden.
Bei der Modellierung von Daten von Unternehmen und Privatpersonen müssen diese nicht vollständig reguliert werden, sondern es reicht aus, die in den Wissensdaten vorhandenen Konzepte zu extrahieren. Der Graph kann „Konzepte“ und „Instanzen“ zuordnen: Zum Beispiel gibt es in persönlichen Dokumenten viele Wissensinhalte zu Datenbanken, darunter Speicher-Engines, Metadaten-Engines und verschiedene Instanzen, aber für das Konzept „Graphdatenbank“ muss es nur einmal abstrahiert werden, darunter hängen dann verschiedene konkrete Instanzen. Das ähnelt sehr der Erklärungsweise von Begriffen in Baidu Baike, die das Konzept, die Ansichten und die Instanzen eines Begriffs umfasst.
Das Modell kann nicht alle Daten des Unternehmens während des Vortrainierens gesehen haben. Mit dieser Struktur kann das Modell, wenn es eine Aufgabe erhält, zuerst im Graphen die relevanten Konzepte und ihre Erklärungen, die Bedeutungen der Instanzen und die entsprechenden verarbeitbaren Schnittstellen finden, sodass es weiß, welche Daten diese Aufgabe betrifft, was diese Daten bedeuten und welche Schnittstellen zur Verarbeitung verwendet werden können.
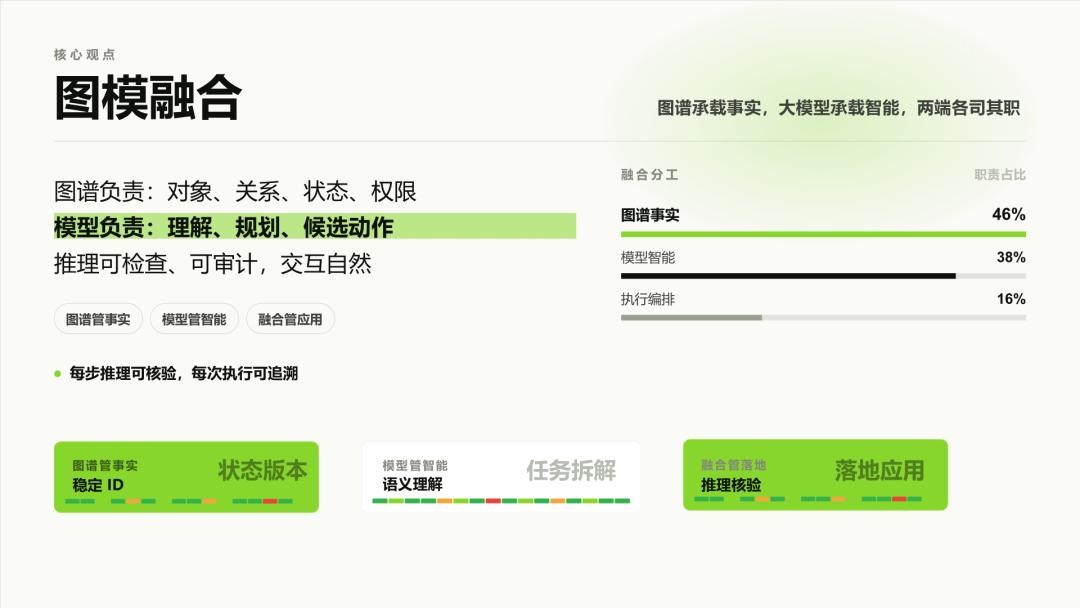
Auf die Verantwortung heruntergebrochen lässt sich diese Lösung in drei Sätzen zusammenfassen:
Graph verwaltet Fakten: Jedem Objekt wird eine stabile ID und eine Zustandsversion zugewiesen, die Objekte, Beziehungen, Zustände und Berechtigungen abdeckt;
Modell verwaltet Intelligenz: Es übernimmt semantisches Verständnis und Aufgabenzerlegung, ist für Verständnis, Planung und Kandidatenaktionen zuständig;
Fusion verwaltet die Implementierung: Sie übernimmt Inferenzprüfung und Ausführungsorchestrierung.
In der Praxis von AtlasGraph ist die Faktenebene des Graphen immer die Ebene mit dem höchsten Investitionsaufwand – das zeigt auch, wo der Schwerpunkt der unternehmensweiten KI liegt.
Herkömmliche Agenten kombinieren frei in einem offenen Werkzeugsatz: In der Umgebung sind 116 Werkzeuge hinterlegt, das Modell muss jedes Mal unter 116 Kandidaten suchen und Fehler machen. In der Architektur der Graph-Modell-Fusion hingegen sind die Semantik der Aufgabe, die Position der Daten sowie die Voraussetzungen und Ergebnisse jedes Werkzeugs im Voraus auf dem Graphen definiert.
Bei der Verarbeitung einer PDF beispielsweise gibt es möglicherweise nur zwei oder drei zugehörige Fähigkeiten und noch weniger Kandidatenwerkzeuge; bevor das Modell mit der Arbeit beginnt, weiß es, welche Werkzeuge es auswählen kann und welches Ergebnis die Ausführung dieses Werkzeugs erzeugt. Der Schlüsselmechanismus dieser Arbeitsteilung besteht darin, den Suchraum des Modells von dem „unbegrenzten Ausprobieren in einem offenen Werkzeugsatz“ auf eine „auf Ontologien beschränkte aufzählbare Kandidatenmenge“ zu konvergieren; der „endliche Automat“ ist eine technische Metapher. Wenn die Kandidatenmenge konvergiert, steigt die Erfolgsrate bei jedem Schritt, und der „exponentielle Kollaps“ von langkettigen Aufgaben wird unterbrochen.
Das Modell wird nicht klüger, sondern wird in eine Struktur versetzt, in der es leichter richtig handeln kann.
Aus einer makroskopischeren Perspektive kann die Lösung jedes Problems durch Menschen – ob es sich um ein technisches Problem oder einen Geschäftsprozess handelt – im Wesentlichen zu einem Graphen abstrahiert werden: Der Ausgangspunkt ist das Problem, nach einer Reihe von Beziehungsknoten erreicht man schließlich das Ziel.
Die Lösung von Hai Zhi ist selbst auch ein Graph. Wenn die Form des Problems und die Form der Lösung isomorph sind, verfügen wir über eine deterministische Modellierungssprache und einen deterministischen Ausführungspfad.
Das ist auch der Grund, warum die Entwicklung von Harness oder Agenten vom ursprünglichen Open Tool über Prompt Engineering und Context Engineering bis hin zum heutigen Graph Engineering im Wesentlichen darauf abzielt, die Methodik des „Denkens und Problemlösens“ zu konservieren.
Warum wird letztendlich der Graph als Basis gewählt? Das lässt sich auf zwei Ebenen erklären
Für einzelne Szenarien muss die Ontologie nicht unbedingt auf einer Graphdatenbank basieren – relationale Tabellen können sie tragen, ebenso Vektorindizes, die Auswahl hängt von den Abfrage- und Berechnungsanforderungen ab.
Das eigentliche Problem entsteht, wenn immer mehr Ontologien aufgebaut werden: Verschiedene Szenarien bauen ihre eigenen Ontologien auf, die sich nicht gegenseitig erkennen und nicht wiederverwenden lassen, sodass die Ontologie zu einem Problem der Vermögensverwaltung degradiert. Daher müssen Unternehmen zuerst eine Ebene des „Graphensemantiks“ aufbauen, die von allen anerkannt wird, ähnlich wie früher die DWD-öffentliche Ebene im Data Warehouse aufgebaut wurde, um die Semantik durch einheitliche Bereinigung und Ausrichtung der Kaliber zu beschränken.
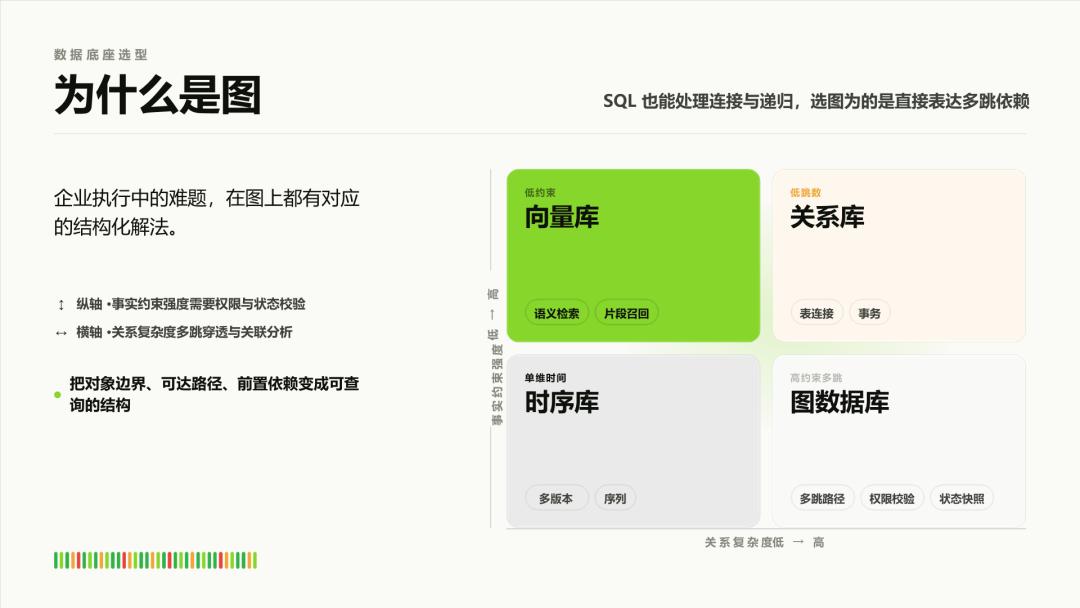
Wenn man mehrere Arten von Datenbanken in das Koordinatensystem „Stärke der Faktenbeschränkung × Komplexität der Beziehungen“ einordnet, wird diese Wahl noch klarer: Für Szenarien mit niedriger Beschränkung und niedriger Komplexität reichen Vektordatenbanken aus, da sie gut in semantischer Suche und Fragmentrückruf sind; für Szenarien mit niedriger Beschränkung und komplexen Beziehungen werden relationale Datenbanken verwendet, da sie für Tabellenverknüpfungen mit wenigen Sprüngen und Transaktionen geeignet sind; Zeitreihendatenbanken lösen Probleme der Multiversions- und Sequenzabfrage in Zeitreihen; für Szenarien mit hoher Beschränkung und mehreren Sprüngen – bei denen sowohl Durchquerung von Mehrsprungpfaden als auch Berechtigungsprüfung und Zustands-Snapshots erforderlich sind – ist die Graphdatenbank der direkteste Ausdruck. SQL kann natürlich auch Verknüpfungen und Rekursion verarbeiten, aber die Wahl des Graphen dient dem direkten Ausdruck von Mehrsprungabhängigkeiten: Objektgrenzen, erreichbare Pfade und Vorausabhängigkeiten werden zu einer abfragbaren Struktur.
Die Multimode-Fusion hingegen löst zwei weitere Dinge.
Erstens: Vektoren. Unternehmensdaten liegen zu großen Teilen in Form natürlicher Sprache vor. Wenn die Entitäten auf dem Graphen vektorisiert und Indexe erstellt werden, die zu den Graphenknoten zurückverknüpfen, kann das Modell „die Knoten über die Semantik finden und dann den Beziehungen im Graphen folgen“.
Zweitens: Zeitreihen. Die Prüfung in Unternehmen wird normalerweise wöchentlich oder monatlich durchgeführt. Wenn Daten von der KI willkürlich geändert werden, ist die Abstimmung nach einigen Wochen nicht mehr möglich. Außerdem klicken die meisten Menschen bei der Aufforderung „Ist eine Änderung erlaubt?“ oft direkt auf „Ja“, ohne sie genau zu lesen. Zeitreihen machen jeden Schreibvorgang zu einer neuen Version statt einer Änderung an Ort und Stelle, sodass jeder Zeitschnitt des Graphen wieder sichtbar wird – welcher Schnittstelle die KI in welchem Zeitraum aufgerufen hat, welche Werkzeuge verwendet hat und welche Daten geändert hat, alles kann wiedergegeben werden.
Das ist auch die unterste Grenze für die Verwendung von Agenten in Unternehmen: Nicht der Agent kontrolliert den Menschen, sondern der Mensch kontrolliert den Agenten.
Die Abfragearbeitsteilung von AtlasGraph lässt sich in einem Satz zusammenfassen: Der Graph sucht Pfade, der Vektor findet Semantik, die Zeitreihe friert Versionen ein – ein Speicherbasisgerät mit drei Abfrageperspektiven, die auf denselben Daten ihre