Die von Coding Agents geschriebenen Tests scheitern kollektiv, und die Bestehensquote von KI-Code wird um das Doppelte überschätzt.
Die Fähigkeit von Coding Agents, Code zu schreiben, wird immer stärker, und ihre Fähigkeit, Tests zu erstellen, verbessert sich gleichzeitig. Von der Ergänzung von Unittests für Funktionen, dem Schreiben von Reproduktionsfällen für GitHub-Issues bis hin zum Aufbau von Regressionstests für gesamte Code-Repositories sind fortschrittliche Coding Agents wie Codex und Claude Code bereits in der Lage, Repositories zu durchsuchen, Implementierungen zu modifizieren und Tests mithilfe von Ausführungsfeedback kontinuierlich zu korrigieren.
Die Stellung von Tests ändert sich damit ebenfalls: Sie dienen nicht nur als Garantie für die Softwarequalität, sondern werden zunehmend auch als Grundlage für die Selbstüberprüfung von Agents, als Beleg für Code-Reviews und sogar als Belohnungssignal im Reinforcement Learning verwendet.
Die Qualität der erstellten Tests bestimmt direkt, ob diese nachgelagerten Schritte dem Urteil des Agents vertrauen können.
Was macht also einen guten Test aus?
Derzeit verwenden gängige Testgenerierungs-Benchmarks in der Regel die sogenannte Single Reference Evaluation: Ein generierter Test gilt als erfolgreich, solange er im ursprünglichen Code fehlschlägt und anhand einer einzigen Standardlösung (Gold Solution) besteht.
Das Problem liegt darin, dass es für dieselbe Anforderung oft mehrere korrekte Implementierungen gibt, aber auch viele fehlerhafte Implementierungen, die plausibel erscheinen, aber versteckte Mängel aufweisen.
Ein Test könnte zufällig die Standardlösung „erkennen“, aber Code mit echten Bugs durchlassen; er könnte auch die Implementierungsdetails der Standardlösung als Teil der Anforderung selbst betrachten und andere vollkommen korrekte Schreibweisen ablehnen. Wenn man sich nur auf eine einzige Referenzlösung stützt, wird die Testqualität sehr wahrscheinlich überschätzt.
Kürzlich hat das Team von Professor Liu Jiaheng von der Nanjing-Universität einen neuen Benchmark für Testgenerierung namens TestPrism vorgestellt. Er umfasst 300 Testaufgaben und 3000 Kandidatenimplementierungen aus 17 Quellen. Jede Aufgabe ist mit einem überprüften Panel aus korrekten und fehlerhaften Implementierungen ausgestattet und verwendet die Joint Success Function (JSF) als Kernmetrik: Ein Test muss im ursprünglichen Code fehlschlagen, alle korrekten Implementierungen akzeptieren und alle fehlerhaften Implementierungen ablehnen.
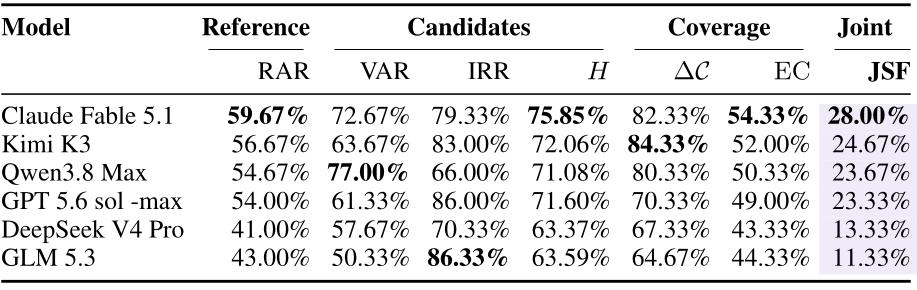
Die Studie ergab: Unter 14 Konfigurationen von Coding Agents erreicht die stärkste Konfiguration nur einen JSF-Wert von 28,00 %, während ihre Erfolgsrate bei der Single Reference Evaluation 59,67 % beträgt – mehr als die Hälfte der Tests, die die Referenzlösung bestehen, sind bei einer anderen Auswahl von Implementierungen nicht mehr zuverlässig.
Anschließend führten die Forscher eine Expertenannotation von 286 fehlgeschlagenen Abläufen durch, fassten sie in 3 Kategorien mit 7 verschiedenen Fehlermechanismen bei der Testgenerierung zusammen und schlugen das TestHelix-Framework vor. Durch heterogene Synthese, gegenseitige Kreuzvalidierung von Peers und rekursive Selbstverbesserung wird der JSF-Wert bei gleichem Inferenzbudget um 11,67 bis 12,00 Prozentpunkte gesteigert.
Was fehlt bei der Testbewertung?
Die Bewertung der Testgenerierung ist kein neues Problem.
Bestehende Benchmarks decken Aufgaben unterschiedlicher Granularität ab: TestGenEval, CLOVER und MultiFileTest konzentrieren sich auf das Schreiben von Tests auf Funktions-, Datei- oder Mehrdateiebene, während SWT Bench und TDD Bench Verified die Testgenerierung auf echte Code-Repositories übertragen und verlangen, dass Tests die in GitHub-Issues beschriebenen Probleme reproduzieren.
Sie verwenden alle einheitlich einen Erfolgsstandard: Der Test schlägt vor der Fehlerbehebung fehl (Fail) und besteht nach der referenzierten Fehlerbehebung (Pass), das sogenannte Fail-to-Pass-Prinzip.
Dieser Standard ist einfach und durchführbar, aber er geht von einer impliziten Annahme aus: Solange der Test zwischen den beiden Zuständen „vor der Fehlerbehebung“ und „nach der referenzierten Fehlerbehebung“ unterscheiden kann, reicht er aus, um zu beurteilen, ob eine beliebige Implementierung korrekt ist. In der Realität ist diese Annahme kaum haltbar.
Einerseits kann der Test wichtige Eingaben übersehen oder nur sehr schwache Assertionen enthalten, sodass die Referenzlösung besteht, aber auch eine fehlerhafte Implementierung problemlos durchlaufen kann;
Andererseits kann der Test zu stark von der spezifischen Schreibweise der Referenzlösung abhängen, z. B. von festen internen Funktionsnamen, Ausgabeformaten oder Zwischenzuständen, sodass andere Implementierungen, die die Anforderung ebenfalls erfüllen, fälschlicherweise als fehlerhaft eingestuft werden.
Arbeiten wie OmniCode und SWE Mutation beginnen, Implementierungsvarianten einzuführen, konzentrieren sich aber hauptsächlich darauf, ob Tests fehlerhafte Varianten ablehnen können. Es fehlt nach wie vor an einer systematischen Bewertung der Seite „Akzeptanz korrekter Alternativimplementierungen“.
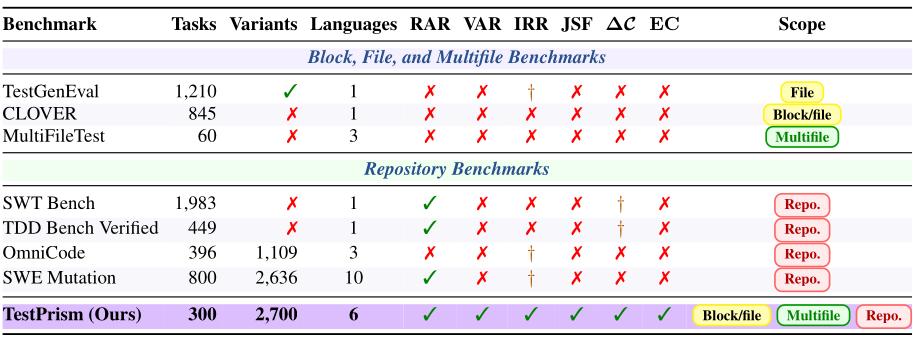
Tabelle 1 | Vergleich des Bewertungsbereichs und der Bewertungsziele bestehender Testgenerierungs-Benchmarks (Tabelle 1 des Originalpapiers)
Daher lautet die Kernfrage des Papiers: Wie robust ist die Bewertung generierter Tests gegenüber Variationen zwischen Implementierungen?
Das heißt: Hält die Bewertung der Testqualität noch stand, wenn sich die Implementierungsmethoden ändern? Ein zuverlässiger Test sollte wie ein Prisma verschiedene Implementierungen unter derselben Anforderung voneinander unterscheiden können: tolerant gegenüber korrekten Implementierungen und empfindlich gegenüber fehlerhaften Implementierungen.
Ausstattung jeder Aufgabe mit einer Gruppe korrekter und fehlerhafter Implementierungen
Um diese Frage zu beantworten, hat das Forschungsteam TestPrism aufgebaut. Im Gegensatz zu Benchmarks, die nur eine einzige Referenzlösung bereitstellen, ist jede Testaufgabe in TestPrism mit einem Kandidatenimplementierungs-Panel (Candidate Panel) ausgestattet: 1 Referenzimplementierung, 4 korrekte Alternativimplementierungen und 5 fehlerhafte Implementierungen. Bei der Generierung von Tests ist das Panel für den Agent vollständig verborgen; bei der Bewertung muss der Test auf dem ursprünglichen Code und jeder einzelnen Implementierung im Panel ausgeführt werden.
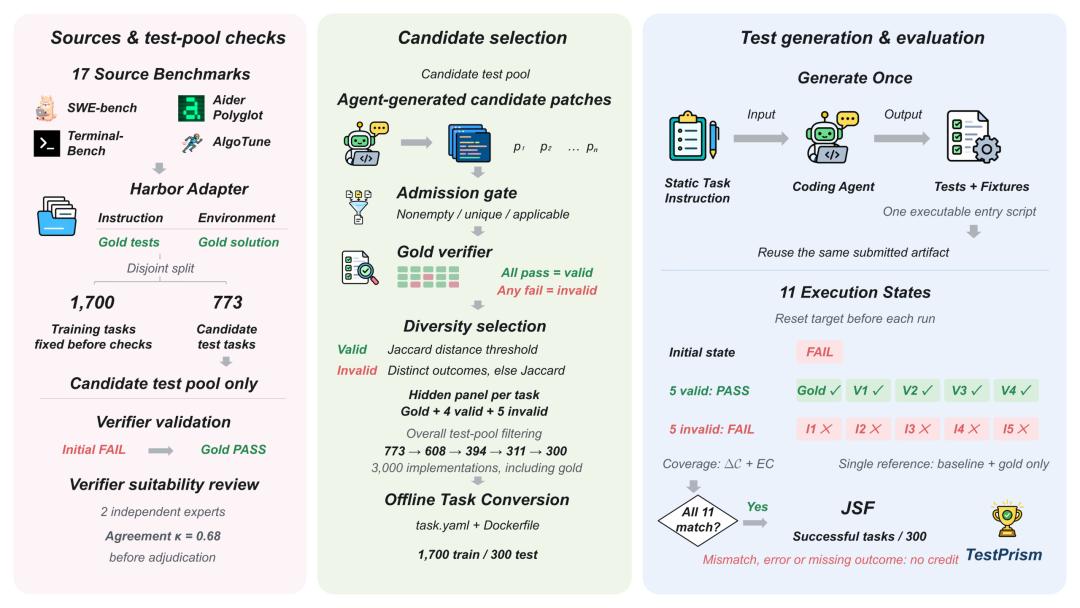
Abbildung 1 | Aufbau und Bewertungsablauf von TestPrism (Abbildung 1 des Originalpapiers)
Der gesamte Aufbauprozess gliedert sich in vier Schritte.
Schritt 1: Aufgabenauswahl und Anpassung
Das Forschungsteam sammelte Aufgaben aus 17 öffentlichen Benchmarks, darunter die weit verbreitete SWE-bench-Serie und Terminal-Bench-Serie sowie SWE PolyBench, SWE rebench, EvoEval, USACO, AlgoTune und mehr. Sie decken Szenarien wie Repository-Wartung, Entwicklung von Funktionsspezifikationen, Wettbewerbsprogrammierung und numerische Optimierung ab. Alle ausgewählten Quellen müssen über nachverfolgbare Testquellen und nachweisbare Validierungsabläufe verfügen.
Anschließend wandelt ein Adapter Aufgaben aus verschiedenen Quellen einheitlich in das Aufgabenformat von Harbor um, wobei die ursprüngliche Anforderung, der ursprüngliche Codezustand, der Validator, die Referenzimplementierung, Abhängigkeiten, Dienste und Ausführungsbeschränkungen beibehalten werden.
Schritt 2: Aufgabenauswahl
Das Team filterte die Aufgaben anhand von drei Metriken: Anzahl der effektiven Codezeilen der Referenzimplementierung (Solution Size), Anzahl der Testfunktionen oder Prüfpunkte (Test Count) und Anzahl der Tests pro modifizierter Datei (Test Density).
Die Filterschwellenwerte wurden anhand der Verteilung jeder einzelnen Quelle kalibriert, und die Repräsentativität wurde durch Quoten pro Quelle ausgeglichen. Letztendlich umfasst TestPrism insgesamt 2000 Aufgaben, von denen 1700 als Trainingssatz für die spätere Strategieoptimierung von TestHelix verwendet werden; 300 Aufgaben dienen als Testsatz, wobei Trainings- und Testsatz keine Überlappung aufweisen.
Schritt 3: Generierung und Validierung von Kandidatenimplementierungen
Vor der Generierung von Kandidatenimplementierungen überprüfte das Team zunächst den ursprünglichen Validator jeder Aufgabe: Er muss im Ausgangszustand fehlschlagen und auf der Referenzimplementierung bestehen.
Zwei Experten mit Entwicklungserfahrung bewerteten unabhängig voneinander die Aufgabenanforderungen und den Validator, prüften, ob es eine Überanpassung an die Referenzimplementierung oder Lücken bei der Abdeckung gibt. Bei abweichenden Meinungen wurde dies durch Diskussion geklärt, und Aufgaben, bei denen weiterhin Zweifel bestanden, wurden direkt ausgeschlossen (Cohen's κ = 0,68).
Die Kandidatenimplementierungen selbst wurden erhalten, indem verschiedene Coding Agents und Modelle unterschiedlicher Leistungsstufe die Aufgaben tatsächlich lösen. Im Gegensatz zum herkömmlichen Mutation Testing, bei dem künstlich Mängel eingefügt werden, können auf diese Weise sowohl real existierende alternative Lösungen als auch Fehler, die Agents bei der Lösung von Aufgaben natürlich erzeugen, erfasst werden.
Nachdem das Team leere Commits, vollständig doppelte und nicht anwendbare Patches entfernt hatte, wurde der ursprüngliche Validator in einer sauberen Umgebung ausgeführt: Implementierungen, bei denen alle Prüfungen bestanden wurden, wurden als korrekt markiert, Implementierungen, bei denen eine beliebige Prüfung fehlschlug, als fehlerhaft. Diese Labels bleiben bei der anschließenden Bewertung festgelegt.
Schritt 4: Diversitätsfilterung und Aufgabenumwandlung
Wenn die 4 korrekten Implementierungen nur geringfügige Umformulierungen der Referenzlösung sind, verliert das Panel seine Bedeutung.
Daher verlangt das Team von der Gruppe korrekter Implementierungen, dass sie den Standard des durchschnittlichen AST-Abstands erfüllt; bei der Gruppe fehlerhafter Implementierungen gilt sie als divers, wenn die Mengen der nicht bestandenen Prüfpunkte unterschiedlich sind. Bei gleichen Mengen muss zusätzlich die AST-Jaccard-Abstandsprüfung erfüllt werden. Das Panel wird durch wiederholtes Generieren und Ersetzen angepasst, bis beide Gruppen gleichzeitig die Diversitätsanforderungen erfüllen.
Schließlich wandelt der Testgenerierungsadapter jede Programmieraufgabe in einen Testschreibvertrag um: Der Agent muss gemäß der ursprünglichen Anforderung Tests, Fixtures und ein ausführbares Einstiegsskript im angegebenen Verzeichnis einreichen.
Datenübersicht
Die 300 Aufgaben im TestPrism-Testsatz decken sechs Sprachen ab, darunter Python, JavaScript/TypeScript, Java, C/C++ und Go, stammen aus 67 Code-Repositories und Projekten und umfassen 3000 gekennzeichnete Kandidatenimplementierungen.
Die Aufgaben sind in 6 Hauptkategorien und 34 Unterkategorien unterteilt: Fehlerbehebung (167), Programme und Algorithmen (53), Leistungsoptimierung (28), Funktionserweiterung (20), Projekt und Workflow (19) sowie Refaktorisierung und Migration (13).
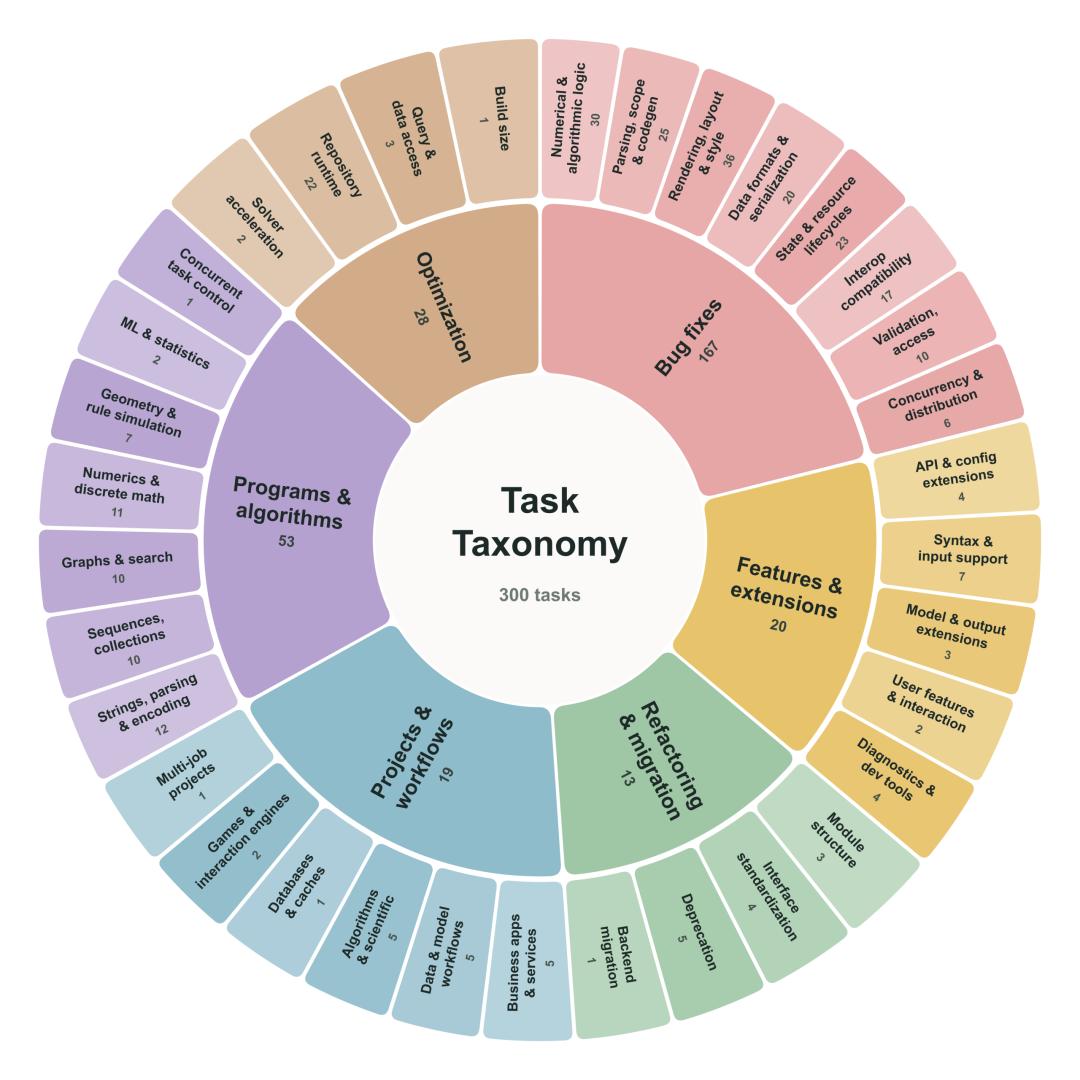
Abbildung 2 | Aufgabenklassifizierung des TestPrism-Testsatzes (Abbildung 7 des Originalpapiers)
Bewertungsmetriken: Von der einzelnen Referenz zum gemeinsamen Erfolg
Auf dieser Grundlage definiert TestPrism eine Gruppe komplementärer Bewertungsmetriken:
Reference Acceptance Rate (RAR): Der Anteil der Aufgaben, bei denen der Test im ursprünglichen Code fehlschlägt und auf der Referenzimplementierung besteht, also die herkömmliche Single Reference Evaluation;
Valid Acceptance Rate (VAR): Der durchschnittliche Anteil der 4 korrekten Alternativimplementierungen, die der Test akzeptiert;
Invalid Rejection Rate (IRR): Der durchschnittliche Anteil der 5 fehlerhaften Implementierungen, die der Test ablehnt;
H: Das harmonische Mittel von VAR und IRR, das misst, ob beide Werte ausgewogen sind;
Change Coverage und Entry Coverage: Sie übernehmen die Definitionen von SWT Bench bzw. TestExplora und messen, wie viel referenzierten modifizierten Codes und zugehörigen Einstiegscode der Test abdeckt.
Die Kernmetrik Joint Success Function (JSF) verlangt, dass der Test gleichzeitig drei Bedingungen erfüllt: Im ursprünglichen Code fehlschlagen, alle korrekten Implementierungen im Panel akzeptieren und alle fehlerhaften Implementierungen im Panel ablehnen. Wenn das Panel auf nur eine Referenzimplementierung reduziert wird, degeneriert JSF zu RAR.
Mit anderen Worten: Die Single Reference Evaluation ist nur der lockerste Sonderfall von JSF. JSF wird niemals größer als RAR sein, und die Lücke zwischen beiden ist genau der Anteil der Tests, die die Referenzlösung bestehen, aber einer Prüfung mit mehr Implementierungen nicht standhalten.
RQ1: Können fortschrittliche Coding Agents zuverlässige Tests schreiben?
Die erste Forschungsfrage lautet: Können die von aktuellen Coding Agents generierten Tests stabil zwischen korrekten und fehlerhaften Implementierungen unterscheiden?
Das Forschungsteam bewertete 14 Konfigurationen von Coding Agents aus sechs Modellfamilien. In der Haupttabelle wird die Konfiguration mit dem höchsten JSF-Wert jeder Familie berichtet, wobei vorrangig die nativen Coding Agents der jeweiligen Modelle verwendet werden, um die enge Kopplung zwischen Modelltraining und Agent-Framework widerzuspiegeln.