Aufbau der nächsten Generation von LLM-Inferenz-Engines für Agentic Reasoning
Warum erfordert agentische Inferenz eine neue Inferenz-Engine?
Zu Beginn des Projekts TokenSpeed war die erste Frage, die wir beantworten mussten: Warum erfordert das Agent-Szenario ein völlig neues Design der Inferenz-Engine.
Das Optimierungsziel herkömmlicher Chat-lastiger Workloads ist relativ einheitlich: Der Benutzer stellt eine Anfrage, und das Modell generiert auf einmal eine vollständige Antwort. In diesem Modus muss das Inferenzsystem nur die Batch-Größe so weit wie möglich auslasten, um den Durchsatz zu maximieren. Der KV-Cache wird nach einmaligem Laden freigegeben, sodass seine Auslastung von Natur aus niedrig ist. Die Lastmerkmale von Agent-Szenarien unterscheiden sich jedoch grundlegend von denen von Chat. Nehmen wir als Beispiel einen Coding-Agent: Das Modell muss kontinuierlich nachdenken, Tools aufrufen, Ergebnisse abrufen und auf der Grundlage der Ergebnisse weiter nachdenken. Der gesamte Prozess besteht aus Zyklen mehrerer kurzer Anfragen. Die erste Anfrage kann einen Präfix-Kontext von mehreren zehn Kilobyte enthalten, aber die Ausgabe jedes nachfolgenden Zyklus umfasst oft nur wenige Hundert Token. Das bedeutet, dass die Inferenz-Engine die Cache-Wiederverwendungsstrategie, den Anfrageplanungsmechanismus und die Optimierungszielfunktion des gesamten Systems neu bewerten muss.
In dieser Lastform steigt die Empfindlichkeit der Benutzer gegenüber der Latenz deutlich an. Wenn ein Agent-Tool im Inferenzschritt eine deutliche Verzögerung aufweist, empfindet der Benutzer dies intuitiv als mangelnde „Echtzeit-Reaktionsfähigkeit“. Daher muss in Agent-Szenarien tatsächlich der Durchsatz unter Latenzbeschränkungen optimiert werden. Intern haben wir einen Leistungsindikator definiert: Der TPS-Wert pro Benutzer darf nicht unter 70 liegen, und unter dieser Einschränkung soll der Durchsatz jeder GPU so weit wie möglich erhöht werden. Im Vergleich zu TensorRT-LLM als Referenz erreicht TokenSpeed im Szenario mit minimaler Latenz bei einer Batch-Größe von 1 eine um 9 % kürzere End-to-End-Latenz als TensorRT-LLM. Am typischen Arbeitspunkt mit 100 TPS pro Benutzer liegt der Durchsatz pro GPU um 11 % höher.
Die Wiederverwendungsrate des KV-Caches ist eine Schlüsselvariable, die die Inferenzkosten bestimmt. Bei DeepSeek wird angegeben, dass seine Cache-Wiederverwendungsrate über 99 % liegt, während die meisten Systeme in der Branche derzeit nur 70 % bis 80 % erreichen. In Agent-Szenarien bedeutet es, dass jeder Treffer den gesamten Prefill-Berechnungsaufwand vollständig einsparen und die Gesamtkosten des Systems stark senken kann, wenn derselbe Kontext von mehreren zehn Kilobyte wiederholt getroffen wird. Wir haben in Tests die Leistung von TokenSpeed überprüft, wenn die Kontextlänge von 128K auf 1M erweitert wird: Der Decode-Durchsatz sinkt nur um 16 %. Darüber hinaus ändert sich mit der zunehmenden Verwendung linearer Aufmerksamkeitsmechanismen in immer mehr Modellen, einschließlich des Gated DeltaNet von Qwen und des KDA, das von Kimi K3 verwendet wird, auch das Verwaltungsmodell des KV-Caches. Modelle mit linearer Aufmerksamkeit behalten keine herkömmliche 1:1-Entsprechung zwischen Token und KV bei, sondern stellen den Kontext durch einen kontinuierlich iterierten Zustand dar, der den SSM-Zustand und den Faltungszustand umfasst. Wie diese Zustände in der Inferenz-Engine effizient aktualisiert, gespeichert und wiederhergestellt werden können, ist eine neue Herausforderung im Systemdesign.
Die Kopplung zwischen Modellarchitektur und Hardwareeigenschaften nimmt gleichzeitig zu. Die MOE-Architektur ist seit der Veröffentlichung von DeepSeek zu einer gängigen Wahl geworden, aber die Optimierung von MOE-Modellen ist nicht einfach. Nehmen wir Kimi K3 als Beispiel: Dieses Modell verfügt über 896 Experten. Obwohl die Latent-MOE-Technologie die Schreibkosten stark senkt und den Anteil aktivierter Experten auf 16 % erhöht, steigt die Komplexität von Routing und Kommunikation erheblich. Gleichzeitig führt die Hardwaregeneration von Blackwell eine Reihe neuer Funktionen wie Tensor Memory und die neue Generation von Tensor Core ein, und die CDNA-Architektur von AMD verfügt über ihre einzigartigen Hardwarefähigkeiten. Wenn die Inferenz-Engine diese Hardwareeigenschaften nicht vollständig nutzen kann, kann der Leistungsvorteil von Blackwell gegenüber Hopper nicht wirklich freigesetzt werden. Basierend auf diesen Beobachtungen hat TokenSpeed auf Kernel-Ebene tiefgehende Optimierungen für Blackwell durchgeführt, um sicherzustellen, dass das Hardwarepotenzial vollständig ausgeschöpft wird.
Das kooperative Design von Runtime und Kernel darf ebenfalls nicht vernachlässigt werden. Selbst wenn der Planer optimal gestaltet ist, kann das Gesamtsystem nicht den idealen Zustand erreichen, wenn die untergeordneten Kernel Leistungsengpässe oder eine zu starke Kopplung aufweisen. Umgekehrt kann der Durchsatz nicht vollständig ausgelastet werden, selbst wenn der Kernel maximal optimiert ist, wenn der Planer viele Leerlaufphasen erzeugt. TokenSpeed hat bei seinem Architekturdesign die Erfahrungen aus diesem Bereich berücksichtigt und die Planung, Ausführung und untergeordneten Operatoren systematisch entkoppelt und neu strukturiert.
Runtime: Aufbau einer skalierbaren Inferenz-Engine-Architektur
Die Gesamtarchitektur von TokenSpeed gliedert sich in drei Ebenen: Steuerung, Runtime und Kernel. Die Steuerungsebene ist vollständig in C++ geschrieben, die Runtime wird in Python implementiert, und der Kernel ist als separates Unterpaket ausgegliedert. Das Kernziel dieses Schichtungsdesigns besteht darin, die Klarheit der Modulgrenzen zu wahren. Die Steuerungsebene ist nur für Planungsentscheidungen verantwortlich und führt keine Ausführung auf der Datenebene durch. Die Runtime ist nur für die Ausführung der von der Steuerungsebene übergebenen Ausführungspläne verantwortlich, einschließlich Cache-Plänen und Vorwärtsberechnungsplänen. Die Kernel-Ebene konzentriert sich auf die Implementierung von Operatoren. Die drei Ebenen erfüllen jeweils ihre eigenen Aufgaben und vermeiden die Wartungsprobleme, die in früheren Inferenz-Engines durch die gegenseitige Durchdringung von Planungslogik, Ausführungslogik und Operator-Implementierung verursacht wurden.
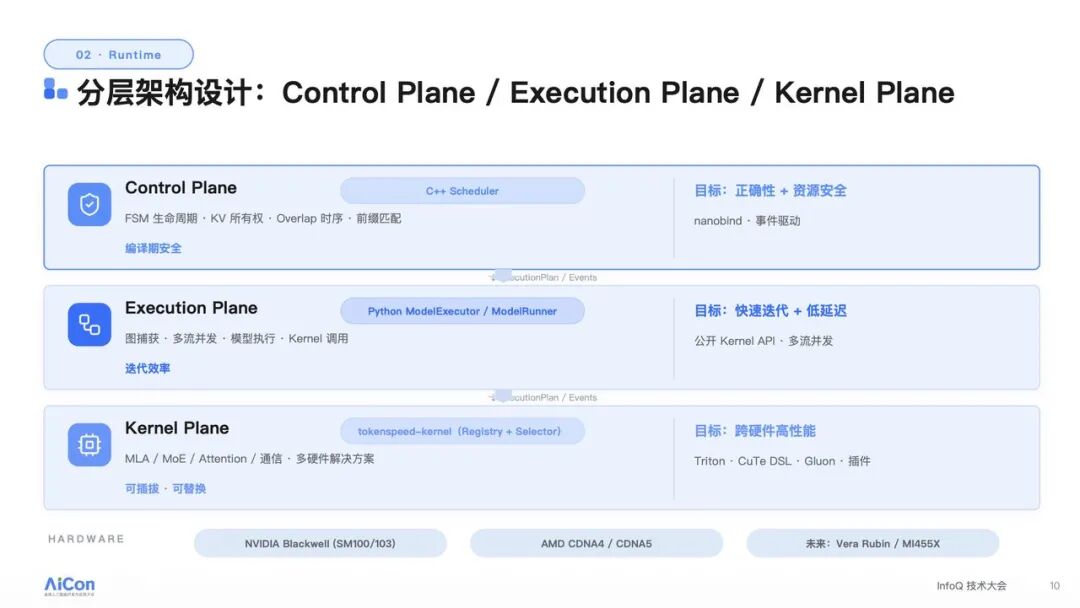
Dass die Steuerungsebene C++ anstelle von Rust wählt, hat praktische historische Gründe. Die meisten Teammitglieder stammen aus früheren Entwicklungsjahren und sind mit Rust nur begrenzt vertraut. C++ erfüllt die Anforderungen in Bezug auf Leistung und Ausdruckskraft vollständig, daher wurde schließlich C++ für die Programmierung der Steuerungsebene ausgewählt. Die Beibehaltung von Python für die Runtime liegt daran, dass das Python-Ökosystem im Bereich des tiefen Lernens sehr ausgereift ist, die Integration von Bibliotheken wie PyTorch und CUDA hoch ist und die Entwicklungseffizienz der Modellanpassungsschicht weitaus höher ist als bei anderen Sprachen. Nachdem das Kernel-Unterpaket ausgegliedert wurde, können Experten von NVIDIA und AMD tiefgehende Optimierungen für ihre jeweiligen Hardwareeigenschaften durchführen, ohne die interne Implementierung des Planers oder der Runtime verstehen zu müssen.
Ein weiterer Vorteil dieser geschichteten Architektur ist die Automatisierung der parallelen Kompilierung. Bei der Entwicklung früherer Inferenz-Engines waren die Codes für die parallele Aufteilung von Modellen oft über verschiedene Modellanpassungsmodule verteilt und eng mit der Implementierung von Aufmerksamkeit, MOE und Kommunikationslogik gekoppelt. Mit zunehmender Anzahl unterstützter Modelle werden diese verstreuten parallelen Codes immer schwieriger zu warten, und die Integration jedes neuen Modells kann Änderungen in mehreren Modulen erfordern. Der Ansatz von TokenSpeed besteht darin, die parallele Aufteilungslogik vollständig aus dem Modellanpassungscode zu extrahieren und ein unabhängiges Placement-System zu bilden. Modellentwickler müssen nur die Grenzen jedes Moduls, die Ein- und Ausgabetypen sowie die Attribute des Moduls in der parallelen Dimension (ob es sich um replicate, shard oder partial handelt) deklarieren, dann verarbeitet das System automatisch die nachfolgende Aufteilung und Kommunikation.
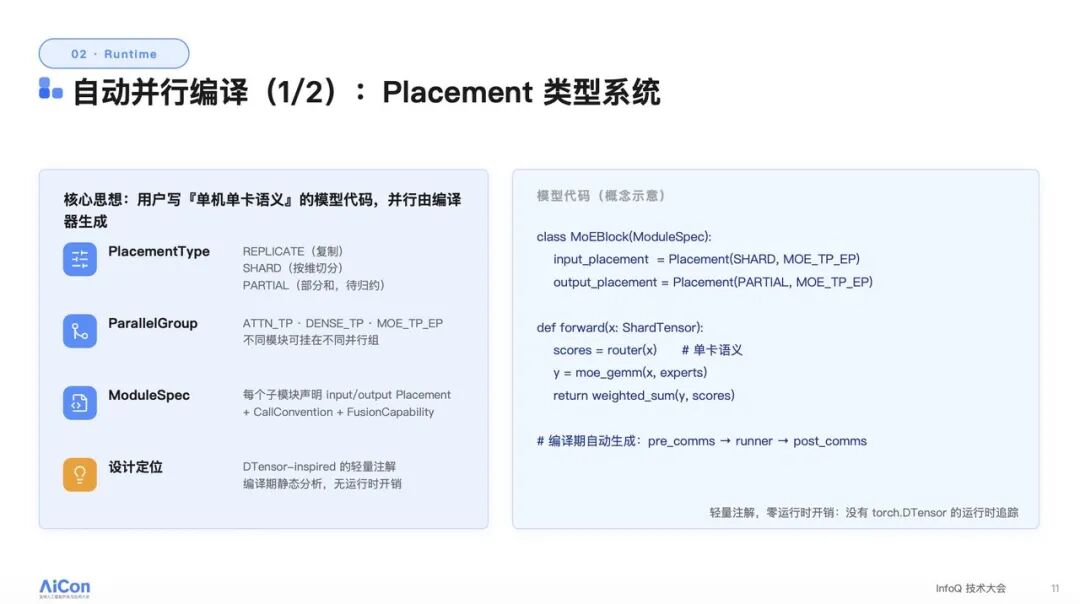
Konkret kann jedes Modul an verschiedene parallele Gruppen angehängt werden. Das Aufmerksamkeitsmodul wird an die Attention-Tensor-Parallel-Gruppe angehängt, das MOE-Modul an die MOE-Parallel-Gruppe, und jedes Modul wählt unabhängig seine parallele Strategie aus. Basierend auf diesen Placement-Definitionen durchläuft das Typkompilierungssystem von TokenSpeed den Ausführungsplan der gesamten Decode-Schicht und vergleicht die Placement-Unterschiede zwischen benachbarten Modulen. Wenn eine Inkonsistenz festgestellt wird, fügt das System automatisch die entsprechenden Kommunikationsprimitive ein: Von partial zu replicate ist all-reduce erforderlich, von shard zu replicate ist all-gather erforderlich, von shard zu partial ist reduce-scatter erforderlich. Die Ausgabe des gesamten Kompilierungsprozesses ist ein einheitlicher Ausführungsplan für compiled_decoder_layer, der zur Laufzeit in drei Phasen integriert wird: In der Prefill-Phase wird die vorangehende Kommunikationsausrichtung durchgeführt, dann werden die Modelloperatoren ausgeführt und schließlich die Kommunikationsausgabe ausgeführt. Diese automatisierte parallele Kompilierung senkt nicht nur die Wartungskosten für die Modellanpassung erheblich, sondern ermöglicht auch die Fusion zwischen benachbarten Operatoren, da das Typsystem vorab Informationen bereitstellt, wodurch der Overhead des Kernel-Launchs reduziert und die Leistung positiv beeinflusst wird.
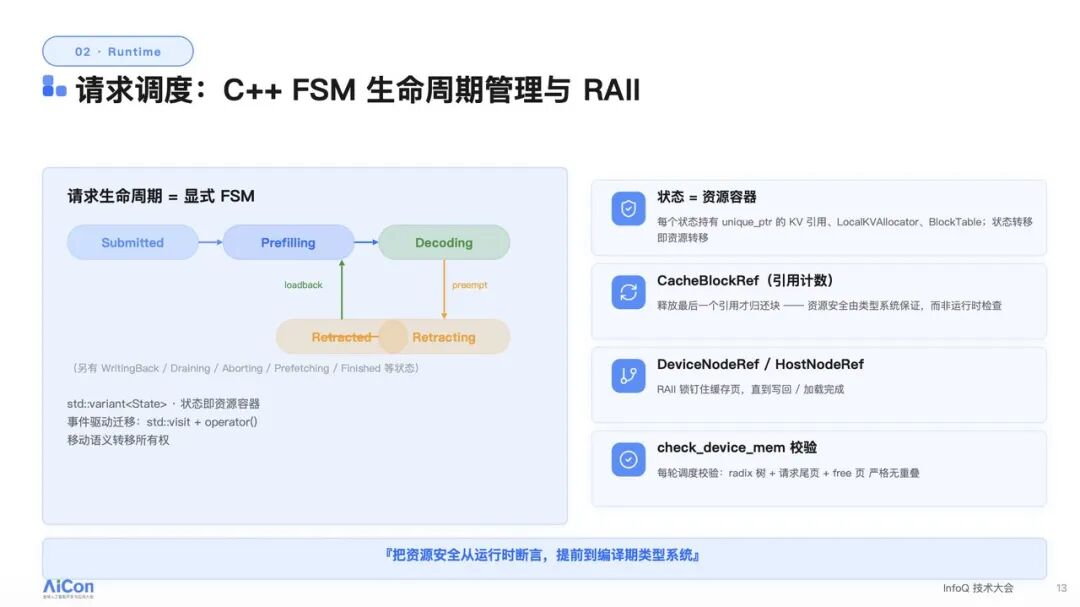
Das Herzstück der Steuerungsebene ist ein Zustandsautomat, der den gesamten Lebenszyklus einer einzelnen Anforderung abdeckt. Eine Inferenzanfrage durchläuft von ihrer Eingabe bis zu ihrem Abschluss unvermeidlich mehrere Schlüsselzustände: submitted, prefilling, decoding, retracting/timeout und finished. Jeder Zustand selbst ist ein Ressourcencontainer, der Ressourcen wie KV-Seitenverweise und die Slot-Liste für SSM/MLA hält, die für diesen Zustand erforderlich sind. Wenn der Zustand wechselt, wird das Eigentum an diesen Ressourcen gleichzeitig an den nächsten Zustand übergeben. Die gesamte Steuerungsebene ist ein kontinuierlich laufendes Zustandsautomatsystem.
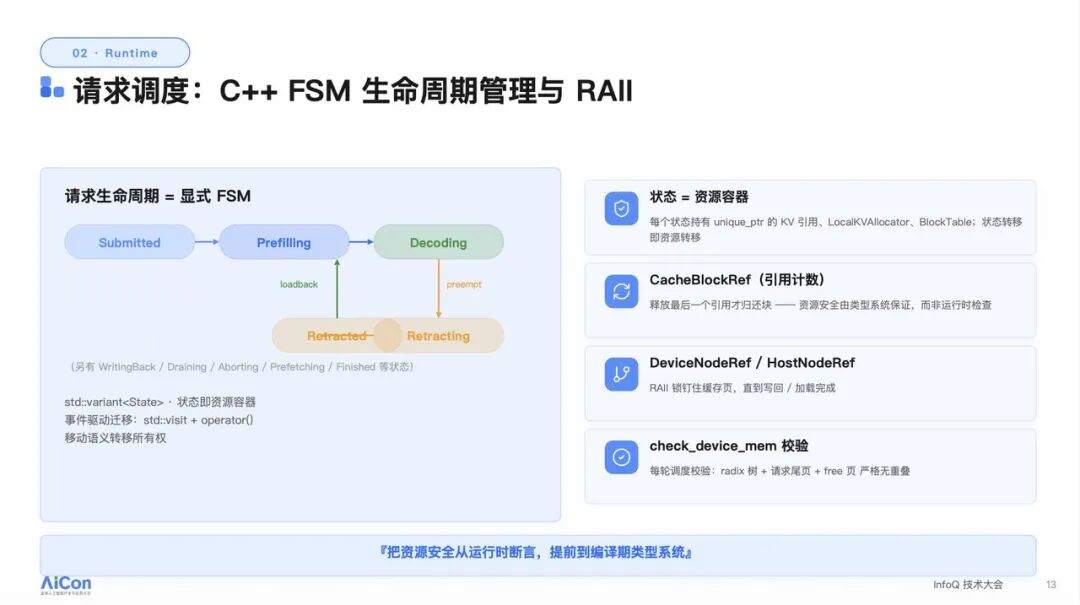
Der Zustandsübergang erfolgt über einen ereignisgesteuerten Mechanismus. Jedes Ereignis trägt den entsprechenden C++-Operator, und während des Zustandsübergangs wird das Eigentum an den Ressourcen über die unique_ptr-Move-Semantik von C++ übergeben. Der clevere Punkt dieses Designs besteht darin, das Laufzeitproblem der Ressourcenverwaltung bereits zur Kompilierzeit zu lösen. Wenn der Code kompiliert wurde, hat der Compiler tatsächlich Probleme wie Ressourcenlecks und Ressourcenzuweisungsfehler überprüft, da alle Ressourcenübertragungspfade im Typsystem explizit definiert und überprüft werden. Die Ressourcen selbst werden nach dem RAII-Prinzip (Resource Acquisition Is Initialization) verwaltet. Sowohl der Referenzzähler des Cache-Blocks als auch der Referenzzähler von Device Node oder Host Side werden nicht vorzeitig freigegeben, bevor die Datenübertragung oder -operation abgeschlossen ist.
Das Zustandsautomat-Design der Steuerungsebene ist vollständig von der Ausführungsebene entkoppelt. Der Planer muss sich nur darauf konzentrieren, wann die Anfrage vom Prefilling-Zustand in den Decoding-Zustand überführt wird und wann ein Retrigger ausgelöst werden muss, ohne sich darum zu kümmern, wie der untergeordnete Kernel die spezifische Berechnung durchführt. Diese Entkopplung ermöglicht es, die Planungsstrategie unabhängig zu iterieren, ohne sie häufig anpassen zu müssen, wenn sich die untergeordneten Operatoren ändern. Die Runtime-Schicht empfängt den Ausführungsplan von der Steuerungsebene, führt die Berechnung in der im Plan definierten Reihenfolge und mit der festgelegten Ressourcenkonfiguration durch und gibt die Ergebnisse nach Abschluss der Ausführung an die Steuerungsebene zurück, um den Zustandsautomaten weiterlaufen zu lassen.
In der praktischen Ingenieurarbeit reduziert dieses Zustandsautomat-Design die Wettlaufsituationen und Ressourcenlecks bei der Planung gleichzeitiger Anfragen erheblich. Ressourcenverwaltungsfehler, die früher bei Implementierungen in Python häufig auftraten, z. B. dass KV-Seiten nach dem Abbrechen einer Anfrage nicht rechtzeitig zurückgegeben wurden oder dass der Referenzzähler im Ausnahmepfad nicht korrekt dekrementiert wurde, wurden in der C++-Implementierung durch Kompilierzeitprüfungen und den RAII-Mechanismus systematisch gelöst. Dies ist auch eines der Kernmotive, warum wir die Steuerungsebene vollständig in C++ neu geschrieben haben.
Die KV-Cache-Verwaltung ist eines der Module, in das das Team bei der Architekturgestaltung von TokenSpeed am meisten Aufwand gesteckt hat. Die Präfixwiederverwendung in Agent-Szenarien stellt weitaus höhere Anforderungen an das Cachesystem als herkömmliche Chat-Szenarien. Derselbe Agent-Anfrage enthält während eines vollständigen Arbeitsablaufs wiederholt denselben Präfix-Kontext. Wenn bei jedem Zyklus der Prefill-Schritt neu berechnet werden muss, steigen die Inferenzkosten drastisch an.
In der ersten Implementierung haben wir uns von der Idee von SGLang inspirieren lassen und einen Radix Tree als Verwaltungsstruktur für den Präfix-Cache verwendet. Das Design des Radix Tree zielt darauf ab eine baumartige Struktur von der Wurzel bis zum Blatt zu pflegen, wobei jeder Knoten im Baum einer Token-Sequenz entspricht und alle Präfixabgleiche der Anfragen auf diesem Baum durchgeführt werden. Dieses Design funktioniert in reinen Aufmerksamkeitsszenarien gut, aber als wir begannen, Kimi K3 anzupassen, stellten wir fest, dass die Semantik des Radix Tree mit einigen neuen Aufmerksamkeitsmustern in Konflikt steht. Mamba-ähnliche Modelle und Sliding-Window-Aufmerksamkeit zerstören von Natur aus die hierarchische Abgleichannahme, auf der der Radix Tree basiert: Ihr Cache-Zugriffsmuster ist keine einfache lineare Erweiterung vom Präfix zum Suffix.
Diese Erfahrung veranlasste uns, das KV-Cache-Verwaltungssystem neu zu strukturieren. Während der Unterstützung von Kimi K3 haben wir den ursprünglichen Radix Tree vollständig auf das Flat-KV-Design migriert. Das neue Cachesystem erkennt den Aufmerksamkeitstyp des Caches nicht mehr. Es fordert nur, dass die oberen Schichten verschiedene Arten von Caches in einem einheitlichen Format an das System melden und ihren jeweiligen Typ und belegten Speicherplatz deklarieren. Die untere Ebene packt alle Caches einheitlich in Blöcke gleicher Größe und führt eine flache Speicherverwaltung durch. Die erste Version von K3 verwaltet Blöcke mit 1536 Token