Erstmaliges gemeinsames öffentliches Auftreten nach der Übernahme im Wert von 54,7 Milliarden Yuan: Li Feifei führt einen Dialog mit Lisa Su und erläutert das vereinheitlichte Weltmodell Atlas im Detail.
Robotik-Vorausschau berichtet am 12. November: Heute, auf der CoRL 2026, hielt Li Fei-Fei einen Vortrag mit dem Titel „Atlas: Ein einheitliches Weltmodell für Generierung und Rekonstruktion“, anschließend führte sie ein Kamingespräch mit Lisa Su, Vorsitzende und CEO von AMD. Dies ist der erste öffentliche gemeinsame Auftritt der beiden, seit AMD die Übernahme von World Labs angekündigt hat.
Dieses Jahr im September kündigte AMD an, eine endgültige Übernahmevereinbarung mit World Labs getroffen zu haben. Der Transaktionswert beträgt etwa 8,2 Milliarden US-Dollar (rund 54,7 Milliarden Yuan) und soll bis Ende 2026 abgeschlossen werden.
Li Fei-Fei nannte in ihrem Vortrag folgende Schwerpunkte:
1. Im Bereich der Robotik sind das Verstehen und Darstellen der Umgebung, die Vorhersage möglicher Folgen von Aktionen sowie die Ergänzung von Echtweltdaten durch Simulation drei Kernprobleme, die Roboter lösen müssen.
2. Die drei Modi von Atlas sind: Dichte Rekonstruktion mit mehreren Bildeingaben, reine Generierung bei Null-Pixel-Bedingungen und spärliche Rekonstruktion mit wenigen Ansichten.
3. Technisch verfolgt Atlas eine multimodale autoregressive Diffusions-Transformer-Architektur, deren Kern darin besteht, die Vorhersage der nächsten Ansicht über Kamerabedingungen zu steuern.
Es kann nicht nur dichte Rekonstruktionen anhand einer großen Anzahl von Bildern durchführen, sondern auch spärliche Rekonstruktionen mit nur wenigen Bildern durchführen und sogar Szenen generieren, wenn keine Bildeingaben vorhanden sind und nur Text-Prompts vorliegen.
4. Li Fei-Fei gab außerdem bekannt, dass derzeit der praktische Wert von Atlas in der Robotersimulation getestet wird. Atlas kann nicht nur dreidimensionale Umgebungen generieren und rekonstruieren, sondern auch für Robotertraining und Navigation verwendet werden, um die reale Welt mit der Simulationswelt zu verbinden und die Simulationsergebnisse dann auf echte Roboter anzuwenden.
Gleichzeitig zeigte Li Fei-Fei in ihrem Vortrag entsprechende Erkundungen: Roboter können vollständig in einer virtuellen Simulationsumgebung trainiert und anschließend im Null-Shot-Verfahren in der realen Welt eingesetzt werden.
5. Abschließend betonte Li Fei-Fei, dass Atlas im Rapidata-Kamerabewegungs-Benchmark den ersten Platz belegt.
In der Phase des Rundtischgesprächs prognostizierte Lisa Su gleich zu Beginn die Zukunft des Robotikbereichs und erklärte, dass physische KI, insbesondere Roboter, eine Chance von mehreren hundert Milliarden US-Dollar in den nächsten Jahren darstelle, und sie enthüllte, dass AMD bereits über ein recht großes Robotik-Forschungsteam verfügt, die entsprechenden Planungen aber noch in einem frühen Stadium sind.
Li Fei-Fei stellte die Ansicht auf, dass „KI gleich Berechnung und Berechnung gleich KI“ sei, und vertrat die Meinung, dass Spitzen-LLMs/VLMs und spezialisierte Modelle jeweils ihre eigenen Stärken haben.
In diesem Prozess forderten beide Seiten dazu auf, Forscher im öffentlichen Sektor mehr Rechenleistung zur Verfügung zu stellen. Man müsse die Kräfte des öffentlichen Sektors nutzen, um zu verstehen und zu bewerten, was KI tut, Benchmark-Tests durchzuführen und der Öffentlichkeit Informationen zur Verfügung zu stellen, um ihr das Verständnis zu erleichtern.
Im Folgenden das Protokoll des Vortrags und des Rundtischgesprächs:
Heute möchte ich mit Ihnen teilen, dass das Forschungsteam von World Labs kürzlich ein Modell namens Atlas entwickelt hat. Dies ist ein einheitliches Weltmodell für Generierung und Rekonstruktion (A Unified World Model for Generation and Reconstruction).
Da wir heute vor Ort auf der CoRL-Konferenz sind, beginnen wir mit den Anforderungen im Robotikbereich.
Ich weiß, dass im Bereich der Robotik viele Veränderungen stattfinden und viele Fortschritte erzielt werden. Noch vor einem Tag haben wir neue Forschungsergebnisse gesehen. Egal welchen technischen Weg wir in der Robotik wählen, egal ob wir Policy Learning verwenden oder nicht, egal ob wir Agenten verwenden oder nicht, es gibt ein grundlegendes Problem, das der Robotikbereich zu lösen versucht:
Angesichts des aktuellen Zustands der Welt, der Aufgabenziele und des Roboters selbst: Was sollte der Roboter in jedem Moment als Nächstes tun?
Im Allgemeinen müssen Roboter mehrere grundlegende Probleme lösen.
Erstens müssen Roboter die Fähigkeit besitzen, den Zustand der Welt und die Umgebung um sie herum zu verstehen und darzustellen. Wir können diskutieren, ob diese Darstellung implizit oder explizit sein soll, aber das Verständnis der Umgebung selbst ist sehr wichtig.
Zweitens müssen Roboter in der Lage sein, die möglichen Folgen von Aktionen vorherzusagen und diese Aktionen auf irgendeine Weise zu planen.
Schließlich ist Daten immer ein Problem. Der Robotikbereich weist eine sehr lange Long-Tail-Verteilung auf, und für den erfolgreichen Einsatz von Robotern stehen ebenfalls eine große Anzahl von Long-Tail-Szenarien an. Daher ist es in vielen Fällen sehr wertvoll, wenn man durch Simulation so viele verschiedene Umgebungen und Zustände wie möglich generieren kann, um Echtweltdaten zu ergänzen. Das hilft sowohl beim Modelltraining als auch bei der Modellbewertung.
Egal welchen Ansatz wir wählen, diese drei Probleme bleiben im Robotikbereich bestehen.
Das bringt mich auch auf Weltmodelle. Tatsächlich entsprechen die drei oben genannten Probleme genau den drei Problemen, die Weltmodelle zu lösen versuchen.
Zum Beispiel entspricht das Verstehen und Darstellen der Umgebung dem Rendering-Problem in Weltmodellen und visuellen Modellen; die Vorhersage der Folgen von Aktionen entspricht dem Planungsproblem; die Simulation verschiedener Zustände in der Welt entspricht dem Simulationsproblem.
Natürlich möchte ich diese Probleme nicht absolut setzen und glaube auch nicht, dass sie völlig unabhängig voneinander sind. Tatsächlich können wir sie in vielen Fällen vereinheitlichen, und diese Probleme sind auch miteinander verflochten. Das sind alles sehr aufregende Spitzenrichtungen in diesem Forschungsbereich.
01. Atlas versucht, Generierung und dreidimensionale Rekonstruktion zu vereinheitlichen
Heute möchte ich mich auf Atlas konzentrieren. Dies ist ein neues Modell, das wir gerade vorgestellt haben.
Im Großen und Ganzen widmet sich Atlas hauptsächlich der Lösung von Rendering- und Simulationsproblemen, insbesondere der Simulation von Weltgeometrien sowie dreidimensionalen und vierdimensionalen dynamischen Prozessen.
Einfach ausgedrückt ist Atlas ein autoregressives Grundmodell (Autoregressive Foundation Model), das von Grund auf neu trainiert wurde. Es ist ein vollständiges Modalmodell, das multimodale Eingaben akzeptieren kann, darunter Text, Bilder, Videos, Tiefensignale, Grayboxing und dreidimensionale Struktursignale.
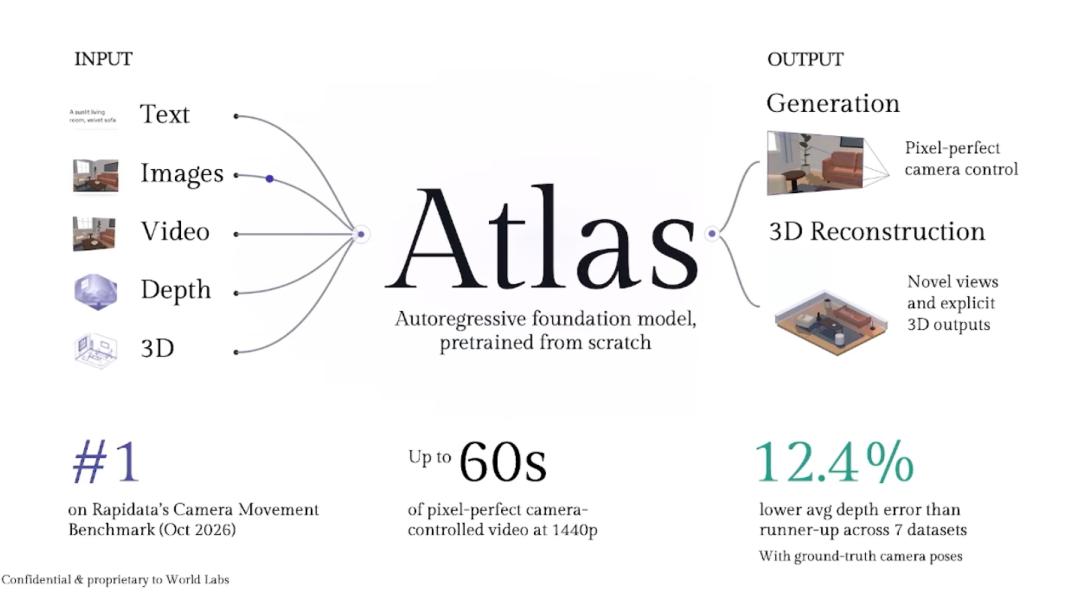
Seine Ausgabe sind Pixel-Frames. Atlas kann jedoch nicht nur hochwertige Bildframes mit räumlich-zeitlicher Konsistenz generieren, sondern auch neue Ansichten synthetisieren, um eine präzise, hochgenaue dreidimensionale Rekonstruktion zu erreichen.
Im Folgenden werde ich einige experimentelle Ergebnisse und spezifische Details zeigen. Zuerst stelle ich Ihnen die Gesamtfähigkeiten von Atlas vor.
Lassen Sie uns zuerst die Entwicklung der entsprechenden Forschung Revue passieren lassen.
Im Bereich des Computersehens gibt es zwei sehr wichtige Probleme. Das sind natürlich nicht die einzigen zwei Probleme im Bereich des Computersehens, aber sie sind wirklich sehr wichtig. Forscher haben viele Jahre, sogar Generationen damit verbracht, diese Probleme zu untersuchen.
Eines davon ist das dreidimensionale Rekonstruktionsproblem. Die von mir hier gezeigten Forschungen umfassen sowohl die klassische Arbeit „Building Rome in a Day“ als auch aktuelle hochmoderne Forschungen, beispielsweise Arbeiten zu NeRF.
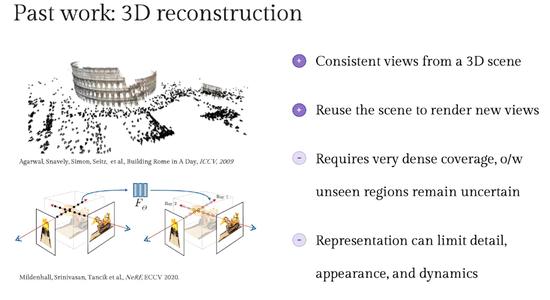
Das grundlegende Problem, das wir zu lösen versuchen, lautet: Wie baut man eine dreidimensionale Szene auf, die der realen Welt entspricht, anhand von Bildern, die von verschiedenen Kamerapositionen und -haltungen aufgenommen wurden?
Die meisten herkömmlichen Methoden erfordern eine große Anzahl von Bildern mit Kamerapose-Informationen.
Wenn diese Kameraperspektiven nicht die gesamte Oberfläche der Szene abdecken, wird die Rekonstruktion sehr schwierig, und das Modell kann die nicht abgedeckten Bereiche nur schwer genau schätzen. Daher weisen die endgültigen dreidimensionalen Rekonstruktionsergebnisse oft große Unsicherheiten auf.
Das ist das klassische dreidimensionale Rekonstruktionsproblem.
In den letzten Jahren hat die generative KI jedoch große Fortschritte gemacht. Heute verfügen wir über reine Generierungsmodelle, die direkt hochwertige Pixelinhalte generieren können.
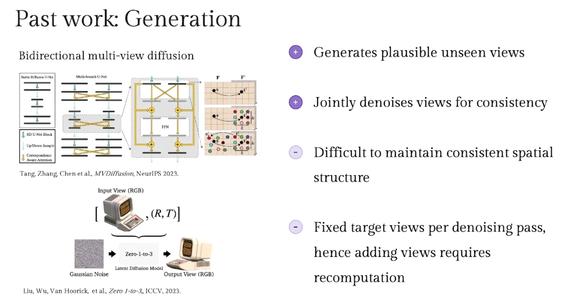
Gleichzeitig bietet die auf Diffusionsmodellen basierende Backbone-Architektur neue Forschungsrichtungen für die Mehransichtsgenerierung und verringert die Distanz zwischen Generierung und Rekonstruktion weiter.
Entlang dieser Forschungslinie sind bereits einige hervorragende Arbeiten entstanden. Sie versuchen, zuvor nicht beobachtete Ansichten zu generieren und die räumliche Konsistenz durch gemeinsames Entrauschen mehrerer Ansichten zu wahren.
Im Großen und Ganzen sind die Effekte dieser Methoden jedoch immer noch begrenzt. Sie haben nach wie vor Schwierigkeiten, die räumliche Konsistenz aufrechtzuerhalten, und jeder Entrauschvorgang kann normalerweise nur auf eine feste Zielansicht abzielen. Wenn Sie die Ansicht ändern oder Echtzeitgenerierung erreichen möchten, werden die Rechenkosten sehr hoch.
Atlas erforscht weiter entlang einer Reihe von Forschungsrichtungen der letzten Jahre und versucht, Generierung und Rekonstruktion zu vereinheitlichen.
Unser Ziel ist es, mit derselben Modellarchitektur und demselben Trainingsschema beide Probleme gleichzeitig zu lösen.
Konkret kann Atlas zwischen den beiden Richtungen Generierung und Rekonstruktion wechseln.
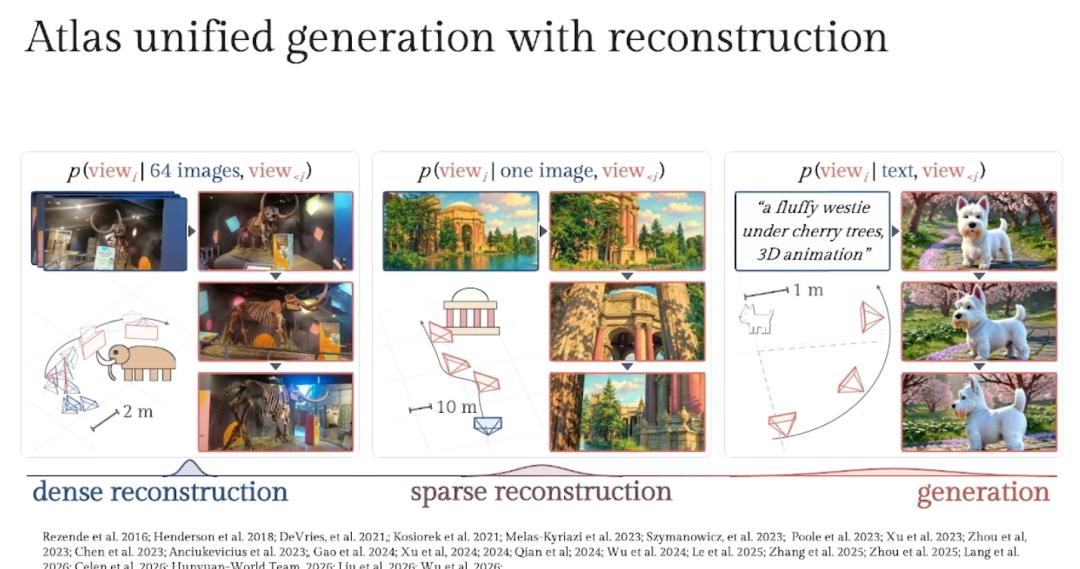
In einem Extremfall, wenn Atlas mehrere Eingabebilder erhält und die Anzahl der Bilder ausreichend groß ist, kann es Rekonstruktionsaufgaben ausführen. Das Modell kann dichte Rekonstruktionen durchführen und qualitativ hochwertige Szenen- und Weltstrukturen ausgeben.
Im anderen Extremfall, wenn keine Pixel-Bedingungseingaben vorhanden sind und nur ein Text-Prompt bereitgestellt wird, kann Atlas reine Generierungsaufgaben ausführen. Es kann auch mehrere fortlaufende Bilder mit Ansichtskonsistenz generieren.
Noch interessanter ist, dass Atlas auch eine Aufgabe erfüllen kann, die Generierung und Rekonstruktion verbindet, die wir als Sparse Reconstruction (spärliche Rekonstruktion) bezeichnen.
In diesem Fall erhält Atlas eine sehr begrenzte Anzahl von Ansichten. Im Extremfall ist die Eingabe sogar nur ein einziges Bild.
Atlas kann die Kamerapose schätzen, dann mehrere Ansichten generieren, die innerhalb der Fähigkeiten des Modells liegen, und schließlich eine vollständige Welt rekonstruieren und generieren.
Daher kann Atlas im selben Modellrahmen den Wechsel von dichter Rekonstruktion zu spärlicher Rekonstruktion und dann zu reiner Generierung realisieren.
02. Selbst mit wenigen Bildern kann eine vollständige Welt rekonstruiert werden
Bevor ich auf die technischen Details eingehe, zeige ich Ihnen zuerst ein Beispiel. Einige von Ihnen hier sollten erkennen, dass dies der Campus der Stanford University ist.
Stanford hat einen sehr berühmten Hauptplatz (Main Quad).
Wenn Sie dem Modell nur zwei begrenzte Eingabebilder geben, generiert es oder ergänzt einen Hauptplatz.
Wenn Sie die Stanford University kennen, werden Sie feststellen, dass dies nicht unser echter Hauptplatz ist. Es wirkt wie der Hauptplatz, ist aber in Wirklichkeit nicht der echte Hauptplatz.
Das Modell führt bedingte Generierung basierend auf Merkmalen wie den langen Gängen in den Eingabebildern durch, sodass die generierte Szene einige Merkmale der langen Gänge behält und auch Bögen auftauchen, aber insgesamt ist es immer noch ein Platz, der basierend auf der Eingabe generiert wurde.
Wenn Sie dem Modell acht Bilder geben, ist der Effekt viel besser.
Angesichts der Tatsache, dass dieser Raum selbst sehr groß ist, sind die Informationen, die acht Bilder liefern, immer noch sehr spärlich. Aber bei genauer Betrachtung hat das Modell im Grunde den gesamten Platz rekonstruiert.
Auf den ersten Blick ist es fast perfekt. Aber Leute, die die Stanford University kennen, werden feststellen, dass die berühmte Memorial Church verschwunden ist. Das liegt daran, dass die Eingabebilder die Memorial Church nicht enthalten.
Schließlich, wenn 33 Bilder eingegeben werden, sind diese Bilder im Verhältnis zur Größe des gesamten Raums immer noch sehr spärlich, viele Bereiche sind nicht abgedeckt, aber eines der Bilder enthält tatsächlich die Memorial Church.
Daher kann Atlas im Grunde den wunderschönen Hauptplatz der Stanford University rekonstruieren.
Ich möchte besonders betonen: Diese 33 Bilder wurden alle in Bodenhöhe aufgenommen, also normale Bilder, die eine Person mit einer Kamera in der Hand aufnimmt.
Aber das Modell kann verschiedene Beobachtungsansichten generieren, einschließlich der Luftaufnahme, die ich jetzt zeige.
Was ist also der technische Schlüssel, der es Atlas ermöglicht, dies zu erreichen?
03. Ansichtsvorhersage ist die Kerntechnologie von Atlas
Für große Sprachmodelle (