Gerade hat Google sein erstes Entscheidungsmodell Gemini Decision 1 vorgestellt: Es erzielte in 9 Tests 7 erste Plätze, wobei die höchste Genauigkeit bei 92,2 % liegt.
Während die gesamte KI-Branche noch darum wetteifert, wer mehr Token generieren kann und über stärkere Schlussfolgerungsfähigkeiten verfügt, hat Google ein neues Modell auf den Markt gebracht, das Antworten nicht wortwörtlich generiert.
Gerade hat Google Gemini Decision 1 offiziell veröffentlicht und gleichzeitig die von diesem Modell angetriebene Gemini Decisions API vorgestellt. Im Gegensatz zu herkömmlichen generativen großen Modellen ist dieses Modell speziell für schnelle Entscheidungen ausgelegt: Es generiert keinen Text Token für Token, sondern bewertet vordefinierte Kandidatenantworten durch eine einzelne Vorwärtspropagation.
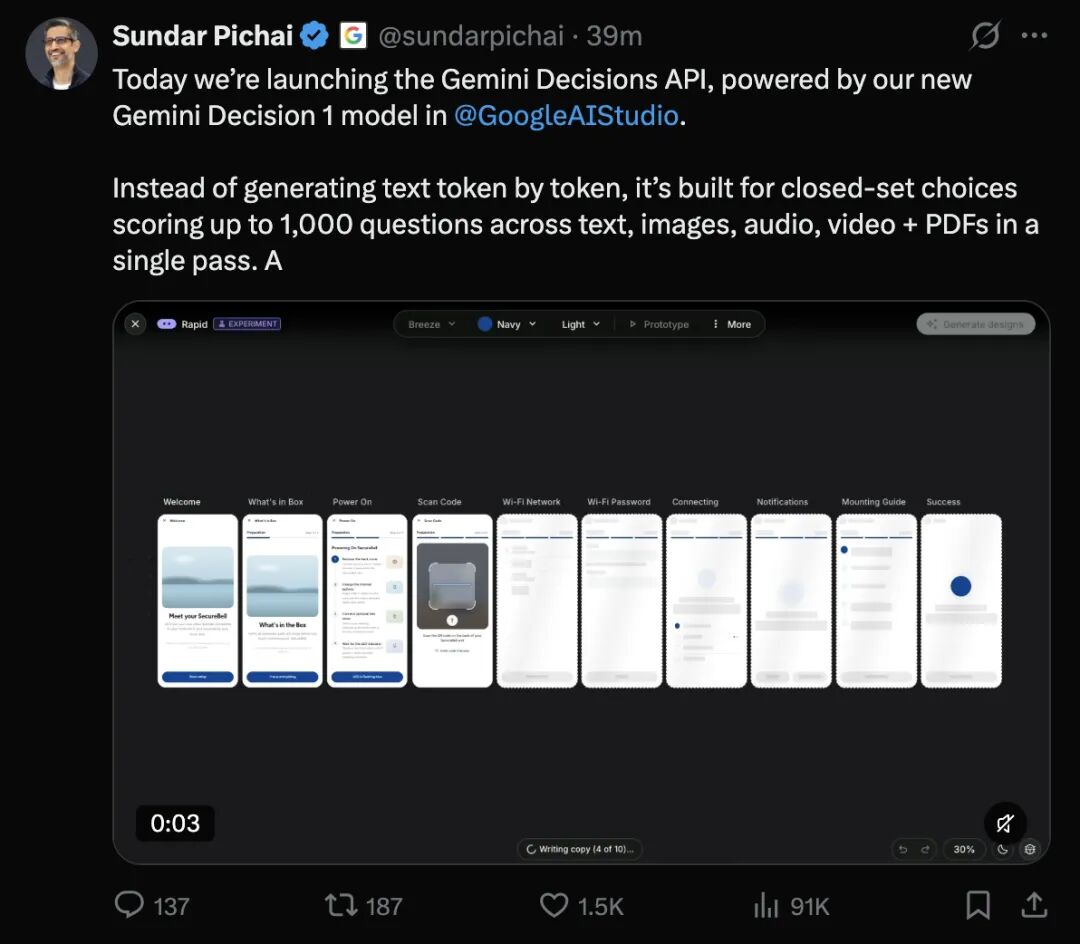
Googles CEO Sundar Pichai hat auch auf der Plattform X einen Beitrag veröffentlicht, der die Hauptfähigkeiten von Gemini Decision 1 vorstellt. Er schrieb:
Heute führen wir die Gemini Decisions API offiziell in Google AI Studio ein, die vom brandneuen Gemini Decision 1 Modell unterstützt wird.
Im Gegensatz zu herkömmlichen Modellen, die Text Token für Token generieren, ist dieses Modell speziell für Entscheidungsaufgaben in geschlossenen Optionssätzen konzipiert. Es kann in einem einzigen Verarbeitungsvorgang bis zu 1000 Fragen in Text, Bildern, Audio, Videos und PDF-Dateien bewerten.
Hier sind einige bemerkenswerte Details:
· Es unterstützt drei Arten von Entscheidungen: Ja/Nein-Beurteilungen, Multiple-Choice-Fragen (bis zu 255 Optionen) sowie Bewertungen anhand von Bewertungsstandards;
· Der Preis für eine Million Eingabe-Token beträgt nur 0,10 US-Dollar, es fallen keine Kosten für Ausgabe-Token an – die Kosten betragen etwa ein Fünftel von Flash-Lite;
· Es liegt bei mehreren Benchmark-Bewertungen an der Spitze und weist gleichzeitig den niedrigsten Kalibrierungsfehler auf.
Interne Teams von Google haben bereits begonnen, diese Technologie zu nutzen.
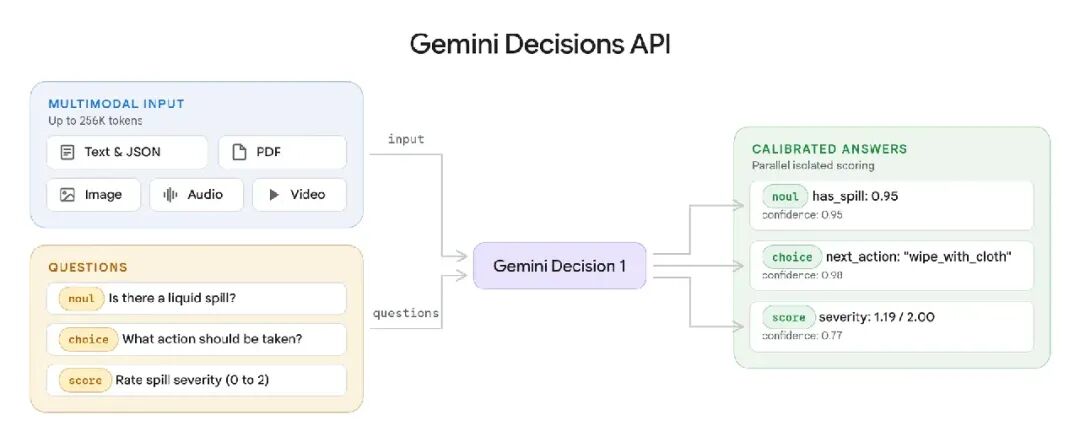
Früher, wenn Entwickler von einer KI verlangen wollten, zu beurteilen, ob eine E-Mail Spam ist oder welcher Agent eine bestimmte Aufgabe übernehmen soll, mussten sie oft ein generatives großes Modell aufrufen und dann das Ergebnis aus dem vom Modell generierten Text extrahieren. Gemini Decision 1 erspart den schrittweisen Dekodierungsprozess Wort für Wort.
Entwickler müssen nur den Eingabeinhalt, die zu beurteilende Frage und die Kandidatenoptionen angeben – das Modell gibt direkt das entsprechende Beurteilungsergebnis, die Wahrscheinlichkeit und das Konfidenzniveau zurück.
Das bedeutet, dass die KI für Aufgaben, die ursprünglich nur ein Klassifizierungs-, Bewertungs- oder Auswahlergebnis erfordern, nicht mehr den gesamten vollständigen Textgenerierungsprozess durchlaufen muss.
Laut den von Google veröffentlichten Daten kann Gemini Decision 1 in einer einzigen Anfrage bis zu 1000 unabhängige Fragen verarbeiten, unterstützt multimodale Eingaben wie Text, Bilder, Audio, Videos und PDFs und weist eine End-to-End-Latenz von nur 150 bis 250 Millisekunden auf.
Die Preisgestaltung ist ebenfalls sehr aggressiv: Eine Million Eingabe-Token kostet nur 0,10 US-Dollar, für Ausgabe-Token fallen keine Gebühren an. Bei derselben von Google veröffentlichten Benchmark-Serie sind die Aufrufkosten fast 5 Mal niedriger als bei Gemini 3.5 Flash-Lite.
Noch bemerkenswerter ist, dass dies nicht nur ein Modell zur Beantwortung von Multiple-Choice-Fragen ist. Google hat es bereits in Szenarien wie der KI-Modell-Route, der Auswahl von Agent-Tools, dem Produktdesign und der Sicherheitserkennung eingesetzt, um es zu einer untergeordneten Komponente zu machen, die in KI-Systemen speziell für Beurteilungen und Entscheidungen zuständig ist.
1000 Fragen in einem Durchgang verarbeiten, bis zu 255 Optionen
Laut der von Google veröffentlichten technischen Einführung bietet Gemini Decision 1 drei Kernfähigkeiten für Entscheidungen.
Die erste Kategorie ist Ja/Nein (binäre Beurteilung). Zum Beispiel die Beurteilung, ob ein Sicherheitsrisiko in einem Bild vorliegt oder ob ein Text gegen festgelegte Regeln verstößt. Das Modell gibt die Wahrscheinlichkeit an, dass die entsprechende Bedingung erfüllt ist.
Die zweite Kategorie ist Multiple Choice (Mehrfachauswahl). Entwickler können 2 bis 255 Kandidatenoptionen vordefinieren – das Modell wählt nicht nur die am besten passende Antwort aus, sondern gibt auch die normalisierte Wahrscheinlichkeit für jede Kandidatenoption zurück.
Die dritte Kategorie ist Ordered Rubric (geordnete Standardbewertung). Entwickler können Bewertungsstandards für verschiedene Stufen selbst definieren, das Modell den Eingabeinhalt bewerten lassen und einen kontinuierlichen gewichteten Score sowie die Wahrscheinlichkeit jeder Stufe zurückgeben.
Die drei Arten von Aufgaben können auch in einer einzigen Anfrage gemischt ausgeführt werden.
Google stellt ein einfaches Beispiel vor: Man lädt ein Foto der Arbeitsplatte im Büro-Teeraum für das Modell hoch, fügt eine Textbeschreibung hinzu und verlangt, gleichzeitig zu beurteilen, ob Flüssigkeit auf dem Tisch verschüttet wurde, welche Reinigungsmaßnahmen ergriffen werden sollen und wie schwer die Situation vor Ort ist.
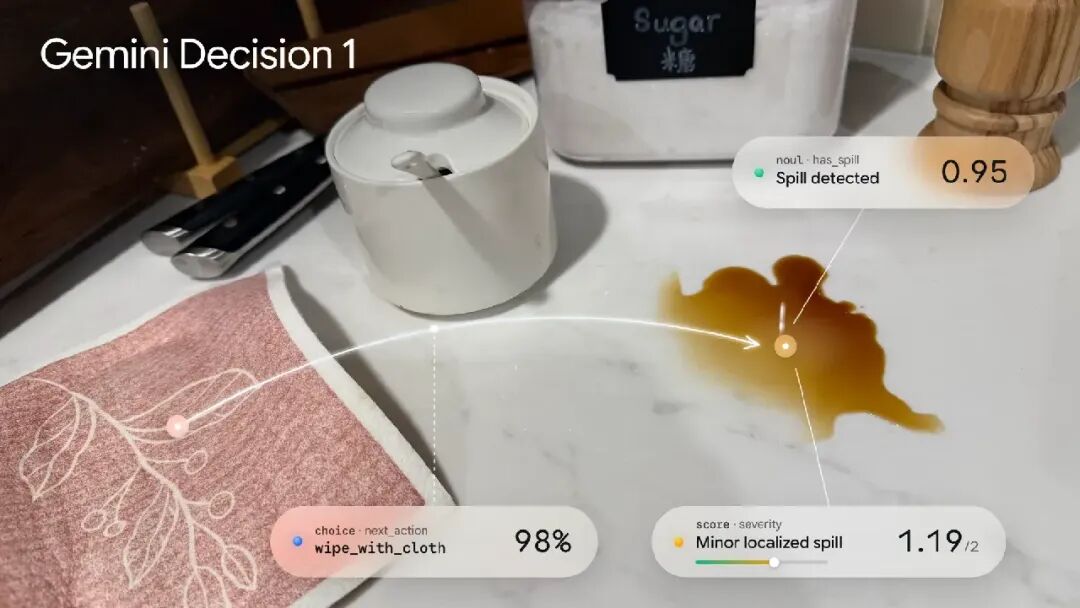
Bei herkömmlichen Verfahren müssten möglicherweise mehrere Klassifikatoren entworfen oder verschiedene Prompt-Aufgaben über ein generatives großes Modell ausgeführt werden. Gemini Decision 1 kann diese Beurteilungen in einer einzigen Anfrage erledigen.
Darüber hinaus unterstützt das Modell einen multimodalen Eingabekontext von bis zu 256K Token. Für Unternehmensszenarien bedeutet dies, dass Entwickler Anrufaufzeichnungen und Kundendaten gemeinsam analysieren oder Versicherungsanspruchsdokumente mit Fotos vor Ort kombinieren können, um Beurteilungen zu treffen.
Jede Entscheidung wird mit einem Konfidenzniveau von 0 bis 1 versehen, sodass das System unsichere Ergebnisse an andere Modelle oder eine manuelle Prüfung weiterleiten kann.
Ein weiterer Wettbewerbsvorteil von Gemini Decision 1 ist Geschwindigkeit und Kosten.
Laut offiziellen Angaben von Google zeigt Gemini Decision 1 bei Benchmark-Bewertungen, die Agent-Routing, Schlussfolgerung, Sortierung und multimodales Verständnis abdecken, eine führende Leistung und erzielt den niedrigsten Kalibrierungsfehler.
In Testkontexten von nicht mehr als 16K Token hält sich die mediane Latenz in der Modellberechnungsphase bei 50 bis 100 Millisekunden, die End-to-End-Latenz beträgt etwa 150 bis 250 Millisekunden. Selbst wenn die Anzahl der in einer einzigen Anfrage enthaltenen Fragen von 1 auf 100 steigt, bleibt die Latenz im Wesentlichen stabil.
Auf dem von Google verwendeten gemeinsamen Benchmark-Datensatz sind die Kosten der Gemini Decisions API fast 5 Mal niedriger als beim Aufruf von Gemini 3.5 Flash-Lite über die Interactions API.
7 von 9 Tests gewinnen, höchste Genauigkeit von 92,2 %
Mit der Veröffentlichung von Gemini Decision 1 hat Google auch einen aufschlussreichen Vergleichsbericht für Modelle vorgelegt.
Im Gegensatz zu dem üblichen Vergleich allgemeiner großer Modelle hat Google dieses Mal drei Konkurrenzprodukte ausgewählt: GPT-6 Luna von OpenAI, das speziell für Klassifizierungsentscheidungen ausgelegte TypeSafe Jev 1.14 und das hauseigene Gemini 3.5 Flash-Lite.
Den Ergebnissen zufolge belegt Gemini Decision 1 bei 9 Benchmark-Tests 7 Mal den ersten Platz und ist auch bei der Wahrscheinlichkeitskalibrierung führend – bei zwei weiteren Tests sowie bei den Gesamtaufrufkosten gibt es jedoch noch Konkurrenten mit besserer Leistung.
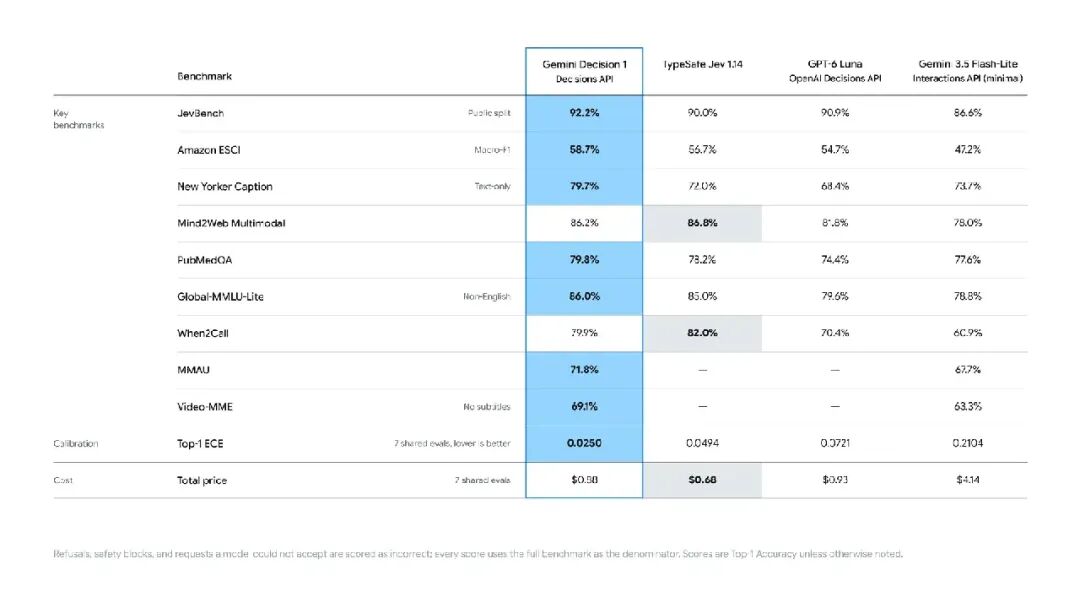
Im JevBench-Test erreicht Gemini Decision 1 eine Genauigkeit von 92,2 % und übertrifft damit GPT-6 Luna mit 90,9 %, TypeSafe Jev 1.14 mit 90,0 % sowie Gemini 3.5 Flash-Lite mit 86,6 %.
Im Amazon ESCI-Test zur Relevanz von Produktsuchen erzielt Gemini Decision 1 einen Macro-F1-Score von 58,7 %, der 4 Prozentpunkte über dem von GPT-6 Luna und 11,5 Prozentpunkte über dem von Flash-Lite liegt.
Beim New Yorker Caption-Test vergrößert sich der Abstand weiter. Gemini Decision 1 erreicht 79,7 %, GPT-6 Luna 68,4 % – ein Unterschied von 11,3 Prozentpunkten. Dieser Test beinhaltet das Verständnis und die Auswahl von Bildunterschriften für Comics und prüft die Fähigkeit des Modells, Kontexte zu verstehen und Kandidateninhalte zu beurteilen.
Im medizinischen Frage-Antwort-Test PubMedQA belegt Gemini Decision 1 ebenfalls den ersten Platz mit einem Wert von 79,8 %, was über den 74,4 % von GPT-6 Luna liegt.
Die Ergebnisse des mehrsprachigen Tests Global-MMLU-Lite sind ähnlich: Gemini Decision 1 erreicht 86,0 %, GPT-6 Luna 79,6 % – ein Unterschied von 6,4 Prozentpunkten.
Dennoch hat Google keine durchgehende Führung erreicht.
Im Mind2Web Multimodal-Test belegt TypeSafe Jev 1.14 mit 86,8 % den ersten Platz, Gemini Decision 1 liegt mit 86,2 % um 0,6 Prozentpunkte zurück.
Beim When2Call-Test, der die Fähigkeit zur Beurteilung von Tool-Aufrufen prüft, ist der Vorteil von TypeSafe Jev 1.14 noch deutlicher: Es erreicht einen Wert von 82,0 %, Gemini Decision 1 von 79,9 %.
Dieses Ergebnis ist besonders bemerkenswert. Die Auswahl von Tools und die Beurteilung des Zeitpunkts von Aufrufen gehören zu den Agent-Anwendungsszenarien, auf die Gemini Decision 1 speziell abzielt – bei diesem Test behält das spezielle Entscheidungsmodell TypeSafe Jev jedoch weiterhin die Führung.
Darüber hinaus erzielt Gemini Decision 1 im Audio-Verständnistest MMAU 71,8 % und im Video-Verständnistest Video-MME 69,1 %, beide Werte liegen über denen von Flash-Lite.
Noch bemerkenswerter als die Genauigkeit ist die von Google besonders hervorgehobene Fähigkeit zur Wahrscheinlichkeitskalibrierung.
Im Top-1-ECE-Test (Expected Calibration Error, erwarteter Kalibrierungsfehler) beträgt der Kalibrierungsfehler von Gemini Decision 1 nur 0,0250, während der von GPT-6 Luna 0,0721, der von TypeSafe Jev 1.14 0,0494 und der von Flash-Lite 0,2104 beträgt.
Mit anderen Worten: Bei dieser Bewertung ist der Kalibrierungsfehler von Gemini Decision 1 um etwa 65 % niedriger als der von GPT-6 Luna und um etwa 88 % niedriger als der von Flash-Lite.
Dieser Indikator ist besonders wichtig für Agent-Systeme.
Zum Beispiel, wenn ein Agent beurteilen muss, ob ein Codeabschnitt Sicherheitslücken aufweist, gibt das Modell nicht nur das Ergebnis „vorhanden“ oder „nicht vorhanden“ aus, sondern auch einen Wahrscheinlichkeitswert. Das System kann anhand der Beziehung zwischen der Wahrscheinlichkeit und der tatsächlichen Korrektheit entscheiden, ob es automatisch Maßnahmen ergreift oder die Angelegenheit zur weiteren Prüfung an Menschen weiterleitet.
Google nutzt es bereits: Die Latenz bei der Agent-Route wird um bis zu 40 % reduziert
Im Gegensatz zu einigen neuen Modellen, die nur Benchmark-Ergebnisse vorzeigen, hat Google dieses Mal auch Anwendungsfälle der Gemini Decisions API in internen Produkten offengelegt.
Das bemerkenswerteste davon ist Gemini Notebook.
Google nutzt die Decisions API als Echtzeit-Modell-Router, um je nach Komplexität der Benutzeranfrage die geeignete Modellstufe und Denkintensität auszuwählen. Bei alltäglichen einfachen Fragen kann das System vorrangig Modelle mit niedrigeren Kosten und schnellerer Antwort aufrufen; bei komplexen Schlussfolgerungsaufgaben wird die Anfrage an ein leistungsstärkeres Modell weitergeleitet.
Laut Google kann durch diese dynamische Routing-Methode die Latenz bei alltäglichen Abfragen um bis zu 40 % reduziert werden.
Dieses Design hängt eng mit dem aktuellen Entwicklungstrend von Agent-Systemen zusammen. Wenn ein Agent eine Aufgabe erledigt, muss er ständig den nächsten Schritt beurteilen – zum Beispiel welches Tool ausgewählt wird, welches Modell aufgerufen wird oder ob ein menschlicher Eingriff erforderlich ist.
Wenn jede einfache Entscheidung von einem großen generativen Modell verarbeitet werden muss, muss das System zusätzliche Latenz und Kosten tragen. Spezielle Entscheidungsmodelle bieten eine Alternative: Relativ einfache Beurteilungen mit klar definierten Optionen werden von Modellen mit niedriger Latenz verarbeitet, während komplexe Aufgaben den allgemeinen großen Modellen überlassen bleiben.
Neben Gemini Notebook hat Google drei weitere Anwendungsrichtungen offengelegt.
In Google Stitch nutzt die neu eingeführte experimentelle Funktion Rapid Canvas die Decisions API, um innerhalb weniger Sekunden interaktive Wireframes für Produktabläufe zu erstellen und schnell auf Änderungsanweisungen zu reagieren, die Benutzer per Sprache oder Klick übermitteln. Nachdem der Benutzer die Designrichtung bestätigt hat, kann die Seite in den vollständigen Stitch-Arbeitsablauf überführt werden, um sie weiter zu verfeinern.
Im CC-Produkt von Google Labs wird die Decisions API verwendet, um schnell das passende Emoji-Reaktion aus über 200 Emoji-Optionen auszuwählen. Intern bei Google Search nutzt Google diese API außerdem, um eine Sicherheitsprüfschicht für MCP-Tools aufzubauen und potenzielle gegnerische Verhaltensweisen und Inhalte zu erkennen.
Referenzlinks:
https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
Dieser Artikel stammt aus dem