Eilmeldung: „Yuanshen“ MiniMax stellt H3 Image als Open Source zur Verfügung, das leistungsstärkste Open-Source-Modell wird in China hergestellt.
OpenAI hat sein vor wenigen Tagen am 4. November veröffentlichtes Images 2.6 erst online gestellt, da rufen schon einige Nutzer aus:
GPT is cooked.
GPT-6 ist völlig am Ende.
Was die Begeisterung aller auslöst, ist das neue Modell H3 Image von MiniMax.
Der Testerin Emily, die am internen Test teilnimmt, nennt einige harte Kernparameter:
Bis zu 16 Referenzbilder, der Prompt kann bis zu 7500 Zeichen lang sein, und die maximale Ausgabegröße beträgt 4K.
Sie hat nebenbei eine Wette abgeschlossen: Nach ihrem Kenntnisstand über MiniMax wird dieses Modell früher oder später Open-Source.
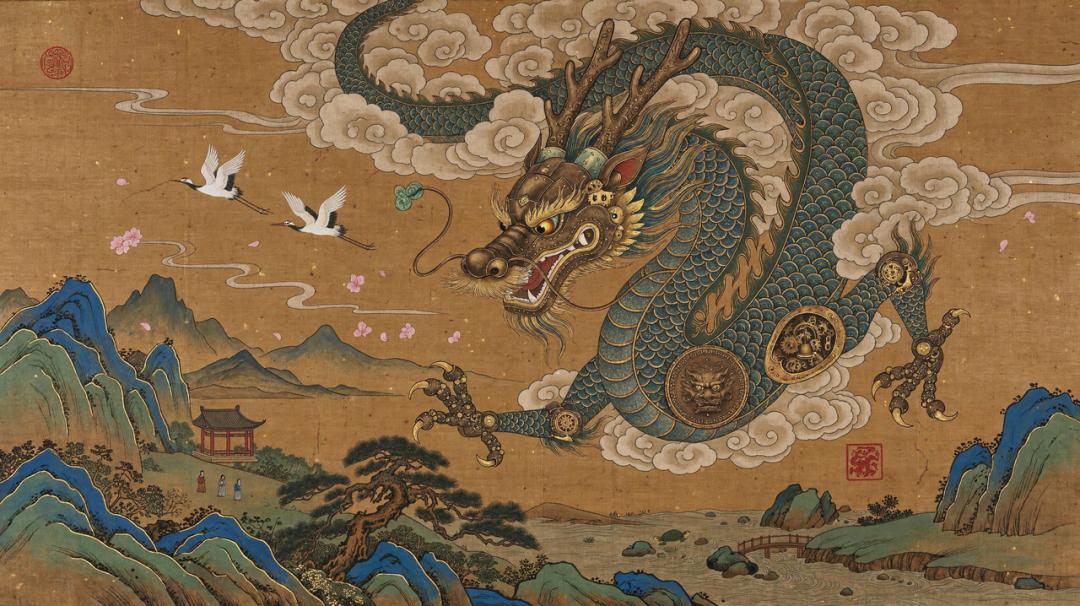
Sie hat richtig getippt, und es ging sogar schneller als sie gedacht hat. Heute veröffentlicht MiniMax offiziell H3 Image, stellt die Gewichte noch am selben Tag als Open Source zur Verfügung, öffnet gleichzeitig die API, und das Modell kann auch direkt im hauseigenen MiniMax Code, auf der offenen Plattform und in Hailuo AI verwendet werden.
Vor drei Monaten hat das Unternehmen das Videomodell H3 Open Source gestellt, und Forschungsteams von Nvidia, Pika und fal haben darauf basierend abgeleitete Modelle nachtrainiert.
Diesmal ist die Bildgenerierung an der Reihe. Der offiziellen Positionierung von H3 Image zufolge ist es das SOTA unter den Open-Source-Bildmodellen, dessen Gesamteffekt in der ersten globalen Liga liegt. Begriffe wie „Spitzenplatz“ hören sich schon etwas abgedroschen an, ein weiteres Label an ihm ist viel beachtenswerter: die Fähigkeit zur Einhaltung von Anweisungen.
Dieses Mal steht Open Source, hohe Auflösung und hohe Geschwindigkeit im Vordergrund.
H3 Image kann direkt Bilder mit 4K-Auflösung (4096×4096) generieren.
Für Kreative bedeutet eine hohe Auflösung mehr Details, einen größeren Spielraum beim Zuschneiden und erweitert die Einsatzmöglichkeiten der Bilder: So kann dasselbe Bild beispielsweise für Poster und Webseiten unterschiedlicher Größe angepasst werden, oder es kann ein Ausschnitt herausgegriffen werden, um eine bestimmte Person oder ein Produkt hervorzuheben.
Die meisten gängigen Modelle auf dem Markt erreichen eine Auflösung von einer bis vier Millionen Pixel, die Generierungsdauer liegt im Allgemeinen im Minutenbereich, selbst die schnellsten benötigen etwa 50 Sekunden. H3 Image braucht nur 10 bis 20 Sekunden, um ein 4K-Bild zu generieren, was den Zeitaufwand für Versuche senkt. Wenn Kreative die Komposition, Farbgebung oder Lichtdetails anpassen müssen, können sie das Ergebnis schnell sehen und weiter bearbeiten.
Das heißt, die tägliche Erstellung von 4K-Inhalten wird zum ersten Mal Realität.
KI-Bildgenerierung: Mehr als nur schöne Bilder
Eine Reihe von Bloggern hat gestern die Zugangsberechtigung für den internen Test erhalten und bereits eine Reihe von Bildern geteilt.
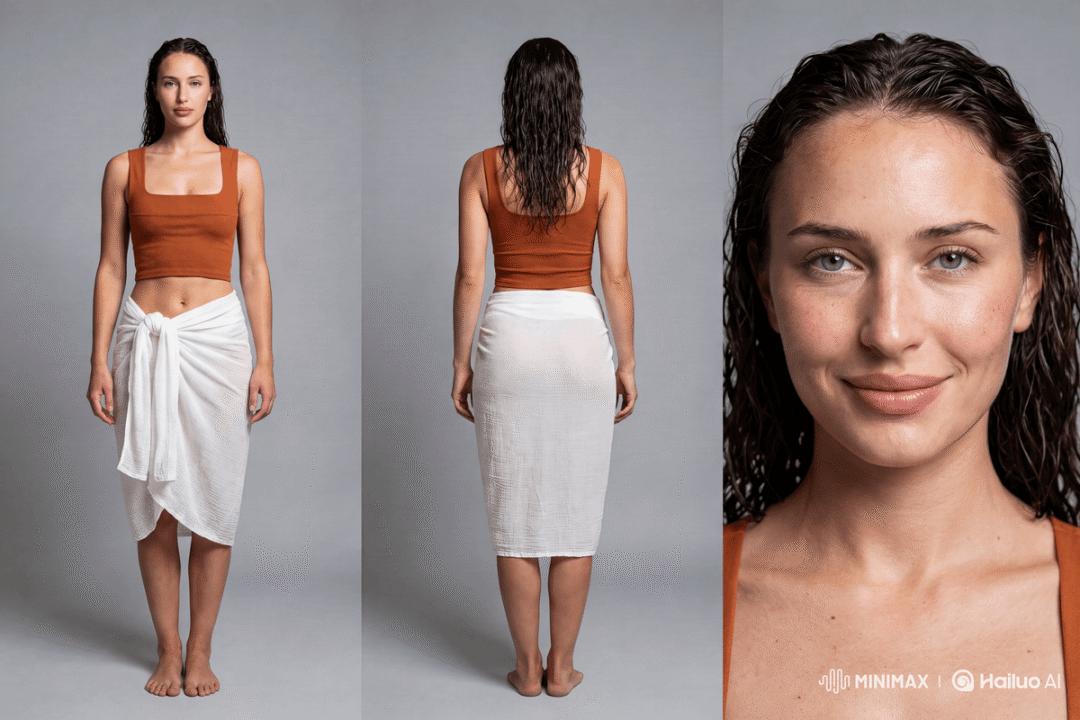
Der Blogger Muhammad Ayan beginnt mit dem Satz „🚨 China hat wieder ein Hammer-Produkt auf den Markt gebracht“, und teilt dann die Bilder: Man lädt ein Foto hoch, und man erhält eine ganze Reihe von 4K-Charakterdesignbildern – vollständige Vorder- und Rückansicht sowie Nahaufnahmen des Gesichts, selbst Poren, Sommersprossen und feine Härchen sind sichtbar.
Das Fazit lautet nur ein Satz: Die „kunststoffartige Oberfläche“ von KI-Porträts ist verschwunden.
Als ich das gelesen habe, habe ich es nicht besonders ernst genommen. Jeden Monat gibt es Leute, die von „einem realistischeren Porträtmodell“ sprechen.
Beim Weiterblättern ändert sich der Stil.
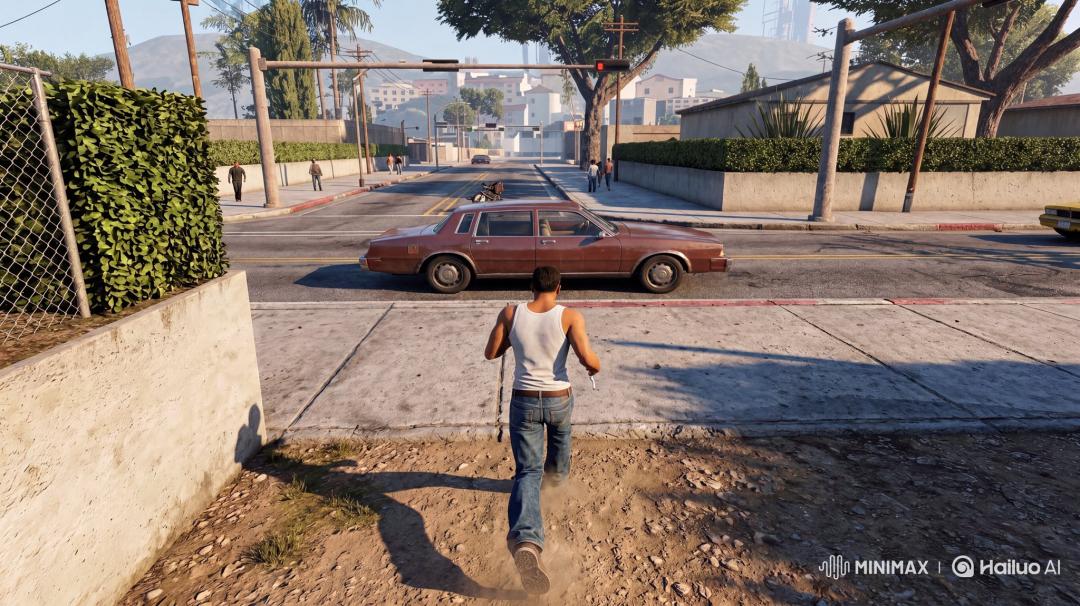
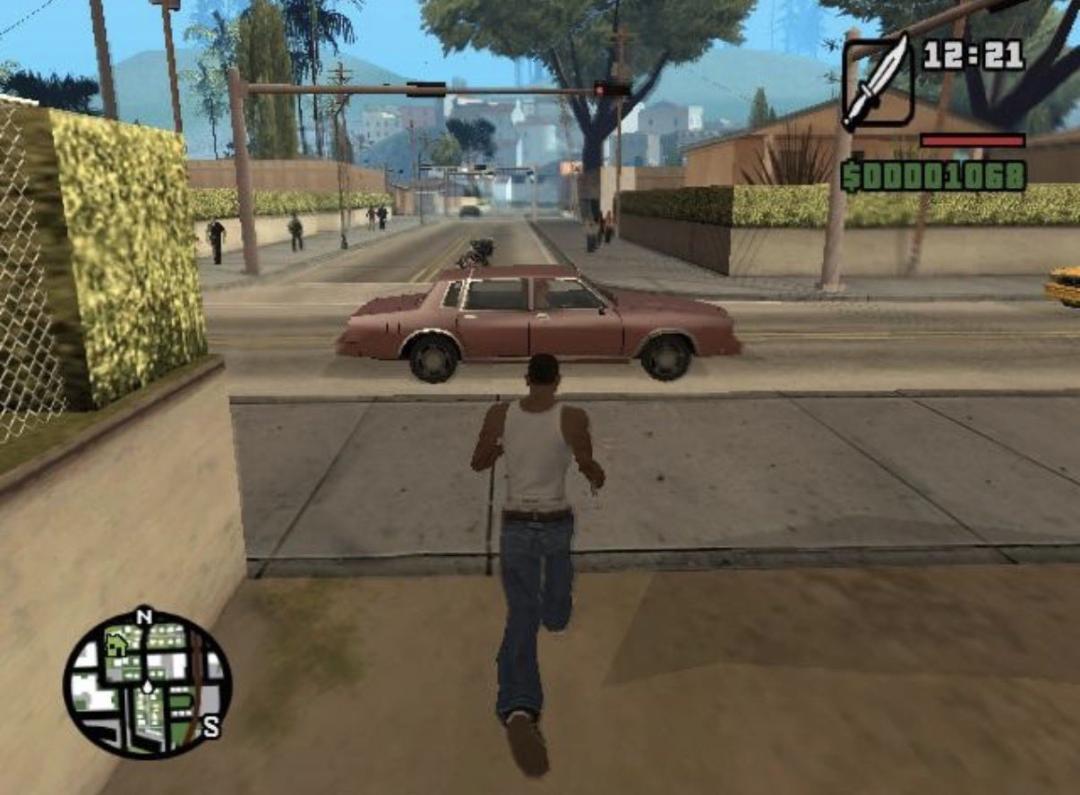
Papillon hat einen alten Screenshot von „GTA: San Andreas“ herausgeholt und es zu einem Next-Gen-3A-Blockbuster neu generieren lassen, mit dem Kommentar: Das Grafik-Upgrade, auf das CJ 20 Jahre gewartet hat, ist endlich da.
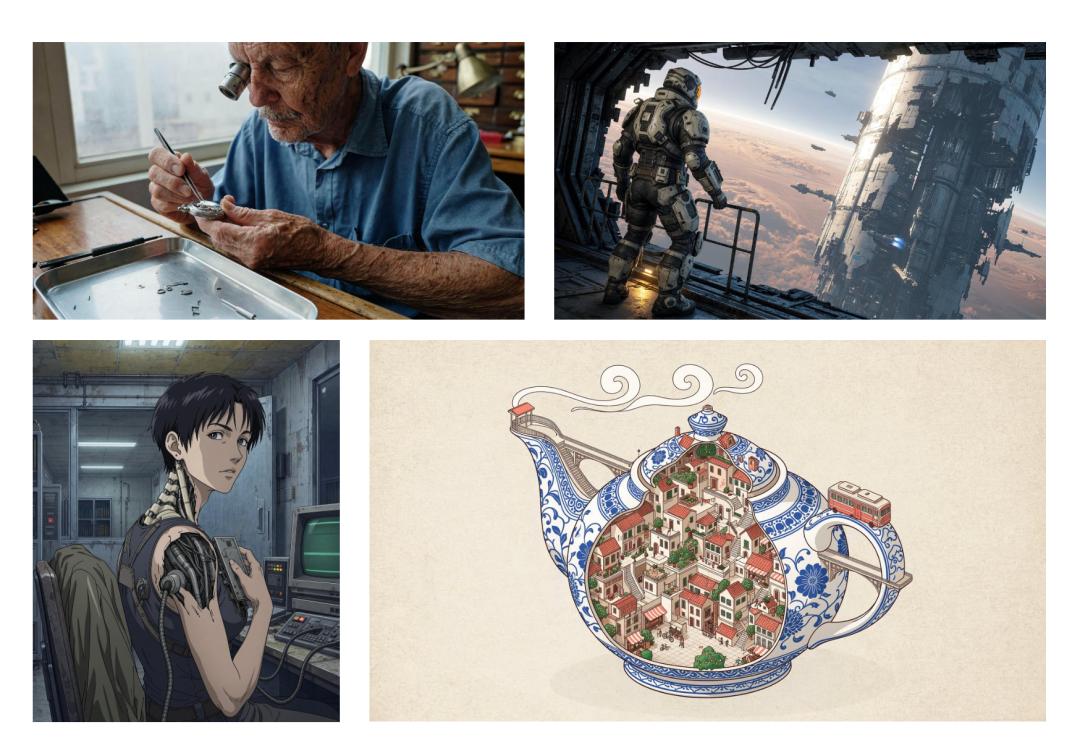
DrSadek hat nacheinander vier Stile wie dokumentarische Fotografie und Cyberpunk-Animation ausprobiert und die Nutzer zur Abstimmung aufgerufen.
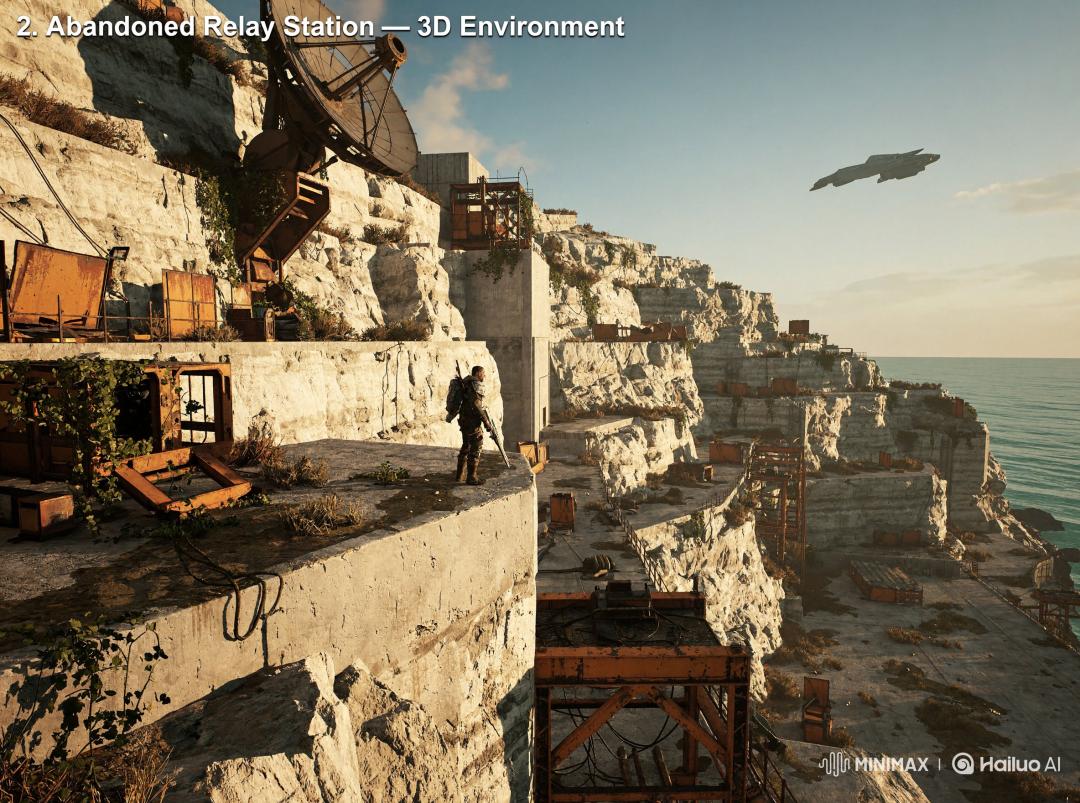
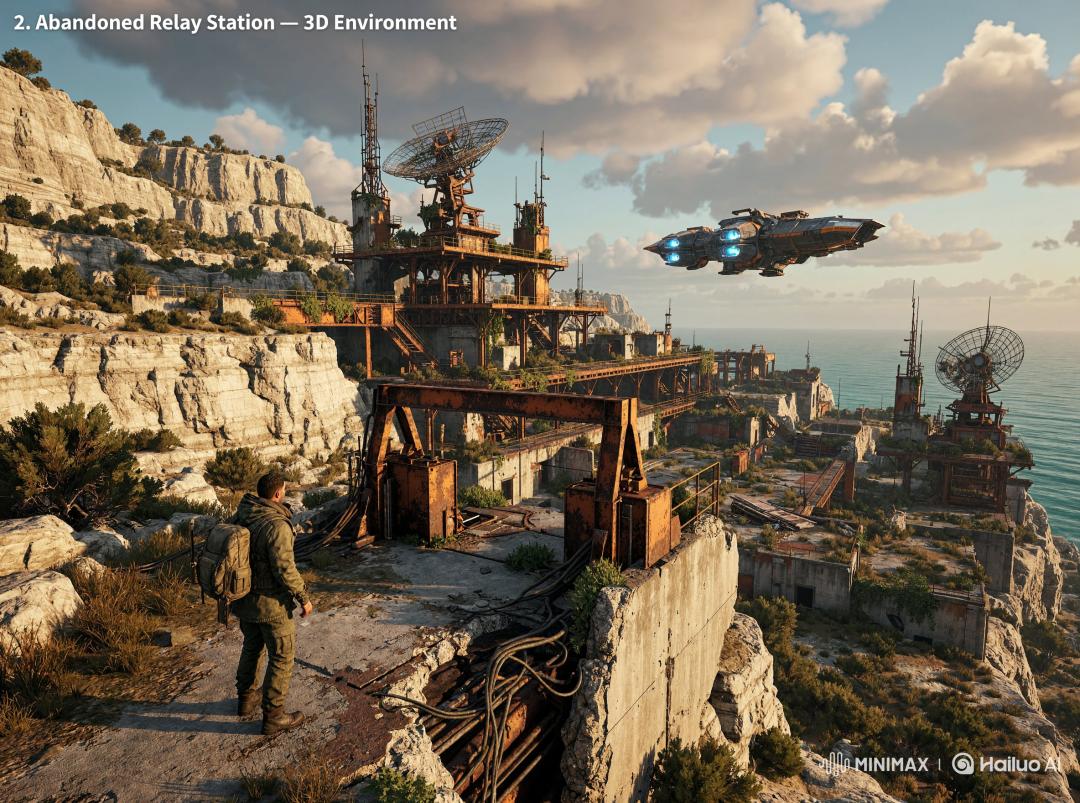
Israa Ali, die „GPT is cooked“ gerufen hat, hat 3A-Spiel-Assets und 3D-Szenen getestet. Ihre Aussage klingt etwas zu optimistisch, aber ihre Begeisterung ist absolut echt.
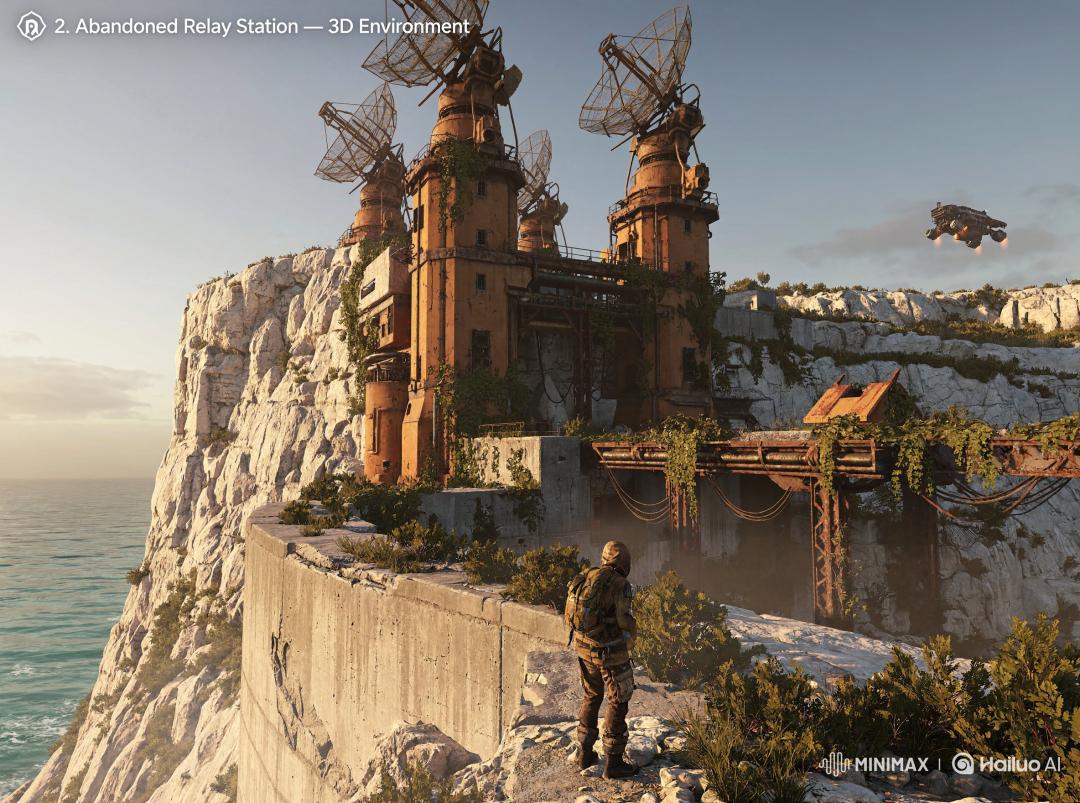
Weiter unten geht es nicht mehr nur um „schöne Bilder“.
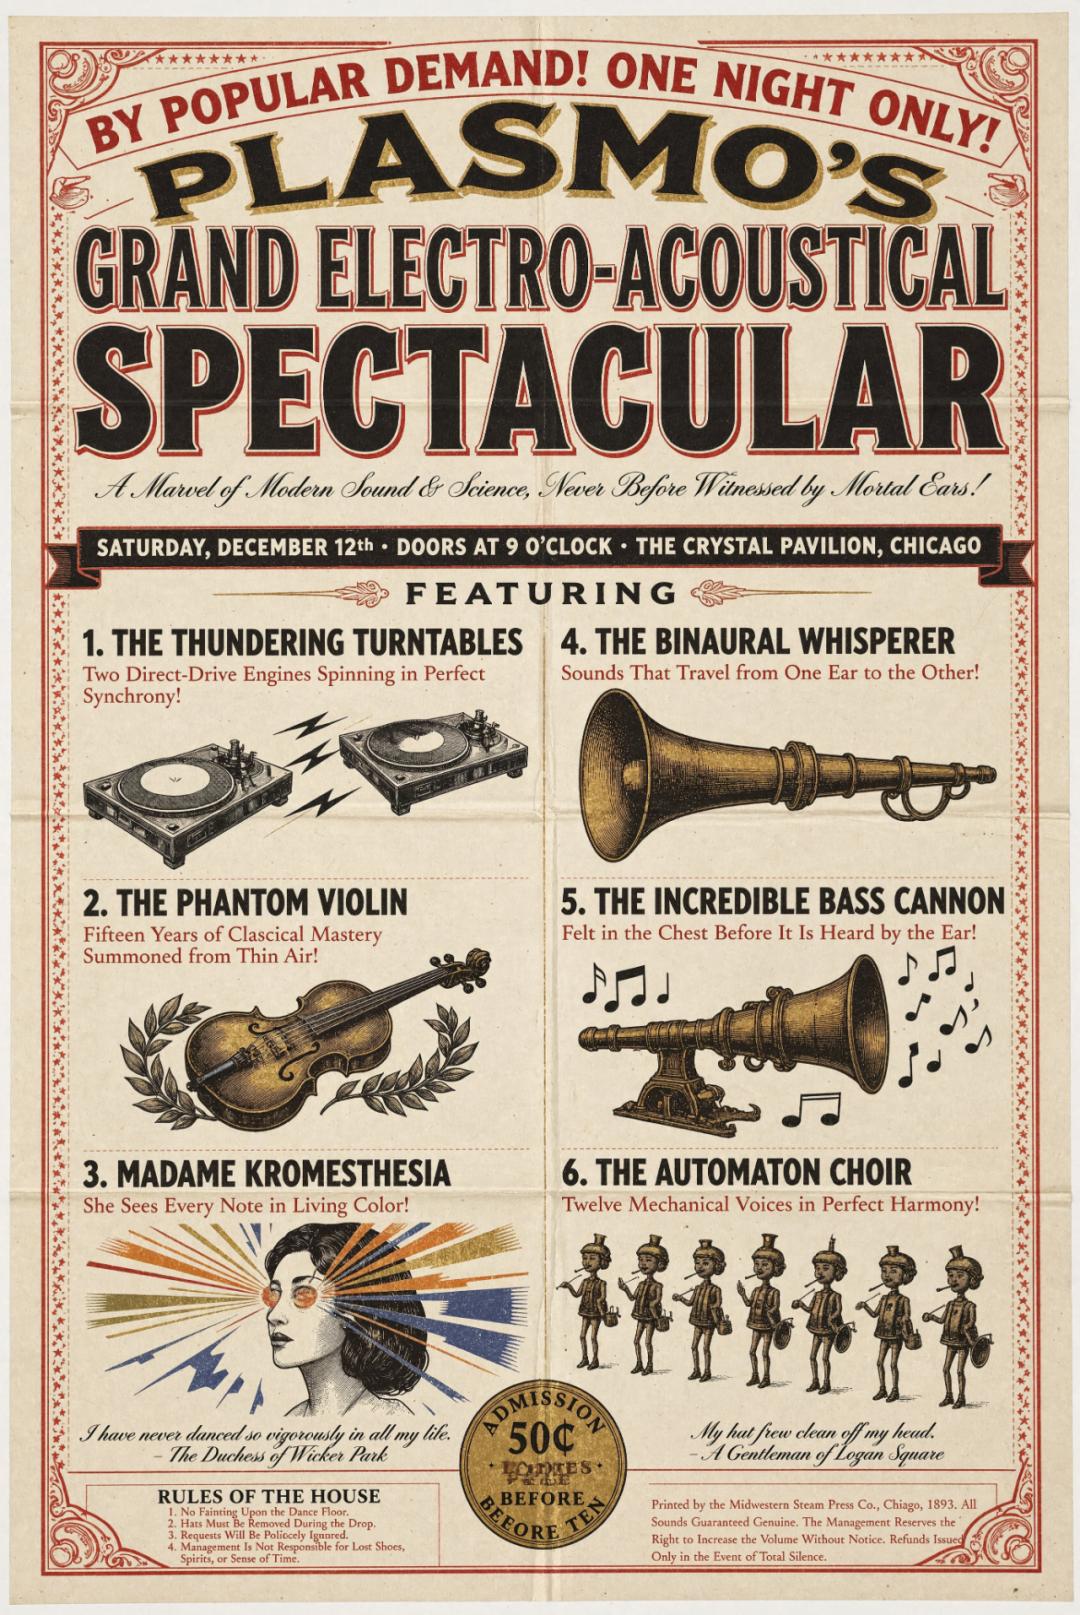
plasm0 hat es für Plakate mit großen Schriftzeichen verwendet und sagt, dass große Zeichen sehr zuverlässig funktionieren, kleine Zeichen gelegentlich Fehler aufweisen, aber im Großen und Ganzen korrekt sind;
Er hat auch die Gesten der amerikanischen Gebärdensprache getestet und bewertet: „Es ist ziemlich gut, viel besser als Moss.“
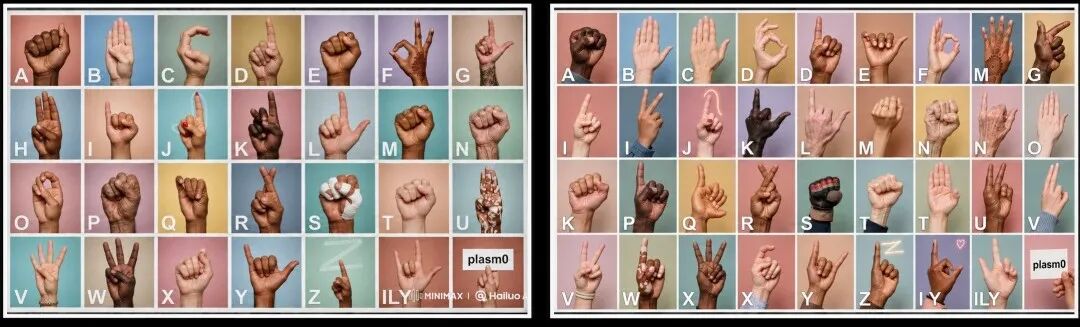
Links: H3 Image; Rechts: Moss.
Gebärdensprache ist ein sehr schwieriges Szenario, bei dem KI-Modelle fast immer Fehler machen. Nach Statistiken von ChatGPT-6.1 Sol liegt die Genauigkeit von Moss nur bei 20,0 %, beispielsweise werden die Gesten für U und V vertauscht, und ein Kästchen, das als X markiert ist, zeigt tatsächlich W. Obwohl H3 Image auch Fehler aufweist, erreicht es eine Genauigkeit von 48,1 %, was der Bewertung „viel besser als Moss“ voll und ganz gerecht wird.
Ankit Patel und studio_oneroom gehen noch weiter: Sie lassen das Modell CAD-Stil-Bilder und mechanische Explosionszeichnungen erstellen, also Bilder, bei denen Teile einzeln auseinandergenommen und in der Luft schweben.
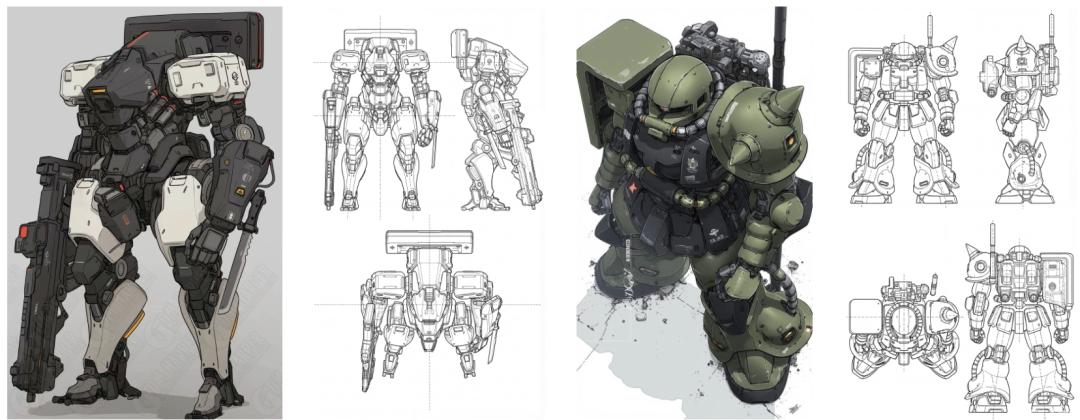
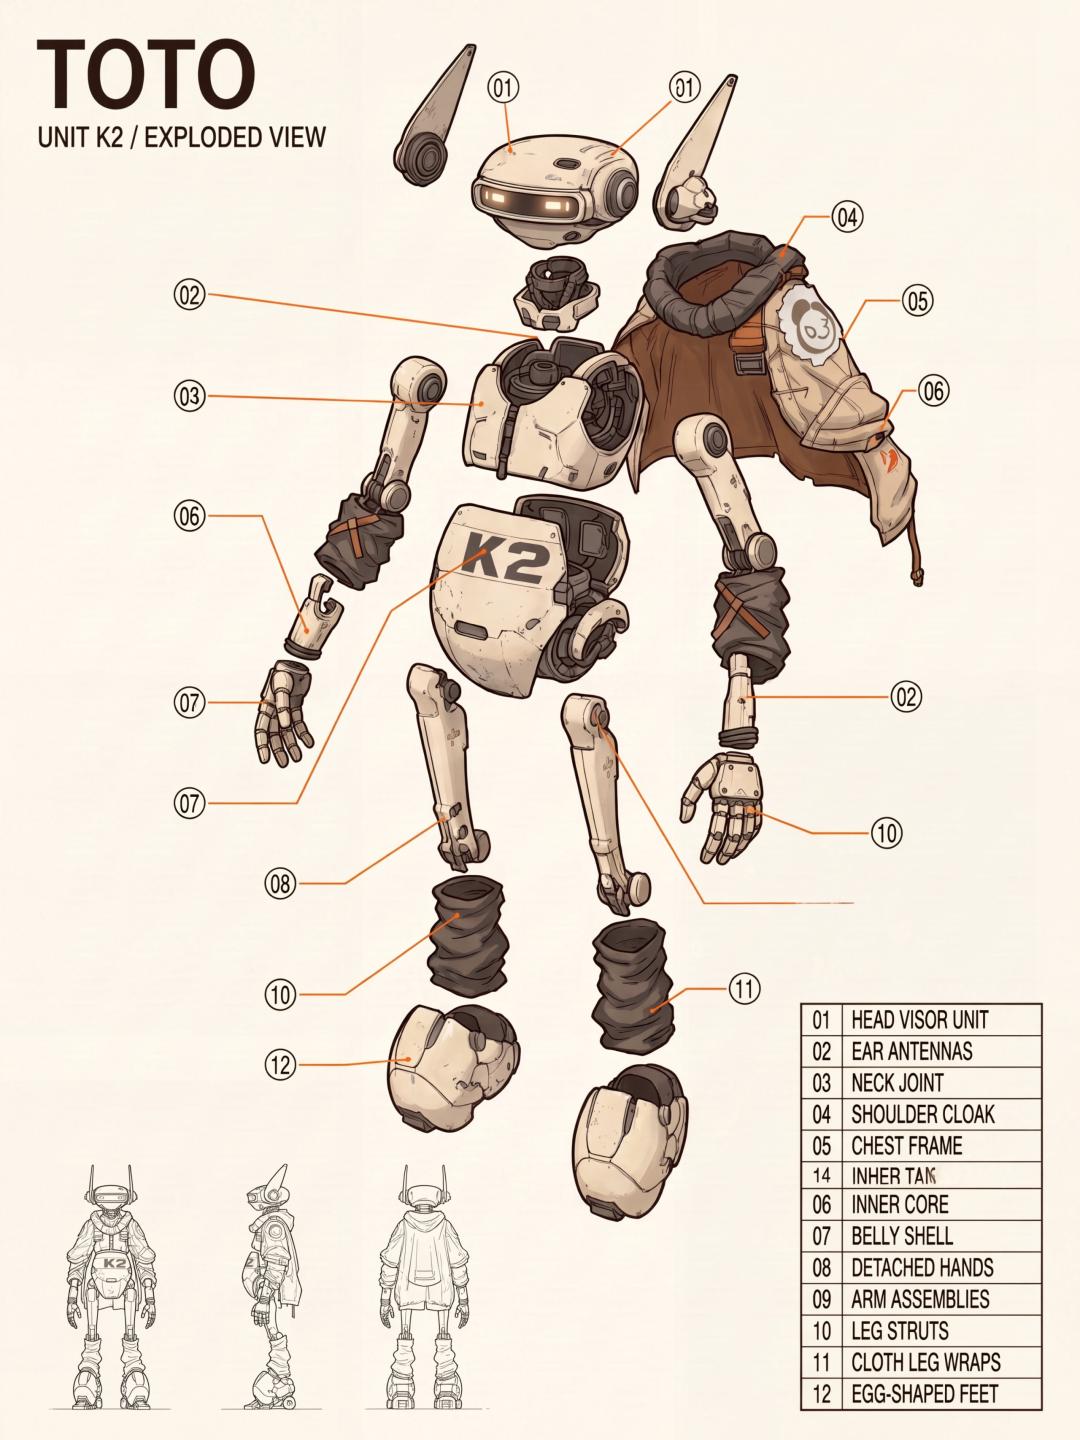
Ist Ihnen aufgefallen? All diese Szenarien sind klassische Fehlerquellen für Bildgenerierungsmodelle. Es ist nicht schwer, ein schönes Bild zu machen. Die Schwierigkeit besteht darin, dass Schriftzeichen nicht falsch sein dürfen, Gesten nicht verwechselt werden dürfen und Teile nicht verkehrt herum eingebaut werden dürfen. Das prüft nicht die Zeichenfähigkeit, sondern die Denkfähigkeit des Modells.
Dieses Bildgenerierungsmodell hat keine Wissenslücken
Modelle wie Midjourney sind wie Kunststudenten: Licht und Textur sind einwandfrei, aber bei langen Texten und räumlichen Beziehungen geraten sie schnell durcheinander.
Sprachmodelle wie Claude sind wie Naturwissenschaftsstudenten: Ihre Logik ist völlig klar, sie können Code schreiben und Diagramme ordentlich zeichnen, aber sie sind nicht für die Bildgenerierung ausgelegt, sodass die Bildqualität nicht mit der professioneller visueller Modelle mithalten kann.
Starke Fähigkeit zur Einhaltung von Anweisungen, hohe Generierungsgeschwindigkeit und hohe Pixeldichte – es scheint, dass man nicht alles auf einmal haben kann. MiniMax will mit diesem Modell ein ausgewogenes Modell ohne Wissenslücken schaffen.
Worte allein reichen nicht aus. Nachdem wir die Zugangsberechtigung für den internen Test erhalten haben, haben wir keine Porträts oder Landschaftsbilder getestet, sondern direkt drei Tests erstellt, die gezielt die Schwachstellen von Modellen prüfen.
Erster Test: Prüfung des Verständnisvermögens des Bildgenerierungsmodells
Ein ausländischer Kreativer hat frühzeitig die Testzugangsberechtigung für MiniMax H3 Image erhalten und gleich eine extrem schwierige Prüfung gestellt!
Der Eiffelturm in Paris soll zu einem zukünftigen interstellaren Kommunikationsrelais in einer Cyberpunk-Welt umgebaut werden, und das Ganze muss in Form eines professionellen architektonischen CAD-Blueprints dargestellt werden.
Ultrafeine Vektorlinien, streng symmetrische Gebäudestrukturen, komplexe Schnittkonstruktionen und selbst dicht gedrängte technische Details dürfen nicht fehlen.
Das Ergebnis hat die Tester total überrascht!
Angesichts eines so komplexen Prompts zeigt MiniMax H3 Image eine unerwartete Detailausdrucksstärke, was seine starke Fähigkeit zur Einhaltung von Anweisungen beweist.
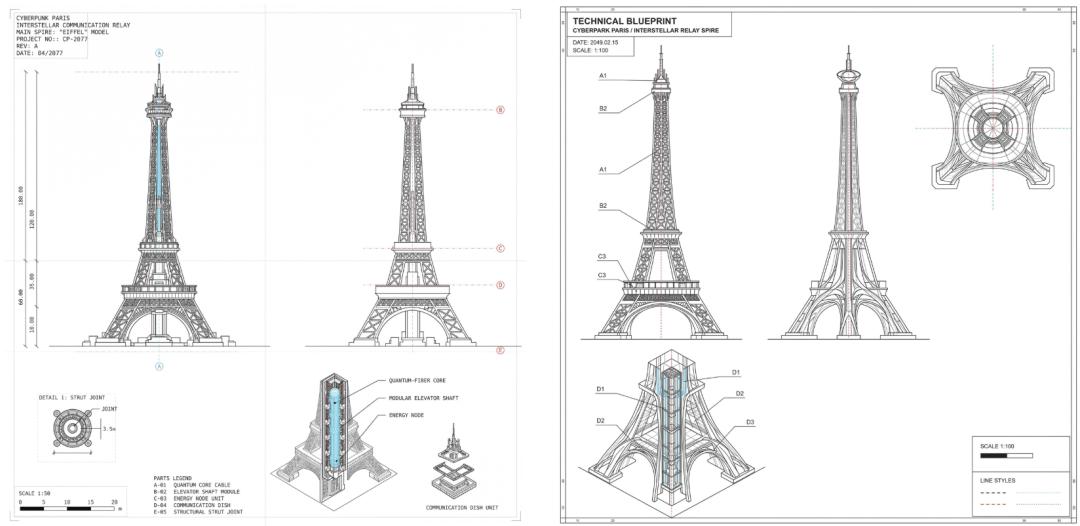
Auch die hölzerne Pagode von Yingxian stellt kein Problem dar, es kann echte Baupläne für den Bauprozess generieren:
