Yao Shunyu wies auf die „Großstrategie“ von Tencent AI4S hin
Der Eintritt der KI in die wissenschaftliche Forschung entwickelt sich von spezialisierten Modellen hin zu allgemeinen intelligenten Agenten, die Probleme lösen und Werkzeuge erstellen können.
Am 7. November 2026 hat Yao Shunyu, Chef-KI-Wissenschaftler von Tencent, auf dem Wissenschaftsgipfel des Future Science Prize Week 2026 seine Einschätzung zu drei Paradigmenwechseln von AI for Science sowie die neuesten Praktiken des Hunyuan-Teams geteilt.
Yao Shunyu absolvierte das „Yao-Klasse“ der Tsinghua-Universität und die Princeton-Universität. Er hat Methoden wie ReAct und Tree of Thoughts vorgeschlagen und war an der Entwicklung von intelligenten Agentenprodukten von OpenAI beteiligt.
Vor der Zusammenfassung werden zwei Dinge kurz erläutert.
1. Dieser Artikel wird von Tide Surge AI nach dem Inhalt der Live-Rede von Yao Shunyu zusammengestellt, wobei die erste Person beibehalten und notwendige Satzanpassungen sowie Kürzungen vorgenommen wurden.
2. Eigennamen und Zahlen werden anhand der Folien vor Ort und öffentlicher Materialien korrigiert, ergänzende Informationen sind mit „Hintergrundergänzung“ gekennzeichnet.
Im Folgenden der Hauptteil des Protokolls der Rede von Yao Shunyu —
AI for Science durchläuft drei Paradigmenwechsel
Ich freue mich, hier zu sein und mit Ihnen über AI for Science zu sprechen.
Wir haben gerade das Hy4-Modell und das Hyra 2.0-Werkzeugframework veröffentlicht. Wenn Sie mehr Details zu den meisten heute besprochenen Inhalten erfahren möchten, können Sie die Forschungsseite von Hunyuan besuchen.
Insgesamt erleben wir drei sehr schnelle Paradigmenwechsel. Sie stehen nicht in einem einfachen Ersatzverhältnis zueinander, sondern entwickeln sich schrittweise und parallel.
In der ersten Phase erstellen wir spezialisierte Modelle für bestimmte wissenschaftliche Probleme.
In der zweiten Phase, dank der Entwicklung großer Sprachmodelle, verfügen wir über allgemeine intelligente Agenten, die Probleme lösen können.
In diesem Jahr, mit der weiteren Entwicklung großer Sprachmodelle, betreten wir die dritte Phase: Intelligente Agenten können nicht nur Probleme lösen, sondern auch Werkzeuge erstellen. Sie lösen sowohl aktuelle Probleme als auch bereiten sich auf zukünftige Probleme vor.
Betrachtet man die erste Phase, ist das klassischste Beispiel für AI for Science AlphaFold. Es repräsentiert das erste Paradigma: Menschliche Forscher stehen vor einem bestimmten Problem, entwerfen ein neuronales Netzwerk für dieses Problem und fügen eine große Menge a priori Wissen, das von Menschen induziert wurde, in die Modellarchitektur ein, wie z. B. Distanzabweichungen oder Sequenzentwicklungsabweichungen.
Die Generationen 1 bis 3 von AlphaFold erschienen ungefähr zwischen 2018 und 2024. Dies ist ein sehr wichtiger Weg für AI for Science: Forscher trainieren ein neuronales Netzwerk, um damit bestimmte wissenschaftliche Aufgaben zu erledigen.
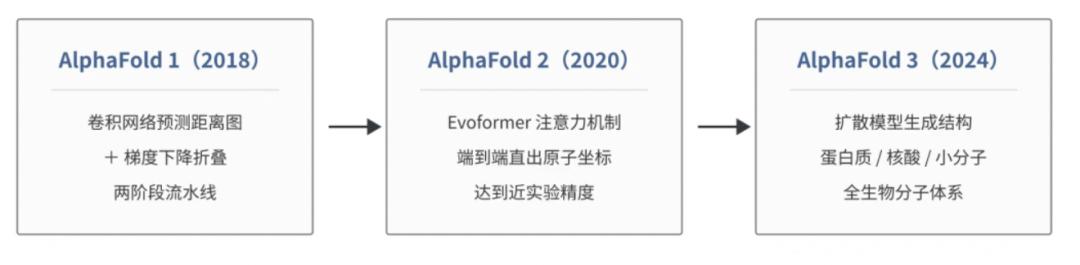
Die technische Hauptlinie der drei Generationen von AlphaFold (zusammengestellt vom Blogger @Hu Qi Hooch)
Aber gleichzeitig findet eine weitere Revolution statt, nämlich die der großen Sprachmodelle.
Große Modelle vollziehen zuerst die Vereinheitlichung und entfalten dann ihre Fähigkeiten durch Skalierung
Ungefähr von 2017 bis 2022 haben große Sprachmodelle eine Reihe von Vereinheitlichungen und Vereinfachungen abgeschlossen.
Der erste Schritt ist die Vereinheitlichung der Daten.
Mithilfe von Transformer und Selbstaufmerksamkeitsmechanismus können wir beliebige Datentypen als eine Zeichenkette von Tokens darstellen. Ob Sätze, Bilder, Videos oder Audiodateien, alle können in eine Token-Liste umgewandelt werden.
Der zweite Schritt ist die Vereinheitlichung der Architektur.
Da unterschiedliche Daten als Token-Liste dargestellt werden können, können wir sie mit derselben Architektur verarbeiten. Der Schlüssel liegt darin, dass zwischen verschiedenen Tokens Selbstaufmerksamkeitsberechnungen durchgeführt werden können.
Mit dieser hochgradig vereinheitlichten Modellarchitektur von Transformer ist der nächste Schritt die Vereinheitlichung der Aufgaben.
Eingaben und Ausgaben von Aufgaben hatten ursprünglich viele Formen, aber wir können sie auf allgemeinere Weise definieren: Vorhersage des nächsten Tokens.
So können viele Aufgaben, sobald eine beliebige Eingabe eintrifft, in dasselbe Problem umgewandelt werden: Welches Token soll als Nächstes erscheinen.
Später ergänzte ReAct den Werkzeugaufruf in diesen Prozess. Das Modell generiert Tokens nicht nur zum Denken, sondern auch zum Handeln. Angesichts eines Problems kann es durch Generierung von Tokens schlussfolgern, aber auch Such-, Code-, Terminal- oder andere externe Werkzeuge aufrufen und dann nach den von den Werkzeugen zurückgegebenen Ergebnissen weiter handeln.
Wenn Sie einen Transformer haben, der mehrere Datentypen verarbeiten kann und zudem Tokens zum Denken und Handeln generieren kann, ist er nicht mehr nur ein Sprachsystem, sondern beginnt, wie ein allgemeiner intelligenter Agent zu wirken, der Informationen empfangen, schlussfolgern und Maßnahmen ergreifen kann.
Ein weiteres sehr wichtiges Merkmal großer Sprachmodelle ist die Skalierung.
Für KI-Praktiker mag dies intuitiv erscheinen, aber ich halte es dennoch für eines der wichtigsten Konzepte der KI.
Mit mehr Rechenleistung, mehr Daten und mehr Parametern sinkt der Verlust des Modells bei der Vorhersage des nächsten Tokens kontinuierlich.
Aber die gleichmäßige Verbesserung der Modellfähigkeiten bedeutet nicht, dass die Praktikabilität der Aufgaben ebenfalls gleichmäßig steigt. Die Aufgabenleistung ändert sich oft plötzlich an einem bestimmten Punkt: Sie liegt lange Zeit nahe Null und wird nach Überschreiten einer bestimmten Schwelle plötzlich sehr gut.
Dieses Phänomen tritt wiederholt in vielen Bereichen auf, wie Mathematik, Programmierung, multimodales Verständnis und auch AI for Science.
Allgemeine intelligente Agenten beginnen bereits, echte wissenschaftliche Probleme zu lösen
Sobald wir über große Sprachmodelle verfügen, die wie Menschen denken und handeln können, nennen wir sie intelligente Agenten. Sie können Werkzeuge aufrufen und Probleme selbstständig lösen.
Ein Beispiel: Wir verwenden Hy4 für das umgekehrte Proteinfaltung.
Bei der Proteinfaltung gibt man eine Sequenz von Aminosäuren ein und erhält die entsprechende dreidimensionale Raumstruktur als Ausgabe; bei der umgekehrten Faltung kehrt man das Problem um: Man gibt die geometrische Struktur des Zielgerüsts an und entwirft eine Aminosäuresequenz, die so gut wie möglich dazu passt.
Die Vorgehensweise des Sprachmodells ähnelt stark der Denkweise von Menschen.
Es nutzt zuerst vorhandenes biologisches Wissen und a priori Wissen, um Kandidatensequenzen vorzuschlagen; dann ruft es Werkzeuge wie Strukturvorhersage auf, um den Übereinstimmungsgrad zwischen der Struktur und dem Ziel zu prüfen; schließlich optimiert es den Plan kontinuierlich anhand der Ergebnisse.
Anfangs war die Leistung des Modells nicht gut, aber nach mehreren Iterationen hat sich das Ergebnis bei der 17. Einreichung deutlich verbessert. Wichtig ist hier nicht, was einmal generiert wurde, sondern dass es ständig Pläne vorschlagen, Werkzeuge aufrufen, Feedback lesen und dann weiter korrigieren kann.
Ein weiteres Beispiel: Wir verwenden das Modell, um etwa 7 Millionen Zellen zu analysieren und die dreidimensionale Struktur eines Mausembryos zu rekonstruieren.
Einfach ausgedrückt sind die Eingaben 84 ungeordnete zweidimensionale Schnitte, das Ziel ist die Rekonstruktion des entsprechenden dreidimensionalen Embryos.
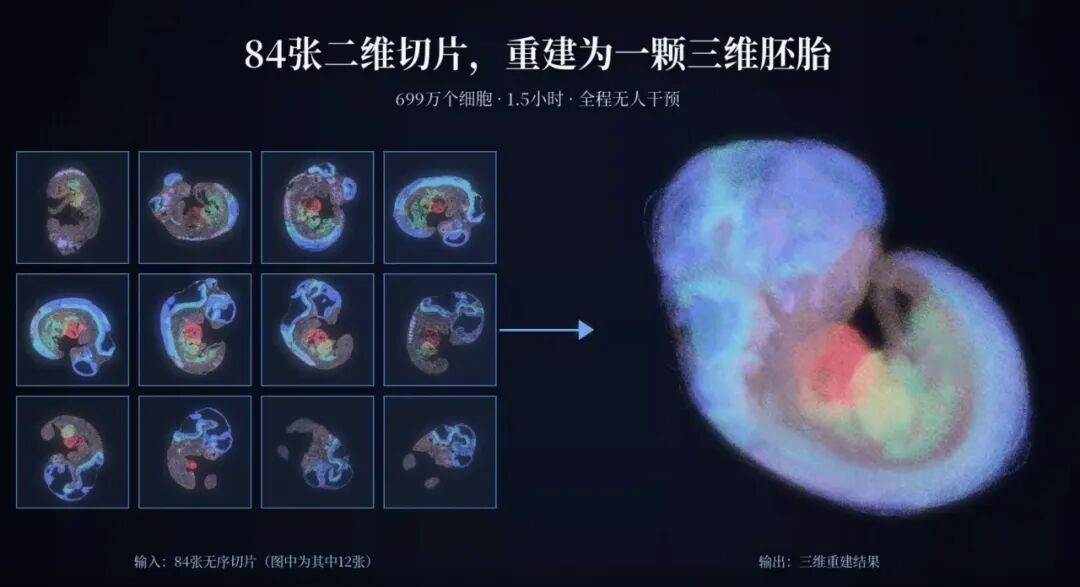
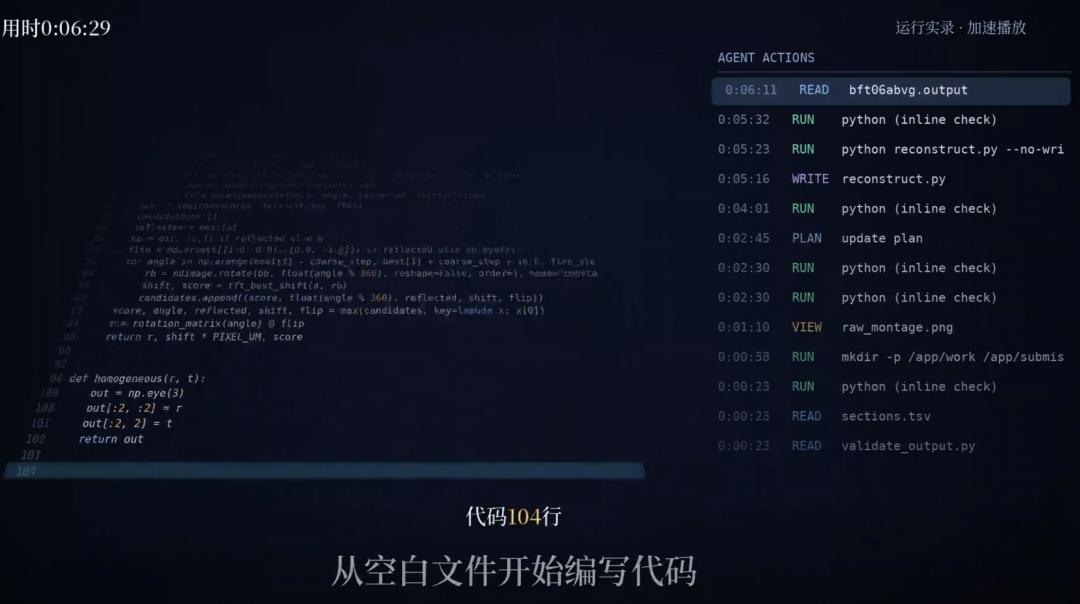
Die Schwierigkeit liegt nicht nur in der großen Datenmenge, sondern auch darin, dass einige Daten fehlerhaft oder beschädigt sein können. Das Modell muss Werkzeuge wie Programmierung und Terminal verwenden, außerdem Fehler erkennen und diese beheben.
Am Ende hat es mit einem einzelnen Rechner den gesamten Rekonstruktionsprozess in etwa 90 Minuten abgeschlossen. Für Biologen kann dies viel Zeit sparen.
Auch im Bereich der Mathematik gibt es ähnliche Fortschritte.
Intelligente Agenten beginnen, offene Probleme in Geometrie, Gruppentheorie, theoretischer Informatik und additiver Kombinatorik zu bearbeiten. Ein eigenes Beispiel von uns ist das Problem der Summen- und Differenzmengen: Der intelligente Agent schlägt Ideen wiederholt vor, prüft und korrigiert sie, erhält schließlich den optimalen Exponenten und beteiligt sich an der Zusammenfassung von Arbeiten.
Das Niveau und die Bedeutung dieser Ergebnisse können unterschiedlich hoch sein, aber die Arbeitsform ist ähnlich: Allgemeine intelligente Agenten beantworten nicht mehr nur ein lokales Problem, sondern bringen den Forschungsprozess mit Hilfe von Werkzeugen voran.
Tatsächlich kann es jetzt bereits in vielen Phasen der wissenschaftlichen Forschung Unterstützung leisten. Es kann Probleme erkunden, Forschungspläne entwerfen, Code schreiben, Experimente durchführen, Ergebnisse analysieren, aber auch Ergebnisse überprüfen, iterieren und optimieren, Arbeiten verfassen und bei der Einreichung helfen.
Um die Leistung von Sprachmodell-Agenten bei wissenschaftlichen Problemen umfassender zu verstehen, haben wir einen Benchmark namens TenureTrail entwickelt, der 7 Forschungsbereiche und 123 ausführbare Forschungsaufgaben abdeckt, die Phasen wie Problemerkundung, Forschungsdesign, Experimente und Datenanalyse, Überprüfung und Iteration umfassen. Die oben erwähnte umgekehrte Proteinfaltung ist eine dieser Aufgaben.
Aus den Bewertungsergebnissen geht hervor, dass Hy4 das Open-Source-Modell mit der besten Leistung ist, aber zwischen Open-Source-Modellen und den führenden Closed-Source-Modellen besteht noch eine Lücke.
Die Forschungsfähigkeit steigt wie der Wasserstand, die echte Veränderung ist die Freischaltung des vollständigen Arbeitsablaufs
Ich halte dies für eine etwas kontraintuitive Art des Fortschritts.
Früher war die Arbeit in einem vertikalen Bereich ähnlich wie das Bauen eines Hauses. Man muss sich auf dieses Problem konzentrieren und vom Fundament an Schicht für Schicht aufbauen.
Die Veränderungen, die durch allgemeine intelligente Agenten entstehen, ähneln mehr dem Ansteigen des Meereswassers. Der Wasserstand steigt stetig an, aber erst wenn er über die Nase steigt, spürt man wirklich, dass sich etwas verändert hat.
Programmierung ist ein Beispiel dafür.
In den letzten fünf bis zehn Jahren hat sich die Modellfähigkeit stetig verbessert. Erst als sie das Niveau menschlicher Ingenieure erreichte, hatten die Menschen plötzlich das Gefühl, dass ein dramatischer Wandel stattgefunden hat. Aber die zugrundeliegende Fähigkeit hat nicht erst an diesem Tag angefangen zu steigen, sondern sie ist stetig gewachsen.
Ein weiteres Merkmal ist, dass Fähigkeiten in verschiedenen Bereichen kombiniert werden können.
Vielleicht schaltet es heute die Datenanalyse frei, morgen die Codierung. Wenn Fähigkeiten wie Literaturrecherche, Schreiben, Datenanalyse und Programmierung nacheinander freigeschaltet werden, kann der intelligente Agent diese Teile verbinden, um einen größeren Aufgabenbereich und einen autonomeren Arbeitsablauf zu bilden.
Viele schrittweise Verbesserungen der Fähigkeiten führen letztendlich nicht zu einer isolierten Funktion, sondern zu einem vollständigen Arbeitsablauf.
Der nächste Schritt ist nicht nur die Abgabe einer Antwort, sondern die Hinterlassenschaft wiederverwendbarer Werkzeuge
Das dritte Paradigma kann als Fortsetzung des zweiten Paradigmas betrachtet werden.
Wir haben bereits gesehen, dass allgemeine intelligente Agenten Probleme wie Menschen lösen können. Einen Schritt weiter geht es darum, sie Software, Werkzeuge und Modelle erstellen zu lassen, um sich auf die Lösung weiterer Probleme in der Zukunft vorzubereiten.
Hier gibt es mehrere entscheidende Veränderungen.
Früher standen wir vor spezifischen Problemen, wie der Struktur eines bestimmten Proteins. Jetzt, mit allgemeinen intelligenten Agenten und spezialisierten Aufgabenframeworks, können die Probleme offener sein und die Methoden an verschiedene Bereiche angepasst werden.
Besonders bei computerbezogenen Aufgaben können die Modelle oft gute Ergebnisse erzielen, da die Ergebnisse leichter zu überprüfen und objektiver sind. Ob der geschriebene Code läuft und ob das Modell die Indikatoren erreicht, kann überprüft werden.
Dieses Framework heißt Hyra 2.0. Es ist ein Harness, also ein Betriebsframework für intelligente Agenten, das mehrtägige bis wochenlange Forschungsaufgaben unterstützt.
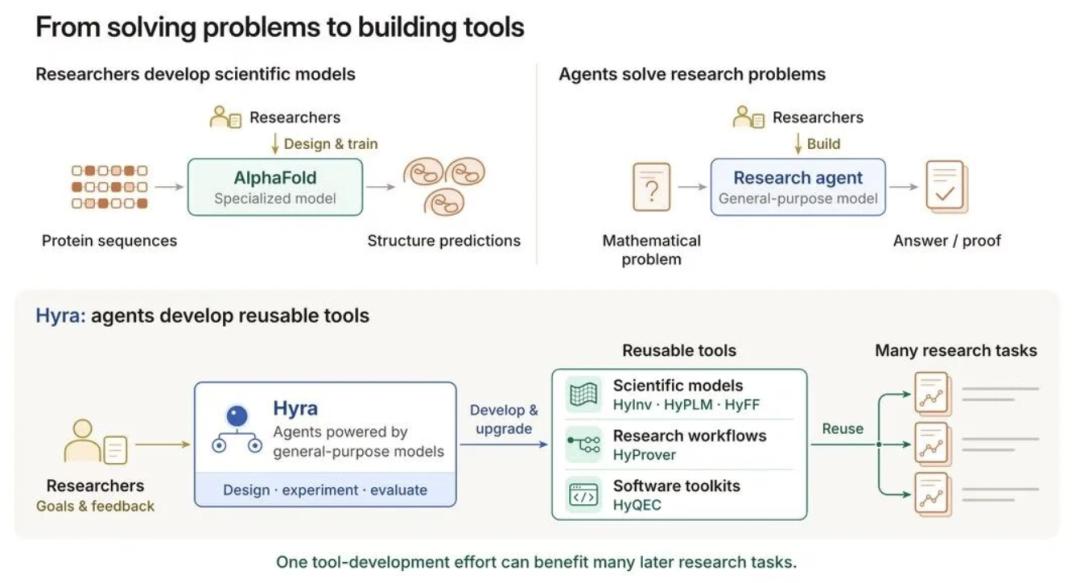
Sie können es sich als ein wissenschaftliches Labor vorstellen.
Die Overall-Ebene ist für die Gesamtkoordination zuständig, die Mission-Ebene zerlegt und treibt die Aufgaben voran, die Worker-Ebene führt die konkrete Forschung durch. Mehrere intelligente Agenten arbeiten zusammen, teilen Arbeitsfortschritte, diskutieren Entwicklungen, entwickeln Werkzeuge, sammeln ursprüngliche Beweise und prüfen sogar gegenseitig die Ergebnisse.
Forscher erhalten nicht nur eine endgültige Antwort, sondern können auch den Aufgabenverlauf, Beweise und Ergebnisse einsehen.
Auf diese Weise wird es zunehmend zu einem autonomen Forschungssystem, das kontinuierlich arbeiten kann.
Der nächste Schritt ist nicht nur die Abgabe einer Antwort, sondern die Hinterlassenschaft wiederverwendbarer Werkzeuge
Ein sehr interessantes Ergebnis ist, dass Hyra 2.0 selbst Modelle erstellen kann.
Es hat von Grund auf ein neues Modell namens