Die Details von Zen6 liegen endlich auf dem Tisch: Wie AMD EPYC in die Ära der Agenten-KI vorantreibt
Auf dem Gebiet der Rechenzentren hat AMD bereits große Erfolge erzielt.
Der Marktanteil von AMD-Server-CPUs ist von etwa 0,2 % im Jahr 2017 sprunghaft auf heute 46 % angestiegen. In den letzten zehn Jahren hat sich AMD von einem fast übersehenen Herausforderer zu einem Anbieter entwickelt, der fast die Hälfte des Marktes einnimmt.
In diesem Jahr hat AMD besonders stark aufgetreten und nacheinander mehrere wichtige Produkte vorgestellt, die alle in dieselbe Richtung zielen: Agentic AI.
Das erste Produkt ist die Zen-6-Architektur, die auf Architekturebene eine flexible Berechnungsgrundlage bietet, die speziell für das Zeitalter der Agenten entwickelt wurde.
Das zweite Produkt ist der EPYC-Prozessor der 6. Generation namens Venice, der über bis zu 256 Kerne verfügt und auf Chipebene eine CPU-Produktfamilie für Agentic AI bietet.
Das dritte Produkt ist das Helion-Rack, bei dem die CPU als Kern zur Steuerung und Ausführung von Agentenaufgaben dient und auf Rackebene ein rackweites Referenzdesign bietet, das speziell für Agentic AI entwickelt wurde.
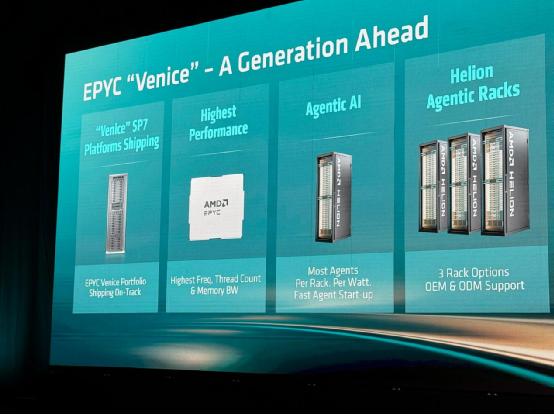
Am 4. November Ortszeit in den USA hat AMD auf der in Las Vegas abgehaltenen Konferenz AMD In Depth detailliert die Architekturgestaltung von Zen 6, die Produktaufstellung von Venice sowie die Ideen für die rackweite Bereitstellung unter KI-Lasten erläutert und auch einen Produktfahrplan veröffentlicht, der bis 2030 reicht.
Es ist erwähnenswert, dass AMD diesmal die MEXT-Speicheroptimierungstechnologie zum ersten Mal ausführlich vorgestellt hat. Gemäß den von AMD vorgelegten Testergebnissen wird bei bestimmten Agenten-KI-Arbeitslasten der DRAM-Verbrauch um 50 % reduziert, während die Systemleistung immer noch 99 % der Konfiguration mit vollständigem DRAM erreicht. Dies zeigt auch, dass sich AMD nicht mehr nur auf die Rechenkerne selbst konzentriert. Wie Daten effizienter und kostengünstiger zur CPU und GPU fließen können, wird zu einem wichtigen Bestandteil von AMDs Layout der KI-Infrastruktur.
Von den Kernen bis zu den Prozessoren, vom Speicher bis zu den Racks ist die gesamte Kette auf die Rechenzentren im KI-Zeitalter ausgerichtet. Hinter diesen neuen Produkten von AMD steckt nicht nur eine Leistungssteigerung, sondern auch sein neues Denken und seine Auswahl bei der Berechnungsinfrastruktur im KI-Zeitalter.
Zen 6 sorgt für Aufsehen: AMDs Überlegungen zur Architektur im KI-Zeitalter
Sehen wir uns zuerst den anspruchsvollsten Teil an: Zen 6.
Bisher hat AMD bereits angekündigt, dass der EPYC der 6. Generation maximal 256 Kerne erreicht, aber es wurde nicht klar erläutert, was genau im Inneren der Kerne geändert wurde. Diesmal hat AMD die Details von Frontend, Ausführungseinheit, Cache und Befehlssatz weiter offengelegt.
AMD-Architekt Mike Clark erklärte vor Ort, dass Zen 6 zwei Designpunkte gleichzeitig verstärkt: Einerseits die Durchsatzleistung des gesamten Prozessors, andererseits die Ausführungsfähigkeit mit hoher Taktfrequenz und niedriger Latenz. Entsprechend den Produkten sind das Zen 6c und Zen 6.
Zuerst gesehen von der Anzahl der Kerne: Hohe Dichte bewältigt Parallelität, hohe Taktfrequenz beschleunigt wichtige Schritte. Bei Zen 6c wird der einzelne Kernkomplex CCX von 16 Kernen auf 32 Kerne erweitert, der gemeinsam genutzte L3-Cache von 32 MB auf 128 MB erhöht, die maximale Taktfrequenz von 3,7 GHz auf 4,1 GHz angehoben und der gesamte Prozessor maximal von 192 Kernen auf 256 Kerne erweitert. Bei Zen 6 wird der CCX von 8 Kernen auf 12 Kerne erhöht, der L3-Cache von 32 MB auf 48 MB vergrößert und die maximale Boost-Taktfrequenz von 5,0 GHz auf 5,3 GHz angehoben.
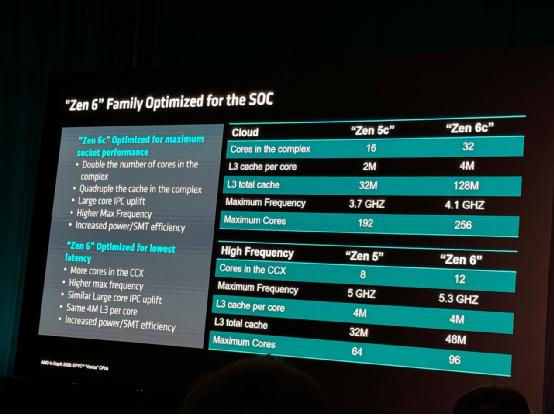
Diese beiden Wege entsprechen den KI-Szenarien im Zeitalter der Agenten. Viele Sitzungen, Sandboxen und Toolaufrufe laufen gleichzeitig, sodass mehr Kerne zur Bearbeitung der Aufgaben benötigt werden; bestimmte Codeausführungen, Datenbankzugriffe oder serielle Schritte wirken sich direkt auf die Abschlusszeit der gesamten Aufgabe aus, sodass eine stärkere Single-Thread-Leistung erforderlich ist.
Es gibt noch ein interessantes Detail: Der Fließkomma-Scheduler von Zen 6c besteht aus drei Gruppen mit jeweils 60 Einträgen, während die hochgetaktete Version von Zen 6 jeweils 46 Einträge pro Gruppe hat. Clark erklärte, dass je höher die Taktfrequenz ist, desto kürzer ist die Zeit, die der Schaltung pro Zyklus zur Verfügung steht, um die Arbeit abzuschließen, und die interne Struktur muss auch strengere Zeitanforderungen erfüllen. Da die Taktzielsetzung von Zen 6c relativ niedrig ist, nutzt AMD diesen Designraum, um die Scheduler-Ressourcen zu erhöhen, sodass der Prozessor die Möglichkeit hat, aus mehr wartenden Operationen ausführbare Arbeiten zu finden.
Zweitens: Mit der Erhöhung der Kerne müssen Cache und Speicherzugriff auch Schritt halten. Bei Zen 6c verdoppelt sich die Anzahl der Kerne und der L3-Cache wird direkt auf das Vierfache vergrößert. Umgerechnet auf die Anzahl der Kerne ändert sich die durchschnittliche L3-Kapazität pro Kern von 2 MB auf 4 MB, wobei jeder Kern noch 1 MB privaten L2-Cache behält. 128 MB L3-Cache werden von 32 Kernen gemeinsam genutzt, und aktive Kerne können sie nach Bedarf verwenden. Bei Programmen, die Daten gemeinsam nutzen, kann ein größerer Komplex auch die Kommunikation zwischen verschiedenen Komplexen reduzieren. Die Funktion des Caches ist leicht verständlich. Die CPU berechnet sehr schnell, aber das Abrufen von Daten aus dem Hauptspeicher erfordert Wartezeit. Die Datenbanken, Laufzeitumgebungen und Toolprogramme, die von Agenten aufgerufen werden, enthalten viele Verzweigungen und unregelmäßige Speicherzugriffe. Wenn wiederholt verwendete Daten in der Nähe der Kerne gehalten werden, können diese Wartezeiten reduziert werden. AMD hat auch die Vorabrufstrategie angepasst: Wenn es wenige Threads und freien Speicher gibt, ist sie aktiver; wenn viele Kerne um die Bandbreite konkurrieren, wird das ungültige Verschieben gesteuert, um zu vermeiden, dass der Pfad durch den Vorabruf selbst verstopft wird. Im Inneren der Kerne wurde auch der Raum zur Suche nach ausführbaren Befehlen erweitert. Zen 6 baut auf der von Zen 5 geschaffenen Grundlage für das Abrufen von Befehlen in zwei grundlegenden Blöcken und die Pipeline auf, erweitert den Op-Cache zum Speichern decodierter Operationen auf 6,75 K Ops, kann pro Zyklus maximal 18 Operationen bereitstellen und hat eine nachfolgende Zuweisungsbreite von 8 Wegen. Das Out-of-Order-Fenster von Zen 6c wird von 448 Einträgen auf 640 Einträge erweitert, das Ganzzahl-Physikalische Register von 240 Einträgen auf 352 Einträge und die Load/Store-Warteschlange von 64/96 Einträgen auf 80/128 Einträge. Man kann sich das Out-of-Order-Fenster als To-Do-Liste vor den Augen der CPU vorstellen: Wenn die vorherigen Arbeiten auf Daten warten, sucht sie nach Arbeiten, die später zuerst erledigt werden können. Mit der Erweiterung des Fensters und der zugehörigen Ressourcen wird der Spielraum zur Bearbeitung von Arbeiten größer. Dies hängt stark mit der Last der Agenten-Ausführungsebene zusammen. Die echte Software, die sie aufruft, enthält oft viele Verzweigungen, Funktionsaufrufe und unregelmäßige Speicherzugriffe, sodass der Prozessor in diesen komplexen Pfaden kontinuierlich nach Arbeiten suchen muss, die vorangetrieben werden können.
Schließlich gesehen von der Vektorberechnung: Zen 6 behält die 512-Bit-Fließkommapfade bei und bietet erstmals vollständige Unterstützung für die AVX-512-FP16-Berechnung. Die Ausführungspipeline für INT8 VNNI wird von zwei Wegen auf vier Wege erweitert und um die Fähigkeit zur Bit-Matrix-Multiplikation ergänzt. Beim Laden von Daten werden zwei 512-Bit-Operationen oder vier 256-Bit-Operationen pro Zyklus unterstützt. Die insgesamt übertragene Datenmenge ist ungefähr gleich, die Verbesserung besteht darin, dass bereits vorhandener 256-Bit-Code die Pfade auch vollständiger nutzen kann. Da Unternehmenssoftware nur langsam aktualisiert wird, ist diese Kombination sehr praktisch.
Zusammengenommen wird AMDs Denkweise deutlich: Hochgetaktete Kerne beschleunigen wichtige Schritte, hochdichte Kerne bewältigen eine große Menge an Parallelität, Cache, Ausführungsfenster und Datenzugriffsfähigkeit helfen den Kernen, kontinuierlich zu arbeiten, und Vektor- und Systemfähigkeiten erweitern den Anwendungsbereich.
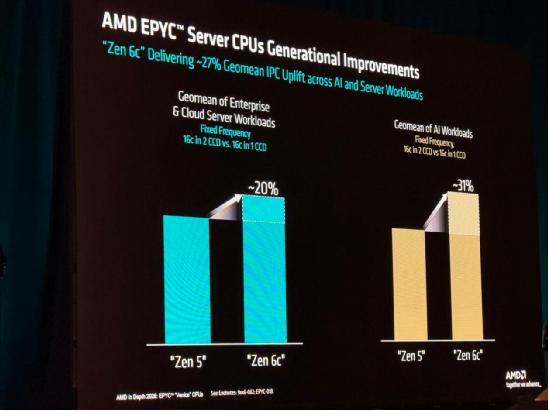
Wie viel Verbesserung bringen diese Änderungen? Bei Tests mit fester Taktfrequenz und festen 16 Kernen erzielt Zen 6c im Vergleich zu Zen 5 eine geometrische durchschnittliche IPC-Steigerung von etwa 20 % bei ausgewählten Unternehmens- und Cloud-Arbeitslasten, etwa 31 % bei KI-Arbeitslasten und eine Gesamtsteigerung von etwa 27 %. Clark erklärte offen, dass AMD seit langem davon überzeugt ist, dass CPUs einen Platz im KI-Software-Ökosystem einnehmen werden, und daher die allgemeine Berechnung, Vektorfähigkeiten und Systemeffizienz kontinuierlich verstärkt. Der Aufstieg der Agenten wertet den Wert dieser Designs auf. Dies entspricht auch der Positionierung von AMD für die Zen-6-Architektur: Flexible Berechnung für das Zeitalter der Agenten (Flexible Computing for the Agentic Era).
EPYC 9006 ist positioniert: AMDs Überlegungen zur CPU im KI-Zeitalter
Auf der Veranstaltung AMD in Depth zeigte AMD einen 96-Kern-Venice mit einer maximalen Boost-Taktfrequenz von 5,3 GHz. Dieser hochgetaktete Venice ist nur eines der Mitglieder der EPYC-Produktpalette der 6. Generation. SP7 bietet noch eine hochdichte Version mit bis zu 256 Kernen und unterstützt 16 Kanäle Speicher; SP8 deckt 8 bis 128 Kerne ab und ist für Unternehmensserver ausgelegt; Venice-X nutzt 3D V-Cache für EDA und Hochleistungsrechnen; Verano verwendet LPDDR5X und konzentriert sich auf die Energieeffizienz von KI-Hostknoten.
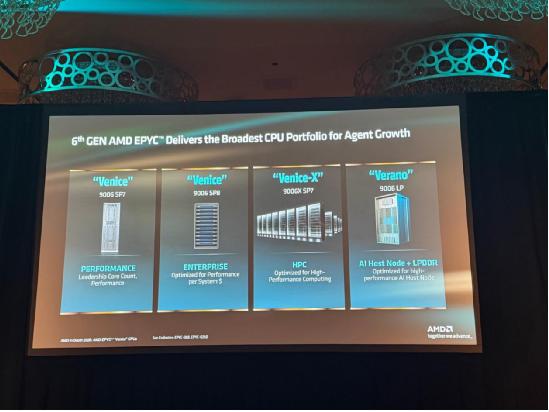
AMD stellt so viele verschiedene CPUs bereit, was damit zusammenhängt, wie Agenten arbeiten. Früher stellte der Benutzer eine Frage und das Modell gab eine Antwort. Jetzt, wenn ein Agent eine Aufgabe erledigt, kann er zuerst eine Datenbank abfragen, dann Code schreiben und Tests ausführen. Wenn er feststellt, dass das Ergebnis nicht stimmt, muss er zurückgehen und es erneut ausführen. Der Benutzer hat nur einmal einen Befehl gegeben, aber im Hintergrund laufen mehrere Durchläufe. Das Modell ist für die Planung und Beurteilung verantwortlich, und die Ausführung dieser Pläne erfordert eine große Menge an CPU-Ressourcen.
AMD unterteilt die CPUs in der Agenten-Infrastruktur in drei Rollen: Die erste Kategorie ist der AI Host Node, der als Host für GPUs fungiert; die zweite Kategorie ist die Agent Sandbox, die eine Sandbox für die Codeausführung und Toolaufrufe bereitstellt; die dritte Kategorie ist ein allgemeiner Rechenknoten, auf dem die ursprüngliche Software des Unternehmens ausgeführt wird.
Als Host für GPUs muss es zuerst schnell sein. Wenn Schritte wie das Vorbereiten von Daten, Übermitteln von Aufgaben und Verarbeiten von Anforderungen an der CPU hängen bleiben, können die nachfolgenden GPUs auch ungenutzt bleiben. Für diese Art von Arbeiten ist die Erhöhung der Verarbeitungsgeschwindigkeit wichtiger Threads oft nützlicher als die weitere Erhöhung der Anzahl der Kerne. Das vor Ort gezeigte Venice mit 96 Kernen und maximal 5,3 GHz zielt genau auf diese Anforderungen ab. AMD hat eine weitere Lösung für Hostknoten vorbereitet: Verano. Es bietet maximal 192 Zen-6c-Kerne oder 72 Zen-6-Kerne, verwendet 24 Kanäle LPDDR5X-8533 und reduziert den Energieverbrauch bei der Datenübertragung zwischen Chiplets durch EFB-Verbindungen. Natürlich können die Speicher austauschbare SOCAMM-Module verwenden. Das LPDDR5X hier verdient eine ausführlichere Erläuterung. Betrachtet man die Agenten-CPUs, die AMD, Intel und Nvidia in diesem Jahr vorgestellt haben, sind die meisten mit LPDDR5X-Produkten ausgestattet. Zum Beispiel verwendet Nvidias Vera ebenfalls LPDDR5X und SOCAMM mit einer maximalen Speicherbandbreite von etwa 1,2 TB/s, hauptsächlich weil Rechenzentren zunehmend strengere Beschränkungen bei Stromversorgung und Wärmeabfuhr ausgesetzt sind. LPDDR5X wurde ursprünglich für mobile Geräte und Edge-Geräte entwickelt. Heute ist es dank der Tatsache, dass es eine höhere Speicherbandbreite bietet, während der Stromverbrauch nur ein Bruchteil des herkömmlichen DDR5-Implementierung beträgt, der Übergang zu LPDDR5X eine wichtige Weiterentwicklung der Serverarchitektur.
