Google hat einen neuen KI-Chip vorgestellt, der eine verdoppelte HBM-Bandbreite bietet.
Laut einem Bericht von Core Eastern vom 9. November hat Google gerade zwei neue TPU vorgestellt: den TPU 8i Max, der für extrem große Kontextfenster konzipiert ist und die höchste Rechenleistungsdichte pro Rack bietet, sowie den TPU 8tx, der sichere und vertrauliche Inferenz unterstützt.
Google gibt an, dass der TPU 8tx die Latenz im Vergleich zum TPU 8t um bis zu die Hälfte senken kann, wobei der Leistungsverlust nahezu vernachlässigbar ist; die Rechenleistung, der SRAM und die HBM-Bandbreite des TPU 8i Max sind jeweils doppelt so hoch wie beim TPU 8i.
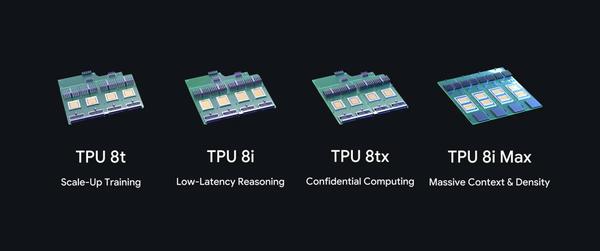
Dies ist das erste Mal, dass Google innerhalb eines Jahres 4 TPU-Modelle auf den Markt bringt. Im April dieses Jahres hatte Google zwei neue spezielle TPU vorgestellt: den 8t für groß angelegtes Training und den 8i für Echtzeit-Inferenz.
Damit decken die vier TPU-Modelle der 8. Generation von Google den gesamten Lebenszyklus von Agenten ab.
Neben der Vorstellung der neuesten TPU hat Google auch den einheitlichen Open-Source-Software-Stack für Entwickler aktualisiert.
01. Gegen vertrauliches Computing und die Speicherwand: Google stellt zwei neue TPU vor
Google hat bisher TPU in Zusammenarbeit mit Google DeepMind entworfen. Da sich das Berechnungsparadigma aber von der Ausrichtung auf menschliche Interaktionen hin zu auf Agenten ausgerichteten Aufgaben wandelt, benötigen Unternehmen Beschleuniger, die Inferenz in extrem großen Kontextfenstern durchführen können. Einige Kunden aus stark regulierten Branchen verlangen zudem spezielle Verschlüsselungsfunktionen für ihre geschäftsspezifischen Workloads.
Das ist der Grund, warum Google diese beiden neuen TPU vorgestellt hat: Das Ziel ist es, jedem Entwickler und Cloud-Kunden die einfache Nutzung von TPU zu ermöglichen.
Das TPU-Produktportfolio der 8. Generation von Google zielt auf verschiedene Phasen des KI-Lebenszyklus ab:
Der im April dieses Jahres vorgestellte TPU 8t ist als Trainingskern für große Basismodelle konzipiert und zielt auf den höchsten "effektiven Durchsatz" ab, also die effektive intelligente Leistung, die pro Watt elektrischer Leistung erzeugt wird; der TPU 8i ist eine Inferenz-Engine, die die Speicherwand durchbrechen und die Kommunikationslatenz zwischen Chips um bis zu die Hälfte senken soll.
Die neu vorgestellten TPU 8tx und TPU 8i Max zielen auf vertrauliches Computing und die Speicherwand ab.
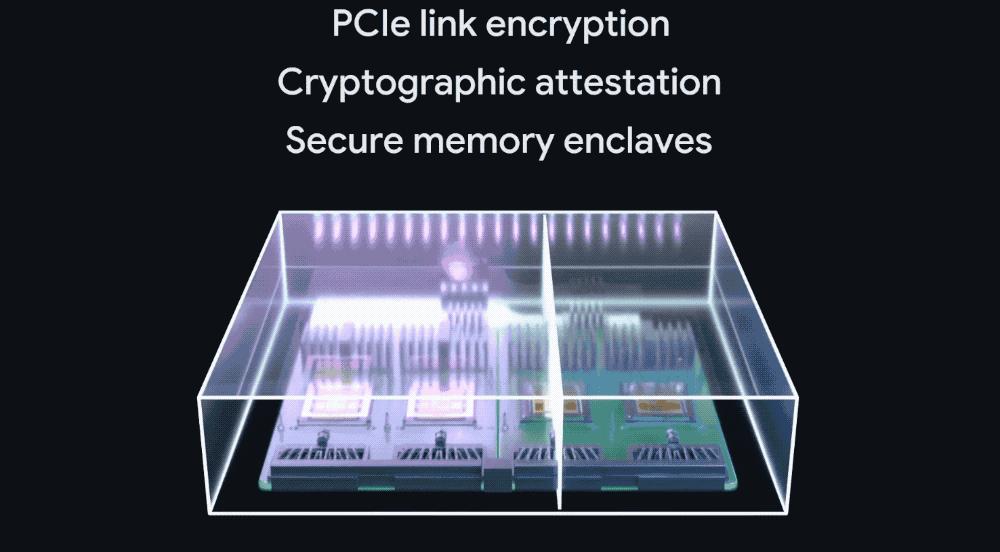
TPU 8tx ist das dritte Modell der 8. TPU-Generation von Google, optimiert für sichere und vertrauliche Inferenz und eignet sich auch für kleinskaliges Training. Es wurde für regulierte Unternehmen und Regierungsbehörden entwickelt, die sensible Daten verarbeiten und gleichzeitig Spitzenmodelle und Agenten ausführen können.
Normalerweise werden Daten bei der Speicherung oder der Netzwerkübertragung verschlüsselt, aber während der Verarbeitung durch den Computer müssen sie im Speicher entschlüsselt werden. Der TPU 8tx verwendet denselben Chip wie der TPU 8t, gepaart mit Hosts der fünften Generation von AMD EPYC CPU, und integriert Sicherheitsfunktionen direkt in die Hardwareebene. Dadurch bleiben sensible Daten und Modellgewichte auch während der Ausführung und Nutzung dauerhaft geschützt und isoliert.
Gleichzeitig nutzt der TPU 8tx das niedrig-latente Boardfly-Netzwerk, das Google für Echtzeit-Inferenz entwickelt hat, um den reibungslosen Ablauf mehrstufiger Agentenaufgaben zu gewährleisten. Google behauptet, dass der TPU 8tx die Latenz im Vergleich zum TPU 8t um bis zu die Hälfte senken kann, wobei der Leistungsverlust nahezu vernachlässigbar ist.
Die Kombination von Trainings-Rechenleistung und Hochgeschwindigkeits-Inferenznetz bedeutet auch, dass Unternehmen Modelle auf demselben System gleichzeitig ausführen und anpassen können. Mit dem TPU 8tx können Entwicklungsteams Modelle mit privaten Daten feinabstimmen, große Modelle zu kleinen Modellen destillieren und Agenten durch Verstärkungslernen trainieren – ohne dass sensible Daten zwischen mehreren unabhängigen Clustern migriert werden müssen.
TPU 8i Max löst das Problem der Speicherwand.
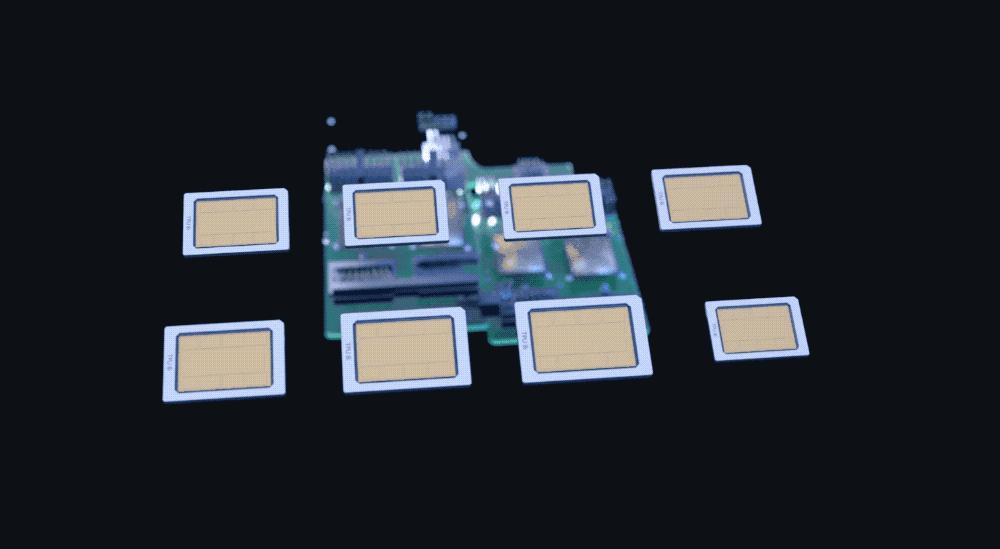
Wenn Dutzende von Agenten gleichzeitig gemeinsam an gesamten Software-Codebasen oder stundenlangen Videomaterialien arbeiten, wird der Engpass der Speicherbandbreite deutlich. Daher hat Google zwei niedrig-latente TPU 8i-Chips auf demselben Gehäusesubstrat verbaut.
Google gibt an, dass der TPU 8i Max eine synchrone Erweiterung von Rechenleistung und Speicher ermöglicht, wobei Rechenleistung, SRAM und HBM-Bandbreite jeweils doppelt so hoch sind wie beim TPU 8i.
Zudem integriert der TPU 8i Max die doppelte Chipfläche im ursprünglichen Rack-Raum, sodass Rechenzentren mehr Rechenleistung bei gleicher Grundfläche und gleichem Stromverbrauch bereitstellen können.
02. Google will TPU für alle Entwickler öffnen und den Software-Stack einheitlich aktualisieren
Google hat zudem angekündigt, dass es folgende Punkte umsetzen wird, um TPU für alle Entwickler zugänglich zu machen:
Erstens wird Google allen PyTorch-Entwicklern die TPU-Entwicklungsfunktionen öffnen, ohne dass sie ihren Code neu schreiben müssen.
Im vergangenen Monat hat Google TorchTPU, das native PyTorch-Framework für TPU, als Open-Source veröffentlicht. Jetzt können PyTorch-Code und Modelle auf Hugging Face nativ auf TPU ausgeführt werden, zudem bieten gängige Open-Source-Inferenz-Engines wie vLLM und SGLang sofort einsatzbereite TPU-Backends.
Um die Hürden für die Hardware-Optimierung zu senken, kann das von Google als Open-Source veröffentlichte TPU-Agenten-Toolkit direkt mit Programmierwerkzeugen wie Claude Code, Cursor und Google Antigravity verbunden werden. Es ermöglicht die Einrichtung der TPU-Umgebung innerhalb weniger Minuten, die automatische Lokalisierung von Leistungsengpässen und unterstützt die automatische Optimierung benutzerdefinierter Operatoren in natürlicher Sprache. Derzeit befindet sich dieses Toolkit noch in der Vorschauversion.
Für Produktivbereitstellungsszenarien hat Google den XLA Serving Engine-Workflow als Open-Source veröffentlicht, der das Training von Modellen mit Python und die anschließende direkte Bereitstellung im niedrig-latenten C++-Runtime unterstützt und Dienste auf heterogener Hardware über TPU, GPU und CPU hinweg bereitstellen kann.
Zweitens gibt Google an, dass TPU bereits branchenführende Produktionsleistungen bei den Benchmarks InferenceX und AgentX erreicht hat.
Die branchenüblichen Evaluierungssätze InferenceX und AgentX richten sich an echte Szenarien wie die Codegenerierung durch Agenten und Aufgaben mit langem Kontext. Nach den von Google veröffentlichten Testergebnissen wurde mit dem nativen vLLM-TorchTPU-Software-Stack auf TPU eine derzeit führende Kosten-Leistungs-Verhältnis-Leistung erzielt. Dieser Vorteil deckt viele Spitzen-Open-Source-Modelle und verschiedene Open-Source-Dienst-Stacks ab, ohne die Modellgenauigkeit zu beeinträchtigen.
Drittens wird Google das Problem der verschwendeten Rechenleistung bei autonomen Agenten weiter beseitigen.
KI-Agenten sind zustandsbehaftete Programme, die beim Warten auf Abfrageergebnisse aus Datenbanken, Rückmeldungen von externen Tools oder menschliches Feedback oft mehrere Sekunden oder sogar Stunden anhalten. Um den Energieverbrauch von Beschleunigern in solchen Wartezeiten zu senken, kann die von Google eingeführte Agent Compute Engine-Software inaktive Agentensitzungen automatisch anhalten und den Arbeitsspeicher innerhalb von Millisekunden vom Chip auslagern.
Viertens wird Google mit TPU Sync die Speicherwand durchbrechen.
Google wird TPU Sync, die Modellzustandsschicht für TPU-Cluster, als Open-Source veröffentlichen. TPU Sync fusioniert den Chip-HBM, den Host-DRAM, den gemeinsam genutzten Speicher und das Rechenzentrumsnetzwerk zu einem koordinierten, einheitlichen Speicherhierarchie; es kann KV-Cache innerhalb von Millisekunden automatisch außerhalb des Chips absenken, Kontext zwischen entkoppelten Auffüllknoten und Decodierungsknoten streamen und Verstärkungslerngewichte synchronisieren, wodurch die KV-Übertragungslatenz und die Generierungszeit des ersten Tokens um mehr als 90 % gesenkt werden.
Fünftens wird Google verteilte Aufgaben auf mehreren TPU mit einem einzigen Controller horizontal skalieren.
Das von Google selbst entwickelte Laufzeitsystem für groß angelegtes verteiltes maschinelles Lernen Cloud Pathways ist jetzt offiziell in Google Kubernetes Engine (GKE) verfügbar und öffnet die Google DeepMind-Laufzeit für alle Google Cloud-Kunden.
Mit der Single-Controller-Architektur und den Pathways-Tools können Entwickler groß angelegte TPU-Cluster über mehrere TPU-Slices hinweg orchestrieren. Google gibt an, dass Entwickler es für Vor-Training, Verstärkungslernen oder Multi-Host-Inferenz genauso einfach nutzen können wie einen lokalen Rechner.
Zudem ermöglicht Cloud Pathways durch co-lokalisierte Python-Sidecars, den schnellen Wechsel von TPU-Slices innerhalb weniger Minuten und die elastische Umordnung von Shards, dass lang laufende Aufgaben auch bei Hardwarefehlern fortgesetzt werden können.
Schließlich wird Google dynamische Slicing-Funktionen von GKE nutzen, um benutzerdefinierte TPU-Topologien bedarfsweise zusammenzufügen.
Die dynamische Slicing-Funktion von GKE ist jetzt offiziell verfügbar. Sie nutzt die optische Circuitswitching-Technologie (OCS), um die Bereitstellung physischer Hardwareressourcen von der Zusammenstellung logischer Slices zu entkoppeln. Diese Funktion kann TPU-Würfel in Echtzeit dynamisch zu größeren Topologien (Hyper-Slices) kombinieren oder in kleinere, voneinander isolierte Workloads (Sub-Slices) aufteilen.
Google gibt an, dass diese flexible Topologiefunktion die Startzeit von Aufgaben auf bis zu 1/5 der ursprünglichen Dauer senken und die Fehlerwiederherstellungsgeschwindigkeit um bis zum 4,5-fachen steigern kann, wodurch die Ressourcennutzung des gesamten TPU-Pools und der effektive Durchsatz von Aufgaben maximiert werden.
03. Schlussfolgerung: Im Agenten-Zeitalter müssen Beschleuniger zur szenariospezifischen Anpassung übergehen?
Google gibt an, dass heute immer mehr Unternehmen KI nutzen, um die nächste Generation von KI-Infrastruktur zu konzipieren und zu bauen – und Google tut das auch. Ob mit dem AlphaChip-Verstärkungslernsystem von Google DeepMind oder mit Gemini, das Chip-Layout-Entwürfe innerhalb weniger Stunden fertigstellt: Google nutzt KI-Dienste auf TPU-Basis, um die Entwicklung der nächsten Generation von TPU-Hardware zu beschleunigen.
Heute explodiert der Bedarf an Rechenleistung für Agenten-Szenarien, und Rechenleistungshersteller wechseln von universellen Beschleunigern hin zu spezialisierten Optimierungen für Szenarien wie Training, Inferenz, Vertraulichkeit und langer Kontext. Google hat durch die wechselseitige Förderung von Chips, Modellen und Systemen einen geschlossenen Kreislauf gebildet und diese um den gesamten Agenten-Lebenszyklus angepasste Beschleunigerlösung entwickelt – eine neue Erkundung, die dem oben genannten Trend folgt.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto "Core Eastern", Autor: Cheng Qian, Redakteur: Panken, veröffentlicht mit Genehmigung von 36Kr.