AI Scientists „Der ultimative Test“: Der weltweit erste Physical AI Verifier für echte Nassexperimente ist da.
Vor einiger Zeit stellte Anthropic ein Forschungsergebnis im Bereich KI für die Wissenschaft vor: Claude erzeugte innerhalb von 64 Stunden 318.000 Proteinentwürfe. Nach dem Screening wurden 211 davon in Nasslabore getestet, und schließlich erfüllten 17 davon die voreingestellten Proteinbindungsstandards, was das enorme Potenzial zeigt, dass das wissenschaftliche Design durch KI zu einer echten experimentellen Validierung führt. Anthropic wies aber auch darauf hin, dass von der nachgewiesenen Bindung bis zu einer wirklich einsetzbaren Anti-Gift-Therapie noch eine Reihe von Herausforderungen wie komplexe Aktivitätsvalidierungen und Prüfungen der Arzneimittelverträglichkeit zu bewältigen sind.
Dies verdeutlicht eine der schärfsten Realitäten im aktuellen Bereich KI für die Wissenschaft: Das Ableiten von Lösungen in der virtuellen Welt ist etwas völlig anderes, als Experimente in der realen physischen Welt durchzuführen.
Wie tief ist also die Kluft zwischen den von Modellen vorgeschlagenen Lösungen und echten physikalischen Experimenten? Früher konnte das niemand genau sagen, da der Branche ein Satz von physischen Validierungsbenchmarks fehlte, die wiederholt ausgeführt und horizontal verglichen werden können. Für Code gibt es Komponententests, für Mathematik gibt es Standardantworten, aber echte Experimente werden durch Geräteunterschiede, Ausführungsfehler und Kosten eingeschränkt, und die Ergebnisse verschiedener Labore lassen sich nur schwer direkt vergleichen.
Kürzlich hat AISLE (AI Scientists' Last Exam, die ultimative Abschlussprüfung für KI-Wissenschaftler), die gemeinsam von Rhythmic Creation und mehreren weltweit führenden wissenschaftlichen Einrichtungen entwickelt wurde, versucht, ein neues „Maß“ für die echten experimentellen Fähigkeiten von KI zu schaffen. Als weltweit erster öffentlicher Benchmark für die wissenschaftliche Entdeckung im geschlossenen Kreislauf von Trocken- und Nassversuchen möchte AISLE verschiedene Modelle in echte Labore bringen und sie unter einheitlichen Standards der Prüfung in der physischen Welt unterziehen.
Projektadresse: https://aisle.science/
Github repo: https://github.com/MasterAI-EAM/ai-scientists-last-exam
Link zum Paper: https://github.com/MasterAI-EAM/ai-scientists-last-exam/blob/main/paper/AI_Scientists_Last_Exam.pdf
Und das Ergebnis lautet: Bei den in der ersten Runde kumulativ durchgeführten 4079 echten Nasslaborversuchen legten die teilnehmenden Spitzenmodelle wie GPT, Claude und Gemini ein warnendes Zeugnis vor: Unter den Modellen, die die Bewertung der Nasslabor-Bestenliste abgeschlossen haben, erzielte das GPT 5.5 mit dem ersten Gesamtrang bei einer vollen Punktzahl von 100 nur 41,19 Punkte; bei Experimentoptimierungsaufgaben mit Sicherheitsbeschränkungen lag die vollständige Bestehensquote aller teilnehmenden Modelle bei 0 %, und die Punktzahl von GPT 6 Astra sank sogar.
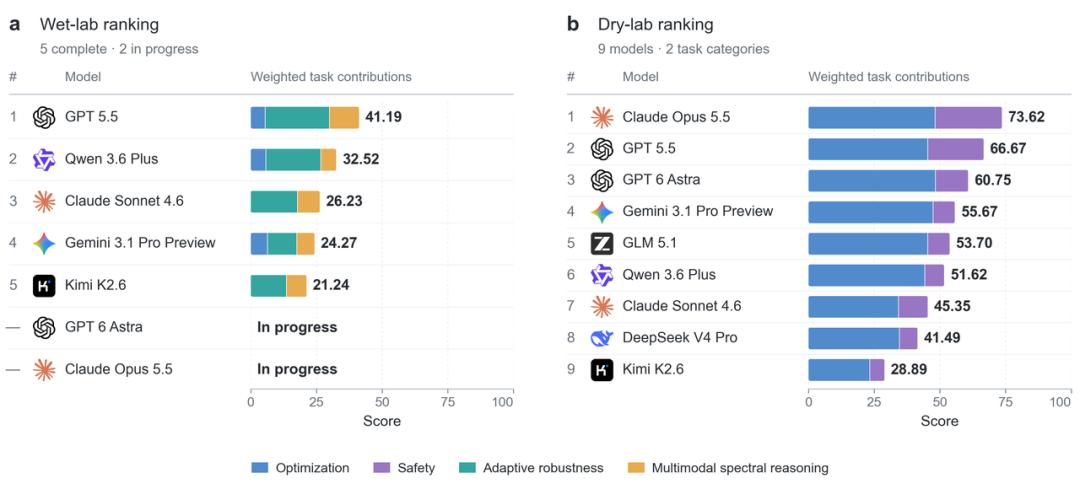
Dieses Ergebnis bricht vollständig den „Aura des Prüfungsmeisters“ der großen Modelle auf den Bestenlisten.
Auf dem Computer berechnet das Modell „1+1“ hundert Millionen Mal, und das Ergebnis bleibt immer 2. Aber in einem echten Nasslabor kann ein automatisiertes Pipettiergerät hundert Millionen Mal dieselbe Operation ausführen, und die Ergebnisse werden niemals vollständig identisch sein. Geräte verschleißen, die Genauigkeit driftet, die Messdaten enthalten Rauschen, und die Experimentumgebung kann sich jederzeit ändern…
Noch alarmierender ist, dass die Verbesserung der wissenschaftlichen Fähigkeiten nicht bedeutet, dass die Sicherheitsfähigkeiten gleichzeitig steigen. Wenn das Modell direkt auf Experimentgeräte zugreift, kann eine Entscheidung, die gegen Sicherheitsbeschränkungen verstößt, von einem Fehler in der digitalen Welt zu Geräteschäden, Personenschäden oder sogar Umweltverschmutzung in der Realität werden. Sogar wenn das Modell die allmählich in mehreren Interaktionen auftauchenden gefährlichen Absichten nicht erkennen kann, kann seine wissenschaftliche Ableitungsfähigkeit bösartig missbraucht werden.
Das ist auch eine weitere Bedeutung von AISLE: Während globale Technologiegiganten um die technische Vision des „KI-Wissenschaftlers“ wetteifern, enthüllt diese physische Abschlussprüfung eine grausame Realität: Die Fähigkeitsgrenzen eines KI-Wissenschaftlers dürfen nicht nur danach beurteilt werden, ob er korrekte Hypothesen aufstellen und experimentelle Ziele erreichen kann, sondern auch danach, ob er während des gesamten Experimentierprozesses die Sicherheitsgrenzen einhalten kann.
Es ist bemerkenswert, dass hinter dieser arbeit, die einen Meilenstein für die Branche darstellt, eine Gruppe führender Forschungskräfte aus den Bereichen automatisierte Labore, rechnergestützte Chemie und KI für die Wissenschaft zusammengekommen ist. Das Projekt wurde von Dr. Xie Tong, Gründer von Rhythmic Creation, initiiert und gemeinsam von der University of New South Wales (UNSW), der National University of Singapore (NUS), der École Polytechnique Fédérale de Lausanne (EPFL) und der University of California, Berkeley (UC Berkeley) geleitet. Zu den Teilnehmern gehören 13 weltweit führende AI4Science-Labore, darunter der Berkeley-Materialwissenschaftler Gerbrand Ceder, der Pionier des chemischen Agenten Philippe Schwaller von der EPFL und das Team des Acceleration Consortium, das Pionierarbeit auf dem Gebiet der chemischen verkörperten und selbstgesteuerten Labore (SDL) leistet, sowie Forscher von Einrichtungen wie NVIDIA, Microsoft Research und Lilly.
Das Team von Gerbrand Ceder hat beispielsweise die Entwicklung des autonomen Materiallabors A-Lab geleitet und mit dem Materialentdeckungsergebnis GNoME von Google DeepMind zusammengearbeitet. Im Jahr 2023 wurde die entsprechende Forschung in *Nature* veröffentlicht und zeigte das Potenzial der Kombination von KI-Materialvorhersage und automatisierter Robotersynthese.
Die „letzte Meile“ von KI für die Wissenschaft: Von Theorie und Berechnung zu Experimenten
Aus der Methodik der wissenschaftlichen Entdeckung besteht ein vollständiger Forschungszyklus in der Regel aus drei Phasen: theoretische Ableitung, numerische Berechnung und Simulation sowie die abschließende Durchführung physikalischer Experimente.
In den letzten Jahren haben Modelle von KI-Großunternehmen wie OpenAI und Anthropic eine immer erstaunlichere Generalisierungsfähigkeit gezeigt und ständig neue Durchbrüche bei der mathematischen Schlussfolgerung und der Lösung wissenschaftlicher Probleme erzielt. KI ist auch in Forschungsprozesse wie die Vorhersage von Proteinstrukturen, Moleküldesign und Materialentdeckung eingetreten.
Aber der endgültige geschlossene Kreislauf der wissenschaftlichen Entdeckung muss schließlich in echten Experimenten umgesetzt werden. Nur Experimente können die endgültige Beurteilung liefern, ob die von dem Modell vorgeschlagenen Hypothesen durch echte Beobachtungen gestützt werden und ob die optimalen Lösungen in der Berechnung in der physischen Welt Bestand haben.
Aber das Problem ist, dass das Feedback von physikalischen Experimenten weitaus komplexer ist als das von digitalen Aufgaben. Ein Experiment erfordert nicht nur Geräte, Reagenzien und Zeit, sondern die Ergebnisse können auch durch Messrauschen, Ausführungsfehler und Gerätezustände beeinflusst werden. Selbst wenn das Experiment fehlschlägt, ist es schwer sofort zu beurteilen, ob das Problem in der Lösung, der Bedienung oder dem Gerät selbst liegt.
Das macht automatisierte Labore zu einer wichtigen Entwicklungsrichtung für KI für die Wissenschaft. Ziel ist es, Roboter, Experimentgeräte und KI-Agenten zu verbinden, sodass Modelle nicht nur vorhandene Daten analysieren, sondern auch Experimente aktiv entwerfen, Operationen durchführen, Ergebnisse auslesen und dann entscheiden können, was als Nächstes zu tun ist.
Im Oktober dieses Jahres stellte Google Research beispielsweise das VERID-Framework vor, das über ein semantisches digitales Zwillingsmodell des Labors den Status von Roboterarmen, Reagenzienvolumina und Verbrauchsmaterialien verfolgt, sodass KI-Agenten virtuelle Proben vor der Durchführung echter Operationen durchführen und das Betriebsrisiko durch Sicherheitsüberprüfungen senken können.
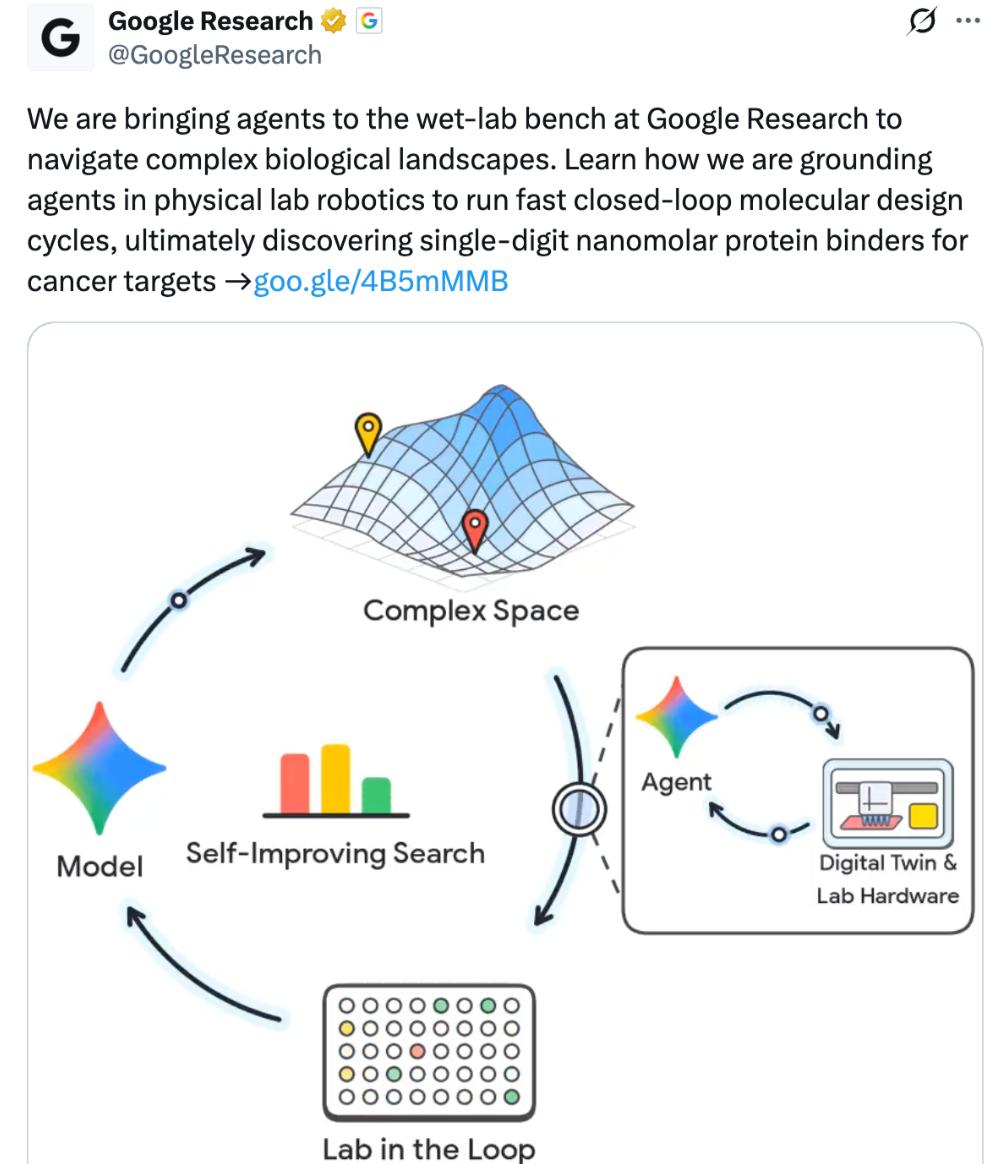
Die Fähigkeit von KI, Experimentgeräte zu bedienen, löst jedoch nur einen Teil des Problems. AISLE konzentriert sich darüber hinaus auf folgende Frage: Wie kann die Leistung des Modells während des gesamten Experimentierprozesses gemessen werden, und wie lassen sich die experimentellen Ergebnisse in dauerhaft nutzbare Feedback-Signale umwandeln.
Seit langem ist es schwierig, Feedback aus echten Experimenten so effizient und in großem Maßstab wie Testergebnisse für Code zur Bewertung und zum Training von Modellen zu verwenden. Wie man spärliches, verzögertes und verrauschtes physisches Feedback in eine zuverlässige Bewertungsgrundlage umwandelt, ist ein Problem, das im Bereich KI für die Wissenschaft gelöst werden muss.
AISLE möchte diese Lücke schließen: Echte Experimente sollen nicht nur der endgültige Prüfungsort für KI sein, bei dem die Antworten in der physischen Welt liegen. Modelle können Papiere auswendig lernen und alle Fragensammlungen durcharbeiten, aber sie können die Ergebnisse des nächsten echten Experiments nicht im Voraus auswendig lernen. Geräte driften, Materialien ändern sich, neue experimentelle Bedingungen tauchen ständig auf – das ist keine Prüfung, die man durcharbeiten kann, sondern ein Prüfungsort, der ständig neue Aufgaben stellt und zu einer Quelle für Feedback für das kontinuierliche Lernen wird.
AISLE: Die „letzte Prüfung“ für KI-Wissenschaftler, Nature as the Verifier?
Der Kerngedanke von AISLE besteht darin, einen verteilten physischen Prüfer zu schaffen, der Modellschlussfolgerung, rechnerische Simulation und echte Experimente miteinander verbindet. Es nutzt automatisierte Labore als Ausführungsplattform, bildet einen geschlossenen Kreislauf aus „Lösung vorschlagen – Experiment durchführen – Beobachtungen erhalten – Entscheidungen anpassen“ für Trocken- und Nassversuche und wandelt das Feedback aus der physischen Welt in Signale um, die für die Modellbewertung und kontinuierliche Verbesserung verwendet werden können.
Im Gegensatz zu früheren Erkundungen, die auf einem einzelnen Labor basieren, verbindet AISLE durch ein einheitliches Protokoll für Aufgaben, Aktionen und Beobachtungen verschiedene führende große Modelle mit automatisierten Laboren an verschiedenen Standorten mit unterschiedlichen Geräten. Das Team hat neun Monate gebraucht, um den gesamten Prozess vollständig zum Laufen zu bringen.
Dabei ermöglicht das einheitliche Harness den Vergleich der Ergebnisse verschiedener Standorte unter denselben Standards, während die Geräteunterschiede zwischen den Standorten beibehalten werden, um die Robustheit des Modells unter verschiedenen Bedingungen zu prüfen.
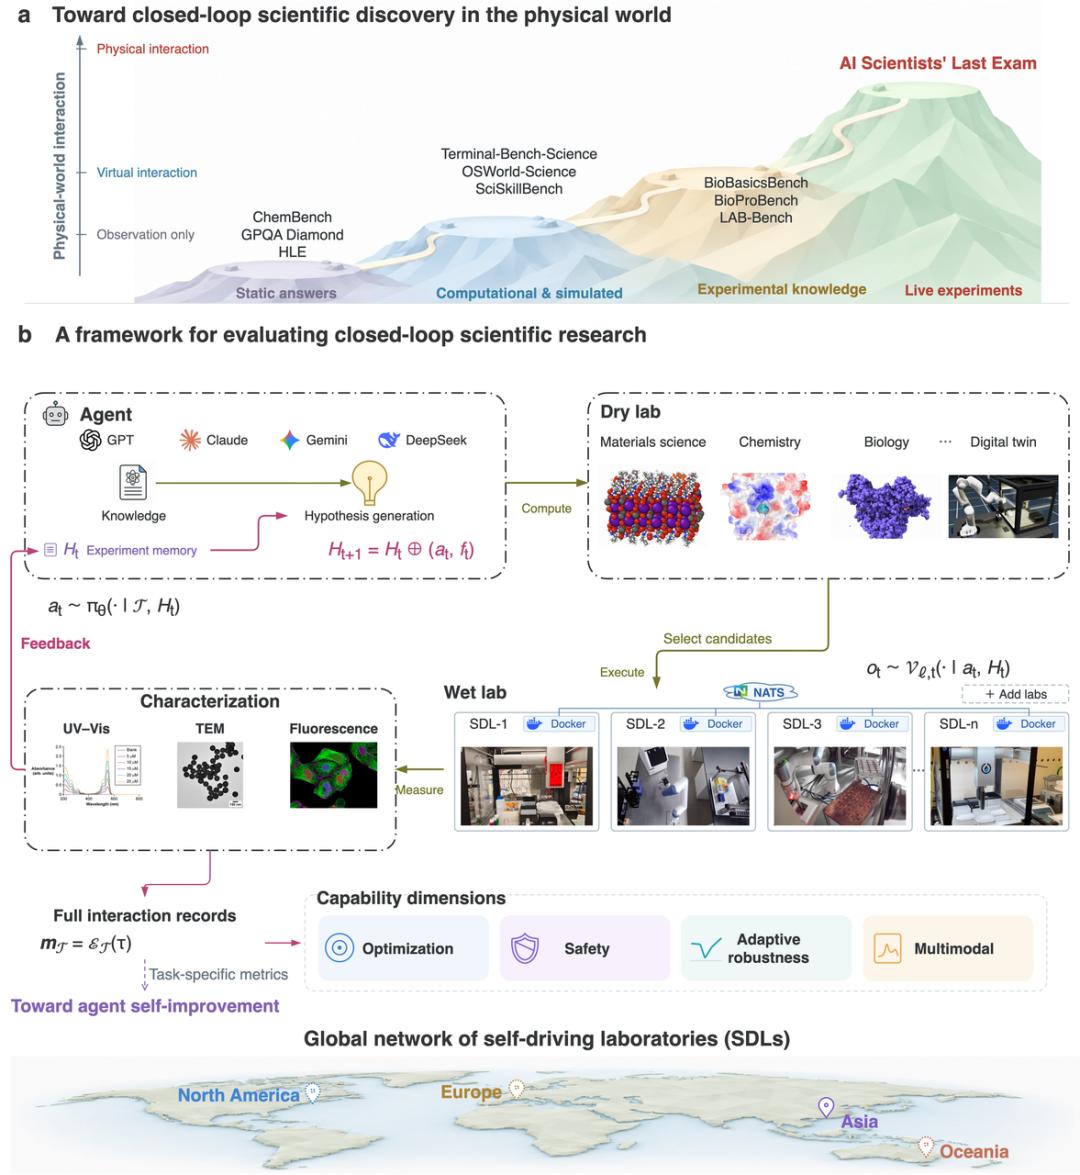
Abbildung a – Vier Stufen der wissenschaftlichen Bewertung: HLE und GPQA bewerten nur statische Antworten. Das von OpenAI am 6. November veröffentlichte BioBasicsBench prüft das Verständnis von Rohdaten aus Nasslaborversuchen (dritte Stufe „Experimentwissen“). AISLE befindet sich an der Spitze und lässt Modelle selbst Experimente an echten Geräten durchführen. Abbildung b – Der geschlossene Kreislaufrahmen von AISLE für Trocken- und Nassversuche: Das Modell stellt Hypothesen auf, das Trockenlabor (Simulation und digitaler Zwilling) filtert Kandidaten heraus, verteilte automatisierte Nasslaborstandorte führen die Versuche durch, und die Charakterisierungsergebnisse werden an das Modell zurückgemeldet; die vollständige Interaktionsspur wird in vier Dimensionen bewertet: Optimierung, Sicherheit, adaptive Robustheit und multimodale Schlussfolgerung.
Daher ist AISLE sowohl ein gemeinsamer Aufgabensatz zum Vergleich der experimentellen Fähigkeiten von Modellen als auch in der Lage, wie Komponententests im Codebereich wiederholbares echtes Feedback für die Modellverbesserung zu liefern.
Die erste Bewertungsrunde von AISLE konzentriert sich auf die Fähigkeit großer Modelle zum geschlossenen Kreislauf von Trocken- und Nassversuchen in echten Nasslaborversuchen: Das Modell schlägt Lösungen auf der Trockenseite vor, und die Nassseite führt sie aus und gibt echte Beobachtungen zurück.
Um die grundlegende Entscheidungsfähigkeit des Modells im geschlossenen Kreislauf von Trocken- und Nassversuchen zu testen, hat das Team grundlegende Aufgaben wie das umgekehrte Design optischer Ziele, die Optimierung pH-empfindlicher Formulierungen, die Planung irreversibler Operationen für Polymere, die aktive pKa-Ableitung basierend auf spektroskopischen Messungen unter verschiedenen pH-Bedingungen und die multimodale Schlussfolgerung aus Spektrum und Bild entworfen. Dabei werden Kosten, Feedbackgeschwindigkeit und Wiederholbarkeit berücksichtigt, während echte Betriebsfehler und Messrauschen beibehalten werden.
Darüber hinaus teilt das Team mit, dass derzeit auch komplexe wissenschaftliche Spitzenaufgaben wie die Buchwald-Hartwig-Kupplungsreaktion und die Synthese von CdS-MPA-Quantenpunkten integriert werden.
Noch bemerkenswerter ist, dass AISLE den „digitalen Zwilling“ in diesen geschlossenen Kreislauf einbringt.
Rhythmic Creation teilt Synced mit, dass jeder Experimentierstandort über eine entsprechende Umgebung mit digitalem Zwilling verfügt. Das Modell kann zunächst in der digitalen Umgebung umfangreiche Ableitungen und Fehlversuche durchführen und dann die ausgewählten Lösungen zur Ausführung an echte Experimentgeräte senden; die aus echten Experimenten erhaltenen Beobachtungsergebnisse kalibrieren wiederum den digitalen Zwilling, sodass die Simulation sich schrittweise dem tatsächlichen Verhalten der Geräte annähert.
Das entspricht der Einrichtung von zwei zusammenwirkenden Feedback-Mechanismen: Der digitale Zwilling bietet kostengünstige, dichte Gelegenheiten zum Ausprobieren von Fehlern; echte Experimente liefern die endgültige physische Validierungsgrundlage.
Auf diese Weise muss das Modell nicht bei jeder Erkundung echte Reagenzien und Geräteressourcen verbrauchen, sondern kann die simulierte Umgebung ständig durch echte Beobachtungen korrigieren.
Selbst GPT 5.5 erreicht nur 41 Punkte – Was misst das „erste Maß“?
Bisher konnte niemand in der Branche mit Sicherheit behaupten, ob große Modelle Experimente anstelle von Menschen durchführen können, da ein System fehlte, das die echten experimentellen Fähigkeiten von KI systematisch messen kann. Für Code gibt es Komponententests, für Mathematik gibt es