7,38 Milliarden Commits pro Monat: GitHub wird von KI-generiertem Code überlastet, selbst die Erweiterung um 4 Millionen Rechenkerne reicht bei weitem nicht aus
Am 17. August erlebten Programmierer auf der ganzen Welt einen kollektiven Ausfall.
Nachdem der Code fertig geschrieben war und man auf die Übertragung klickte, drehte sich der Fortschrittsbalken an Ort und Stelle; die automatischen Tests blieben hängen, die Merge-Anfragen konnten nicht verarbeitet werden, und selbst der KI-Programmierassistent Copilot verlor die Verbindung.
Diese Störung dauerte mehr als sieben Stunden, und an diesem Tag warteten alle Entwickler weltweit darauf, dass der Dienst wieder in Gang kommt.
Drei Tage später veröffentlichte Vlad Fedorov, Chief Technology Officer von GitHub, eine Entschuldigung:
Wenn Sie an diesem Tag gerade eine Software veröffentlichen wollten, haben wir Sie enttäuscht.
Er nannte als Grund: Der Datenverkehr erreichte einen neuen Höchststand, eine Schlüsselkomponente im Rechenzentrum im mittleren Westen der USA wurde nicht entsprechend skaliert, der Druck breitete sich aus und mehrere Dienste fielen nacheinander aus.
GitHub stufte diesen Vorfall als „Kapazitätsausfall“ ein, es war bereits der zweite große Unfall im August.
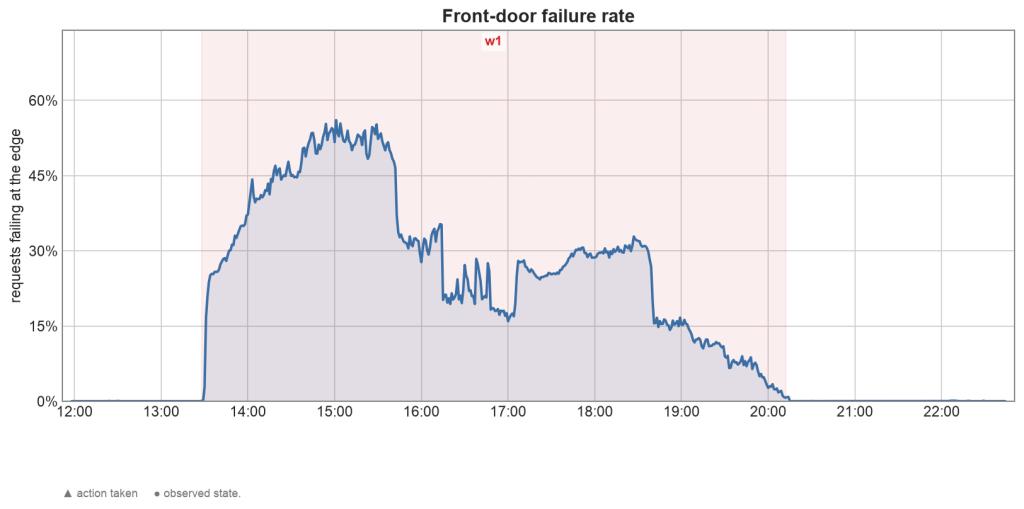
Offizielle Grafik von GitHub: Während des Ausfalls am 17. August lag die Fehlerrate der Anfragen am Eingang zeitweise über 50 %.
Bereits im März und April veröffentlichte Fedorov Beiträge zu Maßnahmen zur Verbesserung der Zuverlässigkeit von GitHub. Er schrieb in seinem Tweet, dass diese Arbeiten bis heute andauern.
Auf welchen Stand ist der Datenverkehr auf GitHub eigentlich angestiegen?
Diesen September haben Entwickler und KI-Agenten 7,38 Milliarden Code-Einträge auf GitHub vorgenommen, mehr als das Fünffache des Wertes vor einem Jahr.
Gerade als alle über die Geschwindigkeit staunten, mit der KI Code schreibt, machte der Ausfall von GitHub das Problem deutlich: Wohin soll der geschriebene Code gespeichert werden?
Die Antwort liegt in den Herausforderungen, mit denen GitHub in diesem halben Jahr konfrontiert war: Der Engpass beim KI-gestützten Schreiben von Code hat sich von „kann geschrieben werden“ zu „kann gespeichert und zusammengeführt werden“ verschoben.
Wer bringt GitHub an seine Grenzen?
Zuerst muss man zwei Aktionen unterscheiden, die Programmierer beim Schreiben von Code ausführen:
Commit (Eintrag) bedeutet, eine lokale Sicherungskopie des Codes zu erstellen;
Push (Übertragung) bedeutet, die Sicherungskopie auf GitHub hochzuladen.
Menschliche Programmierer speichern in der Regel erst dann eine Sicherungskopie, wenn sie einen Codeabschnitt fertiggestellt haben. KI-Agenten hingegen sind wahre „Speicher-Fanatiker“.
GitHub-Ingenieure schreiben im offiziellen Blog: Die Agenten erstellen fast nach jedem Schritt eine Sicherungskopie. Die Anzahl der Push-Vorgänge ist ebenfalls sprunghaft angestiegen, sie hat sich auf das 4,9-fache erhöht, von 690 Millionen pro Monat auf 3,35 Milliarden.
Bereits im August gab es auf Hacker News Nutzer, die anmerkten: Egal wie hoch die Anzahl der Commits ist, das, was GitHub wirklich verarbeiten muss, sind die Push-Vorgänge, dieser Indikator ist nicht ganz aussagekräftig.
Daraufhin widersprach jemand sofort: „Ein Push-Vorgang mit 100 Commits verbraucht mehr Ressourcen als einer mit nur einem einzigen Commit.“
Das bedeutet, dass Commits zwar erst nach dem Push auf GitHub ankommen, aber je mehr Commits in einem einzigen Push-Vorgang enthalten sind, desto mehr Arbeit muss GitHub verarbeiten.
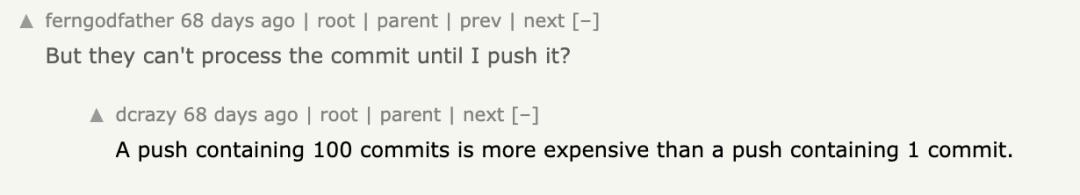
Hacker News-Nutzer diskutierten darüber, ob die Anzahl der Commits aussagekräftig ist.
Diese Gegenargumentation traf genau den wunden Punkt von GitHub: Die Agenten bevorzugen ausgerechnet das „häufige kleine Speichern“. Je häufiger und fragmentierter gespeichert wird, desto größer ist der Druck.
Schlimmer noch: Auf jeden Push-Vorgang folgen eine ganze Reihe von „aufeinanderfolgenden Aufrufen“: Sobald der Code hochgeladen ist, stürzen sich automatische Tests und Code-Scans darauf, und rufen denselben Code wiederholt ab.
In stark frequentierten Repositories kann es pro Minute Tausende von Abrufen geben. Das ist vergleichbar damit, dass Sie gerade eine Prüfungsarbeit abgegeben haben, und Tausende von Robotern gleichzeitig herbeieilen, um sie zu korrigieren.
Im September wurden die automatisierten Pipelines (Actions) von GitHub 3,26 Milliarden Mal ausgeführt, mehr als das Vierfache des Wertes vor einem Jahr.
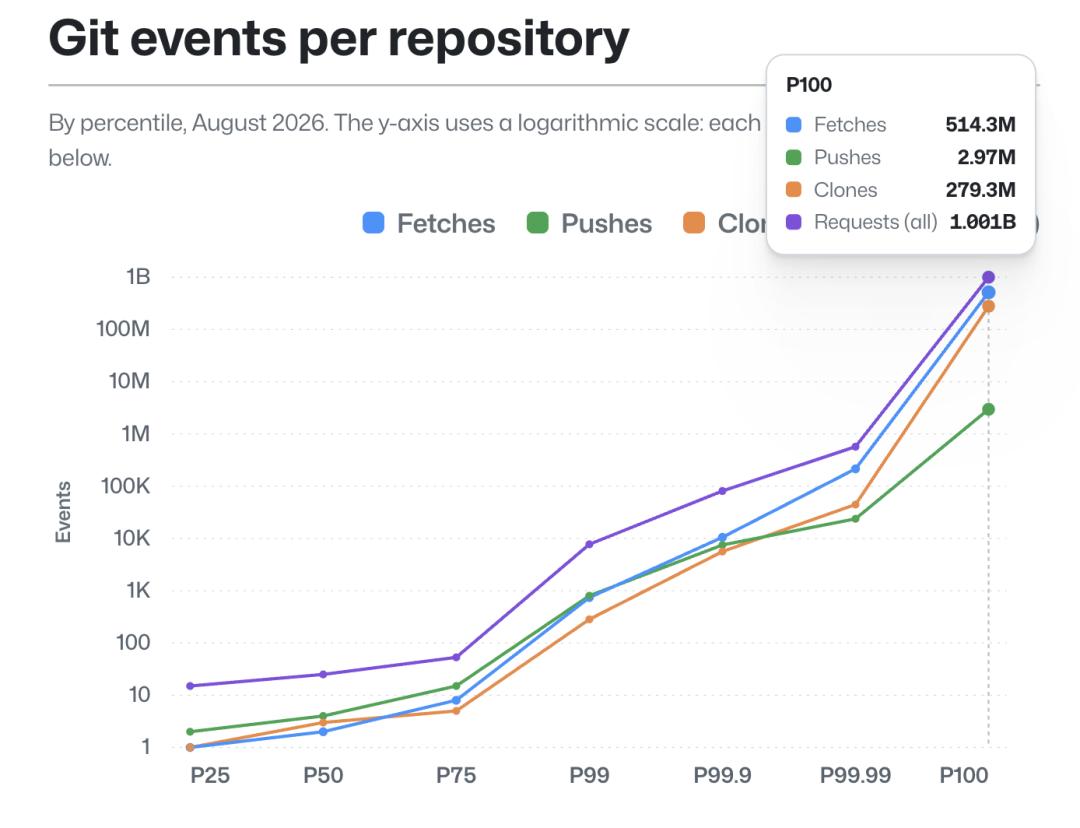
Die Auslastung der einzelnen GitHub-Repositories unterscheidet sich stark: Im August 2026 wurde das am stärksten frequentierte einzelne Repository von etwa 1 Milliarde Anfragen getroffen. Jede Stufe auf der vertikalen Achse bedeutet eine zehnfache Steigerung der Anzahl.
Wie The New Stack berichtet, führt GitHub diesen Anstieg hauptsächlich auf die „Nachfrage durch Agenten“ zurück:
Eine Gruppe völlig neuer Nutzer ist aufgetaucht. Sie schlafen 24 Stunden am Tag nicht, und ihre größte Leidenschaft ist das Drücken der Speichertaste.
Warum wird das Speichern langsamer, je mehr Sicherungskopien es gibt?
Wer die Raserei der Agenten versteht, versteht auch die Schwierigkeiten der alten Architektur von GitHub besser.
Um Datenverlust zu vermeiden und die Last der Code-Leser zu verteilen, erstellt GitHub standardmäßig 5 vollständige Sicherungskopien für jedes Repository, die auf 5 Servern verteilt sind.
Dieses Design war im Zeitalter menschlicher Entwickler sehr stabil: Der Verlust einer Kopie ist kein Problem, und bei vielen Lesern kann die Last verteilt werden.
Auf dieser alten Architektur hat GitHub 1 Milliarde Code-Repositories betrieben.
Doch im Zeitalter der Agenten zeigt sich die Schwachstelle.
Der erste Engpass liegt beim „Speichern“.
Nach den alten Regeln müssen bei jedem Speichern von neuem Code alle 5 Sicherungskopien beteiligt sein, und die endgültige Geschwindigkeit wird von dem langsamsten Server bestimmt.
Das ist vergleichbar damit, dass ein Unternehmen 5 Buchhalter einstellt, die gemeinsam ein einziges Konto führen: Jeder neue Eintrag ist erst gültig, wenn alle 5 unterschrieben haben, und es zählt die Unterschrift des langsamsten.
Außerdem kann immer nur ein Eintrag gleichzeitig vorgenommen werden: Wenn der vorherige Eintrag nicht unterschrieben ist, muss der nächste warten. Wenn die Anzahl der Personen, die das Konto prüfen, steigt, muss das Unternehmen mehr Buchhalter einstellen. Aber je mehr Buchhalter es gibt, desto länger dauert der Unterschriftsprozess.
In der alten Architektur behindern sich Lese- und Schreibvorgänge gegenseitig. Je mehr Sicherungskopien GitHub hinzufügt, um die Last der Lesevorgänge zu verteilen, desto langsamer wird das Speichern.
Die Agenten speichern aber jede Minute, und jeder Vorgang muss warten, bis die Buchhalter unterschrieben haben.
Noch gefährlicher: Wenn zu viele Sicherungskopien beschädigt sind, stoppt der Speichervorgang vollständig. Das ist vergleichbar damit, dass zu viele Buchhalter erkranken und das Konto nicht mehr weitergeführt werden kann.
Der zweite Engpass liegt beim „Zusammenführen“.
Alle Code-Änderungen müssen schließlich in denselben Hauptzweig integriert werden.
Innerhalb eines Jahres hat sich die Anzahl der Zusammenführungen auf GitHub fast vervierfacht, das ist vergleichbar damit, dass Tausende von Fahrzeugen auf denselben Mautpunkt zusteuern.
Wie langsam ist die Warteschlange eigentlich? GitHub-Ingenieure haben im Blog eine Rechnung aufgemacht.
Wenn die Sicherungskopien eines Repositories an zwei Standorten verteilt sind, beträgt die Entfernung zwischen dem eigenen Rechenzentrum von GitHub und der Microsoft-Cloud etwa 1600 Kilometer, eine Hin- und Rückfahrt dauert etwa 25 Millisekunden, und für einen einzigen Speichervorgang sind mehrere solcher Hin- und Rückfahrten erforderlich.
Schlimmer noch: Das gesamte Repository lässt nur einen einzigen Schreibvorgang gleichzeitig zu. Wenn der vorherige Eintrag nicht vollständig gespeichert ist, muss der nächste warten.
25 Millisekunden sind für menschliche Programmierer kürzer als ein Augenblick. Für Agenten ist das aber die Obergrenze, die die Effizienz blockiert: Wie schnell ein Agent arbeiten kann, hängt davon ab, wie schnell ein Push-Vorgang abgeschlossen wird.
Die jahrelang von GitHub hochgelobte Stabilität ist im Zeitalter der Agenten zu einem Engpass geworden.
Zuerst Hardware aufstocken – bis der Strom im Rechenzentrum nicht mehr reicht
Als Reaktion auf den Spitzenverkehr war die erste Maßnahme von GitHub, mehr Server hinzuzufügen.
Bis August hat GitHub bereits mehr als 3 Millionen neue CPU-Kerne und 120 PB Speicher hinzugefügt.
Aber es passierte trotzdem das peinliche Problem: Der Strom im Rechenzentrum reichte nicht mehr aus.
Fedorov schrieb in der Nachbesprechung: Sie haben so viel Hardware installiert, wie die Stromversorgung des alten Rechenzentrums tragen kann.
Nicht nur der Strom im Rechenzentrum ist erschöpft, sondern die gesamte Stromversorgung der Region, in der sich das Rechenzentrum befindet, hat ihre Kapazitätsgrenze erreicht. Alle Steckdosen sind belegt, und wenn man weitere Server hinzufügen möchte, muss man umziehen.
Daher hat GitHub damit begonnen, die Migration auf die Cloud-Plattform von Microsoft (Azure) zu beschleunigen: Im Mai trug die Microsoft-Cloud nur 12 % der Arbeitslast; bis August stieg dieser Anteil auf etwa 58 %.
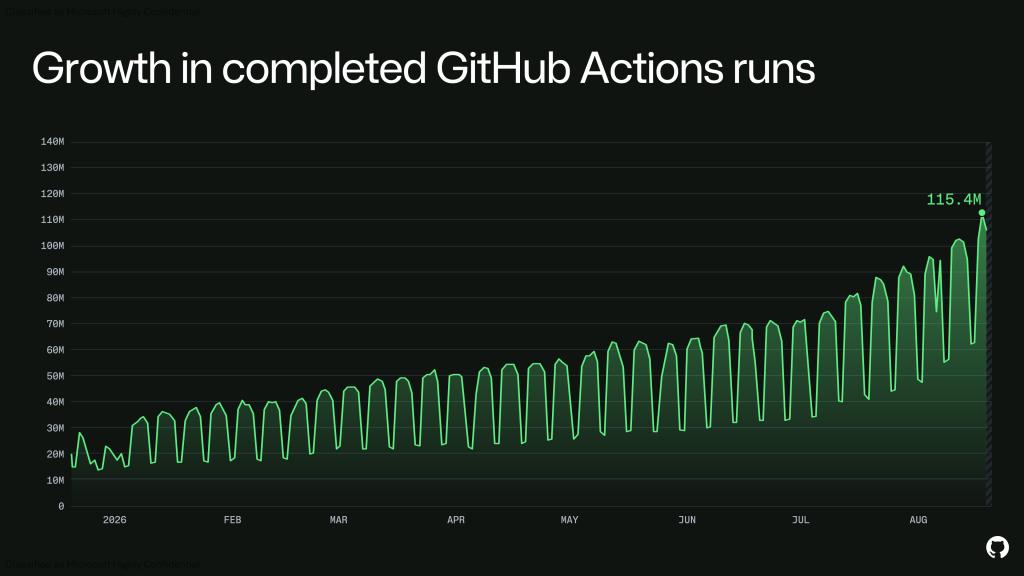
Von Anfang 2026 bis August ist die tägliche Anzahl abgeschlossener Ausführungen von GitHub Actions von etwa 15 bis 30 Millionen auf etwa 115 Millionen gestiegen.
Auf der GitHub-Jahreskonferenz am 28. Oktober wurden die Infrastrukturzahlen erneut aktualisiert:
In diesem Jahr wurden insgesamt 4 Millionen neue CPU-Kerne und 160 PB Speicher (entspricht etwa 160 Millionen GB) hinzugefügt, und die Netzwerkbandbreite wurde um 50 Tb pro Sekunde erweitert.
Aber der Microsoft-Manager Jay Parikh gab trotzdem in seinem Blogbeitrag an diesem Tag zu: Es reicht nicht aus, nur die Kapazität zu erweitern, man muss auch die Architektur ändern.
Geld für Hardware auszugeben, kauft nur Atempause, beseitigt aber nicht die grundlegenden Mängel der alten Architektur.
Die Basis austauschen: Konten und Schalter trennen
Wie kann man die Architektur umbauen? Kehren wir zu dem vorherigen Vergleich mit den 5 Buchhaltern zurück.
Bei der alten Methode bewacht jeder Buchhalter einen Schalter, hält ein vollständiges Konto in der Hand, muss sowohl Gäste empfangen, die das Konto prüfen wollen, als auch selbst Buchungen vornehmen.
Die neue Methode besteht darin, die Konten in ein zentrales Archiv zu legen, und die Schalter kümmern sich nur um den Empfang der Gäste. Der gesamte Code wird in dem großen Archiv der Microsoft-Cloud gespeichert, der Schutz vor Datenverlust und die Sicherungskopien werden vollständig von dem Archiv übernommen, und die Server an der Vorderseite werden entlastet und kümmern sich nur um die Verarbeitung von Anfragen.
Diese Trennung hat drei Vorteile.
Erstens: Trennung von Lese- und Schreibvorgängen.
Egal wie viele Personen den Code lesen, die Geschwindigkeit des Speicherns wird nicht verlangsamt. Die Schalter im Vordergrund können je nach Bedarf geöffnet oder geschlossen werden: Bei hohem Verkehr öffnet man mehr, bei niedrigem Verkehr schließt man sie wieder. Wenn einer defekt ist, kann sofort ein Ersatz eingesetzt werden.
Zweitens: Überflüssige Unterschriften werden abgeschafft.
Bei einem Push-Vorgang ist der einzige Schritt, der die Zustimmung aller Beteiligten erfordert, das „Aktualisieren des Branch-Zeigers“. Das Verschieben von Daten in das Archiv, die Integritätsprüfung und das Scannen nach durchgesickerten Schlüsseln können alle parallel ausgeführt werden, ohne in der Warteschlange zu warten.
Drittens: Aufräumarbeiten im Hintergrund.
Früher wurden alte Daten auf den Servern verarbeitet, die auch Gäste empfangen, was Ressourcen von der Bearbeitung von Anfragen abzieht. Jetzt wird dies vollständig an spezielle „Reinigungs“-Server übergeben, die im Hintergrund langsam im Archiv aufräumen.
Interne Tests zeigen, dass die Anzahl der Schreibvorgänge pro Sekunde, die diese neue Architektur verarbeiten kann, um bis zum 35-fachen gesteigert wurde.
Die eigentliche Herausforderung besteht darin, diesen tiefgreifenden Umbau durchzuführen, während GitHub weiterhin normal betrieben wird.
Das ist vergleichbar damit, den Triebwerk eines Flugzeugs auszutauschen, während es in 10.000 Metern Höhe fliegt.