Das Weltmodell „Cloud-Gaming“ wurde vorgestellt, ein Produkt von Li Feifeis World Labs.
Heute spielen die Leute in der KI-Szene Spiele.
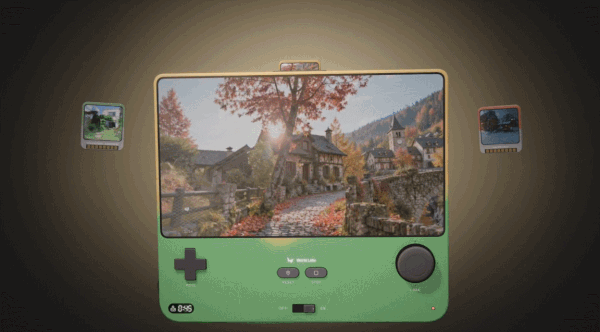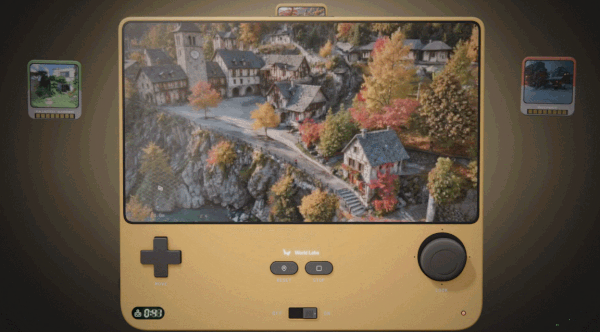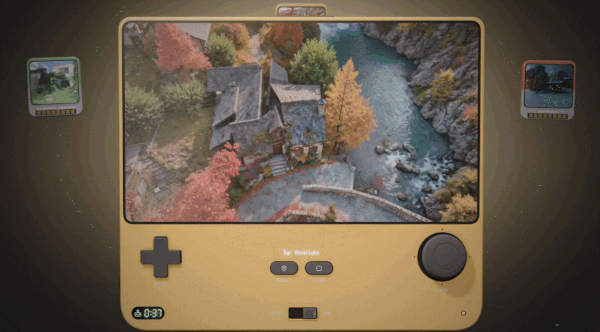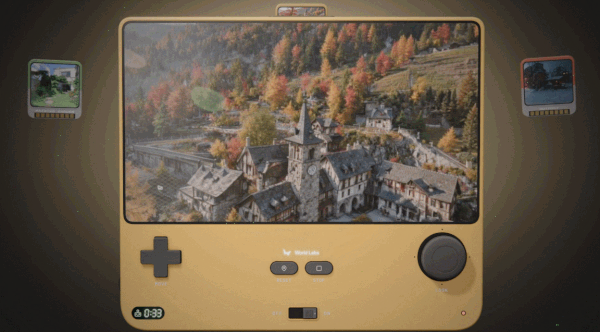
Das von Li Feifei gegründete Startup World Labs hat seine erste „Anwendung“ Frameboy vorgestellt, die Ego-Perspektiven in Echtzeit durch KI generiert und generative KI zu einer direkt erfahrbaren Erkundungserfahrung macht.
Frameboy ist eine optimierte Demonstrationsversion des Atlas-Weltmodells, die auf Cloud-GPUs basierendes Streaming nutzt und eine maximale Bildrate von 15 fps erreichen kann. Praktische Tests ergaben eine Modellantwortzeit von nur etwa 70 ms, was bereits fast dem Niveau von Cloud-Spielen entspricht.
Erlebnis-Link: https://frameboy.worldlabs.ai/
Derzeit bietet es kuratierte Szenarien zur Erkundung an, darunter verschiedene reale Landschaften, Cyberpunk-Räume und den Campus der Stanford University. Einige dieser Szenarien gehen von einem einzigen Bild aus, lassen Atlas andere Perspektiven ergänzen und bauen schrittweise eine erforschbare Umgebung auf. Andere basieren auf mehreren Fotos desselben Ortes, aus denen das Modell neue Perspektiven zwischen und außerhalb der vorhandenen Bilder generiert.
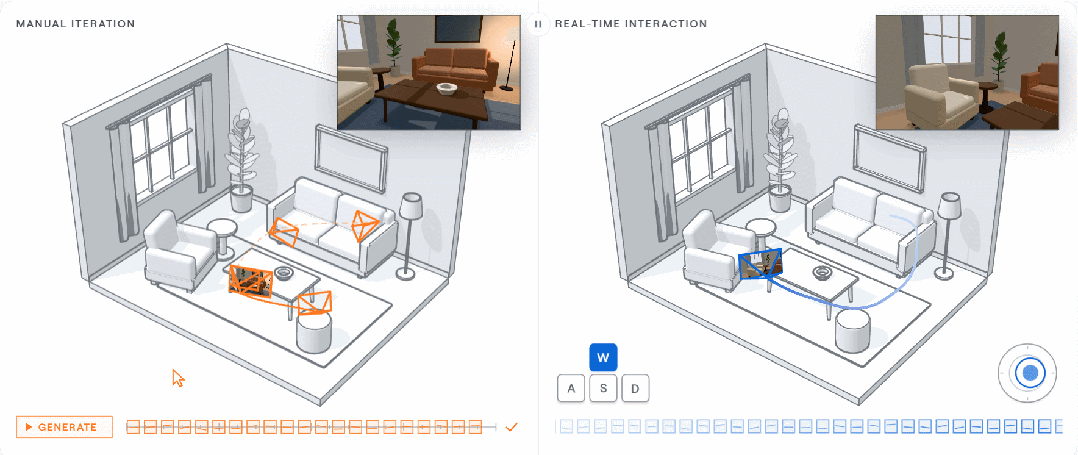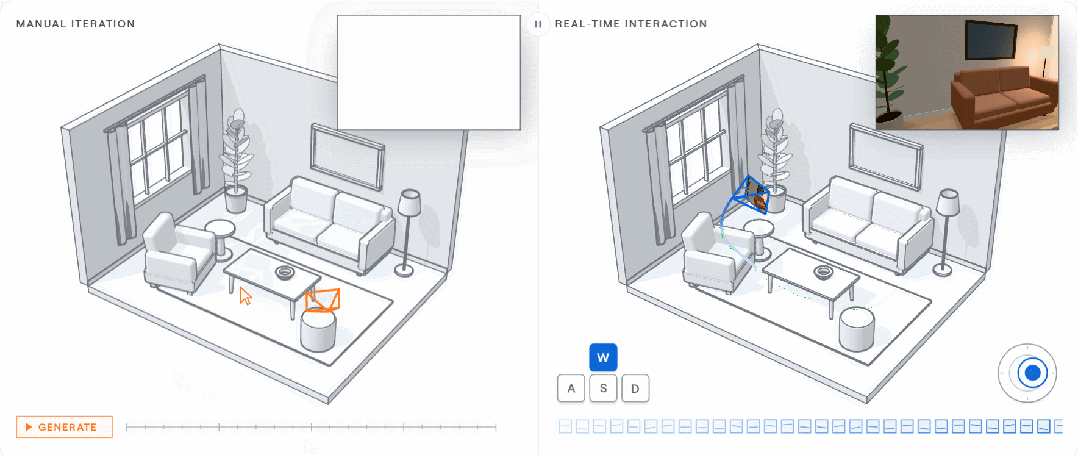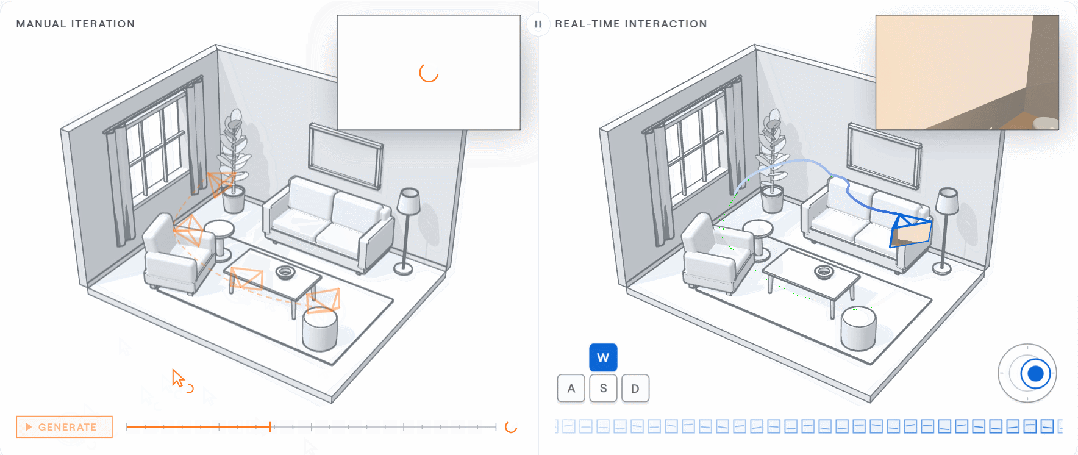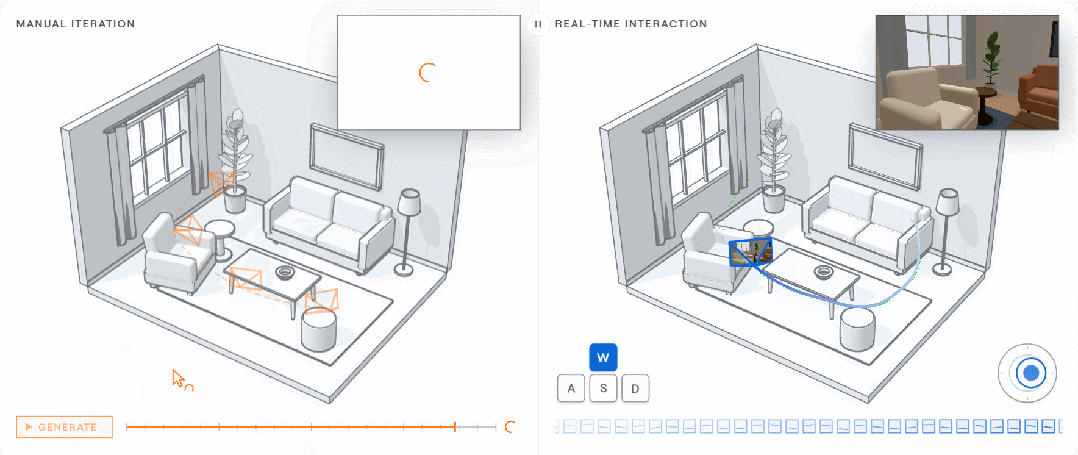
World Labs hat Frameboy zudem direkt in die Beta-Webanwendung Viewfinder als Streaming-Overlay-Rendering-Modus integriert. Dadurch können Nutzer Szenen Frame für Frame mit ihren eigenen Eingaben aufbauen und anschließend virtuelle Welten in Echtzeit erkunden und erweitern.
Genau wie bei der Nutzung einer Kamera können Sie aus verschiedenen Perspektiven navigieren und 3D-konsistente Ansichten der Welt generieren. Jeder Frame wird von Atlas generiert und enthält Farb- und Tiefeninformationen. Sobald alles bereit ist, können Nutzer das Frameboy-Overlay aktivieren, um die generierten Frames während der Erkundung in Echtzeit wiederzugeben.
Atlas: Aus einem Foto eine dreidimensionale Welt ableiten
Um die Bedeutung dieser Echtzeit-Demonstration von Frameboy zu verstehen, müssen wir zunächst klären, was das dahinterstehende Atlas eigentlich ist.
Am 1. September dieses Jahres hat das von Li Feifei gegründete Unternehmen World Labs Atlas offiziell vorgestellt – ein von Grund auf vortrainiertes universelles Weltmodell, das Text, Bilder, Videos und 3D-Rauminformationen verarbeiten kann. Im Gegensatz zu Videomodellen, die hauptsächlich fortlaufende Bilder generieren, versucht Atlas ein komplexeres Problem zu lösen: Wie würde die Welt aussehen, wenn sich die Kamera an eine andere Position bewegt?
Bei der Vorstellung hat World Labs ein sehr anschauliches Beispiel gezeigt.
Zuerst gaben die Forscher Atlas ein Foto eines Gartens und forderten es auf, die Ansicht dieses Bereichs aus der Vogelperspektive zu generieren. Da das ursprüngliche Foto nur einen Teil des Gartens zeigte, konnte das Modell die vorhandenen Objekte zwar nachbilden, musste aber die umliegenden Häuser und die Umgebung selbst erschließen.
Anschließend fügten die Forscher ein zweites Foto hinzu, das ein kleines Haus neben dem Garten zeigte. Diesmal enthielt das von Atlas generierte Bild sowohl den Garten als auch das kleine Haus, während die weiter entfernten Gebäude weiterhin vom Modell selbst ergänzt wurden. Erst nach Hinzufügen des dritten Fotos, das das Haupthaus in der Nähe zeigte, rekonstruierte das Modell die gesamte Szene näher an der realen Umgebung.
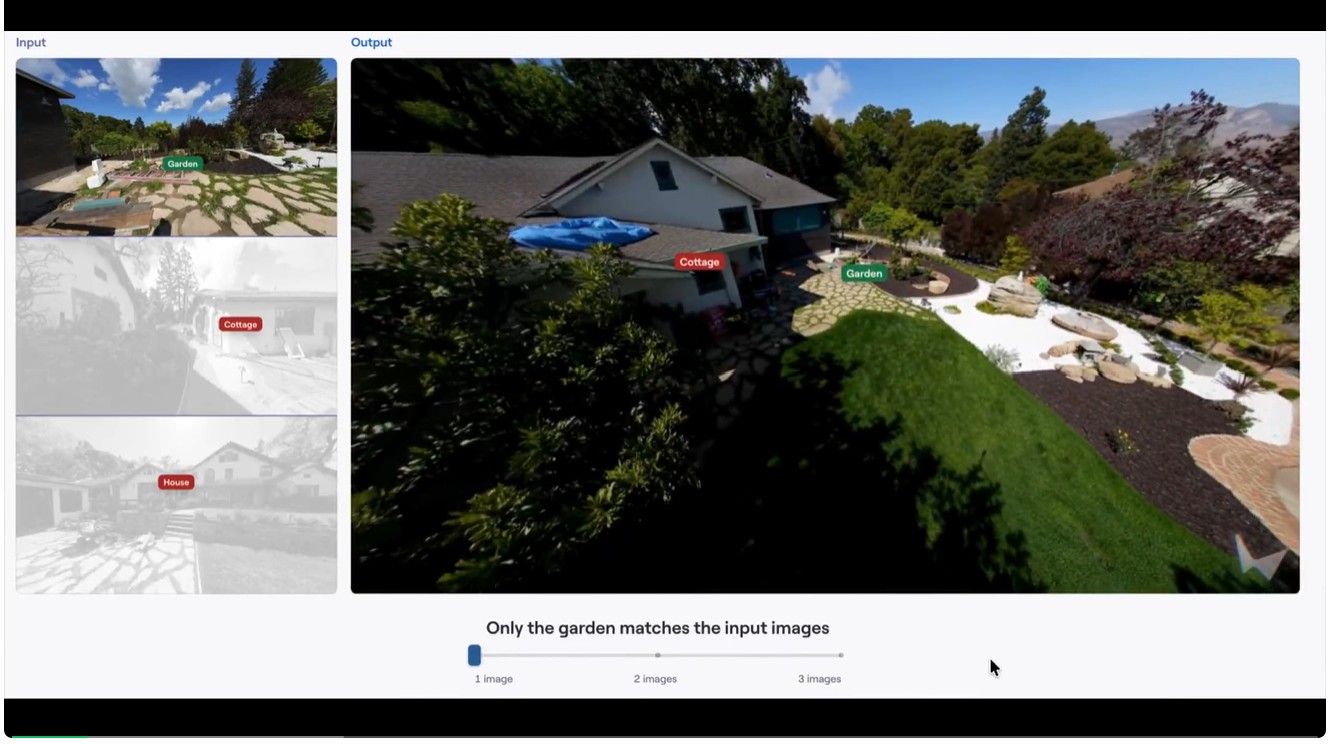
Dieser Prozess zeigt ein wichtiges Merkmal von Atlas: Es kann nicht nur bereits beobachtete Räume anhand begrenzter Bilder rekonstruieren, sondern auch mithilfe des im Training erlernten Weltwissens ableiten, was sich außerhalb des Bildausschnitts befinden könnte.
World Labs nennt seinen Kernmechanismus „Räumlicher Kontext“ (Spatial Context).
Einfach ausgedrückt erkennt Atlas nicht nur, welche Objekte auf dem Bild zu sehen sind, sondern verknüpft jedes Bild mit der Position und Ausrichtung der Kamera im dreidimensionalen Raum. Wenn der Nutzer eine neue Beobachtungsposition angibt, generiert das Modell anhand der vorhandenen Rauminformationen das Bild, das von dieser Position aus zu sehen sein sollte.
Dies ist auch ein wichtiger Unterschied zwischen Atlas und herkömmlichen Videogenerierungsmodellen. Letztere steuern die Kamerabewegung normalerweise über Textbeschreibungen wie „Kamera nach links bewegen“ oder „Um die Person rotieren“, während Atlas präzise Kamerapositionen und -winkel direkt entgegennimmt, sodass Nutzer den Blickwinkel auf die Welt explizit festlegen können.
Auf technischer Architekturebene nutzt Atlas einen multimodalen autoregressiven Diffusions-Transformer. Er kombiniert die Ideen von Sprachmodellen und Diffusionsgenerierungsmodellen: Er organisiert Text, Bilder, Kameraposen und Tiefeninformationen in einem einheitlichen räumlichen Kontext und generiert schrittweise neue Bilder und räumliche Daten.
In der ersten Demonstration konnten Nutzer bereits Kamerapfade im Voraus entwerfen, sodass Atlas Videos mit einer Länge von bis zu einer Minute und einer maximalen Auflösung von 1440p generieren und die Konsistenz der Szene zwischen verschiedenen Kamerawinkeln so weit wie möglich aufrechterhalten kann.
Aber die Fähigkeiten von Atlas gehen über die Generierung von Videos hinaus.
Es kann zudem Bilder und Tiefeninformationen gleichzeitig generieren und 3D-Repräsentationen wie Punktwolken und 3D Gaussian Splatting ausgeben. Mit anderen Worten: Das Modell kann nicht nur Bilder aus einem bestimmten Winkel darstellen, sondern auch Daten erzeugen, die für Arbeitsabläufe wie 3D-Rendering und Raumerfassung verwendet werden können.
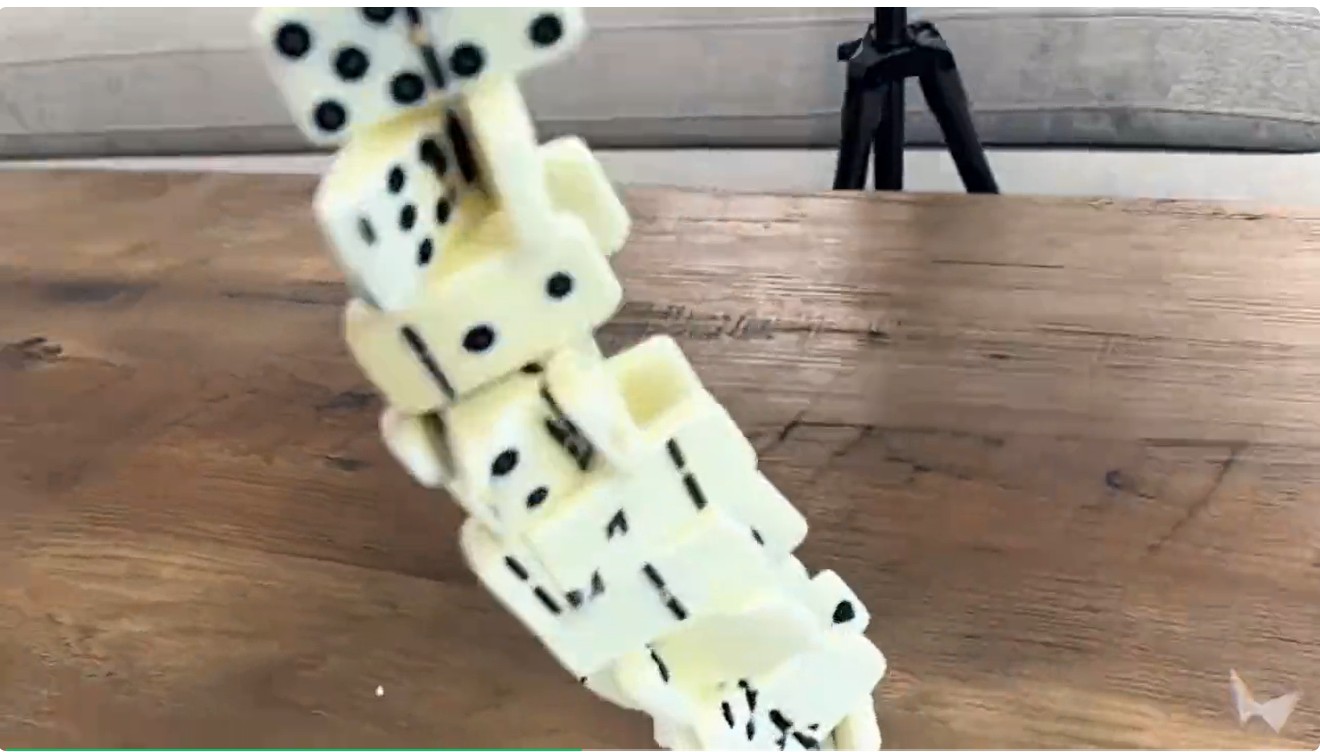
Zum Beispiel haben Forscher drei bis fünf normale Smartphones und Actionkameras verwendet, um dieselbe Szene aus verschiedenen Winkeln aufzunehmen. Atlas rekonstruiert den Raum anhand dieser Bilder, sodass Nutzer den Beobachtungswinkel in dem Moment wechseln können, in dem die Aktion stattfindet – ähnlich dem „Bullet-Time“-Effekt aus dem Film *Matrix*, ohne dass ein herkömmliches großangelegtes Mehrkamerasystem eingesetzt werden muss.
Ein weiteres Anwendungsfeld ist die Robotersimulation. Forscher können reale Umgebungen per Handyvideo aufzeichnen, dann Atlas nutzen, um den Raum zu rekonstruieren, und Bilder und Tiefendaten generieren, die die bordseitige Kamera des Roboters beobachten würde, wenn er verschiedene Routen entlangfährt. Dies bietet eine neue Methode, um Robotersimulationsumgebungen mit wenigen echten Aufzeichnungen aufzubauen.
Mit dem Aufkommen von Frameboy hat sich die Art des kreativen Arbeitens auf Basis von Weltmodellen verändert: Wir können uns bewegen, beobachten und gleichzeitig entscheiden, was als Nächstes passiert. Diese Erfahrung hat Potenzial für die Filmschauplatzsuche, räumliche Konzeptgestaltung und die Konzeption von Spielleveln.
Referenzinhalt: https://www.worldlabs.ai/blog/atlas-realtime
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Jiqi Zhixin“ (ID: almosthuman2014), Redakteure: Neo, Zenan, veröffentlicht mit Genehmigung von 36Kr.